LOADING...

加载过慢请开启缓存(浏览器默认开启)

loading

P-luminary

星海智伴

2026/9/1
阅读全文

ComfyUI

2026/3/10

D:\comfyUI\ComfyUI_windows_portable\ComfyUI把这里面的extra_model_paths.yaml.example后的.example删除掉就可以正式生效的配置文件了

a111:
     base_path: path/to/stable-diffusion-webui/
     checkpoints: models/Stable-diffusion
     configs: models/Stable-diffusion
     vae: models/VAE
     loras: |
          models/Lora
          models/LyCORIS
     upscale_models: |
                   models/ESRGAN
                   models/RealESRGAN
                   models/SwinIR
     embeddings: embeddings
     hypernetworks: models/hypernetworks
     controlnet: models/ControlNet

这里要注意修改 把base_path: path/to/stable-diffusion-webui/改成自己的大模型路径
这里的controlnet: models/ControlNet也是需要修改成controlnet: extensions\sd-webui-controlnet\models

2026年1月秋叶大佬最新Comfyui整合包:ComfyUI-aki-V3.7和V2.7-史诗级更新 - ComfyUI资源网

  • 在设置中可以设置Comfy的信息
  • 双击空白位置可以直接搜索对应的节点
  • 左侧的节点库不但可以手动搜索节点,还可以一级一级查找
  • 右键添加组可以同时对组内的所有节点进行统一管理出现一个框
  • 点击运行箭头时有更改时运行、实时运行
  • 从latent接口长按鼠标左按拖出一条线 会弹出系统推荐的几个适合这个接口的节点
  • 在工作流(w)可以选择某个工作流右键添加到画布中
  • Comfy的开发者模式:如果要通过comfyui对接外部程序开发一些app之类的应用
  • 节点连线中间会多出一个Add Reroute 点击后会多出一个大的转接点;之后移动这个Reroute点就可以调整连线的路径了;现在就可以通过调整Reroute节点的位置实现远程连接加规整连线的效果了;也可以在Reroute节点上按住shift,这样就可以在这个Reroute点上新建出一个分支出来了,在空白位置松手就会弹出一个搜索框,添加额外的节点进来;也可以按住shift键在Reroute点创建分支连接到已有的其他接口去
  • 按住Ctrl+左键框选后再按Ctrl + G即可创建一个组(可以移动组内款选的所有节点);删除组时要右键点击编辑框的Edit Group → 删除即可删除这个组;现在也可以左键点击组后按退格键即可删除这个组;如果想把这个组固定不动 按P 就可以固定这个组了;也可以给新建的Reroute点进行Ctrl + G打组
  • 组与组之间可以进行嵌套使用;可以在大的组里面进行右键Edit Group进行更改颜色
  • 键盘的.可以将工作流快速定位到界面的中心;选中某个节点按下键盘的.就会直接放大界面到这个节点中去
  • 右键某个节点有个折叠,点击后当前节点就会最小化显示了;节点左上方也有个小圆点也可以直接最小化,再点击一下即可自动复原
  • 正面提示词一般可以把节点改成红色,负面提示词一般可以把节点改成绿色
  • 按住Ctrl不放,点击节点即可对多个节点选择;长按Ctrl + 左键不放也可以进行多个节点选择;这里比如框了两个节点然后我需要移动这两个,此时需要按住Shift不放即可拖动选中的两个节点
  • 选中其中一个节点Ctrl + C后Ctrl + V就可以复制这个节点了;或者选中某个节点长按Alt不放再进行鼠标拖动即可复制节点
  • 如果需要复制的节点携带连线则需要Ctrl + C复制节点后再Ctrl + Shift + V进行复制携带连线的节点(保留连线关系的节点)
插件安装

在这里E:\ComfyUI-AI_DeskTop\ComfyUI-aki-v3\ComfyUI\custom_nodes
安装方式

①:确保\custom_nodes路径 然后用Git从GitHub上复制git clone xxxx地址后进行安装
②:点击UI界面的Manager→Custom Nodes Manager 里面集成ComfyUI的各种节点


  • workspace-manager是左上角文件夹图标管理工作流的插件
  • ComfyUI-Custom-Scripts很多小功能和节点;如果最后一个节点是保存节点,那么工作流生成的图片都可以在E:\ComfyUI-AI_DeskTop\ComfyUI-aki-v3\ComfyUI\output里面获取到;也可以在图片右键通过保存图片来保存;instant一直执行 change当改变节点状态后就会立刻执行

ComfyUI的Manager管理器

★ 点击Manager 左上角的DB是数据库

  • 数据库:频道(1天缓存):comfyUI管理器里面的数据库每天更新一次
  • 数据库:本地:仅仅为你本地的上一次更新为准
  • 数据库:频道(远程):远程实时更新

★ 下面Channel指ComfyUI针对性的给你推送对应频道的插件和节点内容
★ 目前没有找到可以调出小狐狸的图标 以及每个节点右上角的ID号和所对应的父类
★ Component是工作流节点的使用情况

  • Use workflow version:使用作者分享工作流本身的节点版本
  • Use higher version:使用最高版本
  • Use my version:使用当前节点的版本来替代作者工作流的节点版本

★ SnapshotManager快照管理器 可以给当前的comfyui添加一个快照;随时可以恢复到之前的快照了
★ Install PIP packages安装pip包
★ Install via Git URL通过复制GitHub的连接来安装插件
★ Upadte All更新ComfyUI全部和节点本身
★ Community Gallery社区手册

秋叶启动器

秋叶启动器的高级选项

选择有CUDA的生成引擎

疑难解答

可以检测扫描包的问题

版本管理

可以插件、扩展、内核的管理

工作流的保存和使用

尽量去用.json去保存或导入
工作流分享平台:(https://comfyworkflows.com/) 和 https://openart.ai/workflows/
[ComfyUI工作流下载渠道整理 - 设计经验 - 素材集市](https://www.sucaijishi.com/articles-51-571-1.html#:~:text=国外老牌工作流网站%2C需科学上网访问,提供免费下载和付费在线生成服务。 包含国外大神的ComfyUI基础教学视频,资源全面,学习ComfyUI的绝佳去处。 https%3A%2F%2Fopenart.ai%2Fworkflows%2Fhome,无需科学上网,功能类似OpenArt Flow%2C可直接下载使用工作流,工作流资源丰富。 https%3A%2F%2Fcomfyworkflows.com%2F)
https://civitai.com

导入工作流节点错误处理方法

  • 在网上下载的工作流会出现节点爆红的情况:绝大部分原因就是当前工作流里用的插件在我们comfyUI中并没有安装 → 直接点击Manager → Install Missing Custom Nodes 直接安装缺失节点即可

  • 如果自动安装缺失节点也会有莫名其妙报错 那就直接卸载删除,手动搜索节点去安装

报错查找与解决方法

在秋叶管理器里面的疑难解答 右上角开始扫描寻找报错情况
所用插件报错 可以去该插件的GitHub官方的Issues中搜索核心报错关键词则同款问题的报错即可出现

从入门到进阶

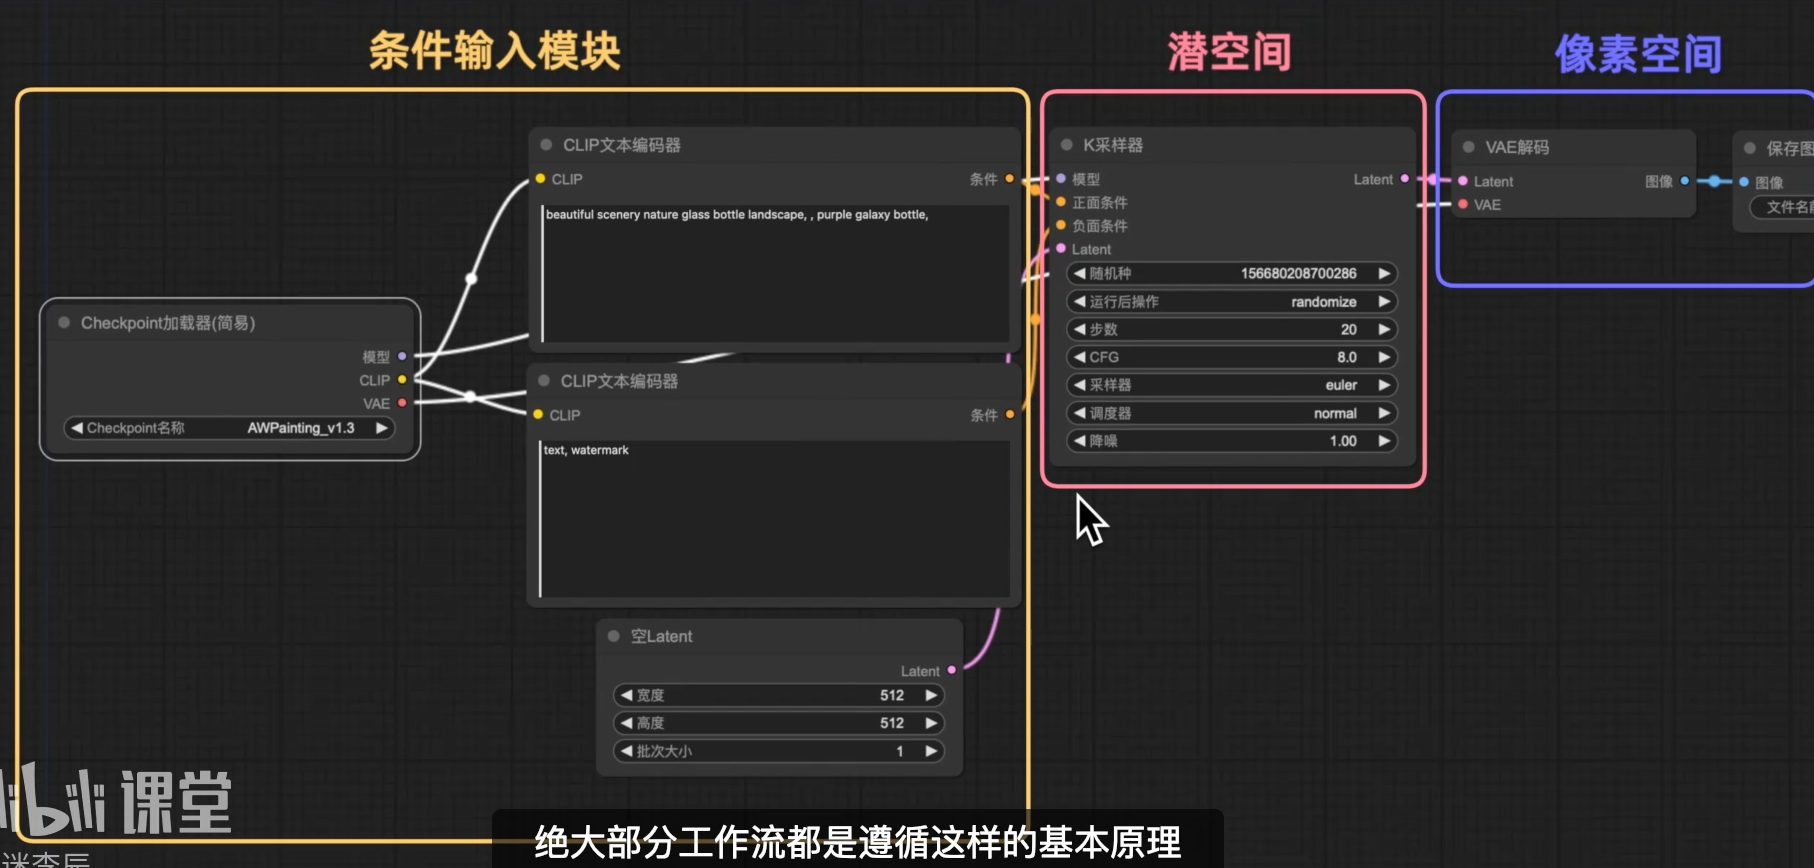
潜空间

潜空间(K采样器):所谓就是AI处理图像的空间,加噪去噪采样生成图片,但生成图片仅被AI识别;
但这个图片在潜空间里面经过加噪去噪处理后不能直接显现出来,要通过VAE解码这个节点,把潜空间的图像转变为最终像素空间图形,这个才是我们最终看到的结果。

Lora、Controlnet

LoRA 可以理解成 AI 绘画的「专属技能包 / 插件」,核心作用是:让 AI 快速学会特定风格、物体、人物或细节,不用重新训练整个大模型,是你做「产品替换 / 电商图」的超级利器。

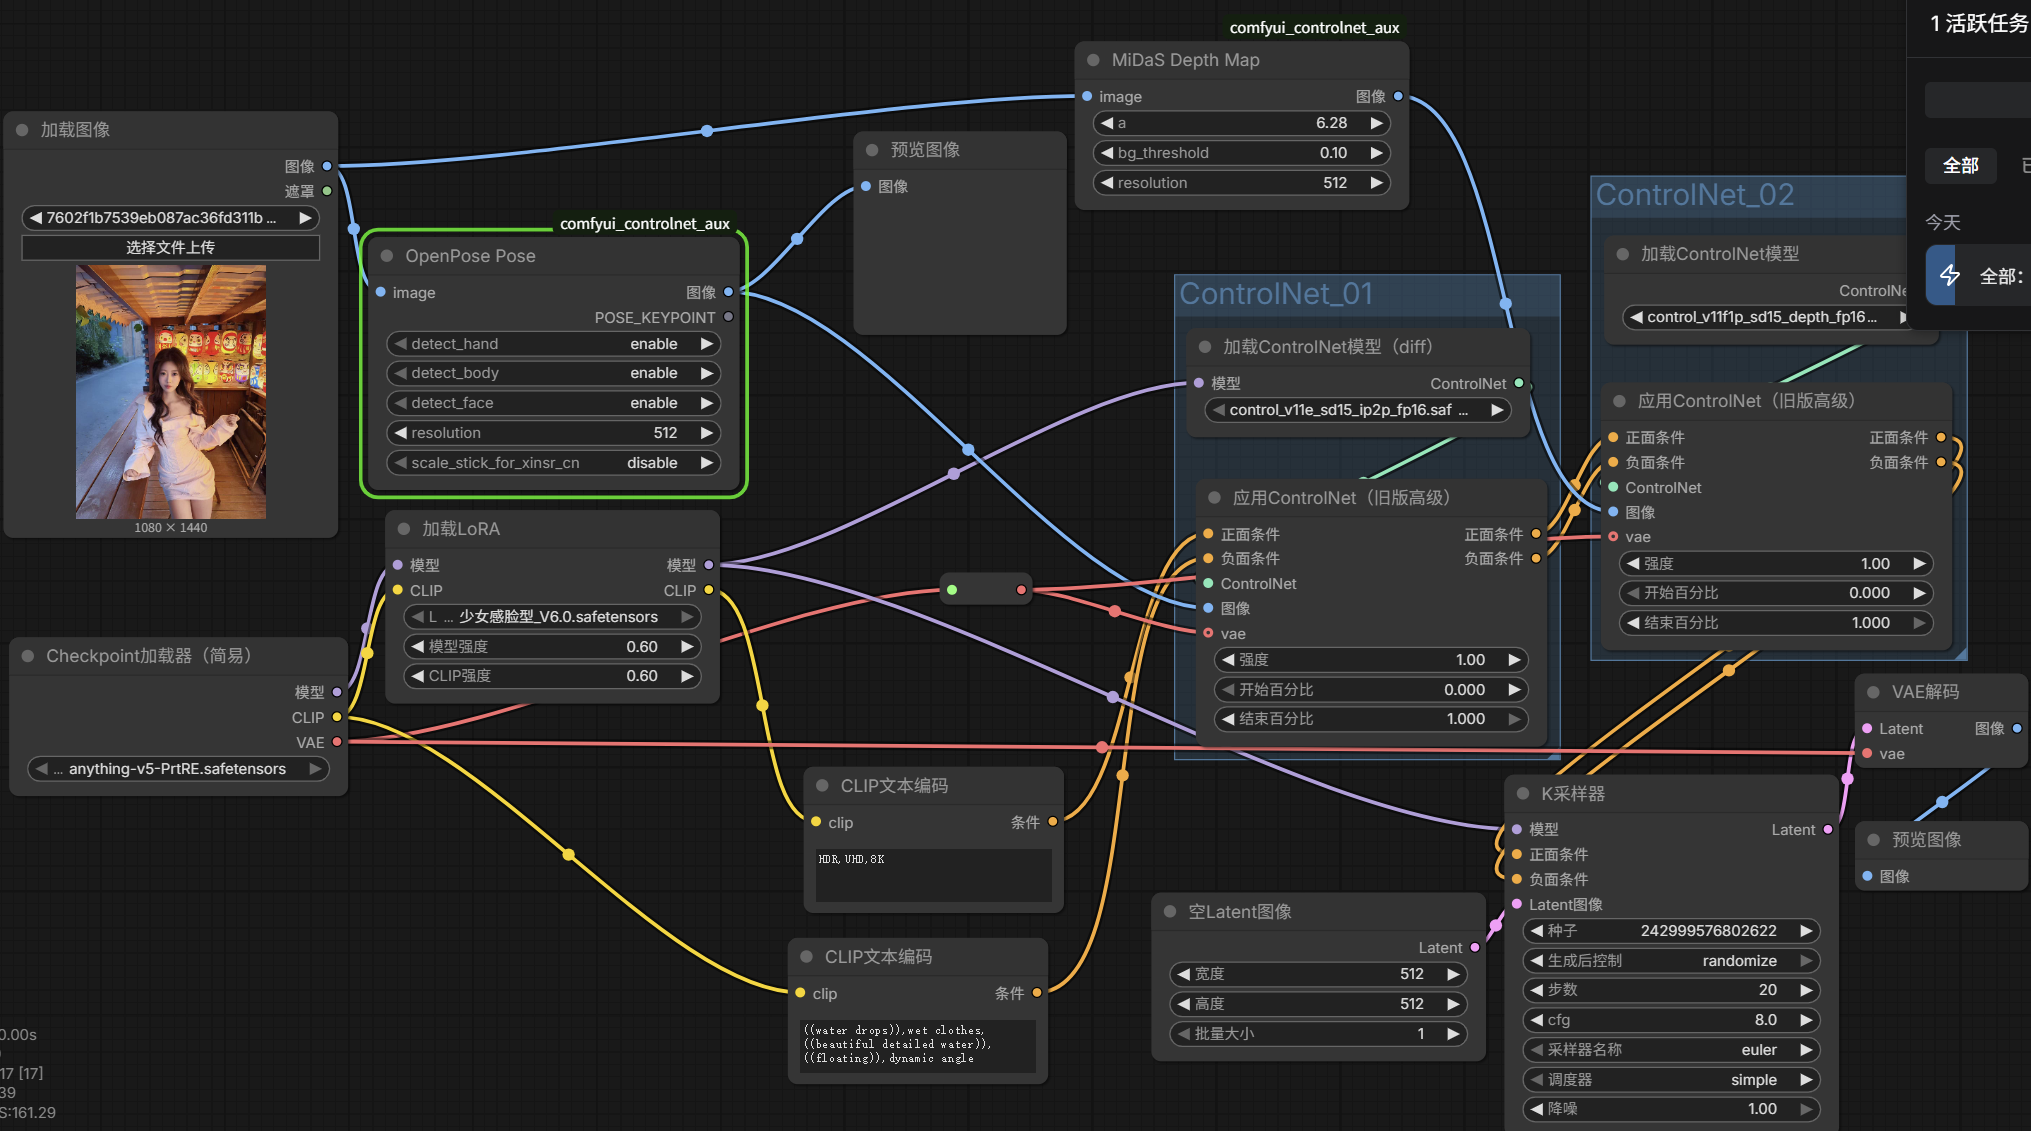
如果要给工作流加Lora、Controlnet节点的话,首先要确定节点是加载哪个的模块里面;这两个模型都是属于限制最终生成图片的前置条件 → 是要在条件输入模块里添加的 [双击空白地方 添加lora加载器]

不同节点之间接口是有名称和颜色之分的,一般情况下不同颜色的接口是不能相互连接的,需要把相同颜色的接口对接一下;随后选择一个想要的lora风格

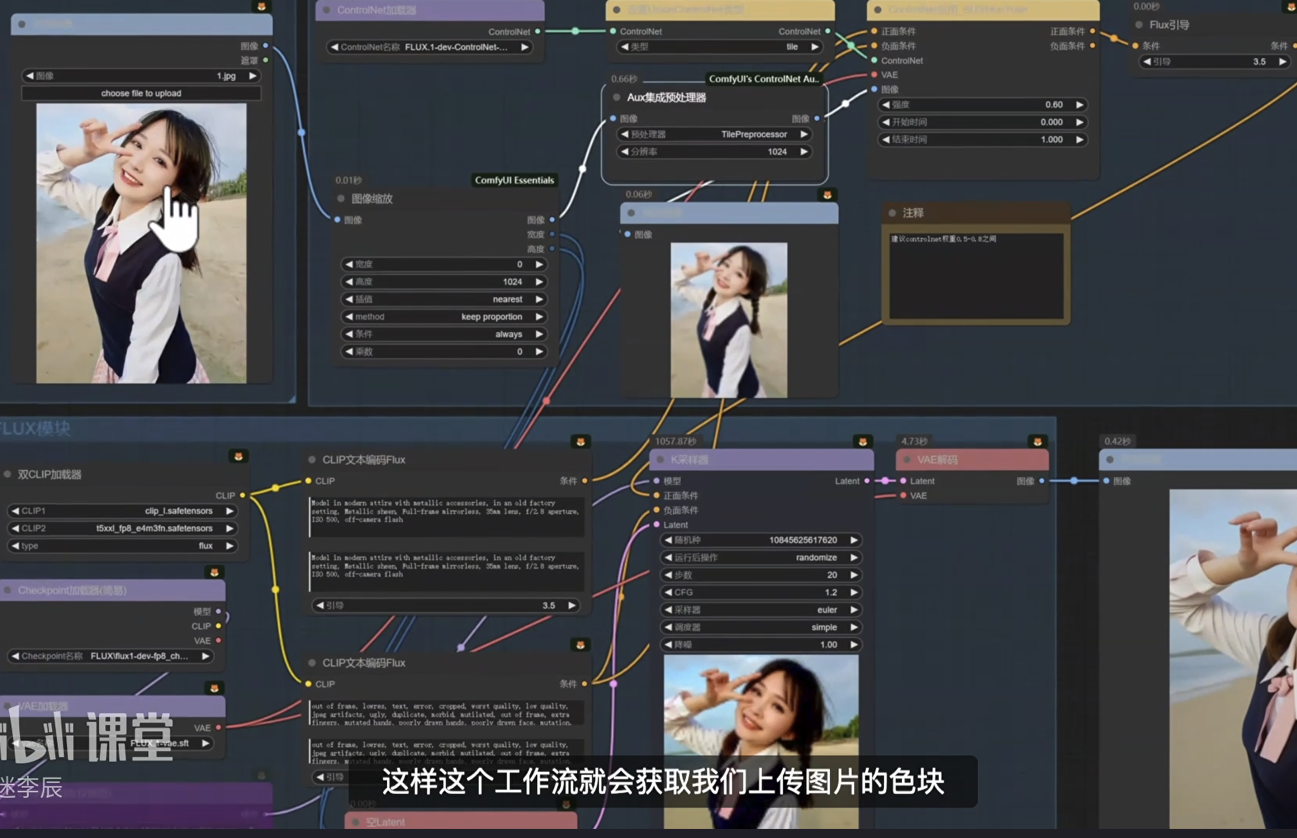
ControlNet = 给 AI 套上 “规矩”,让它严格按你的形状、线条、姿势、结构来画图。

  • 普通生图:AI 自由发挥,产品容易变形、角度乱飞、透视不对。
  • ControlNet:AI 必须遵守你给的轮廓 / 线条 / 深度图,想画歪都难

Controlnet的加载相对复杂一些。要安装controlnet_aux插件,下载Controlnet模型。
模型放置到comfyui安装目录\models\controlnet里面 不过都已经搞好了 只需要双击空白区域,搜索controlnet应用这个节点即可

comfyUI第四阶段难点:

  • ComfyUI更新速度太快导致以往工作流报错
  • 需要学习的插件太多 增加了学习成本
  • 部分插件更新颠覆旧工作流

ComfyUI的原理是黑色代表0,白色代表1;后续需加图像反转进行01反转
降噪:相当于重绘幅度。数值越小,越忠于原图效果。数值越大,画面会改变增加AI想法

使用每个工作流时

理解一下当前工作流的运行逻辑

  • 别人为什么要这样搭建
  • 有没有可以删除、修改、优化的
  • 多看、多想、多思考

Comfyui的原理

条件输入模块中的CLIP(Contrastive Language-lmage Pre-training)对比性语言—图像预训练用于提示词与图像之间进行转化的多模态部件;让我们输入的提示词直接转换到K采样器的潜空间中;通过加噪去噪的步骤来转换成图片,

潜空间(Latent Space):像素非常低,是AI的工作空间;仅需很低的像素就可以正确认识和处理图像 当处理完毕后,再通过像素空间,把潜空间的低像素图片转换成我们肉眼所看的最终像素图片[这个转换的过程就要用到VAE解码器]

Comfyui每个节点都有不同颜色的端口;右边的为输出端口,是用来连接到下一个节点的输入端口中去的;不过每一个节点之间的连线要相同颜色的接口才可以匹配上。

所有的节点输入接口都只能连接一个线路;输入接口只能1对1;输出接口可以1对多

工作流的顺序一般都是从左到右生成的,但核心的最好是从最中心开始也就是K采样器

Clip终止层与LORA的加载

在网站上下载元素时 Usage Tips:CLIP SKIP:2
Clip是一个先进的神经网络,他把我们输入的关键词转换成很多层数值来生成图片
Clip Skip默认值是1 也就是Clip神经网络从开始参与到结束 [计算层1……计算层20]
Clip Skip=2时 也就是 [计算层1……计算层19]
Clip Skip的值会对最终生成的效果有较大的影响

LORA是一种微调模型是依附在大模型身上的,可以在大模型的模型接口拖出一条线就可以看到lora加载器了

绕过:右键节点可以进行绕过,在工作流上就会选择跳过。该节点变淡

CLIP文本编码(SDXL)工作流 与 高级采样器

CLIP文本编码SDXL更加精细化的文本

在空白节点中 右键 → 添加节点 → 高级 → 条件 → CLIP文本编码(SDXL)
CLIP_G:是直接的文本 [有一只精致的猫宇航员穿着太空服在宇宙飞船里面]
CLIP_L:是一个个的关键词 [猫、宇航员、太空服、宇宙飞船]

上面的宽度和高度一般都是生成图片分辨率的两倍/四倍 比如1024 × 1024的图片 就可以设置为2048/4096

CLIP文本编码SDXL(Refiner)

在空白节点中 右键 → 添加节点 → 高级 → 条件 → CLIP文本编码(Refiner)
Refiner是在采样过程中将近结束的时候才起效的
美学分数:是用来设置细化强度的 [一般是4-6 细节增加最好]

K采样器(高级)

高级采样器比普通采样器多了添加噪波和下面的开始/结束降噪步数和返回噪波
关闭天机噪波(因为下面自己添加了) 步数30 开始降噪步数:0 结束降噪部步数:25 → 从一开始运行到25步的时候就转到refiner的采样器了(开启返回噪波 剩下的5步可以返回出去了)

提示词自动翻译与自定义风格预设

  • 直接输入中文
  • 提示词预设
  • 自定义提示词
  • 随机提示词

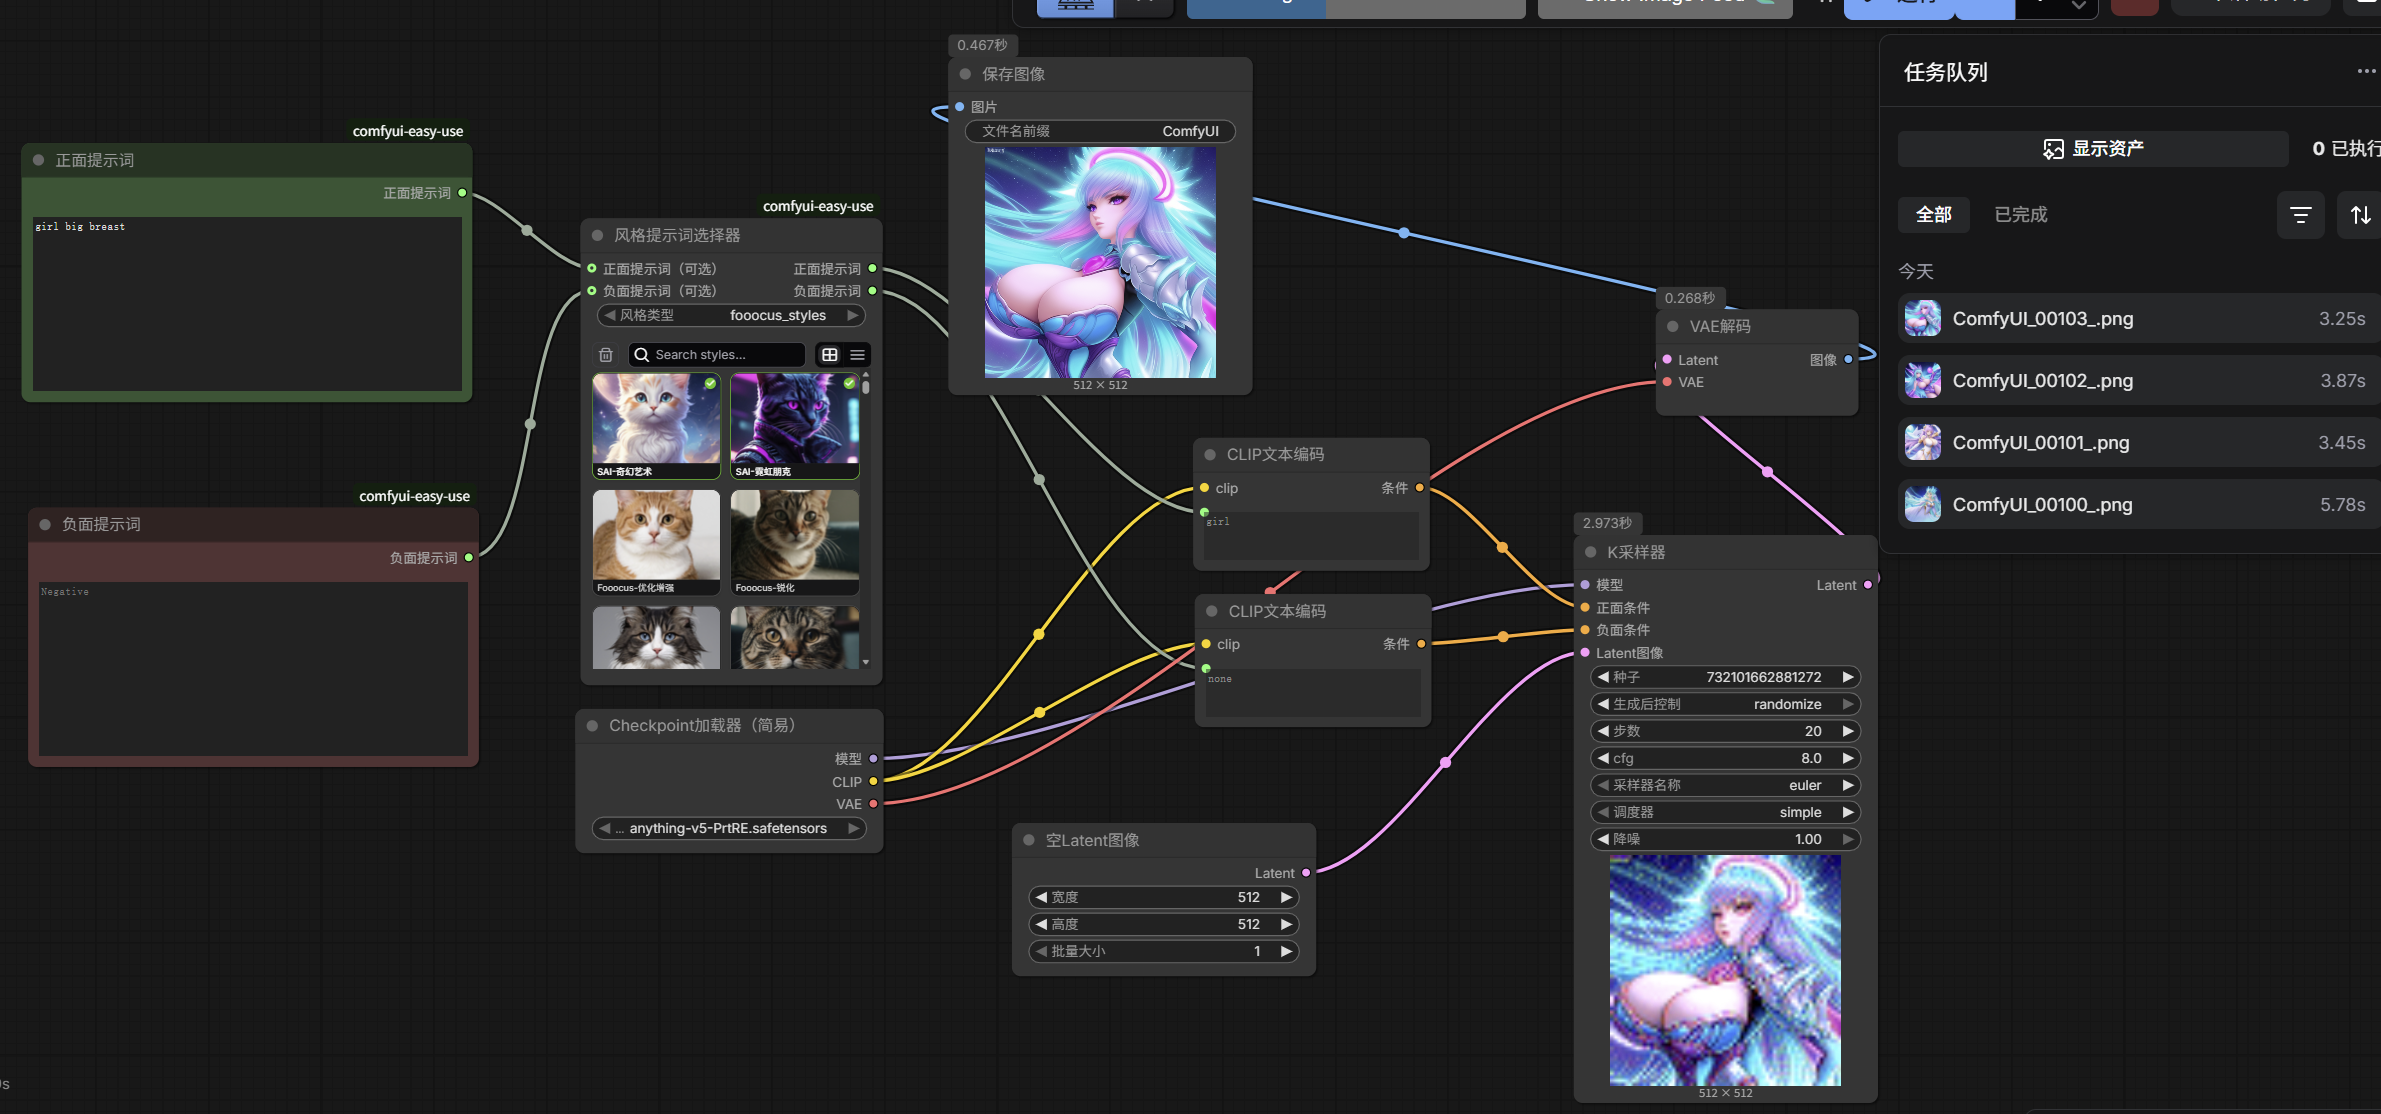
安装ComfyUI Easy Use可以提供一系列提示词预设
安装...alek...翻译功能

在空白区域右键 → 添加节点 → EasyUse → 提示词 → 风格提示词选择器;不过这个是字符串的接口 直接连是无法连接上的,需要把clip文本编码器的提示词右键转换文本为输入[新版本直接可以将正反面提示词连接到文本了]

在前面增加正面提示词和负面提示词

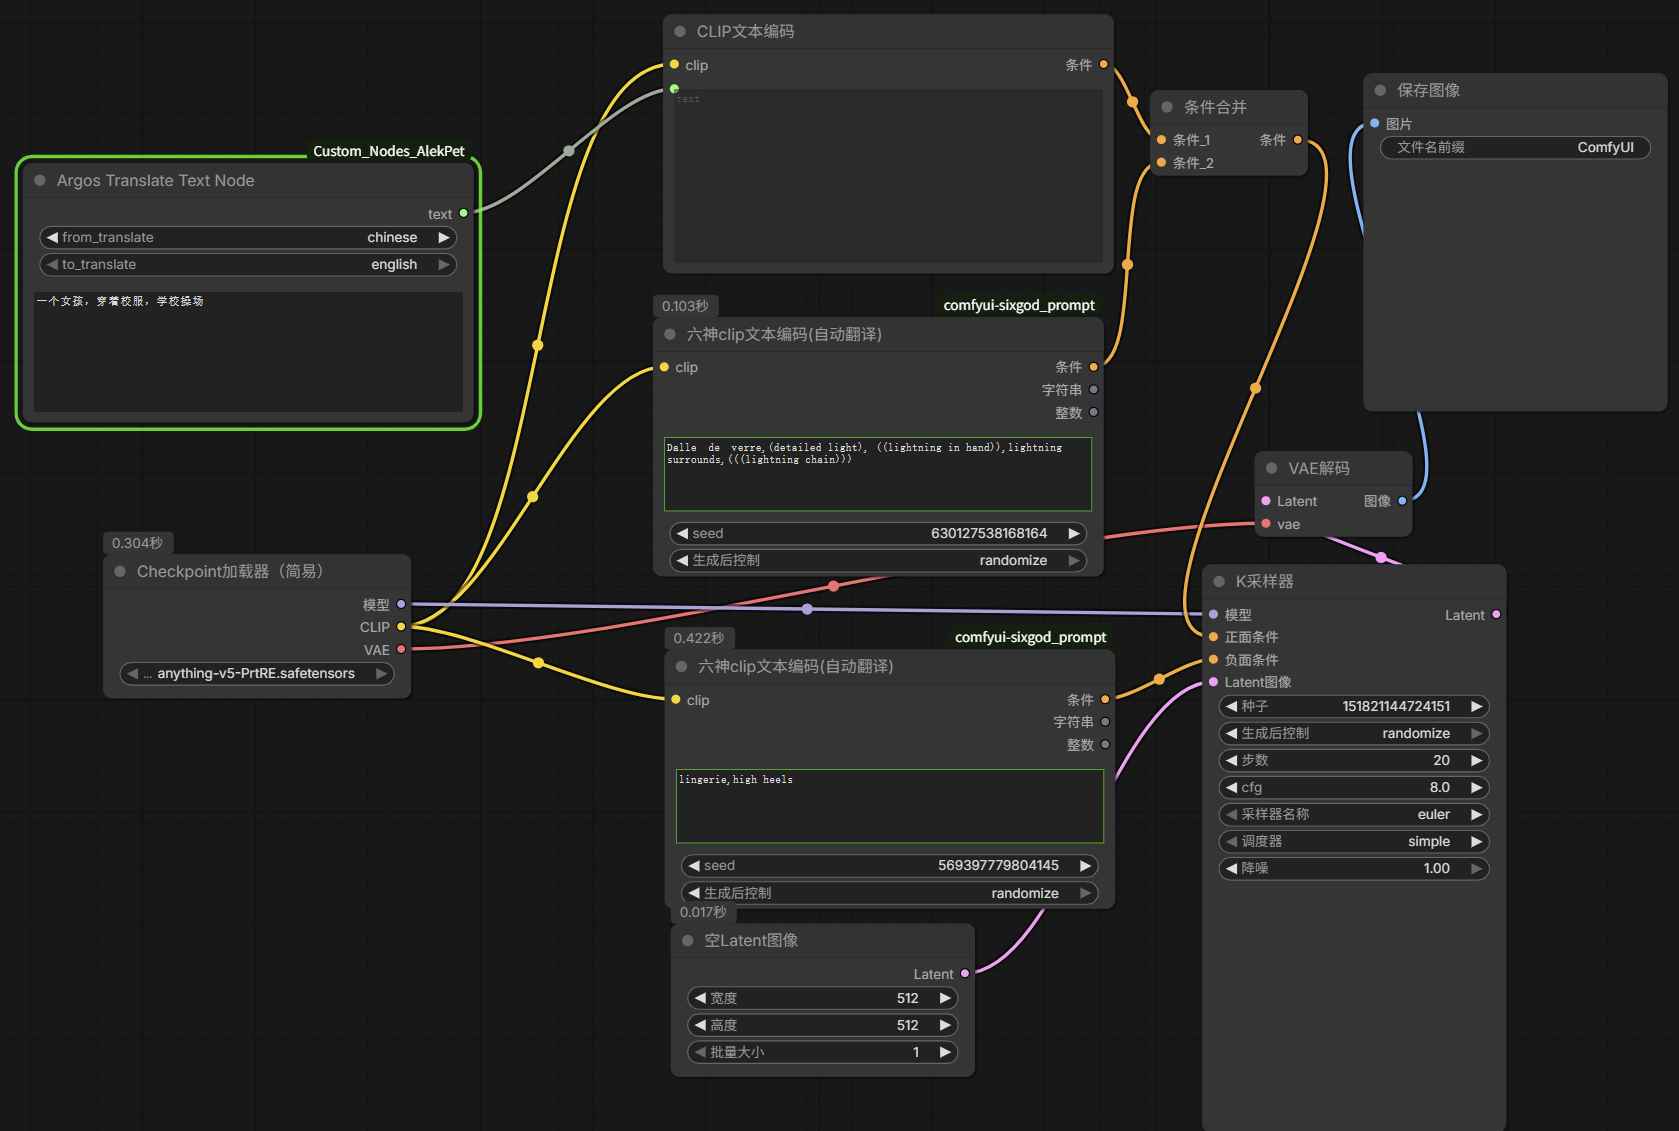
安装 https://github.com/thisjam/comfyui-sixgod_prompt.git **六神clip文本编码(自动翻译)**重启后按Alt + Q进入专门的提示词页面;这里双击才能给六神提示词设置快速选中写入!!

Alt+Q 点击自定义随机词库 在上方先输入prompt提示词后 在配置随机词库中选择 下方的任意标签 以及内部的标签;再随便起个标题 → 发送到提示框

在收藏夹内可以收藏自己的预设!!

★ 很多时候我们输入提示词的时候是直接输入中文的 那么刚刚安装的新插件就可以派上用场了 右键 → 添加节点 → AlekPet Nodes →文本→Deep Translator Text Node(有代理的)

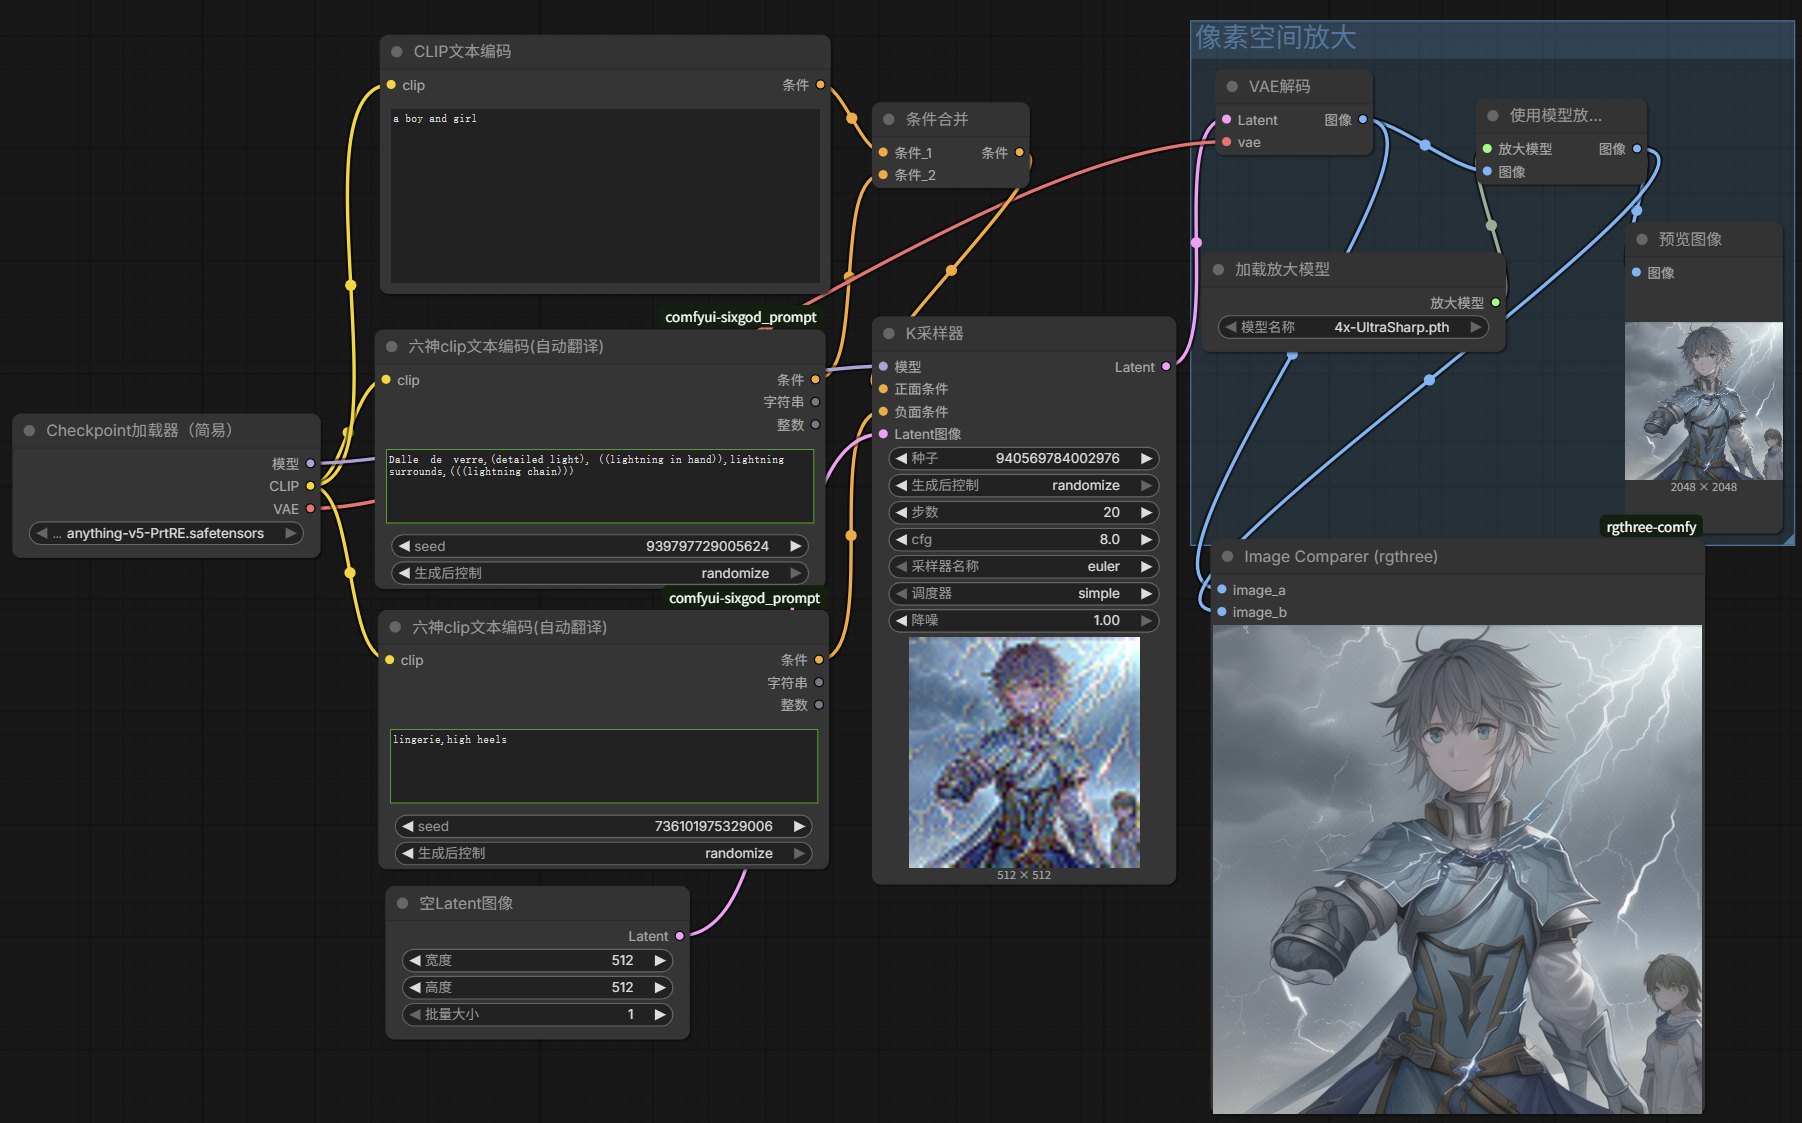
ComfyUI 四种放大方式

下载的模型可以放到ComfyUI目录/models/upscale_models里面

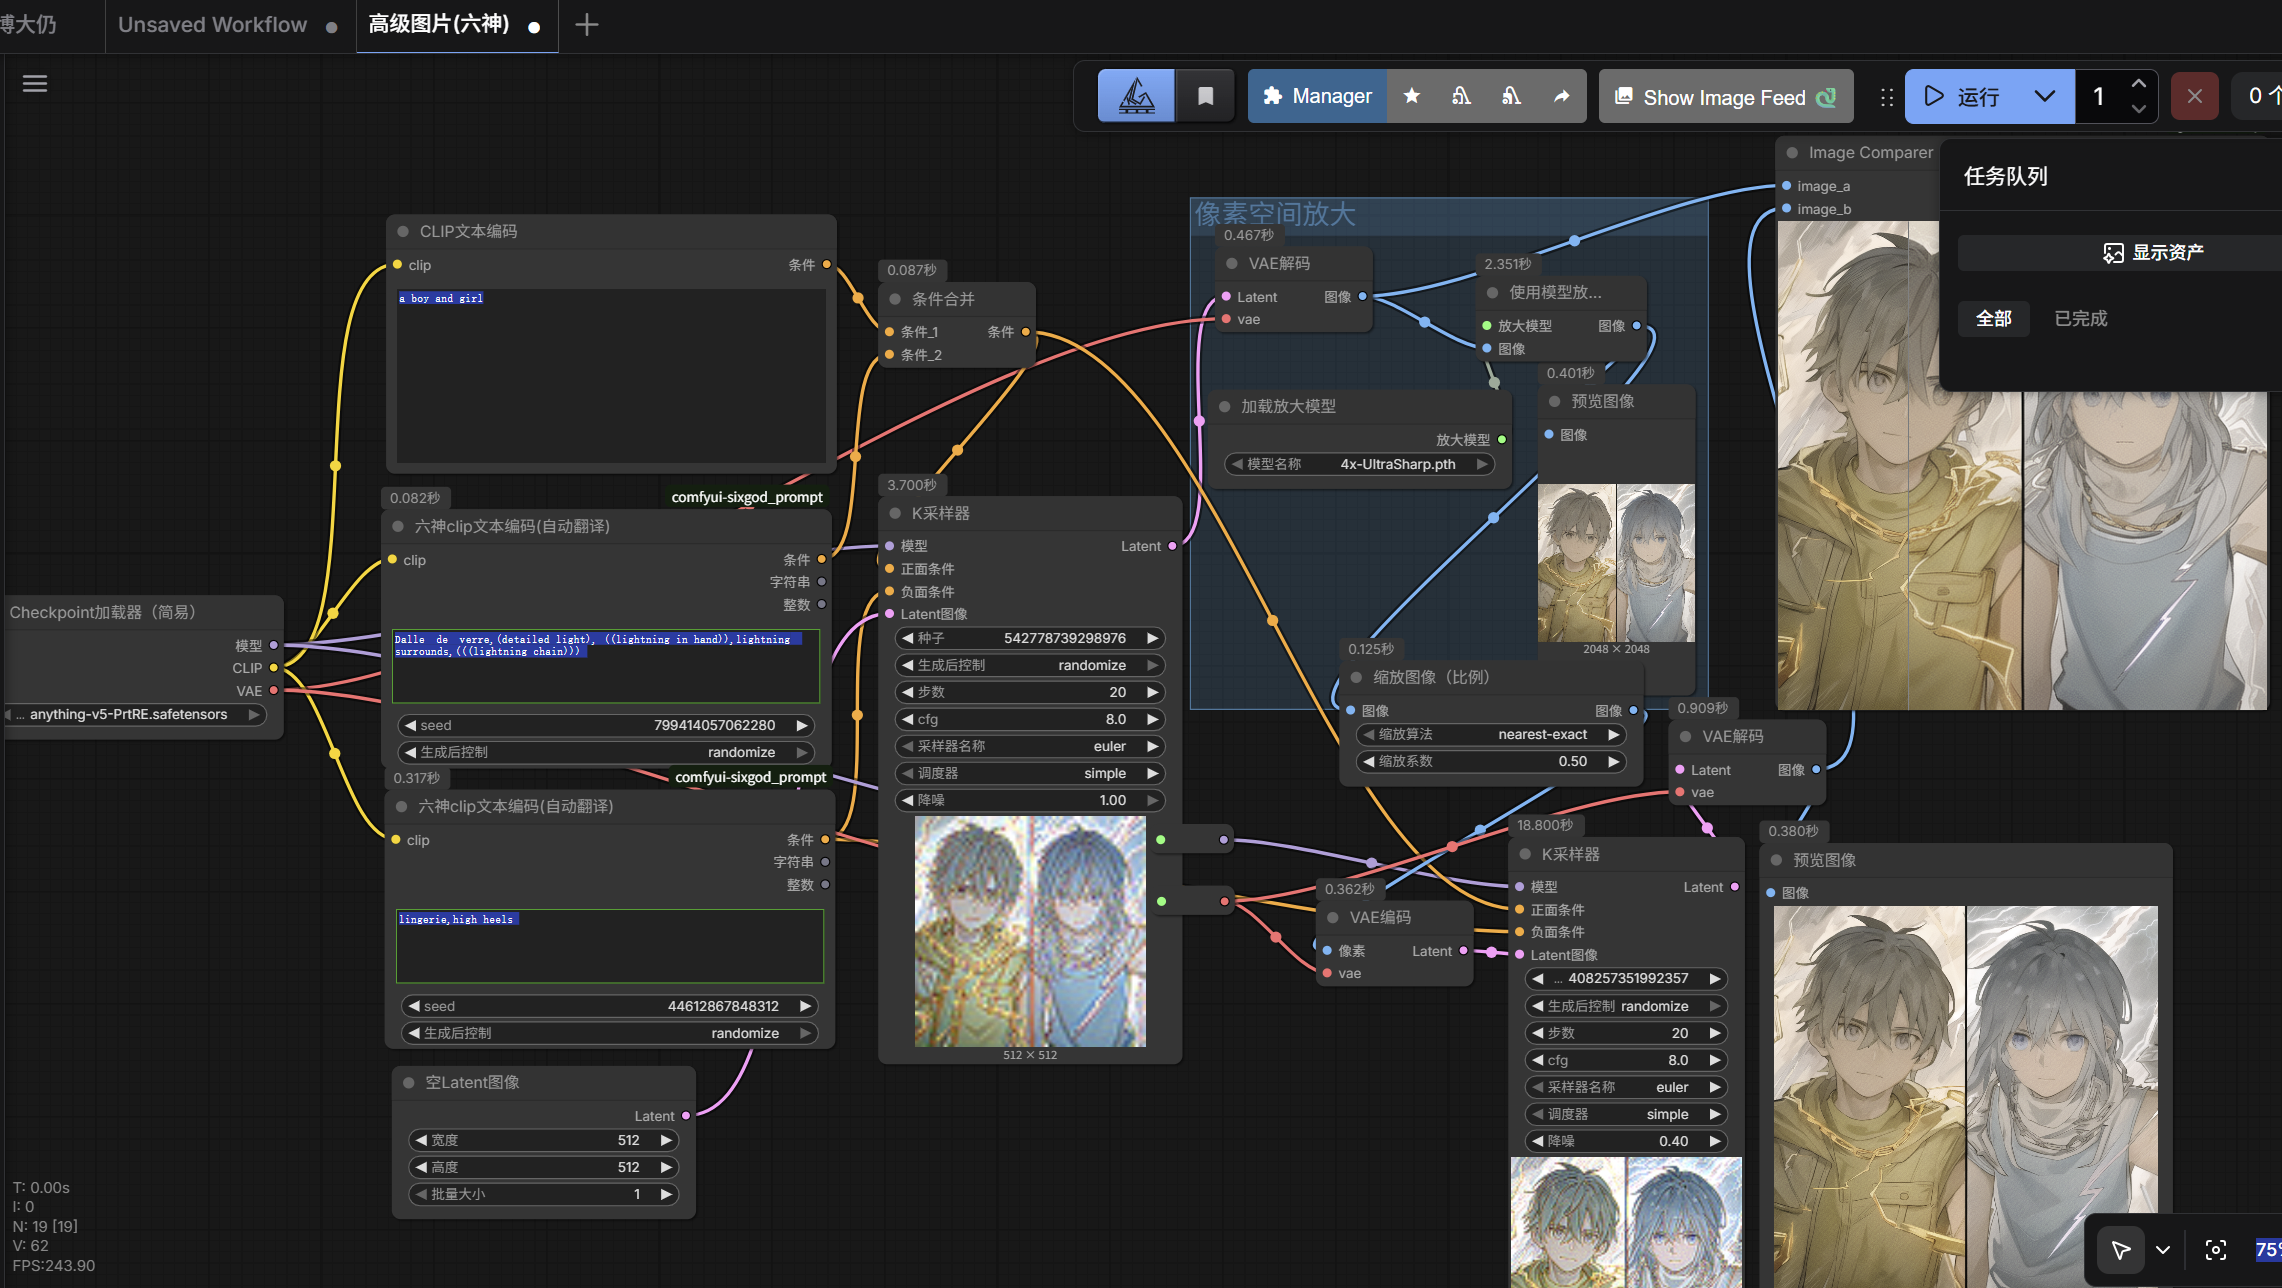
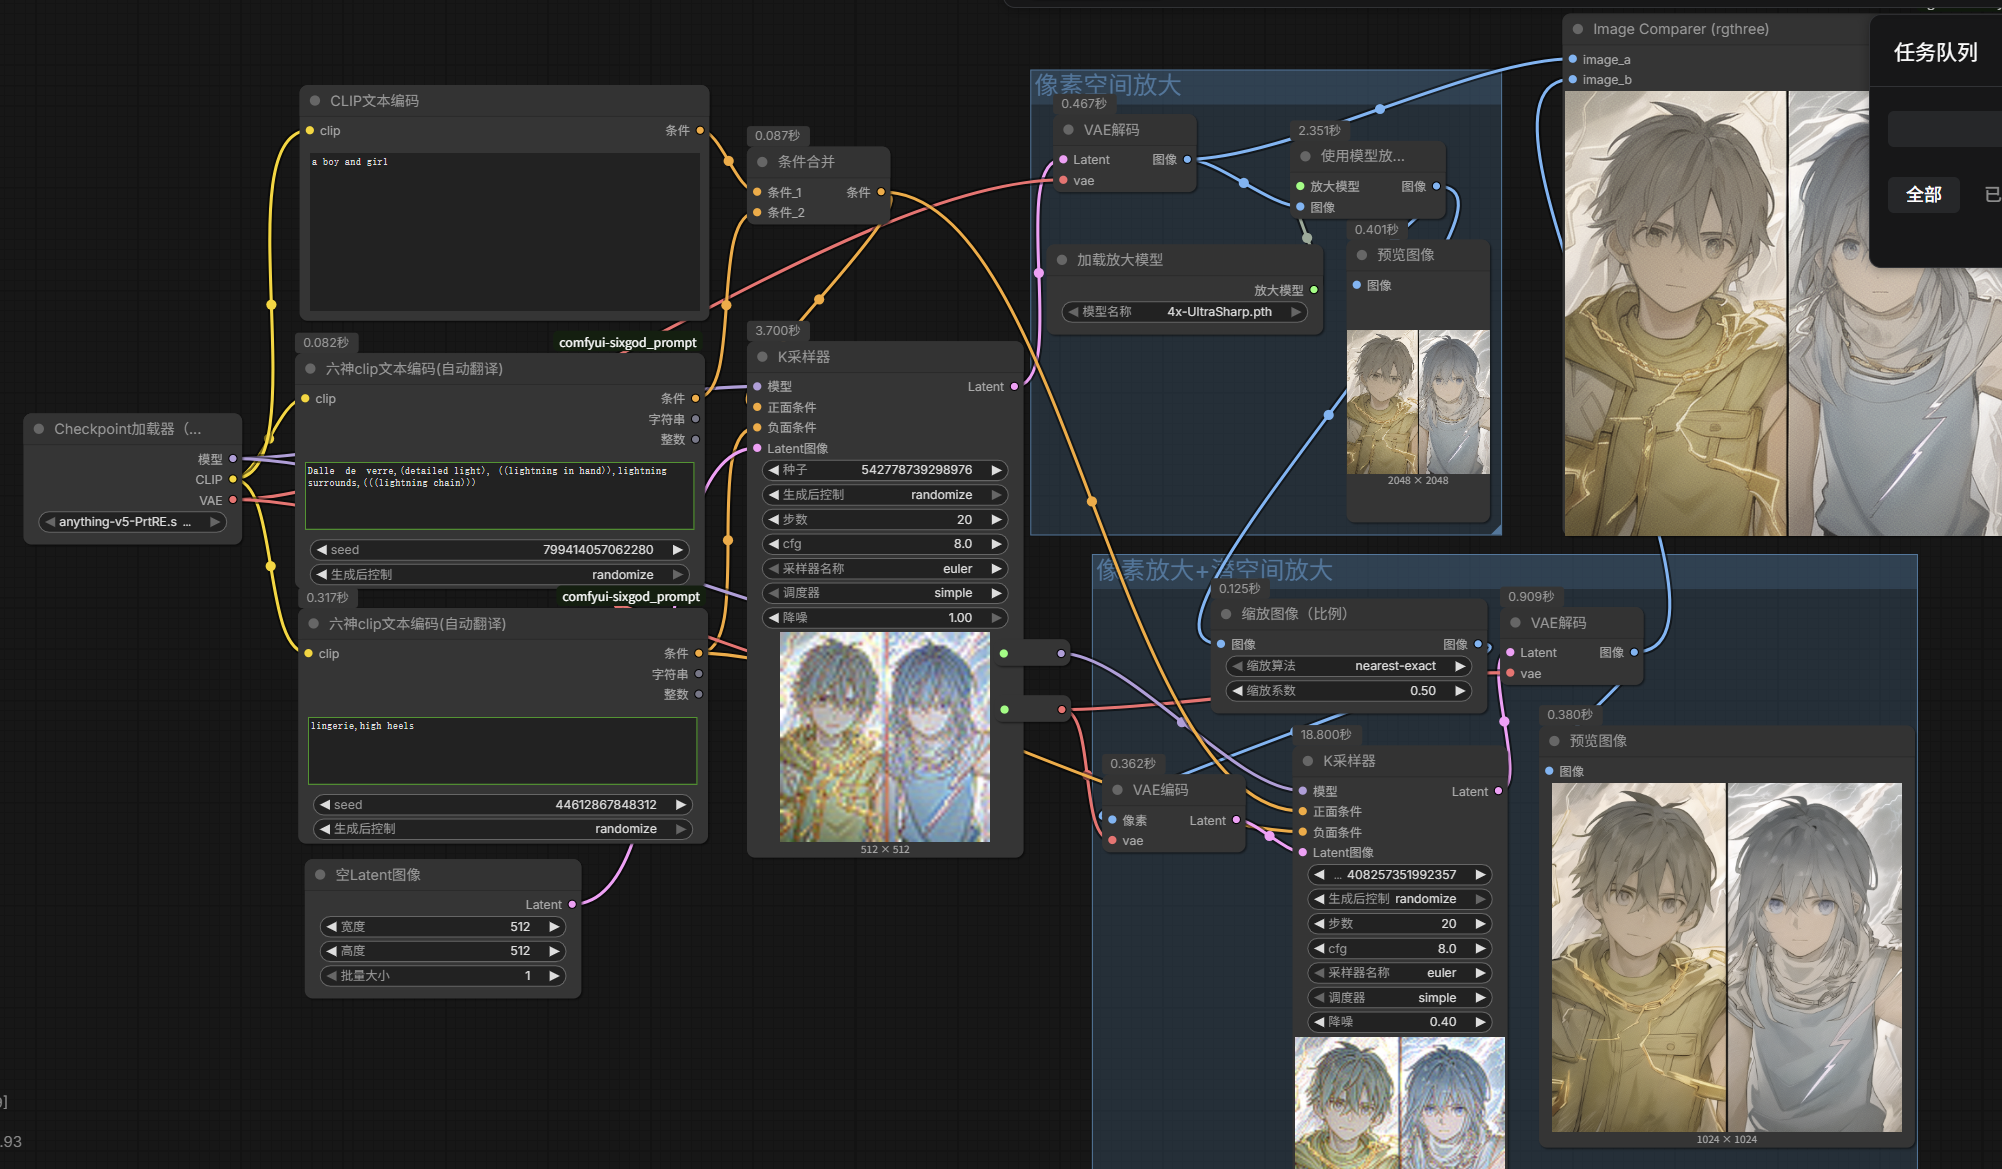
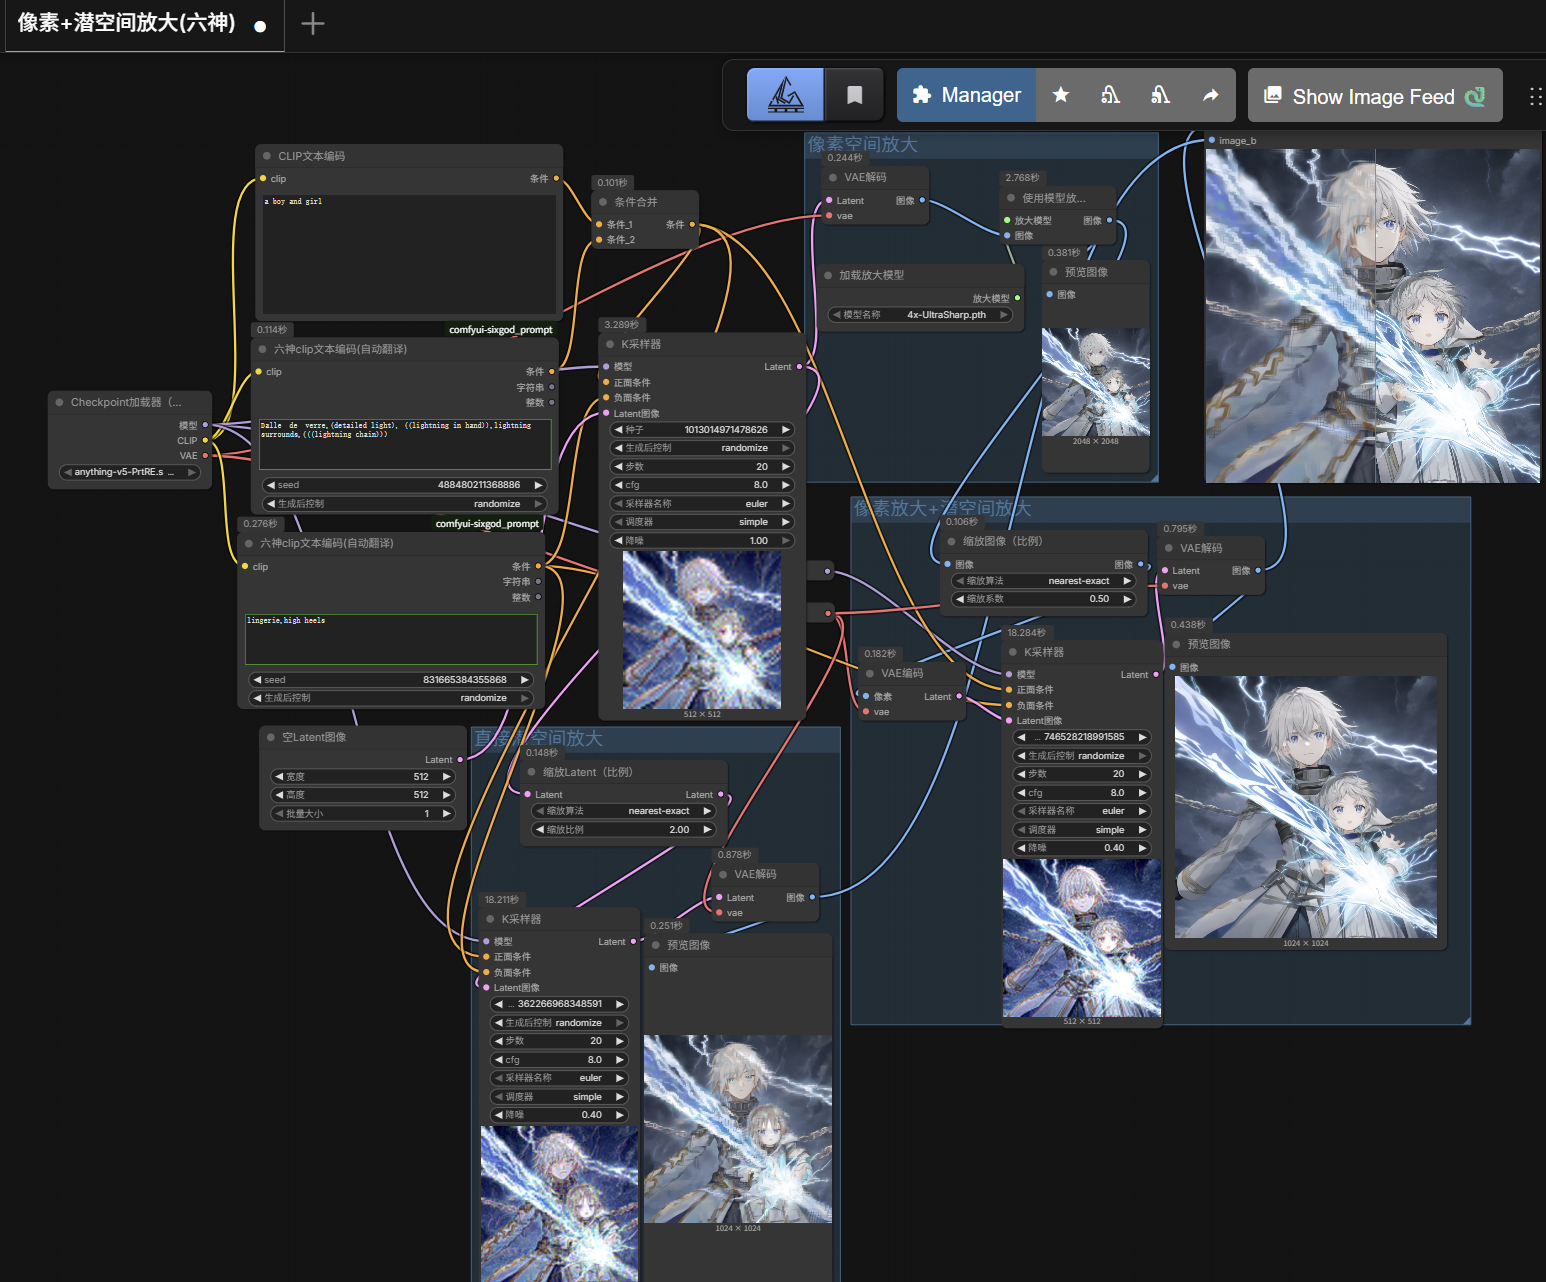
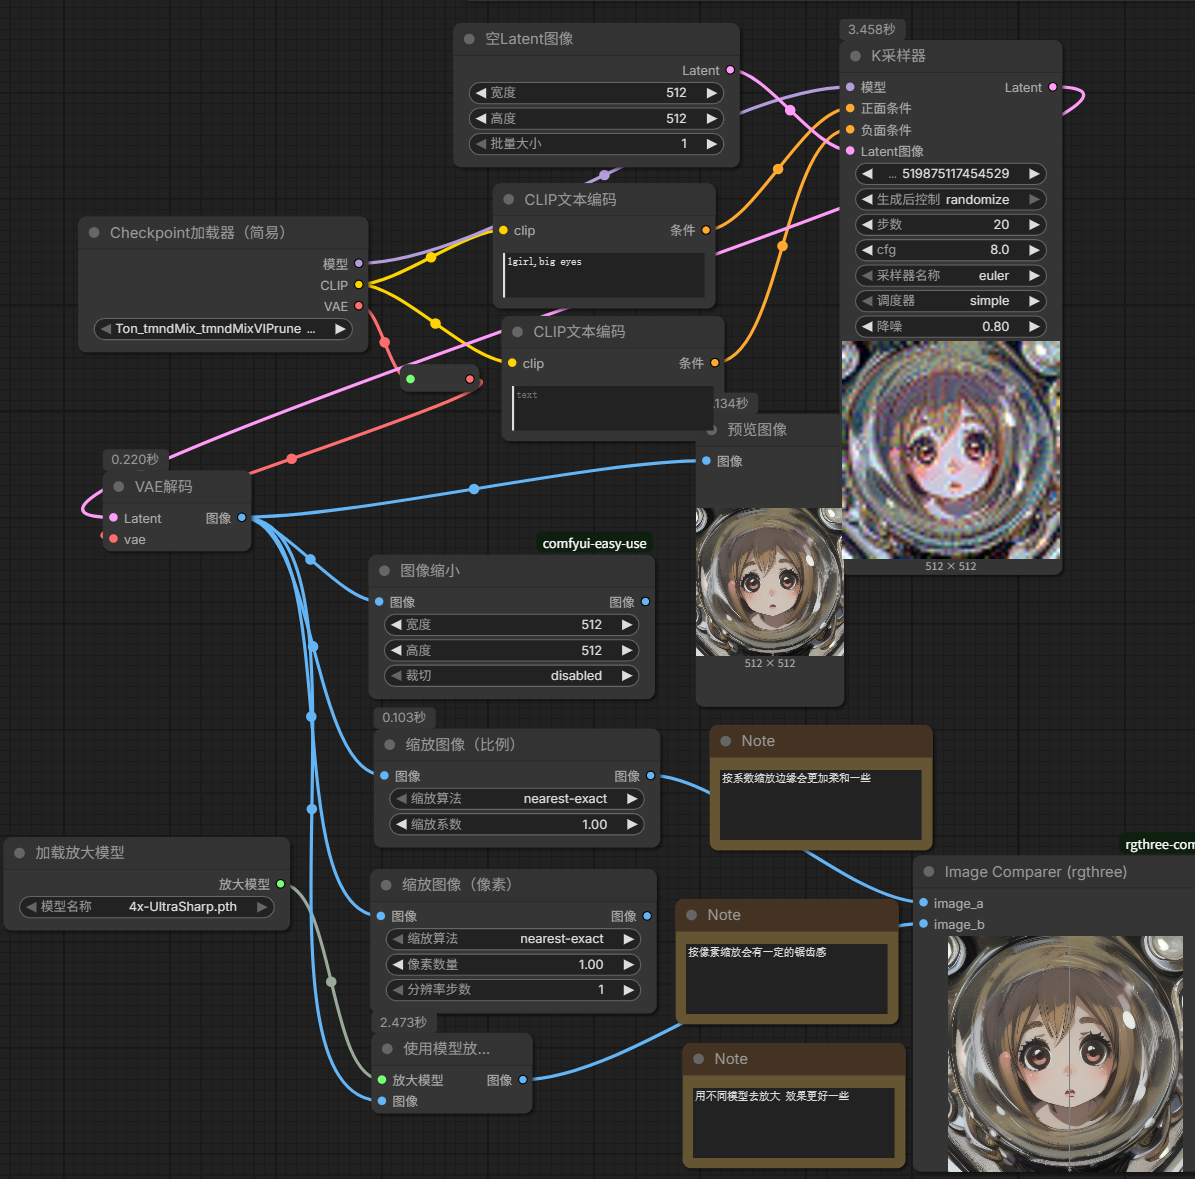
  • 新建节点 → 图像 → 放大 → 使用模型放大图像;然后从该节点的放大模型拖出一条线到空白选择建立加载放大模型 → 选择4x-UltraSharp.pth

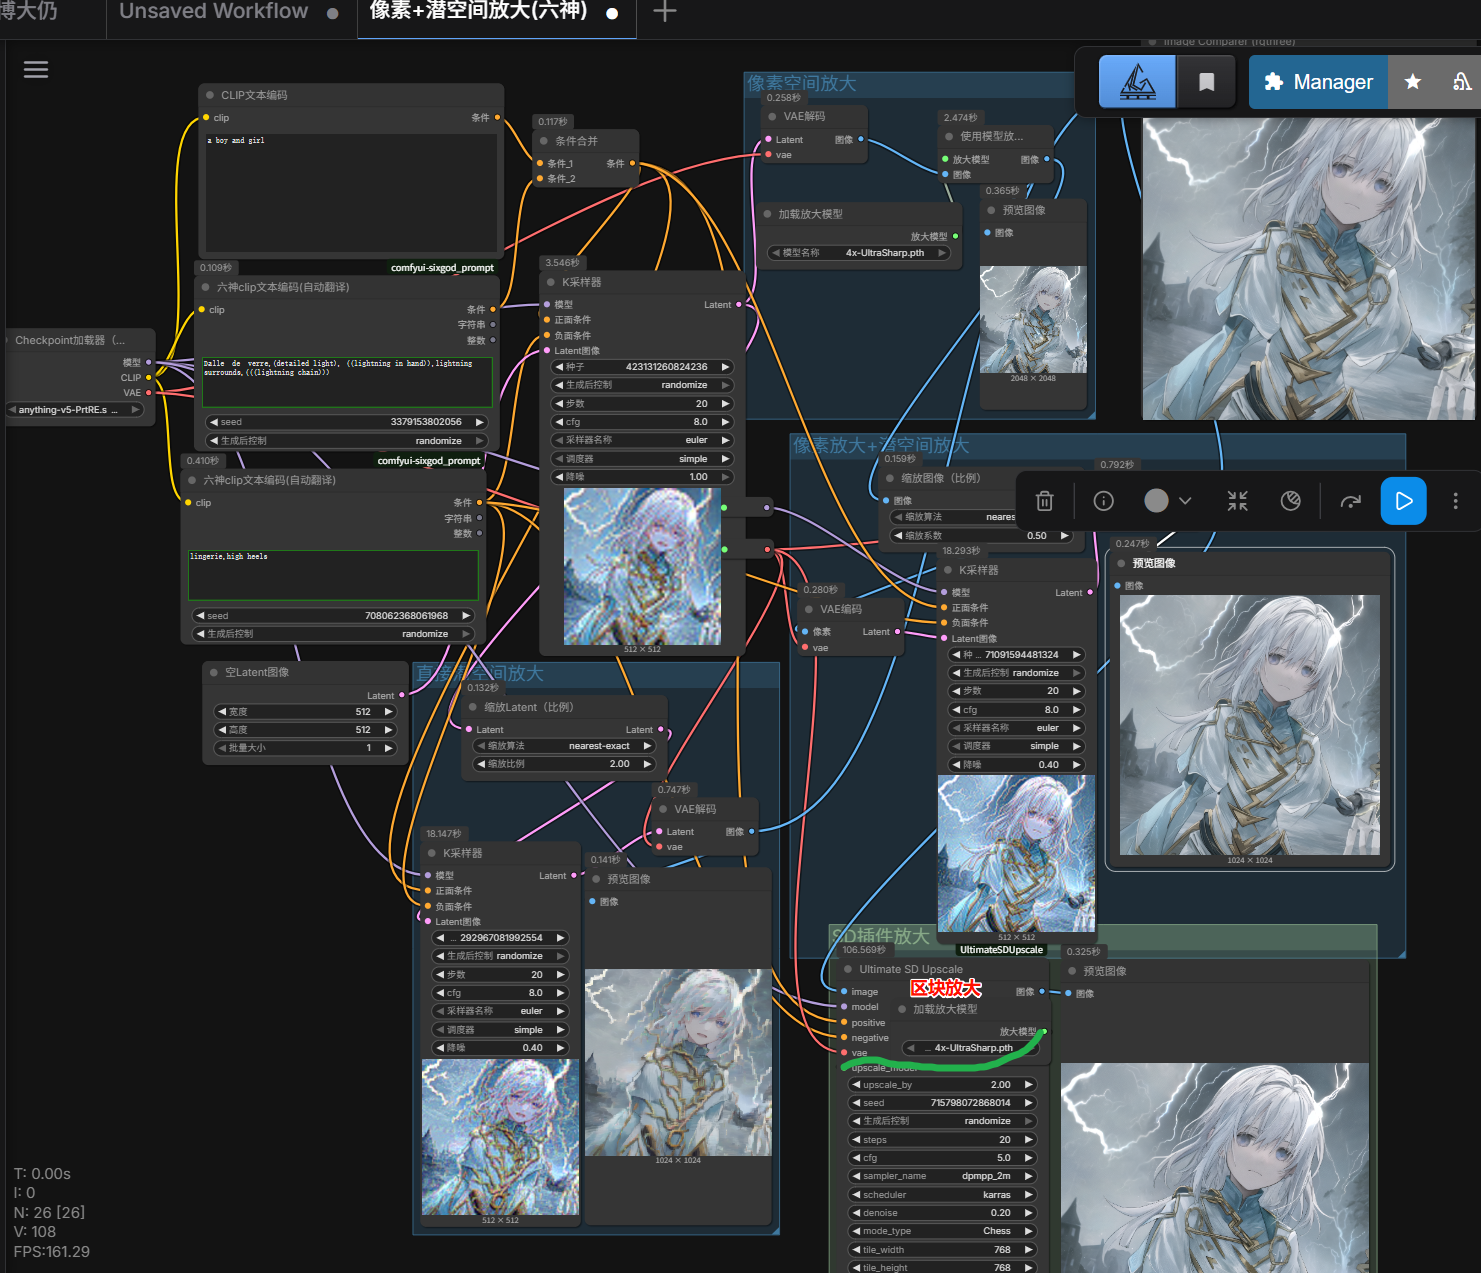
  • 整个流程先进行一次采样,通过图像模型放大节点对第一次采样的像素空间图片放大4倍,把这个4倍的图片重新编码调入到潜空间进行二次采样[由于像素空间进行了四倍的放大,那么这个4倍放大的图片进入潜空间就会非常大了,非常容易导致爆显存和大幅增加渲染时间],所以要在放大的节点后面从图像拖出一个按系数缩放节点 系数0.5(画面缩小50%)。先放大4倍再缩小2倍=放大2倍
    在VAE节点上点击鼠标中键即可快速新建一个转节点出来;由于二次采样,我不希望画质变化太多,所以第二个的k采样器的降噪要改小点

  • 直接在第一层k采样器里拖出一个Latent按系数缩放……

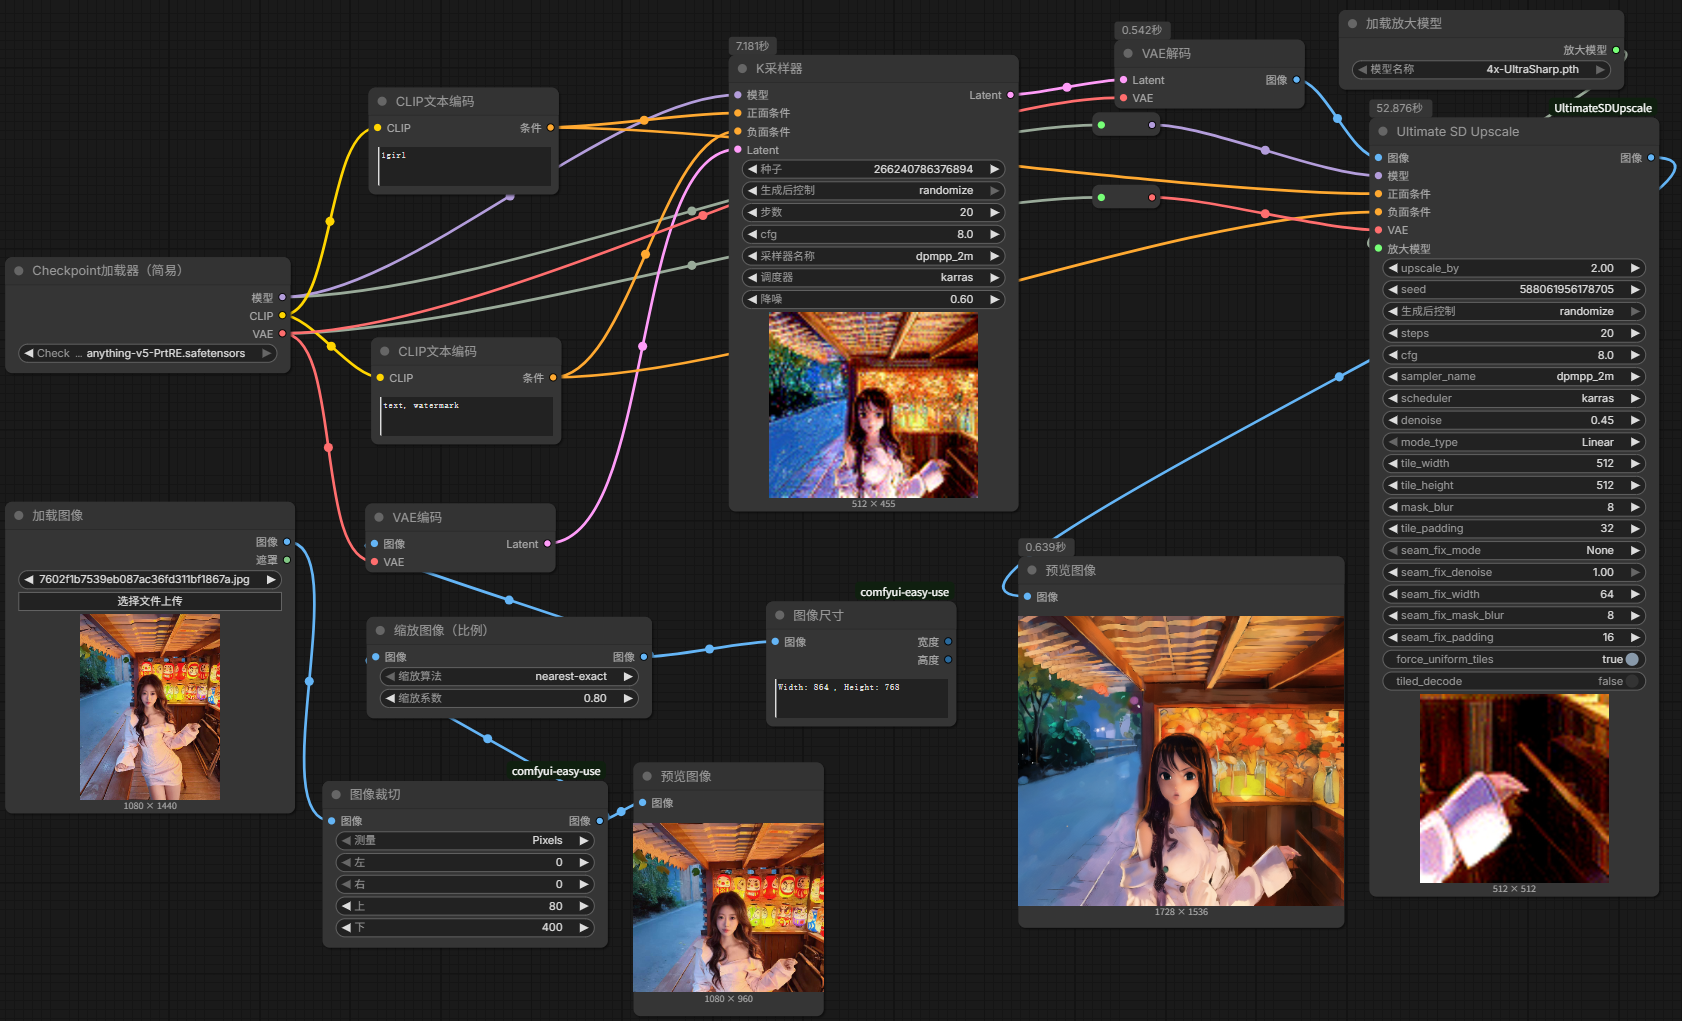
  • 图片放大到4K甚至更高分辨率(若按之前方法就很容易爆显存):需要用到分块放大来节省系统资源;新增Ultimate SD Upscale


精讲一下 CLIP、VAE、Latent

1. 三大核心模型:各自负责什么?

📝 CLIP:文本编码器(把文字变成模型能懂的向量)

  • 本质:OpenAI 开发的多模态模型,负责把自然语言提示词转换成「文本嵌入向量」。
  • 在 SD/SDXL 里的作用
    • 把你的提示词(比如 a girl in school uniform)编码成高维向量,告诉模型「我想要画什么」。
    • SDXL 是双编码器:CLIP-G(全局语义)+ CLIP-L(细节语义),所以用 CLIPTextEncodeSDXL 节点。
  • 关键节点
    • CLIPTextEncode:SD 1.5 用,输入 CLIP 模型 + 提示词,输出 CONDITIONING(条件向量)。
    • CLIPTextEncodeSDXL:SDXL 专用,分别输入 text_g 和 text_l 提示词。

🎨 VAE:图像编码器 / 解码器(像素 ↔ 潜在空间)

  • 本质:变分自编码器,负责在「像素图像」和「潜在空间(Latent)」之间互相转换。
  • 核心功能
    1. 编码(Encode):把高清图片压缩成小尺寸的 Latent 向量(比如 1024×1024 像素 → 128×128 潜在特征),大幅降低计算量。
    2. 解码(Decode):把生成好的 Latent 向量还原成可预览的 PNG/JPG 像素图。
  • 关键节点
    • VAEEncode:输入图像 + VAE 模型 → 输出 LATENT。
    • VAEDecode:输入 LATENT + VAE 模型 → 输出图像。
  • 注意:SDXL 有专门的 VAE,不能和 SD 1.5 的混用,否则会出噪点 / 颜色崩坏。

✨ Latent:潜在空间(模型真正「画图」的地方)

  • 本质:高维特征空间,是 Stable Diffusion 模型实际操作的中间表示,不是肉眼可见的图片。
  • 作用
    • 比原始像素图小很多(比如 8× 压缩),让扩散模型能高效迭代生成。
    • 承载了图像的「结构、风格、细节」等核心信息,是 KSampler 迭代的对象。
  • 关键节点
    • EmptyLatentImage:生成空白 LATENT(决定画布尺寸)。
    • LatentComposite:把多个 LATENT 合成。
    • LatentUpscale:对 LATENT 做超分。

2. 文生图完整数据流:节点是怎么连起来的?

我们用最经典的「文生图」工作流来串一遍,你就能理解每个节点的角色:

1. 文本输入 → CLIPTextEncode → CONDITIONING(告诉模型画什么)
2. EmptyLatentImage → LATENT(空白画布,决定尺寸)
3. CheckpointLoader → 模型本体 + CLIP + VAE
4. CONDITIONING + LATENT + 模型 → KSampler(核心生成步骤)
5. 生成后的 LATENT → VAEDecode → 最终图像

🔄 分步拆解原理

  1. 提示词编码阶段
    • Text 节点输入中文 / 英文提示词 → 连接到 CLIPTextEncode 的 text 端口。
    • CheckpointLoader 输出的 CLIP 模型 → 连接到 CLIPTextEncode 的 clip 端口。
    • 输出 CONDITIONING:这是「文本条件」,告诉扩散模型「我要生成符合这个描述的图」。
  2. 潜在空间初始化
    • EmptyLatentImage 节点设置宽高(比如 1024×1024)→ 输出空白 LATENT。
    • 这相当于给模型一张「隐形画布」,所有生成操作都在这上面进行。
  3. 扩散生成阶段(KSampler)
    • 这是 ComfyUI 的「心脏」,负责迭代去噪生成图像:
      • 输入:LATENT(画布)、positive CONDITIONING(正向提示词)、negative CONDITIONING(反向提示词)、model(扩散模型本体)。
      • 原理:从随机噪声开始,一步步根据文本条件「擦掉」噪声,逐步逼近目标图像。
      • 输出:生成完成的 LATENT(还不是图片,是特征向量)。
  4. 图像解码阶段
    • KSampler 输出的 LATENT → 连接到 VAEDecode 的 samples 端口。
    • CheckpointLoader 输出的 VAE 模型 → 连接到 VAEDecode 的 vae 端口。
    • 输出:最终的像素图像(IMAGE 类型),可以用 PreviewImage 或 SaveImage 节点查看 / 保存。

4. 一句话总结

  • CLIP:把文字变成模型能懂的「指令向量」。
  • KSampler:拿着 CLIP 的指令,在 Latent 画布上迭代生成,最后用 VAE 翻译成图片。
  • VAE:在「像素图」和「潜在特征」之间做翻译。
  • Latent:模型真正画图的「隐形画布」。

Controlnet核心节点串联

知识点讲解

你现在学的是 ComfyUI 最核心、最强大的功能,搞懂这个,你就入门高阶 AI 画图了。

  • ControlNet 加载器 = 拿工具
  • ControlNet 应用 = 用工具
  • 串一起 = 让 AI 严格按你的要求画图,不乱来

二、ControlNet 加载器 是干啥的?

作用:加载 ControlNet 模型

你可以把它理解成:

给 AI 配一个 “专用规则老师”

比如:

  • OpenPose 模型 → 管姿势
  • Canny 边缘模型 → 管线条结构
  • Depth 模型 → 管景深、立体
  • Lineart 模型 → 管线稿

加载器干的事:

  1. 从你的硬盘里读取 .safetensors 模型
  2. 告诉系统:我现在要用这个规则

它不处理图片,只负责把模型准备好。

增加一个OpenPose Pose姿态预处理器、再加一个应用controlnet(高级)
在ControlNet拉出一条线 → DiffControlNet加载器(向下兼容controlnet加载器)

三、ControlNet 应用(Apply ControlNet)是干啥的?

作用:把规则强行灌给主模型,让它听话

主模型(SD/SDXL)本来是自由发挥的。

ControlNet 就是强制约束。

Apply 节点干两件事:
  1. 接收 预处理好的图(OpenPose 骨架、Canny 线条、深度图…)
  2. 把 约束规则 注入到生成过程中

简单说:

AI 必须按这个结构 / 姿势 / 线条来画,不能乱变。

四、它俩为什么必须串联?

因为:

光有模型不行,光有指令也不行,必须结合。

正确逻辑链:
  1. ControlNetLoader

    → 加载姿势 / 边缘 / 深度模型

  2. ControlNetApply

    → 把这个约束应用到画图过程

串联后效果:

主模型(画内容) + ControlNet(定结构)= 精准可控的画面

没有加载器 → 没有规则

没有应用 → 规则不生效

五、controlnet有哪些场景?

ControlNet 的本质:

强行控制画面的结构、姿势、线条、空间、视角,让 AI 不乱画。

1. 控制人物姿势(最常用)

用 OpenPose

  • 固定人物动作:站、坐、跳、躺、比心、跳舞
  • 不让手崩、不让姿势乱飞
  • 想画什么动作,先摆好骨架,AI 照着画

用途:

角色插画、COS 图、动态人物、二次元姿势


2. 控制画面线条 / 轮廓

用 Canny / LineArt

  • 你给一张线稿 → AI 帮你上色、细化
  • 你给一张草图 → AI 帮你精修
  • 强制保留物体轮廓,不改变构图

用途:

线稿上色、草图转插画、漫画上色


3. 控制画面深度 / 空间

用 Depth

  • 控制:谁在前、谁在后
  • 控制:近大远小、立体感、透视
  • 画场景、建筑、室内特别稳

用途:

场景画、建筑、室内设计、写实风景


4. 控制人体结构 / 姿态更精准

用 DensePose / OpenPose

  • 人体结构不崩
  • 动作更自然
  • 多人物不乱叠

5. 控制画面构图 / 边缘结构

用 SoftEdge / HED / Canny

  • 你定好:人物在哪、物体在哪
  • AI 只负责画内容,不改变布局
  • 做分镜、故事板超好用

6. 控制人脸角度、五官位置

用 FaceLandmark

  • 正脸、侧脸、45° 想定就定
  • 不歪脸、不崩五官
  • 做头像、证件照、角色脸

7. 控制画面风格、边缘、质感

用 Shuffle / Tile / Style

  • 强化细节
  • 高清修复
  • 保持风格统一

8. 控制画面 “语义”:什么东西在哪

用 Seg(语义分割)

  • 天空、地面、人物、建筑
  • 强制分区,AI 不能画错区域
  • 做场景、建筑、环境设计最稳

9. 控制画面 “正常姿势” 不崩坏
用 OpenPose + Depth
  • 手不崩
  • 身体不扭曲
  • 多人不乱跑
  • 视角不乱飞

这是画人物必开组合。


10. 做 “同一动作、不同画风” 批量出图

一个姿势骨架

→ 换模型、换风格、换衣服

→ 动作完全不变

做表情包、角色设定、系列图神器。


🧠 最简单记忆法
  • OpenPose = 管人动作
  • Canny = 管线条轮廓
  • Depth = 管空间立体
  • LineArt = 管线稿
  • Seg = 管物体位置
  • Face = 管脸

🔥 最实用的 3 个组合(你必学)
  1. OpenPose + 主模型

    画人物不崩姿势

  2. Canny + 主模型

    线稿上色、结构不变

  3. Depth + 主模型

    场景、建筑、透视超准

调整人物骨骼编辑&控制

安装插件ComfyUI-Openpose-Editor-Plus这个插件只能调整大骨骼
所以再通过Git URL安装一个https://github.com/yanlang0123/ComfyUI_Lam.git

修复 ComfyUI Manager 安全级别错误

当通过 Git URL 安装 ComfyUI 插件时遇到 This action is not allowed with this security level configuration 报错,本质是ComfyUI Manager的安全策略限制了外部代码执行。本教程提供了方案,覆盖 Windows/macOS/Linux 全平台操作。

其实在 ComfyUI Manager 的仓库中已经有说明如何解决这个问题,
E:\ComfyUI-AI_DeskTop\ComfyUI-aki-v3\ComfyUI\user__manager
通过修改 config.ini 文件来修改安全级为 weak 即可解决。

安装完毕后双击寻找openpose→姿态编辑器
ref可以给当前节点添加一个参考图进来,并且可以改变图片的宽度和高度,点击显/隐画板就可以调出画板出来
把人体、脸部、手部骨骼文件下载并导入到E:\ComfyUI-AI_DeskTop\ComfyUI-aki-v3\ComfyUI\custom_nodes\comfyui_controlnet_aux\cache\lllyasviel\Annotators
人体:body_pose_model.pth
手部:hand_pose_model.pth
脸部:facenet.pth

如果插件冲突或者版本不对直接在missing里面找一下上面的IMPORT FAILED报错,然后问豆包 安装缺少的东西

PS E:\ComfyUI-AI_DeskTop\ComfyUI-aki-v3>

完美!我看到真正的问题了!你的系统装了 Python3.13,和 ComfyUI 自带的 Python 打架了,所以命令直接报错!

我给你最终、最简单、100% 能成功的方案,不用管任何复杂路径,直接复制运行!

终极一键修复(复制这 3 行,直接运行)

E:\ComfyUI-AI_DeskTop\ComfyUI-aki-v3\python

在你现在这个 蓝色 PowerShell 窗口里,直接复制粘贴这 3 条命令,一条一条运行:

.\python\python.exe -m pip uninstall tensorflow -y
.\python\python.exe -m pip uninstall protobuf -y
.\python\python.exe -m pip install protobuf==4.25.3

..\..\..\python_embeded\python -m pip install -r requirements.txt 来手动安装各种python

ComfyUI反推提示词WD

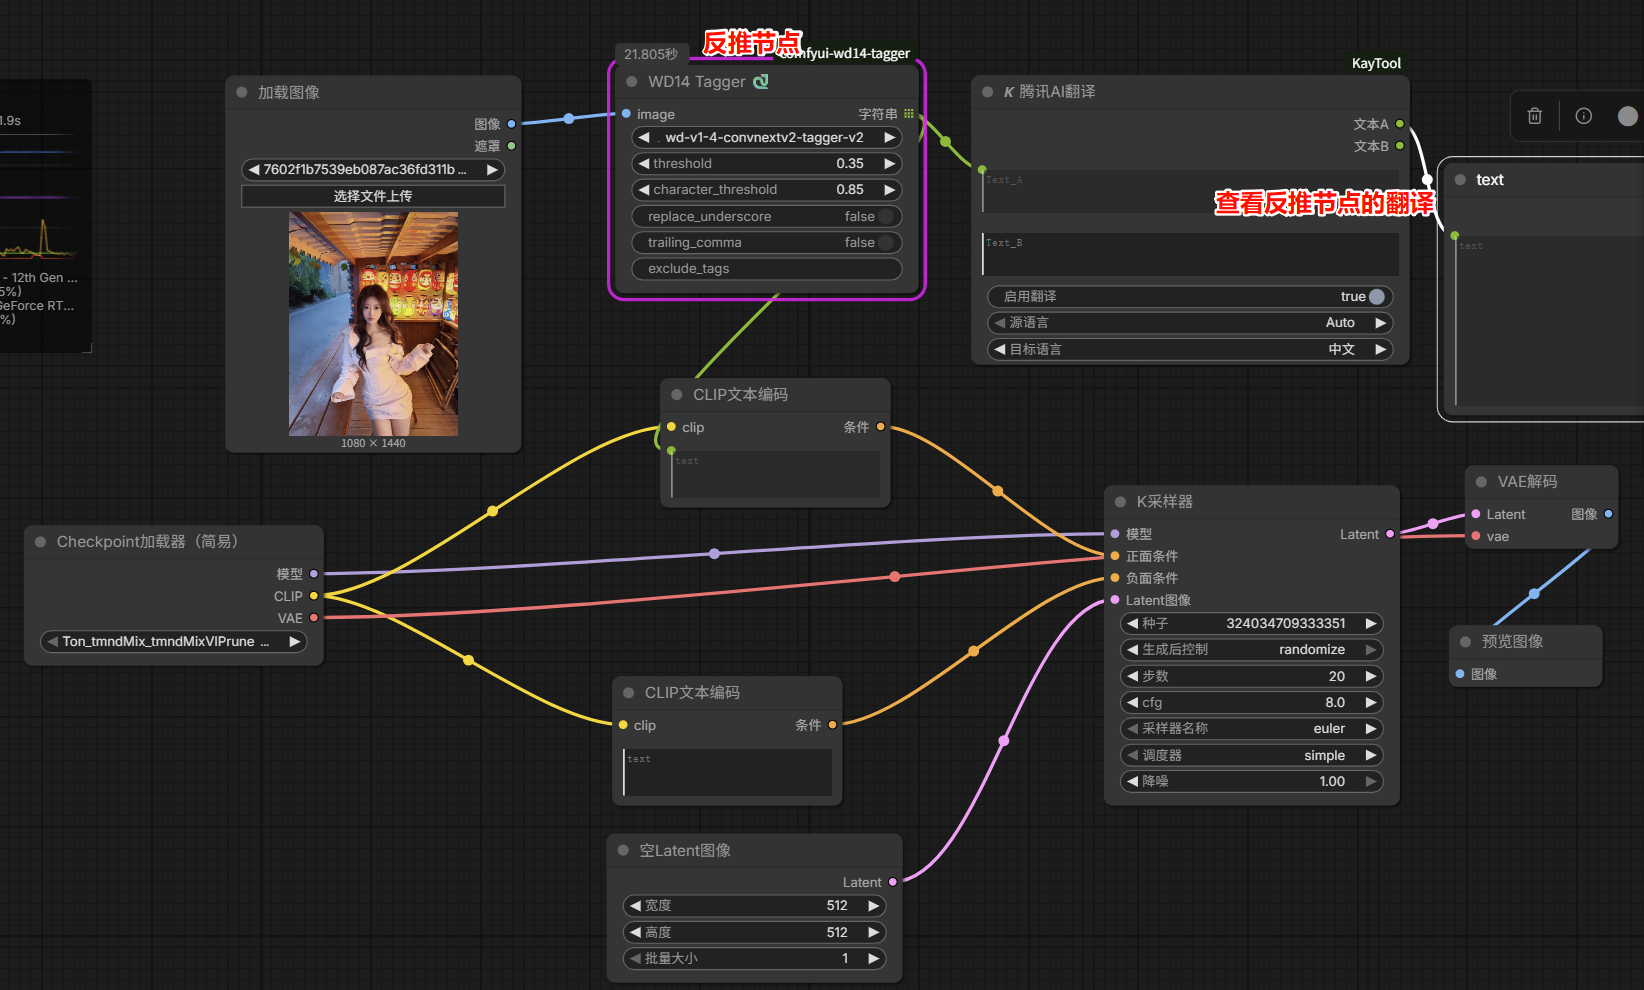
WD14 Tagger

  • threshold(阈值):数值越高,抓取的提示词越少;
  • character_tthreshold(人物特征特提示词):比上方阈值效果低
  • exclude_tags(排除元素):cat可以排除

图像尺寸 图像缩放 裁剪节点

尺寸太大会直接变形、畸变
SD1.5大模型基础出图分辨率最多只能去到768分辨率
大尺寸等比缩小再传到k采样器中

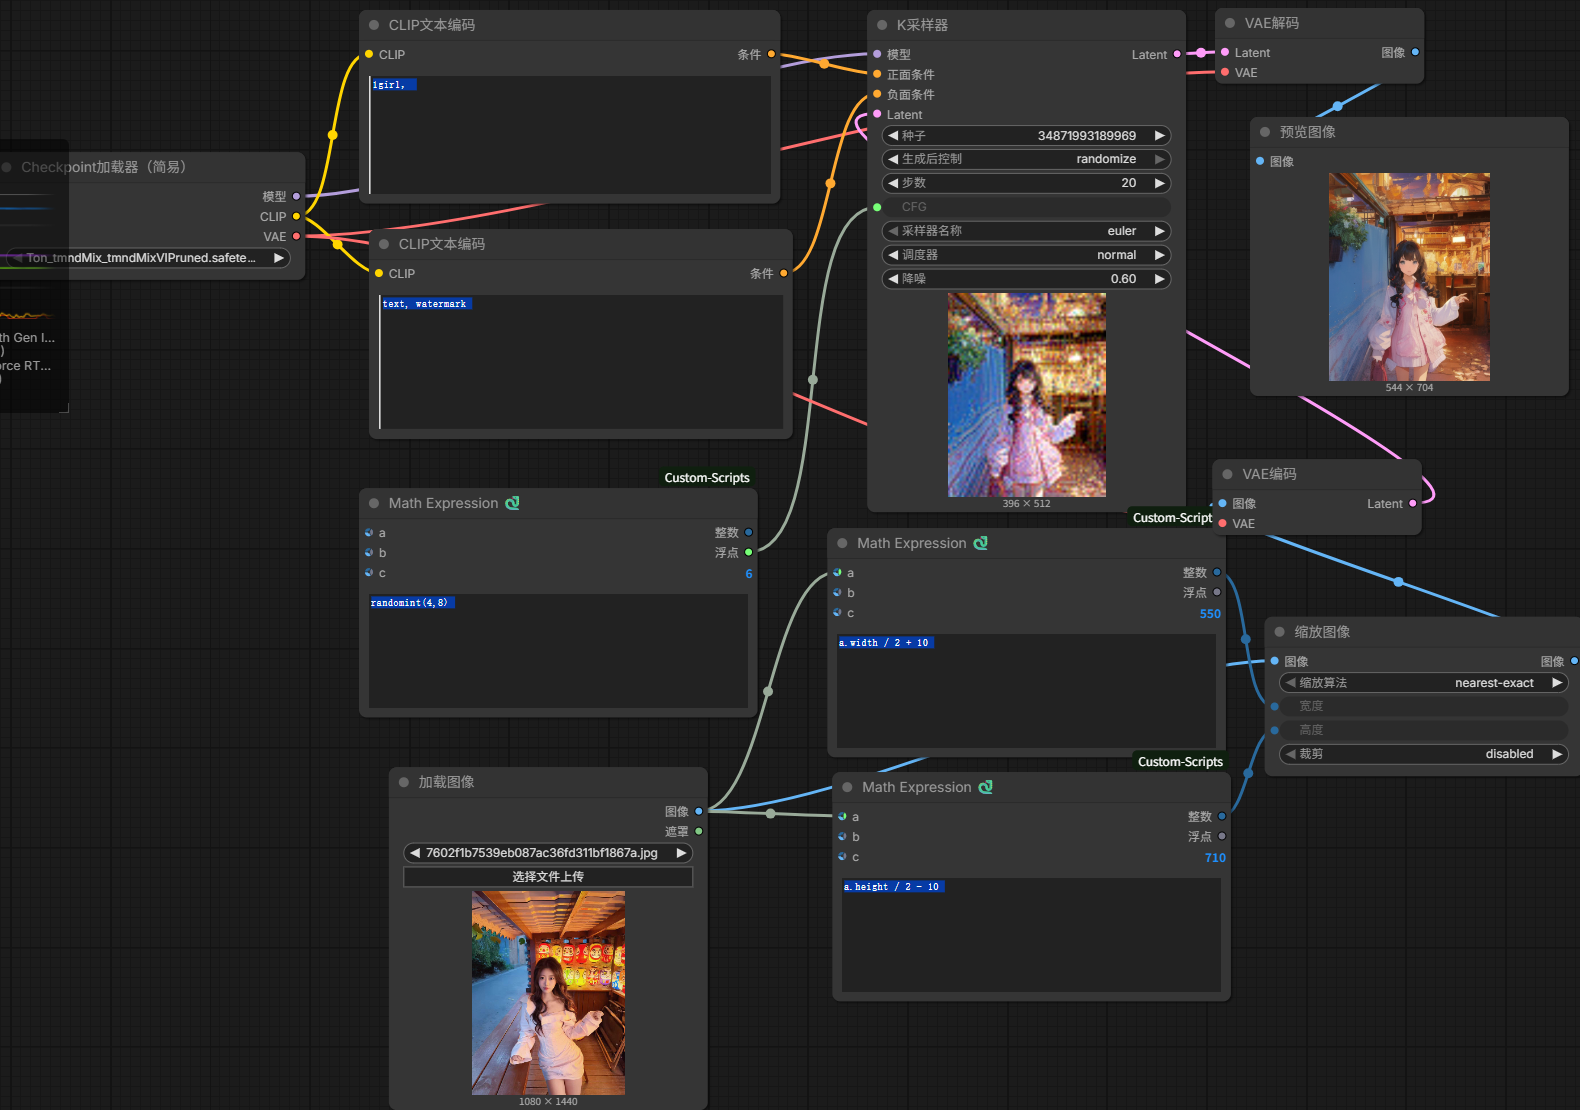
数学表达式节点

可以通过数学运算逻辑去进行图像缩放及适 合运算的节点

K采样器可以进化成输入的 带有CFG的随机数种子 然后将数学表达式拖入
CFG 是「提示词引导强度」,核心作用是:控制 AI 生成的图片有多 “听” 你的提示词指令,是 K 采样器里最影响生成效果的参数之一。

Clip Vision视觉编码节点

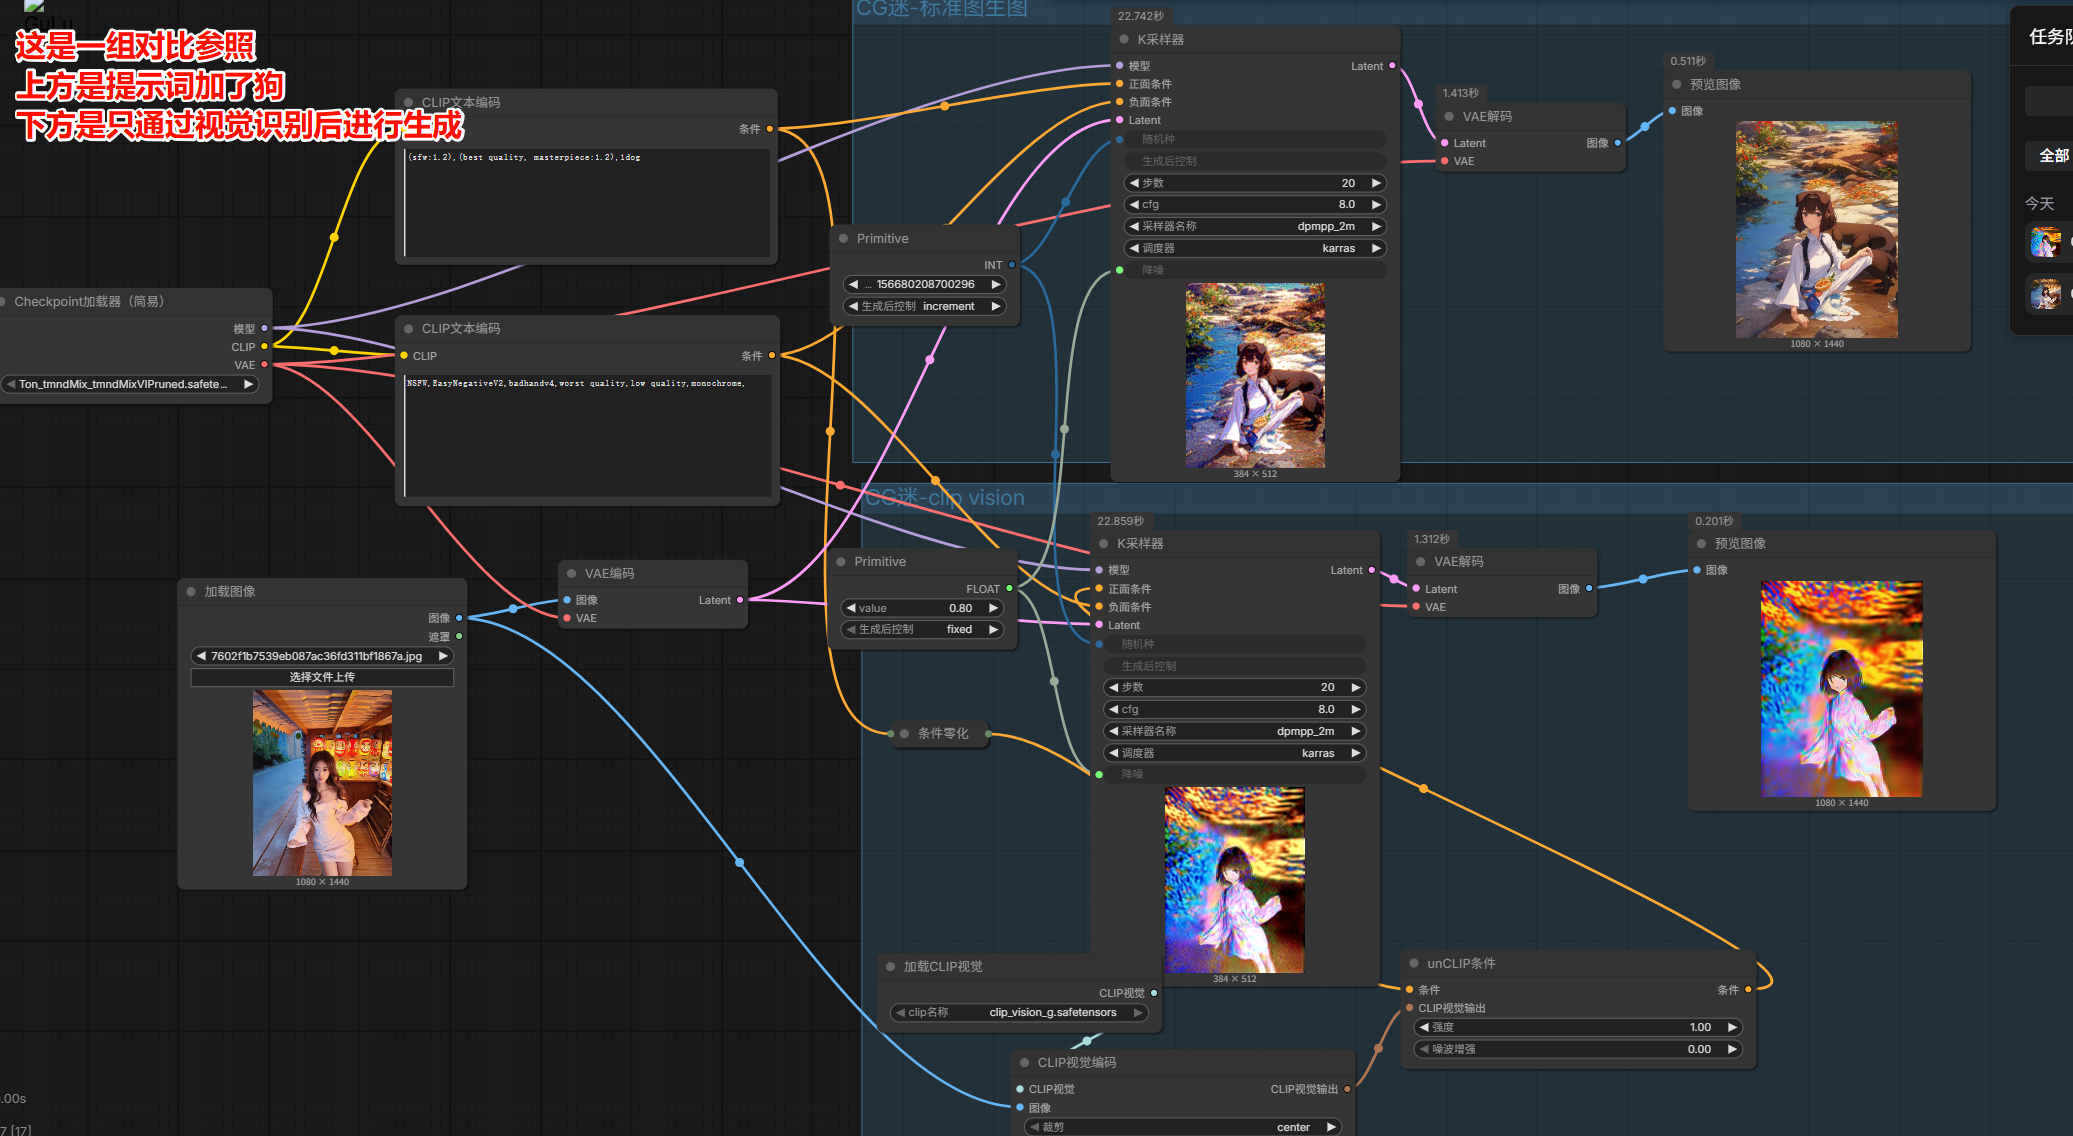
是能够通过对应的视觉模型实实在在的对上传的图片进行分析和学习【其实跟图生图类似 但大有区别】

能够获取和分析我们上传的图片,从而编码成对应的条件作为输出传输给K采样器来生成图片

要想效果更好 要把大模型切换到SDX大模型

这里的大模型都要放到:E:\ComfyUI-AI_DeskTop\ComfyUI-aki-v3\ComfyUI\models\clip_vision 中

下载clip_vsion_g.safetensors

unCLIP条件节点可以读取CLIP视觉编码节点的数据,并经过模型进行学习,从而转换成条件传给K采样器;这个条件节点还可以配合正向提示词一起起到双重叠加的效果

条件零化:可以让正向提示词传输过来的数据归零,正向提示词的效果不会发生作用!

高效的集成节点,管道,元组,堆栈

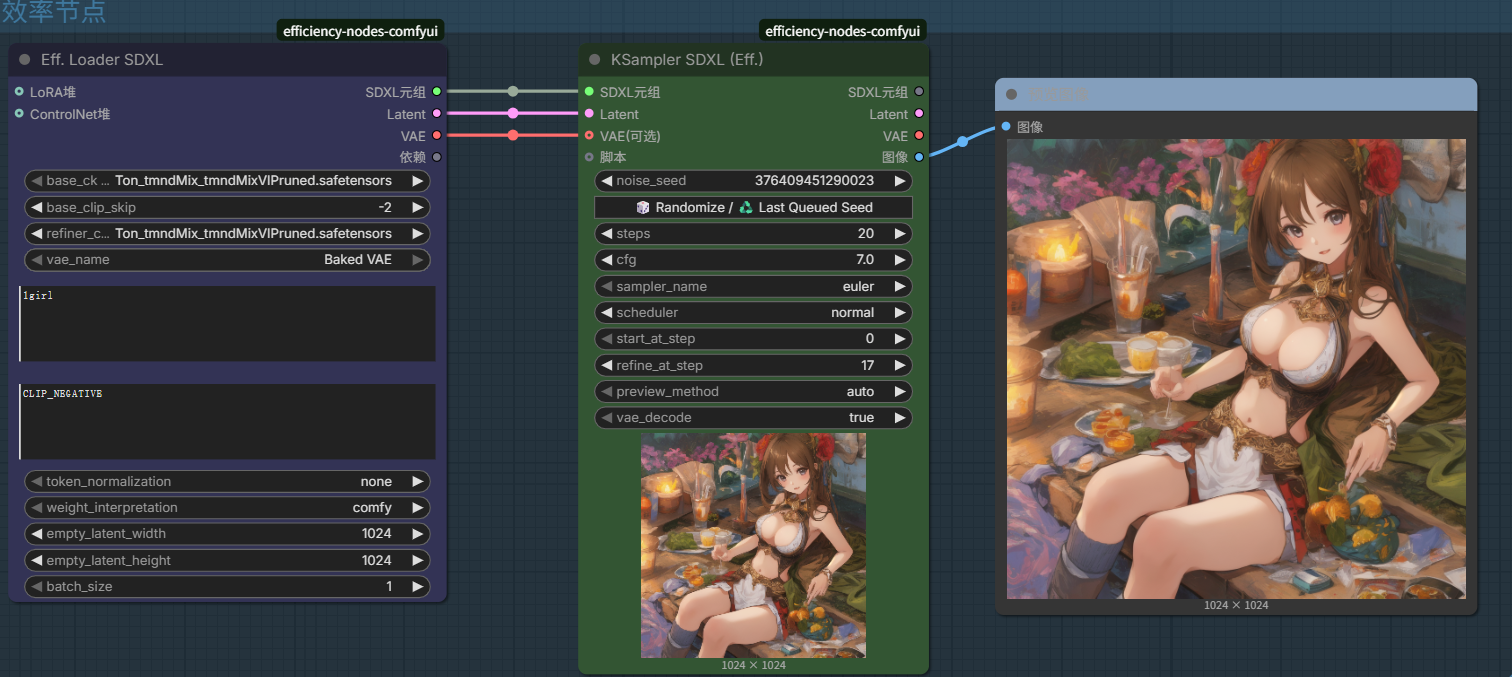
集成节点:一个节点顶替多个节点【类似于SD放大节点】是众多节点的融合体

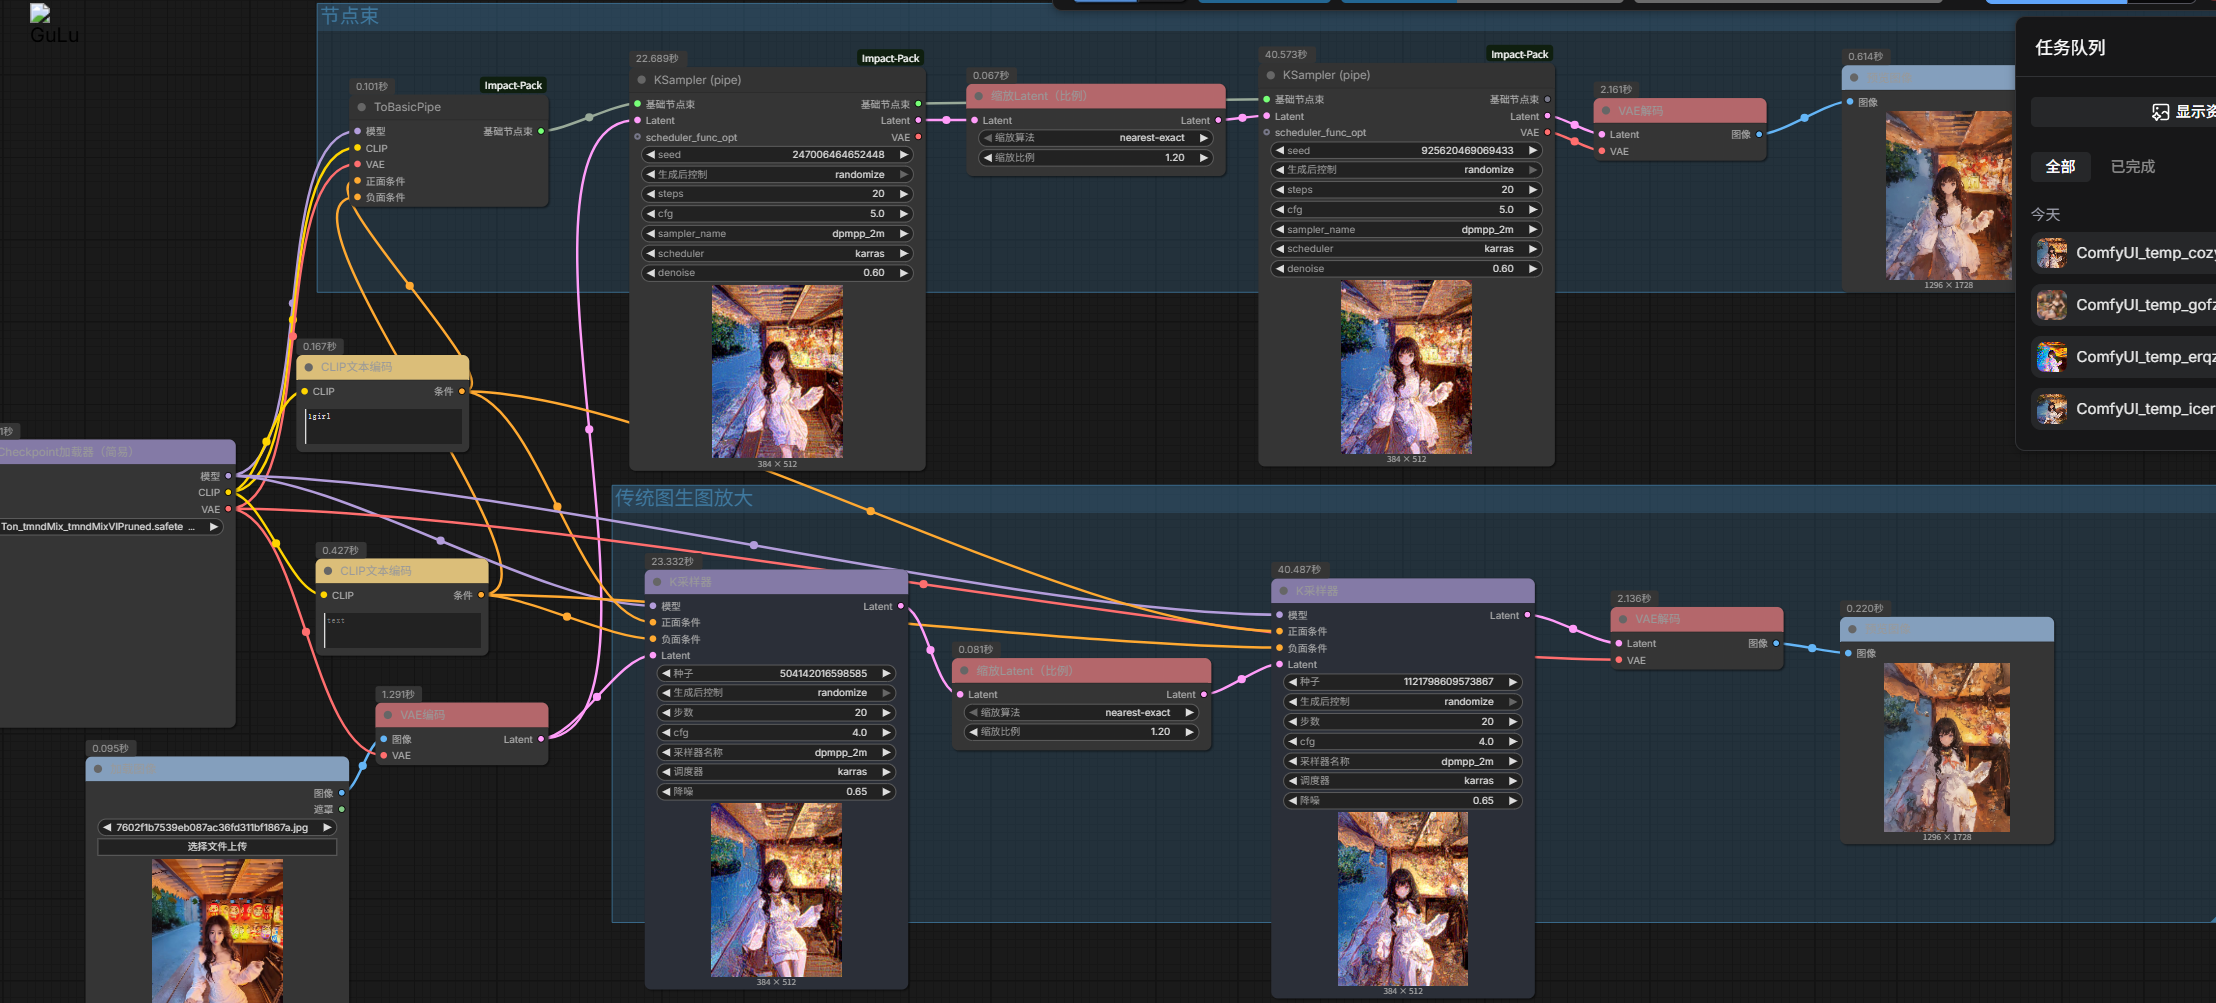
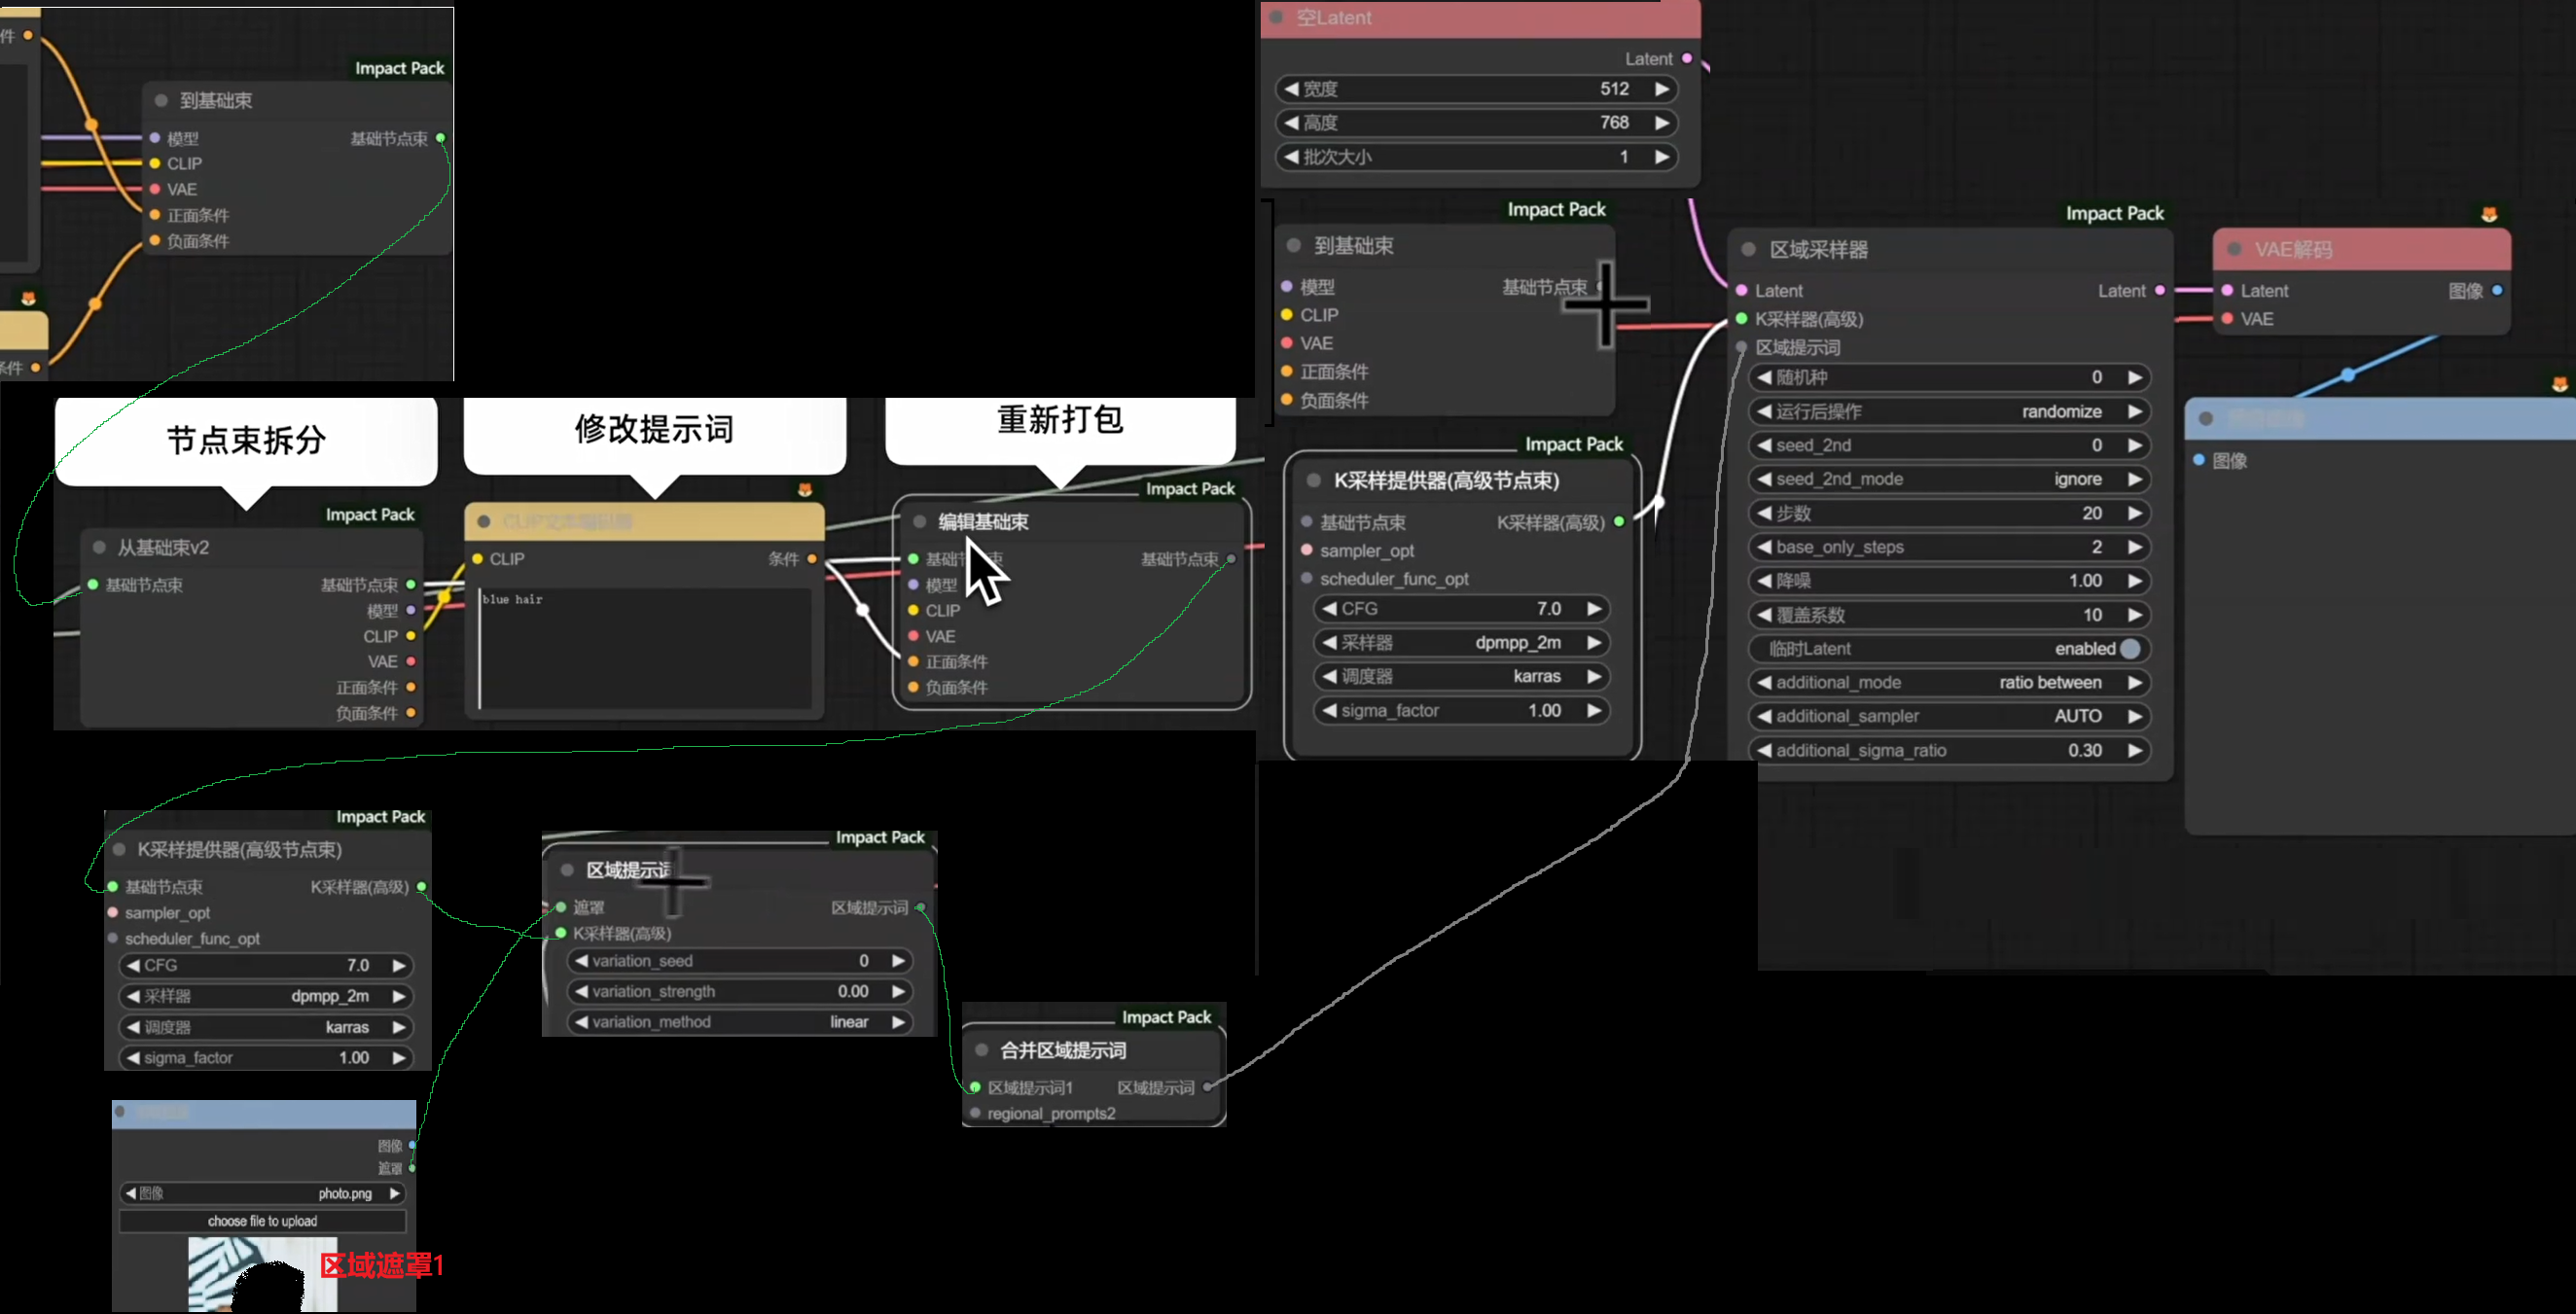
pipe管道节点(ToBasicPipe + KSampler SDXF(Eff.) ):到基础束【整合到了很多在一起】→ 可以创建一个**k采样器(节点束)**【减少线路的长途跋涉连线】

【到基础束】

  • 模型 ⚪ 基础节点束
  • CLIP
  • VAE
  • 正面条件
  • 负面条件

元组TUPLE(Eff. Loader SDXL + KSampler SDXF(Eff.) ):集成了CLIP Skip跳过、VAE、正向提示词、负向提示词

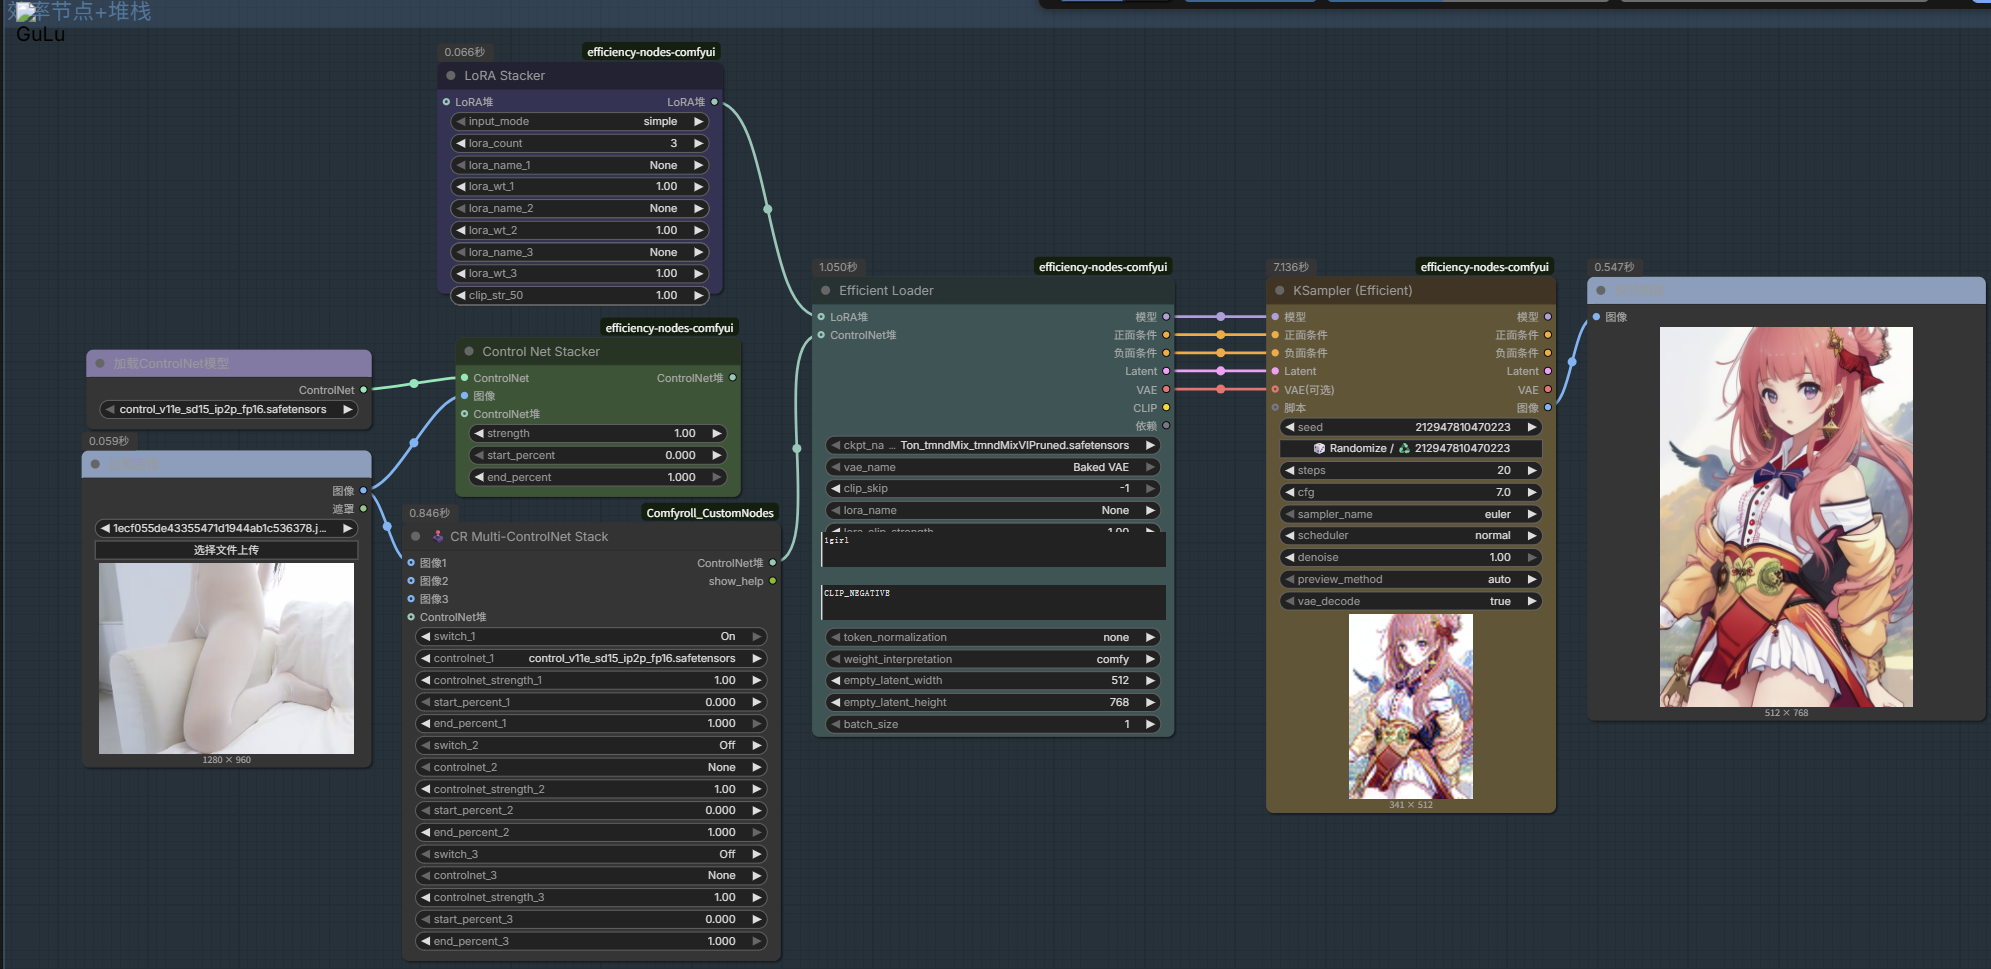
堆栈 + 效率节点:

效率工具缺点:由于集成度过高,会失去一些自定义、定制化的功能;需要配到插件使用,所以兼容性和工作流迁移方面没有原始节点好;稳定性和速度方面欠缺(引入网上的工作流会出现)

embeddings加载与webui参数复用

embeddings:体积很小的标签模型,相当于输入一系列的优化提示词

可以直接从LibLibAI的地方点击图片右下角的感叹号信息,可以获取提示词Prompt;但直接复制到自己的里面会发现生成的效果很差,这里面的原因是复制的提示词可能缺失了对应的lora模型,而且对方在负面提示词里经常会加入(embeddings);只需要加入到负面提示词里就相当于输入了一串十多二十多个优化人物体态的负面提示词;需要手动在后面加入embedding:xxxx,xxx是所对应的模型名称

NSFW,(worst quality:2),(low quality:2),normal quality,(lowres),bad anatomy,bad proportions,wrong fluoroscopy,limb dislocation,malformed limbs,extra limbs,bad facial,bad face,unnatural face proportions,swollen or deformed face,embedding:xxxx

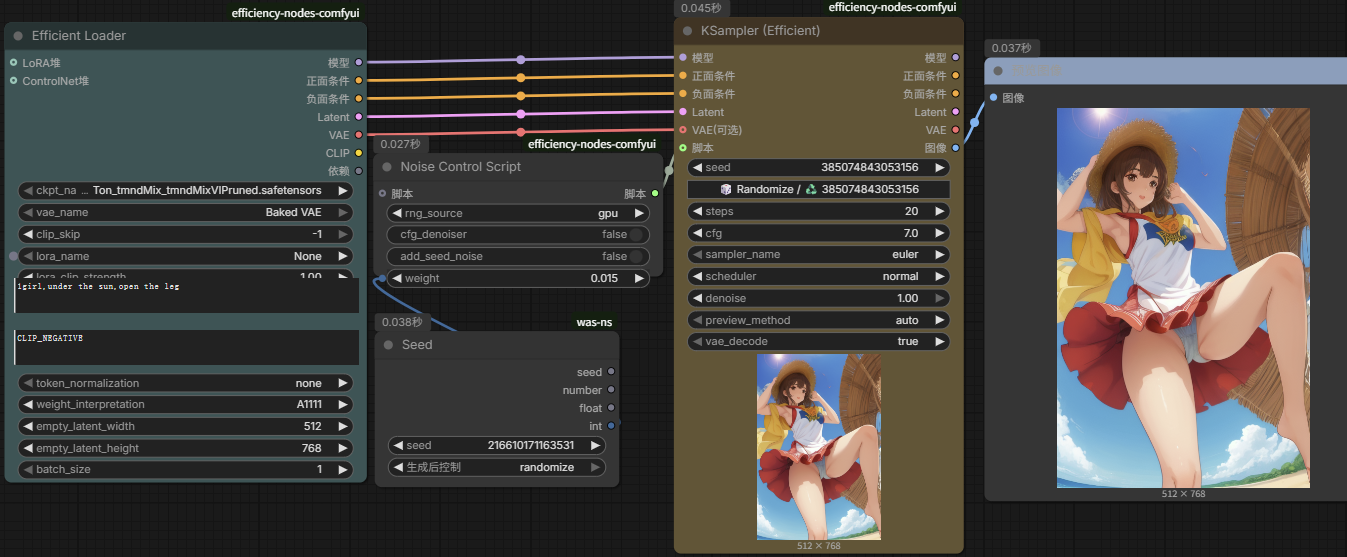
默认ComfyUI是通过CPU来生成噪波的,WebUI是通过GPU(显卡)生成噪波的;

在 ComfyUI / AI 画图里,噪波(Noise) 你就记一句最简单的:

噪波 = AI 画图的 “起点”

AI 不是凭空画,而是从一堆随机杂色点开始,慢慢擦除、细化,变成清晰图片。这堆随机杂色,就叫 噪波。

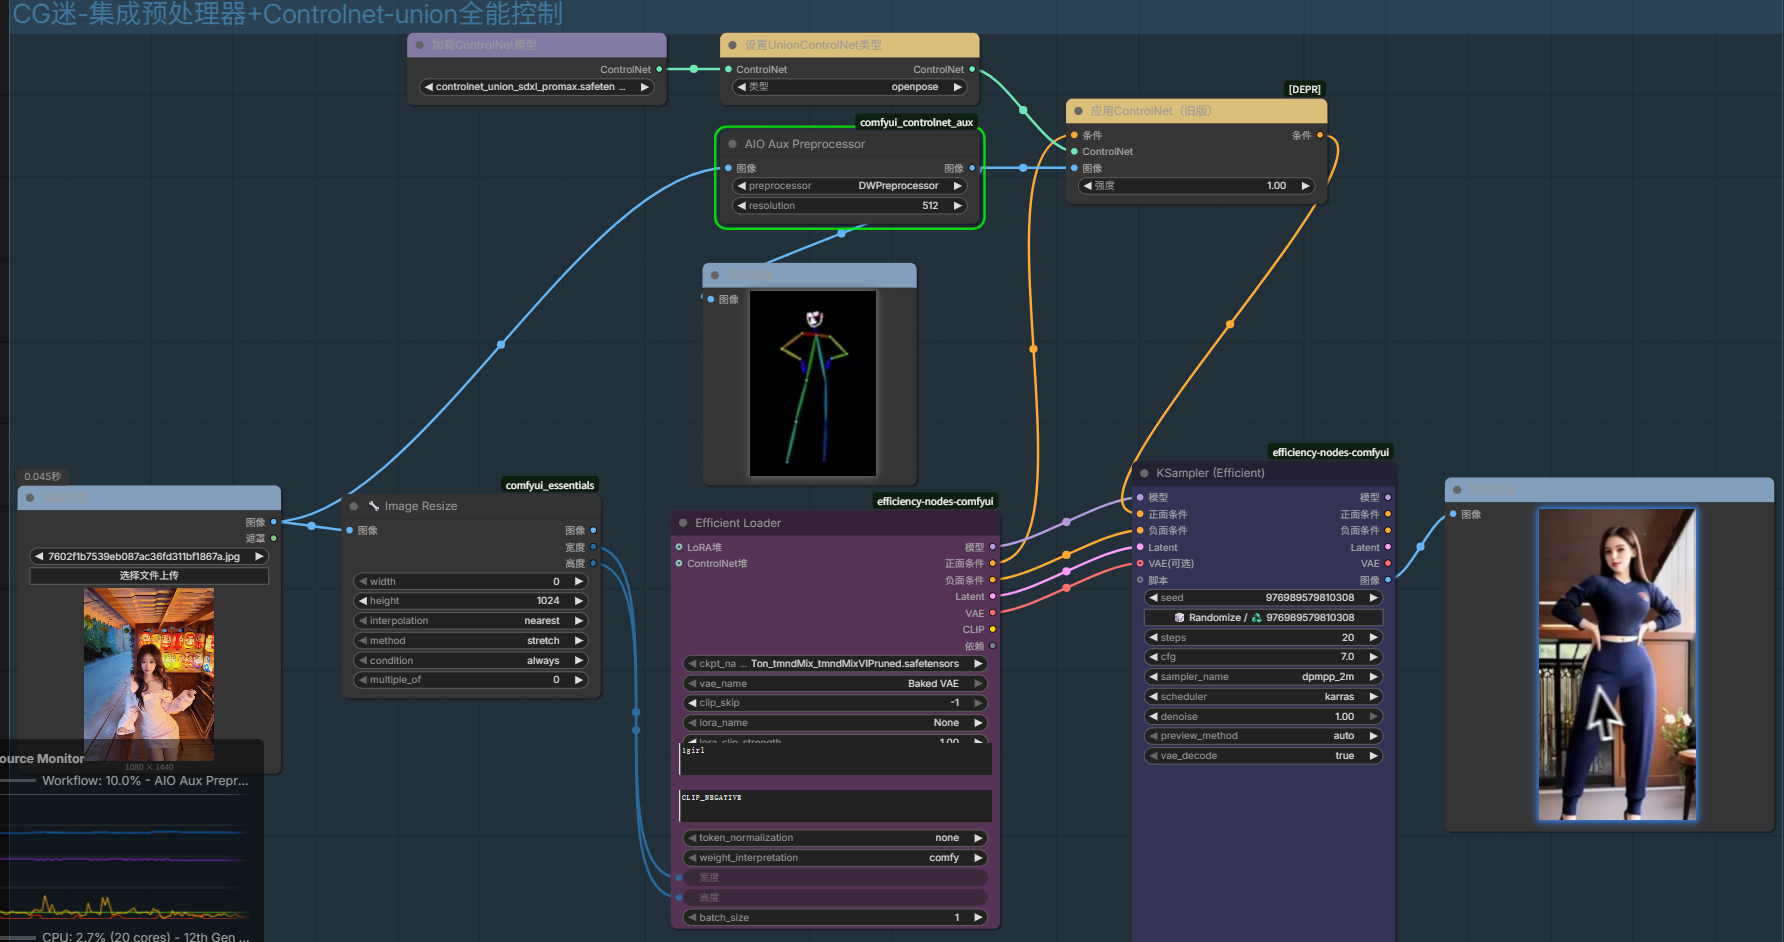
集成预处理器 + Controlnet-union全能控制

AIO Aux Preprocessor:集成的预处理器节点(包含非常多常用的预处理器节点)

万能controlnet模型:controlnet-union-sdxl-1.0 仅支持SDXL大模型使用;controlnet_union_sdxl.safetensors; controlnet_union_sdxl_promax.safetensors
下载后放在E:\ComfyUI-AI_DeskTop\ComfyUI-aki-v3\ComfyUI\models\controlnet中

就可以新建节点 → 条件 → ControlNet → 设置UnionControlNet类型
这样一个模型就内置了13款常用的controlnet模型了!

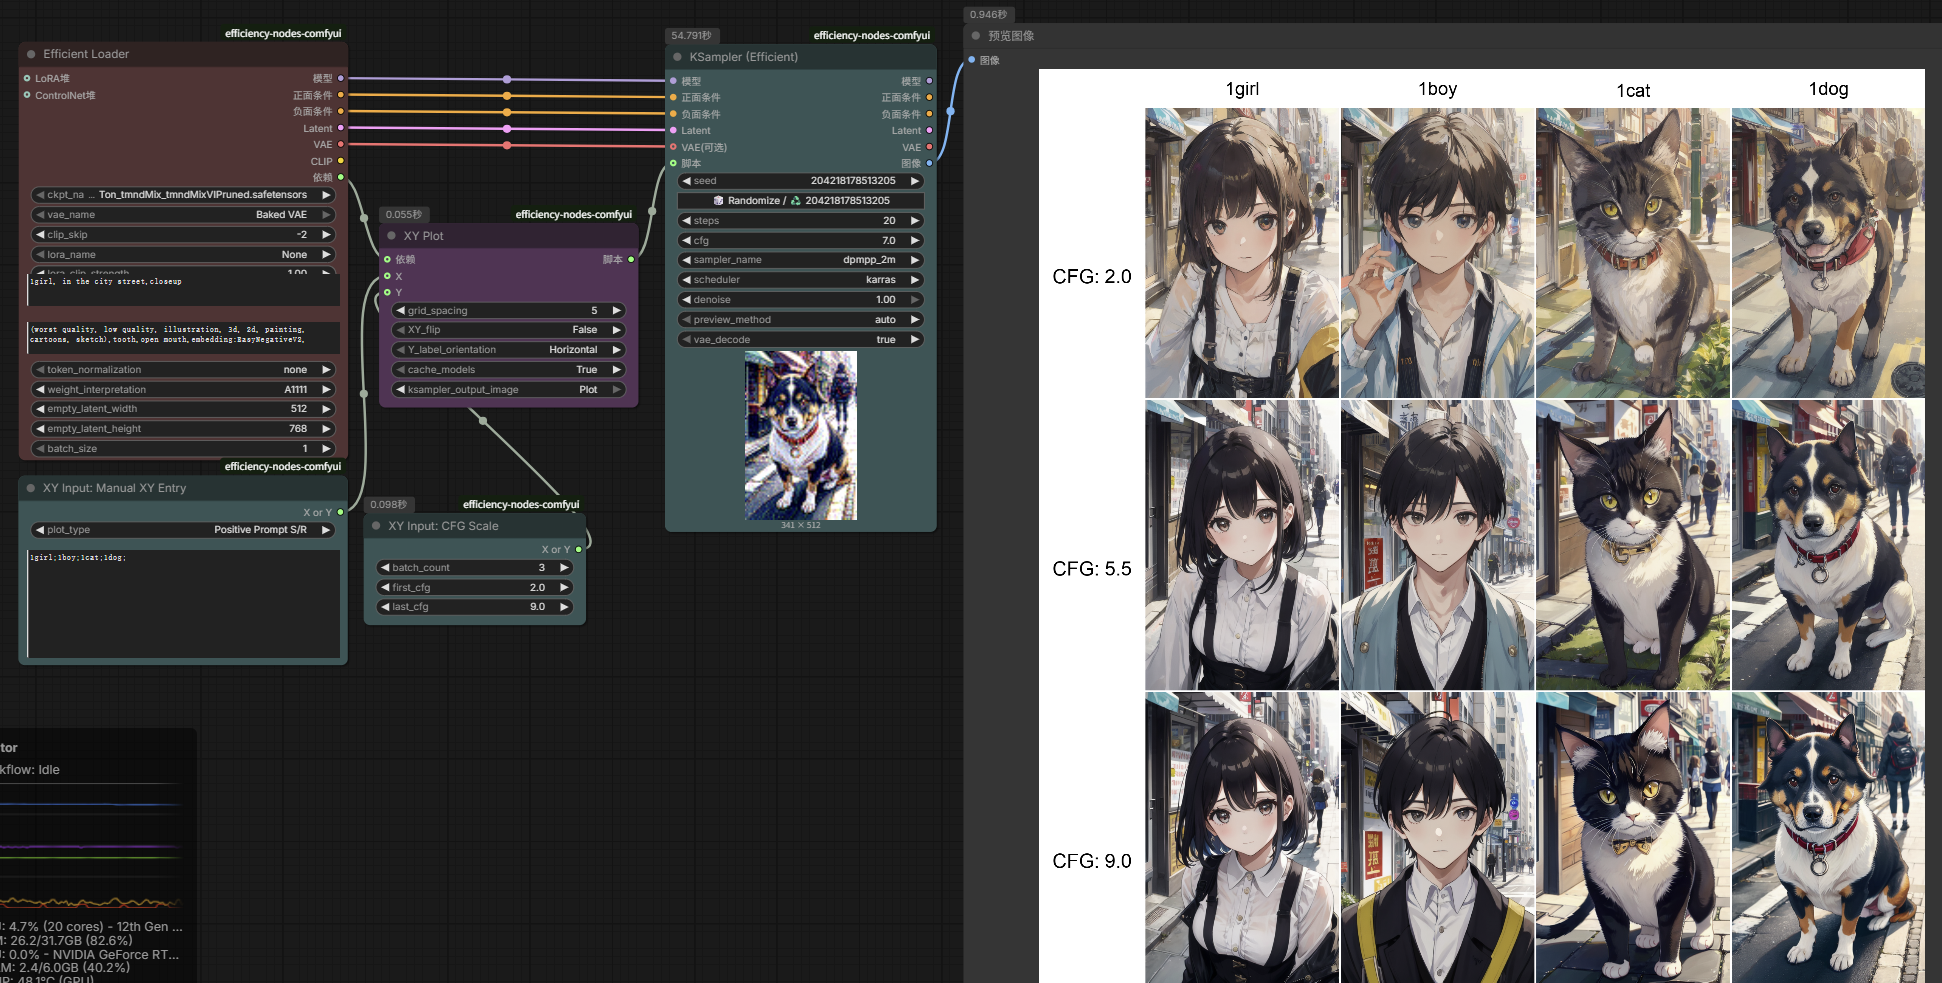
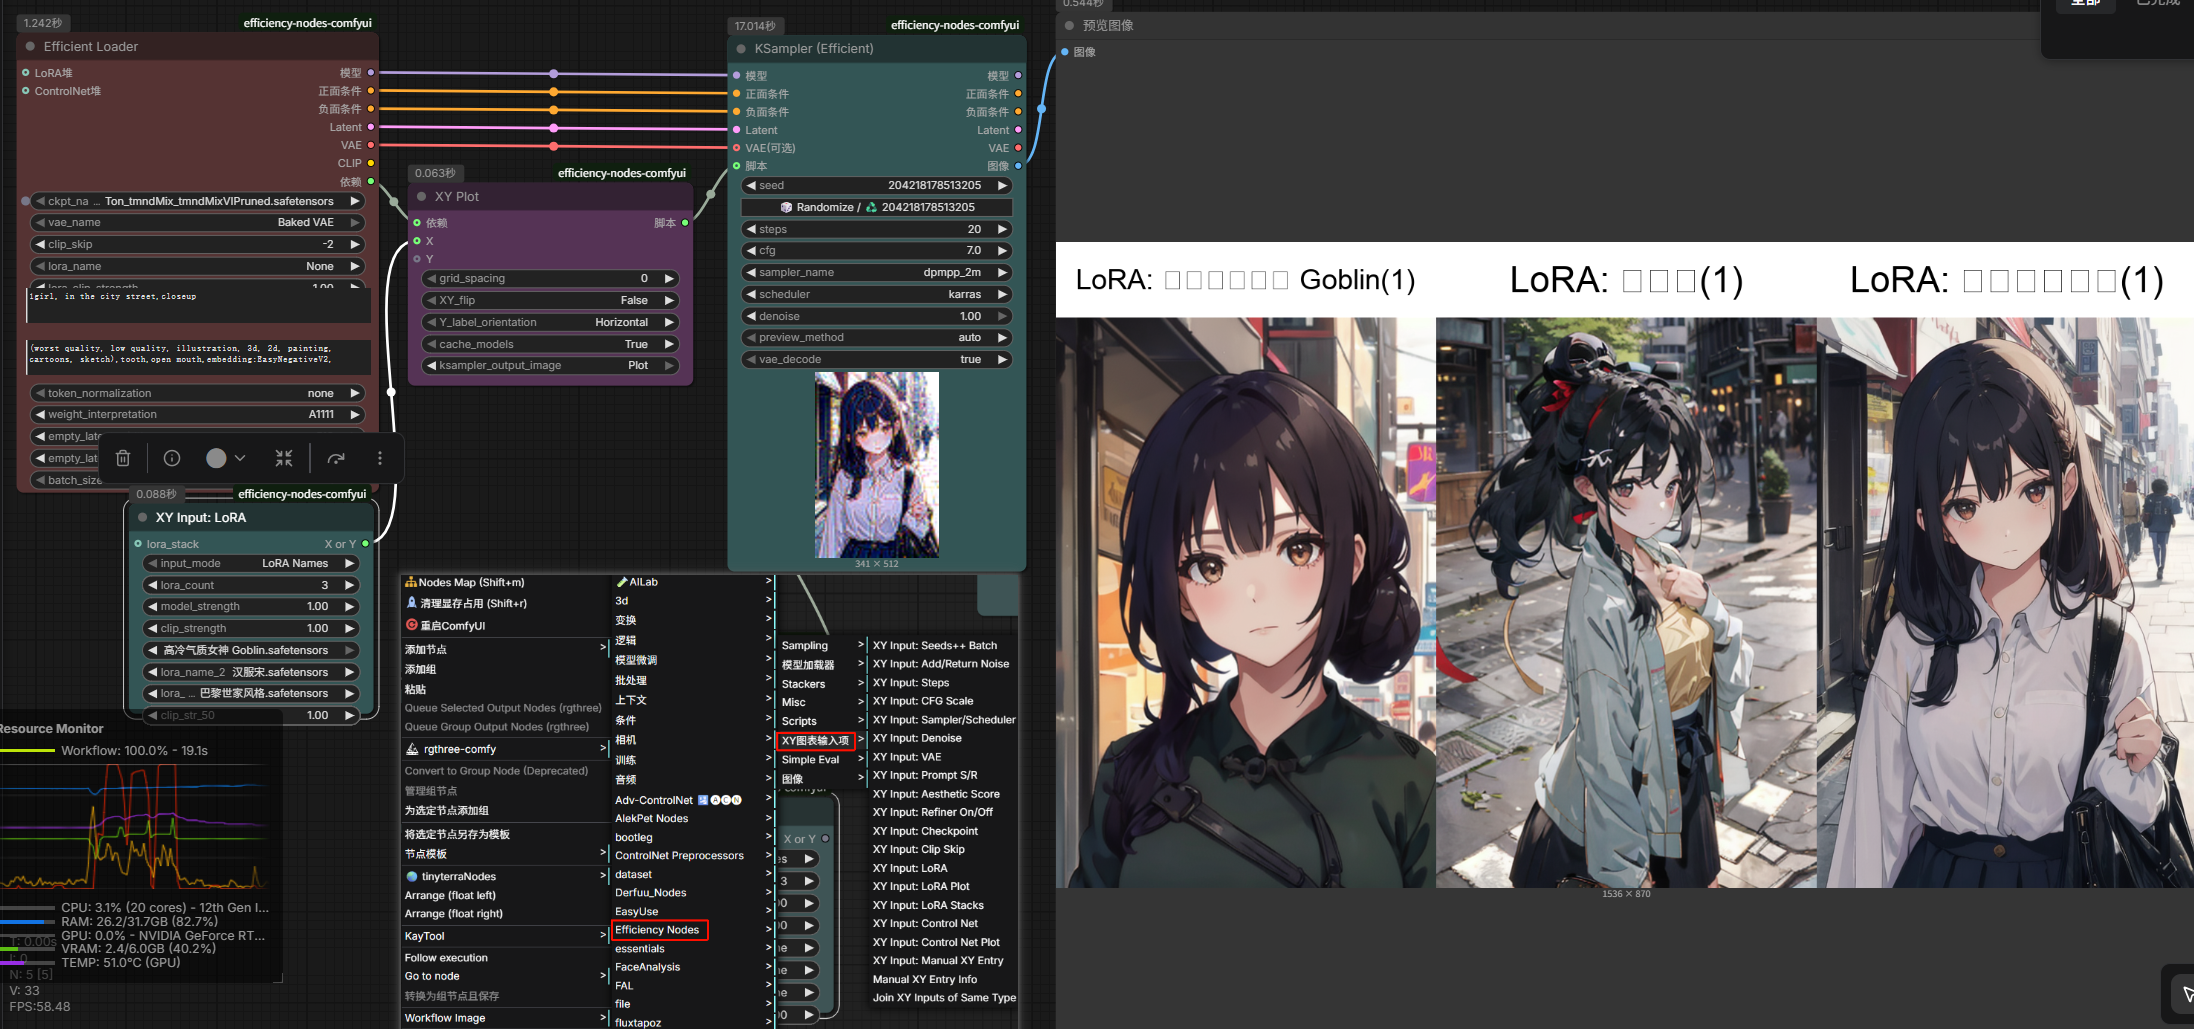
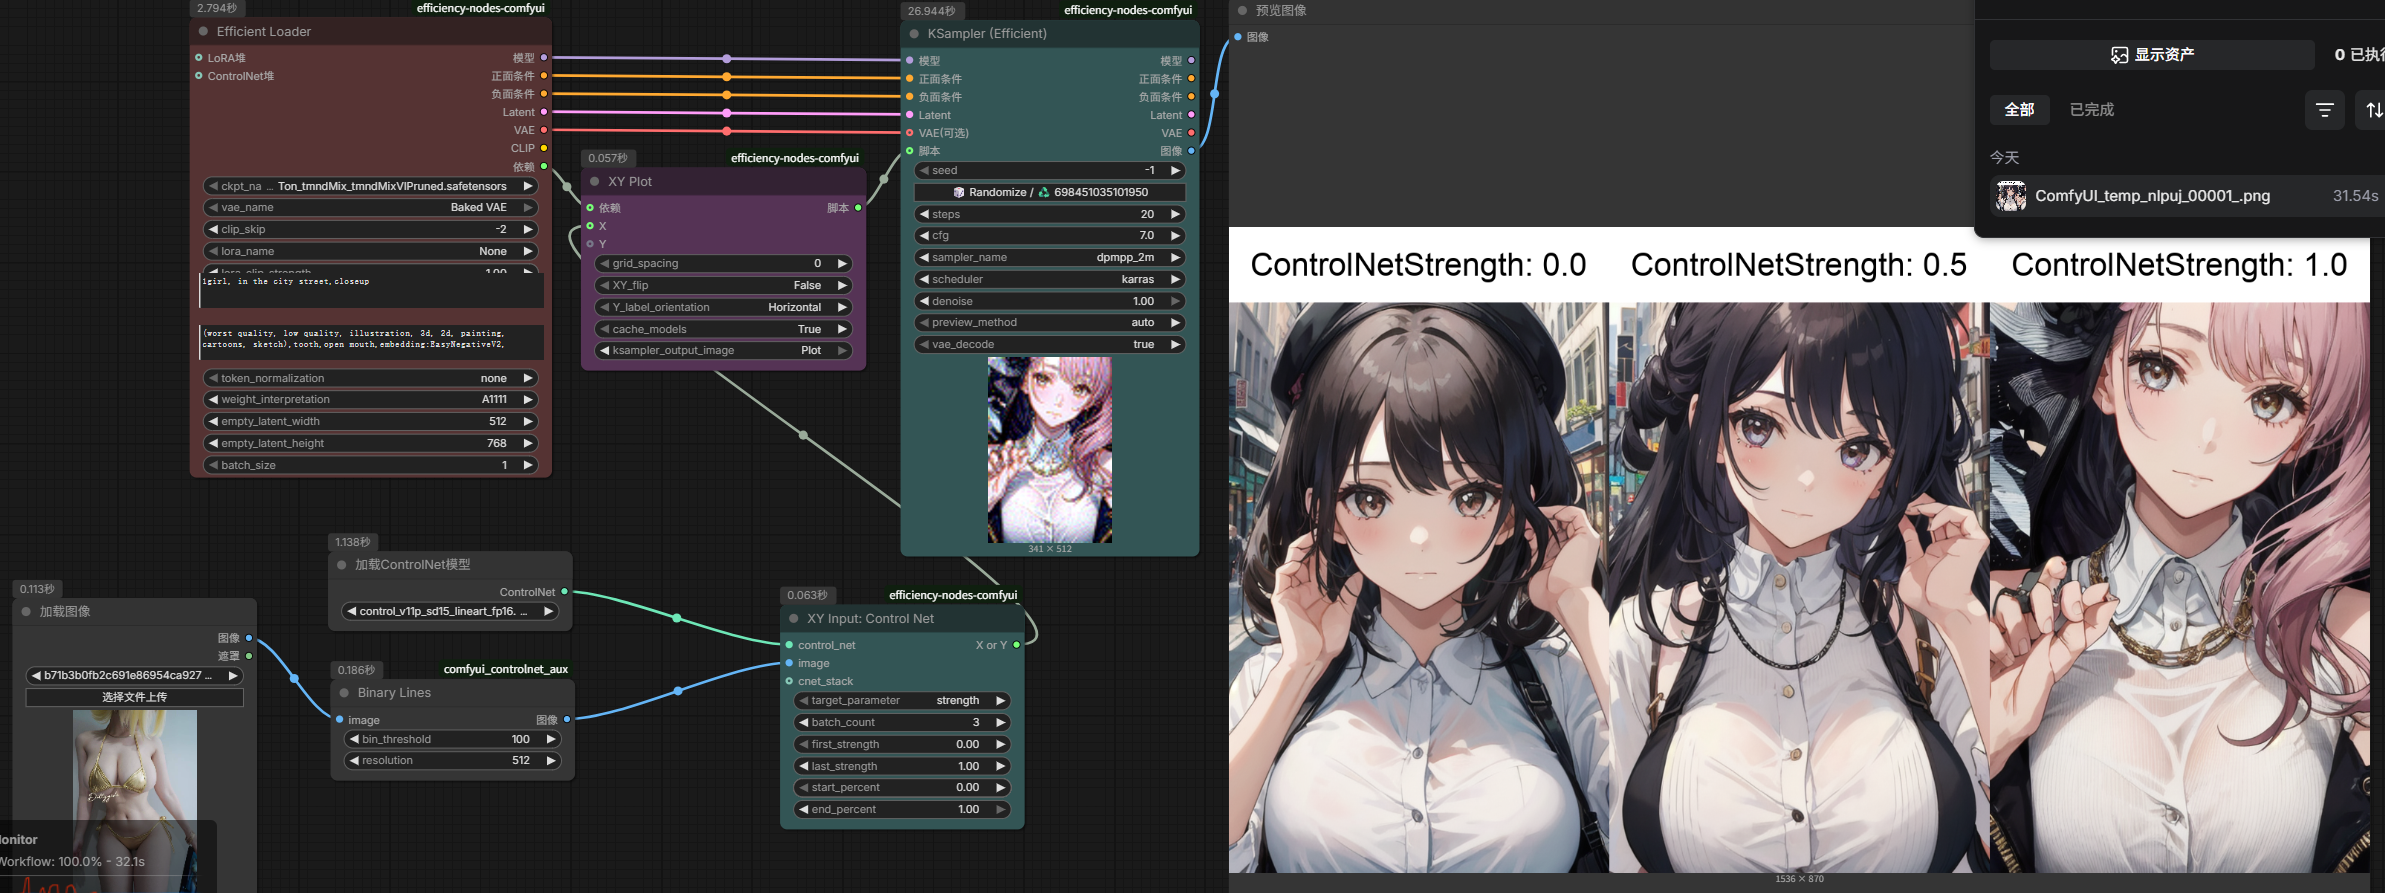
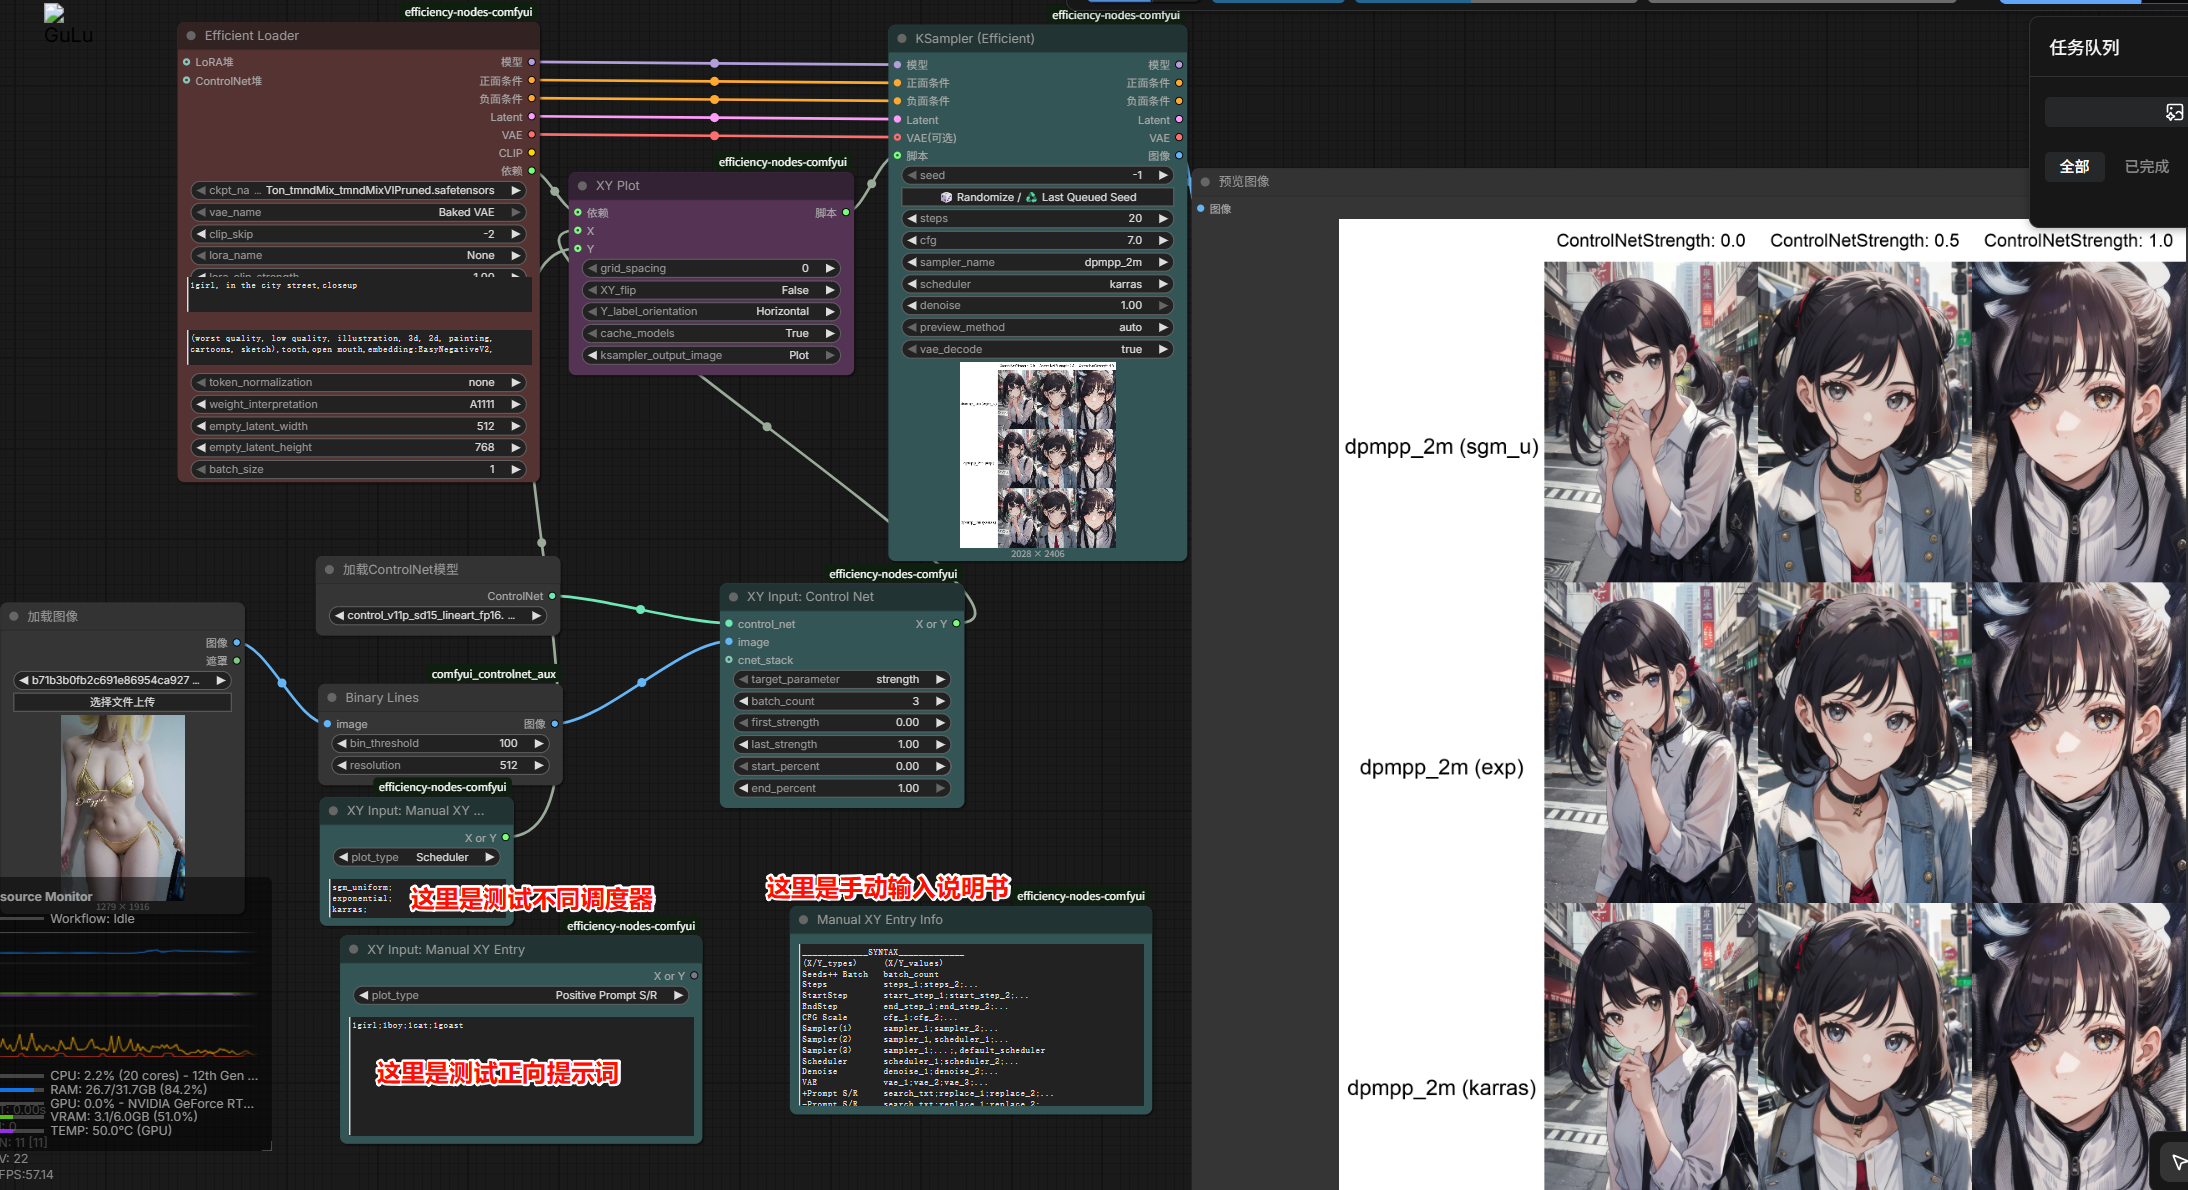
XYZ脚本参数对比测试

XY Plot:展示生成后横纵坐标的效果

也经常成为lora脚本的测试

controlnet测试参数

XY手动输入节点

右键 → 添加节点 → Efficiency Nodes → XY Input: Manual XY Entry
再添加一个节点说明 也是在上面的路径 → Manual XY Entry Info
这里面有详细的使用手动输入节点的说明
找到___________SCHEDULERS___________ 调度器

SCHEDULERS
simple;
sgm_uniform;
karras;
exponential;
ddim_uniform;
beta;
normal;
linear_quadratic;
kl_optimal;
AYS SD1;
AYS SDXL;
AYS SVD;
GITS

选择好后复制到手动输入节点里面
上面的plot_type(接口类型)要改成Scheduler(调度器)
此时就可以测试不同采样器和不同调度器之间的搭配生成效果了
也可以搞成正向/负向提示词 也非常好用【可以测试不同提示词的效果】

节点预设保存与重复调用必备技巧

每次不要经常拖拽 很费事

  • Controlnet模块;按住Ctrl框选模板节点后,在空白位置点击鼠标右键 → 储存选中为模板 → 起个名右键就可以调用了
  • 框选中工作流,右键选择转换为组节点且保存 → 可以把框选的节点整合成一个单独的整合节点;在整合节点中右键Manage Group Node就可以管理预设 → 右上角可以选择是想编辑哪个预设 → 可以改整合节点内部的命名
  • 左上角的文件夹可以有Import进行导入工作流

在整合节点上右键 → Convert to nodes 就可以转换成普通节点了

缺点:一旦整合了节点之后,我们就不能单独进行局部修改和调整了!!!

ComfyUI批处理,批量出图技巧

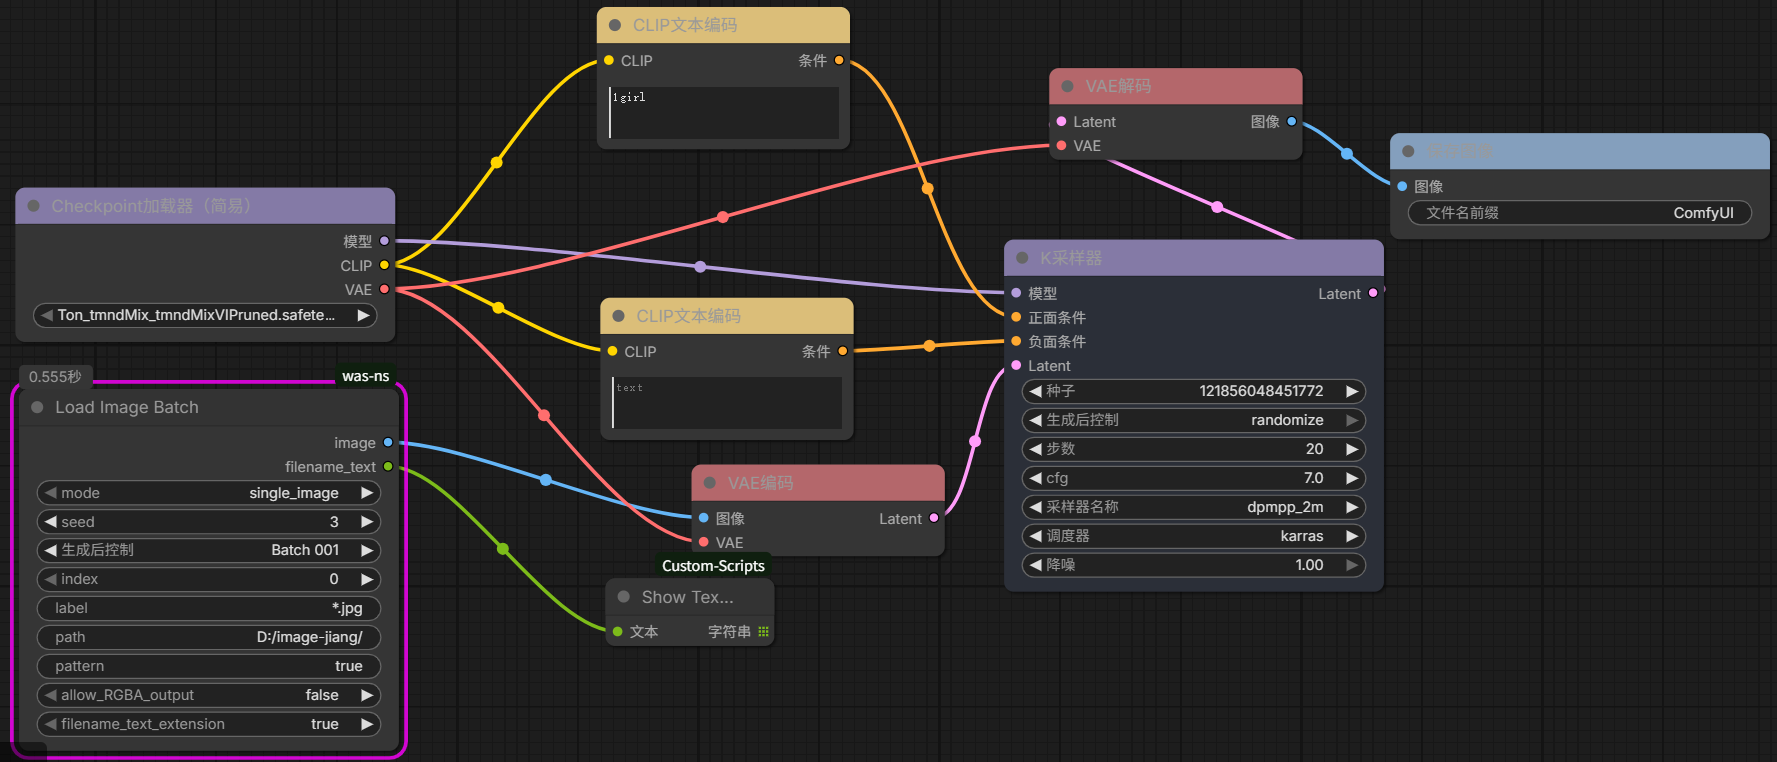
Load Image Batch : 在画布上右键 → 添加节点 → WAS Suite → IO → Load Image Batch

mode里面有三种:random随机、incremental_image(递增模式)、single_image

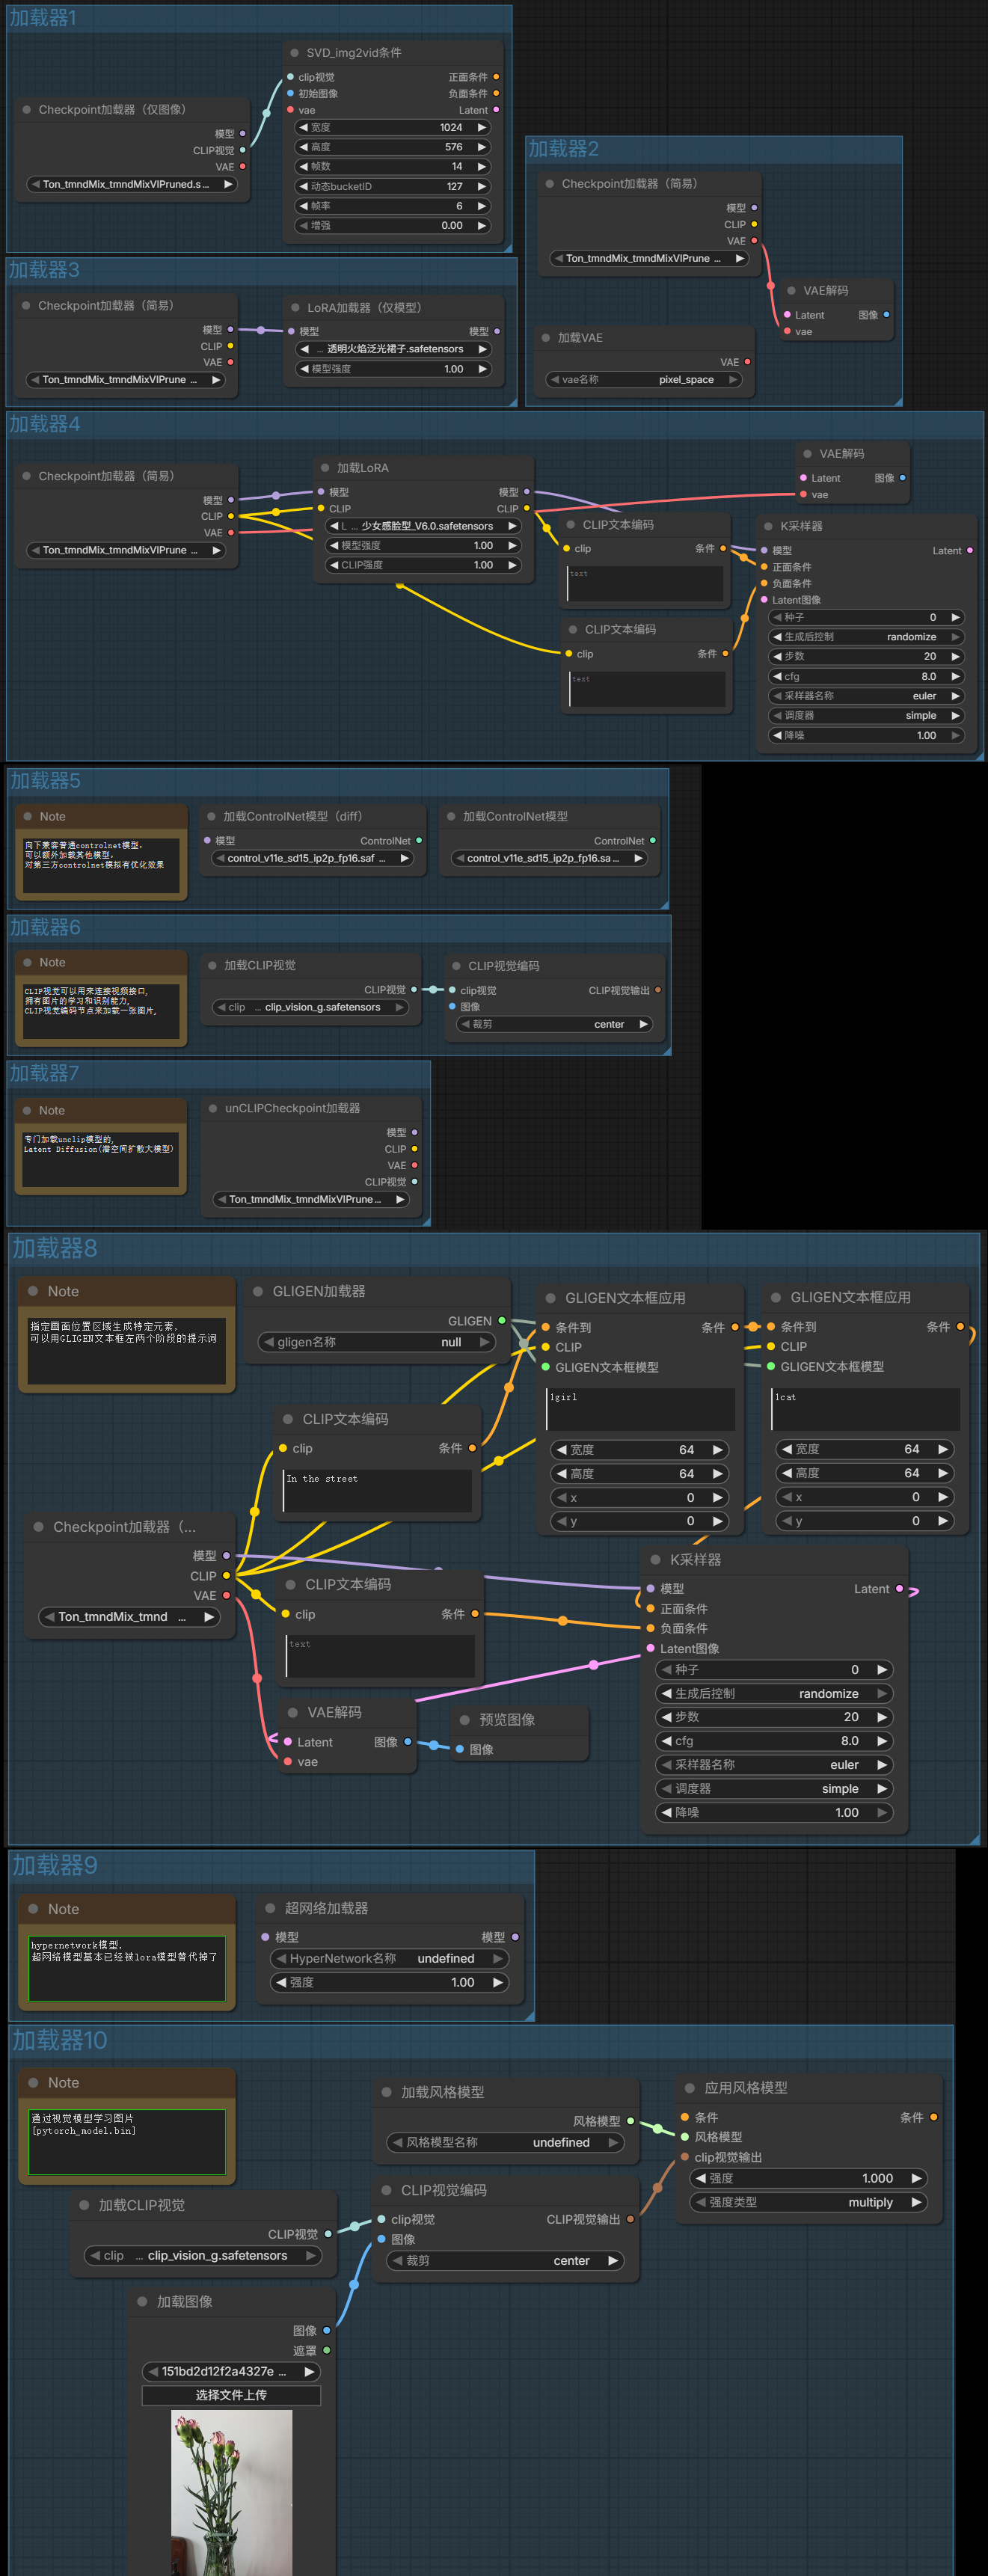
ComfyUI基础节点详解——加载器

共计上百个节点,共5大分类,一口气了解ComfyUI各个节点的使用
五类基础节点
  • 采样
  • 加载器
  • 条件
  • Latent
  • 图像

大部分的工作流都是以大模型的加载CheckPoint加载器(简易)作为起始输入源来进行展开的,一个工作流里面可以存在多个加载器

  • 放大模型加载器:对生成的图片进行放大

连接controlnet的时候要用到对应的controlnet模型加载器;所以加载器是工作流中各个模块的生产力源头;随着添加插件后在右键,点击添加节点→ 加载器 → 就能看到插件的那些加载器了

节点讲解我们都将会在LiblibAI的在线版comfyui

右键添加节点 → 加载器 → ‘ 所有加载器 ‘

ComfyUI基础节点详解——条件

条件节点 => 主要作用:充当指挥官,下达命令,设定生成条件。

例如提示词要求生成什么内容,controlnet要求生成什么样的动作姿势,最终画面都需要遵循这些条件节点的要求来生成图像

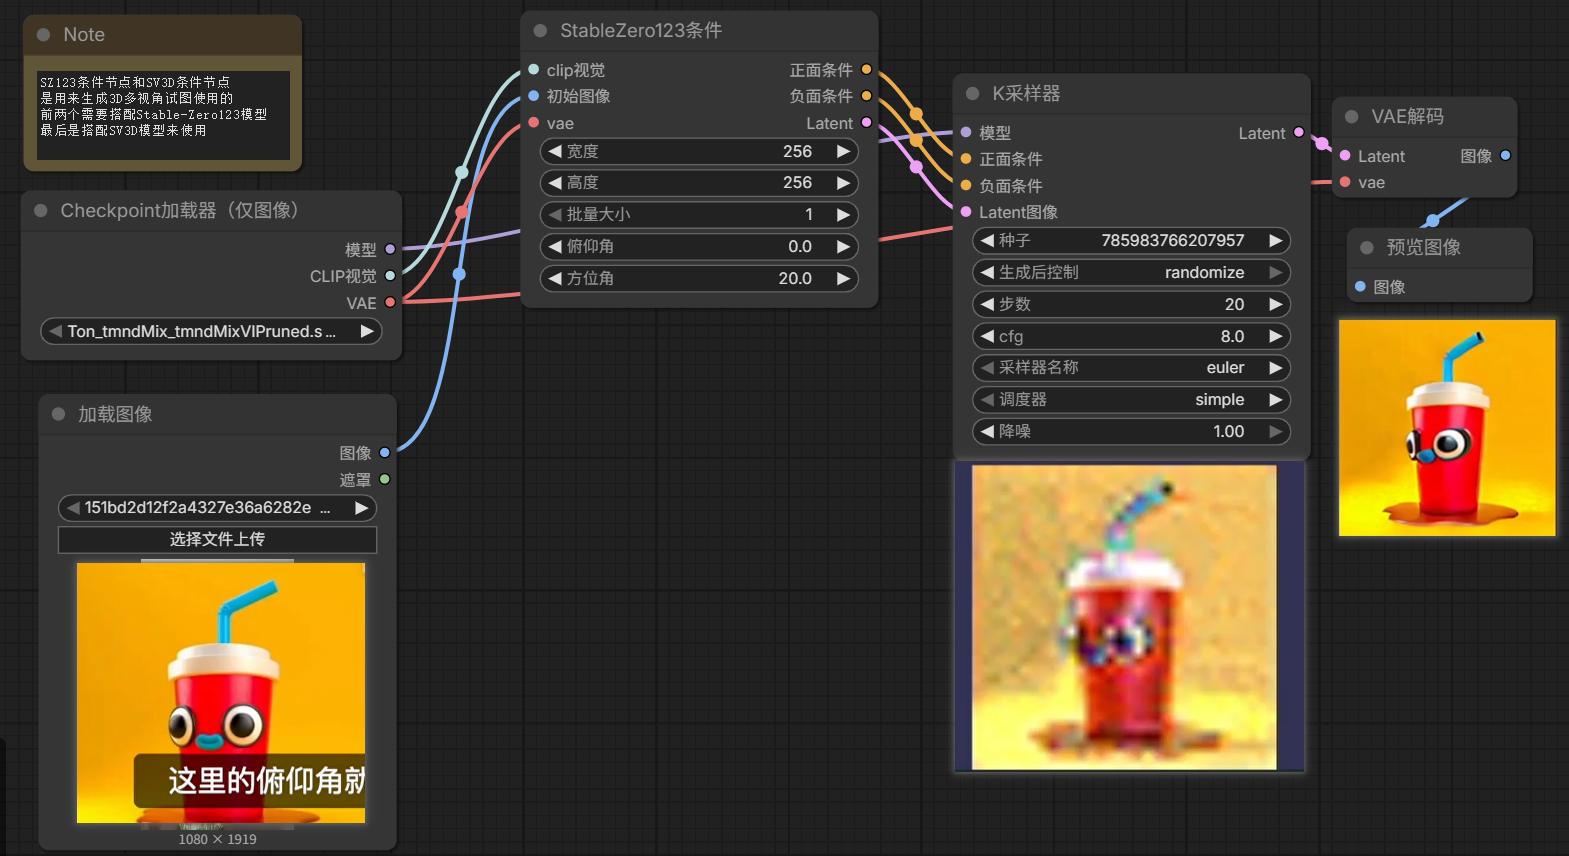
StableZer123、StableZer123(批次)

SD4X放大条件节点(SD_4X放大条件)

图片进行四倍放大后再进入潜空间进行采样降噪处理

这里要用大模型x4-upscal-ema.ckpt

Stable Cascade B阶段节点

Stable Cascade B 阶段节点(Stage B)是 Stable Cascade 三阶段生成流程里的 “高清细节上采样 + 精修” 核心节点,负责把 Stage C 生成的低分辨率小 latent 放大、补全细节,为最终出图打基础。

一、Stable Cascade 三阶段总览(先看懂流程)

Stable Cascade 分 Stage C → Stage B → Stage A 三步生成:

  1. Stage C(Prior / 先验):在极小 latent 空间(如 24×24)生成基础构图、语义,速度快、显存占用低。
  2. Stage B(Decoder / 解码器):核心上采样 + 细节精修,把 Stage C 的小 latent 放大到中高分辨率 latent,补纹理、结构、细节。
  3. Stage A(VAE / 最终解码):把 Stage B 的 latent 解码成像素图,输出最终高清图。
二、Stage B 节点的核心作用(你问的重点)
1. latent 上采样(最核心)
  • 接收 Stage C 输出的低分辨率 latent(如 24×24),通过扩散模型将其放大到中高分辨率 latent(如 256×256、512×512)。
  • 相当于 “把模糊小图放大成清晰大图的 latent 版本”,是从 “小 latent” 到 “高清图” 的关键桥梁。
2. 细节精修与语义对齐
  • 基于文本提示词,对放大后的 latent 进行去噪、补细节、修正结构,让图像更贴合提示词、更真实。
  • 解决 Stage C 生成的 latent 细节不足、结构粗糙的问题,是画质提升的关键环节。
3. 显存友好的高清生成
  • 相比直接在高分辨率 latent 上跑扩散,Stage B 先在小 latent 跑 Stage C,再上采样,大幅降低显存占用,让普通显卡也能生成高清图。

InstructPixToPixConditioning 条件节点

通过提示词可以在我们上传图片的基础上赋予一系列新的样式风格

  • 比如输入make it file让它着火;就会在原图的基础上产生效果
  • 也可以改变其他的元素,比如输入make it old就可以让他变老

这里要用大模型cosxl_edit.safetensors

Clip停止层

参数:停止在CLIP层 (x)
真实风:-1
动漫风:-2

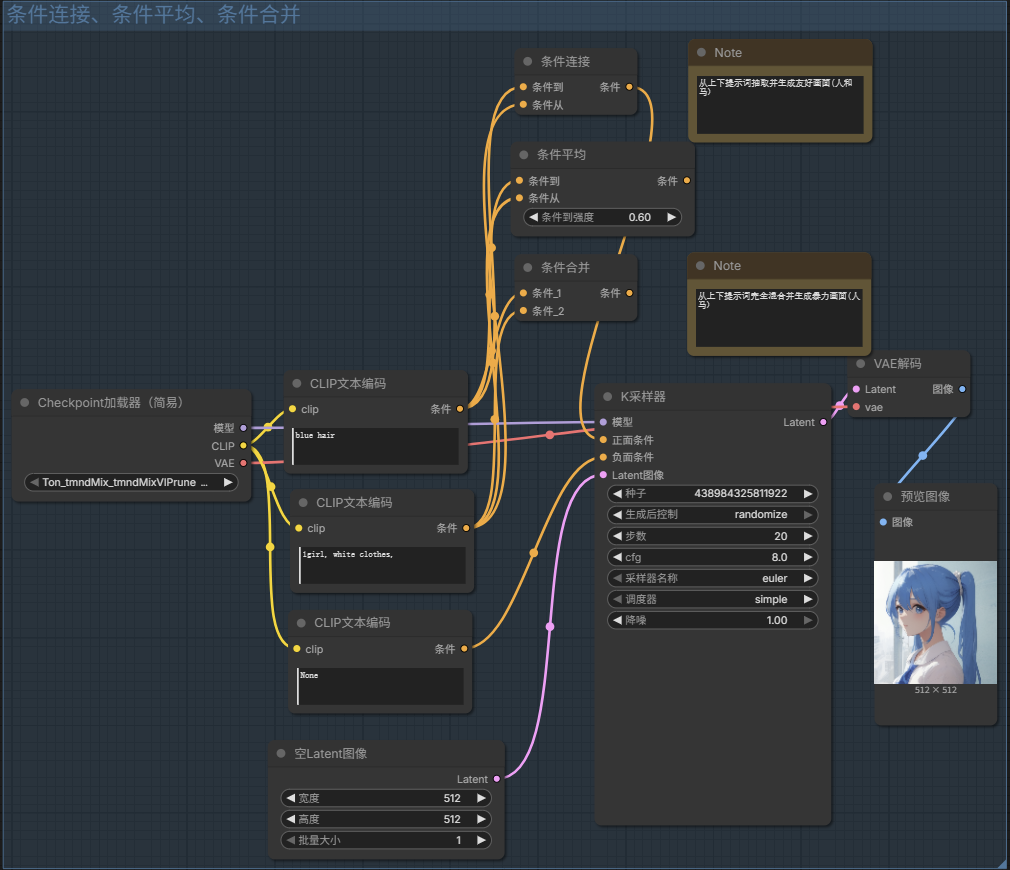
条件连接、条件平均、条件合并

条件连接(联结):可以合并两个正向提示词,因为提示词都写在一个CLIP中可能会互相干扰

条件平均:由于有两个正向提示词,可以通过其参数来调整合并之后那个提示词会起更多的作用;

  • 例如默认值是1,就代表:上面的提示词起100%的作用(蓝色头发 无白色衣服)
  • 如果改成0,就代表:下面的提示词起100%的作用(白色衣服 无蓝色头发)
  • 所以要选择 0~1 的数值

条件合并:上下提示词进行完全混合!!!

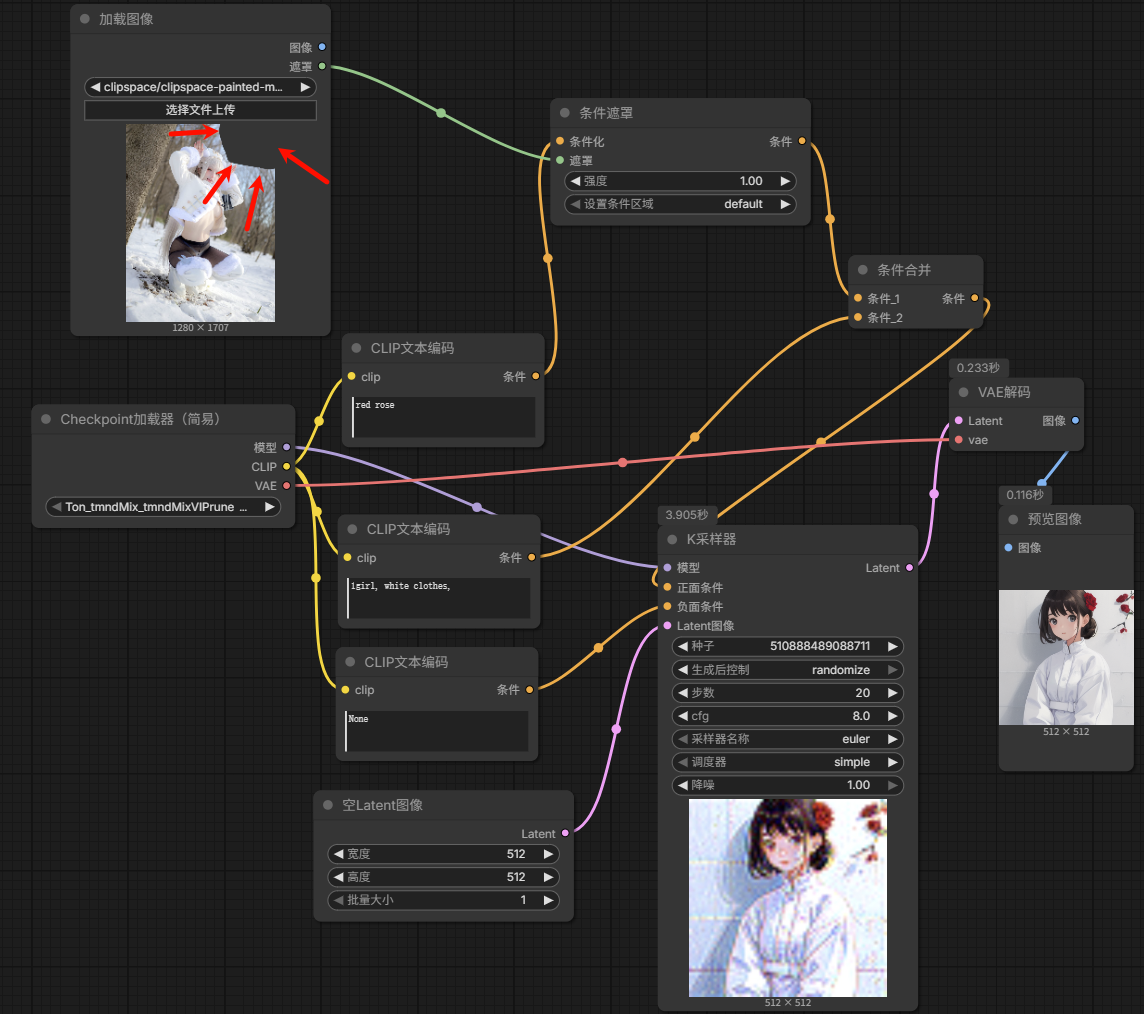
条件设置遮罩

CLIP视觉编码 + unCLIP条件

在图生图下,让comfyUI参考图片的风格去生成图片

ComfyUI基础节点详解——Latent(潜空间)

K采样器就是典型的潜空间模块,这个潜空间是专门AI处理图像的空间,不管是我们给它传输内容还是从潜空间里面产出的内容,都需要靠Latent节点来进行中转转化

  • 空Latent(适合文生图使用):不需要传输内容进潜空间
  • 加载图像→VAE编码.Latent→K.Latent(给图片参考):图片经过编码后转换成Latent,传输给K采样器;同理在K采样器里面处理完毕的图像就需要通过VAE解码节点来转换成像素,最终得到我们看得到的图片

Latent缩放,Latent按系数缩放

Latent缩放:可以手动改变我们上传图片的宽度和高度(因为不知道宽高比可能出现畸变);所以一般用Latent按系数缩放节点

Latent按系数缩放节点:会自动获取图片的宽度和高度,通过系数值来进行等比放大或缩小

  • 缩放算法一般选择nearest-exact(缩放系数最高效果最好)【如果图片生成后有锯齿状可以切换其他柔和算法】

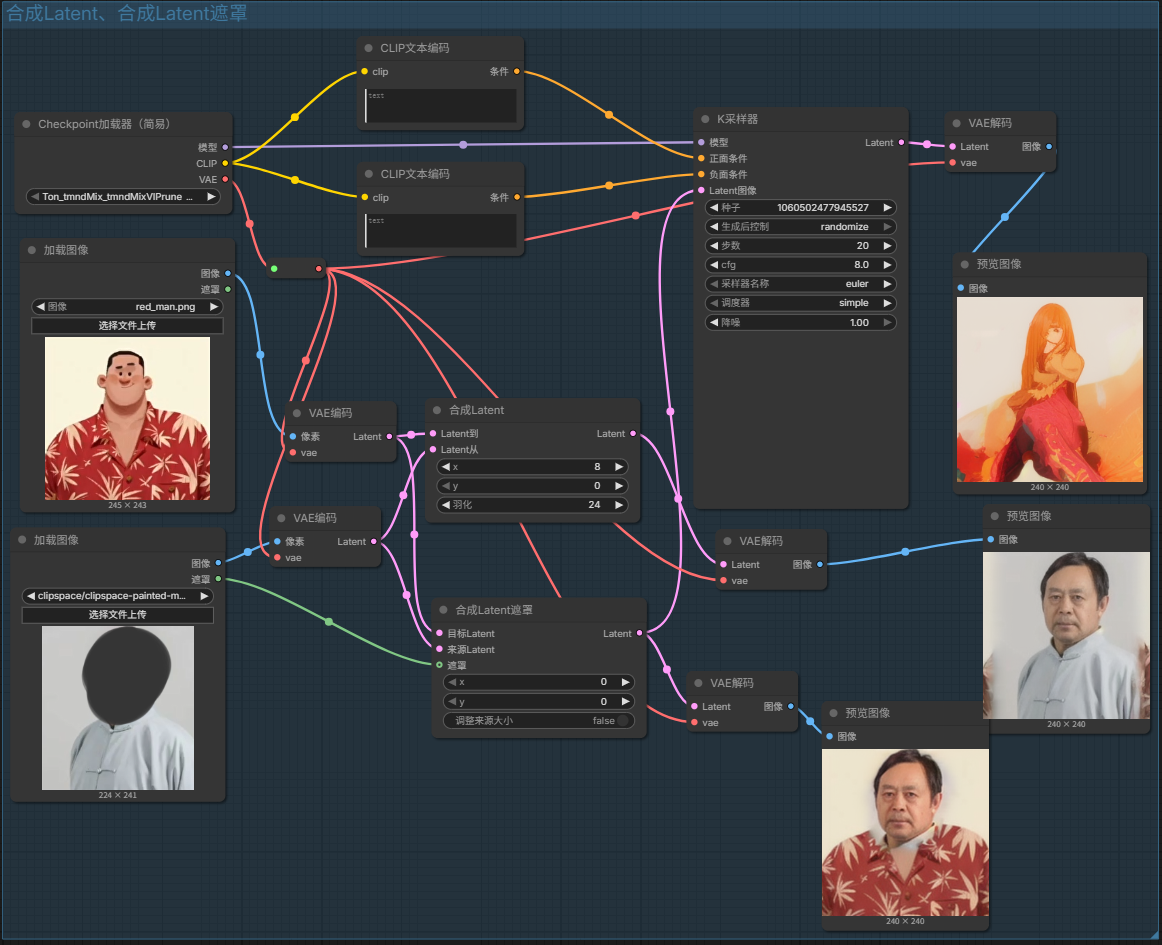
合成Latent、合成Latent遮罩

将两个图片的画面融合,把下面的源图片覆盖在目标图片上面

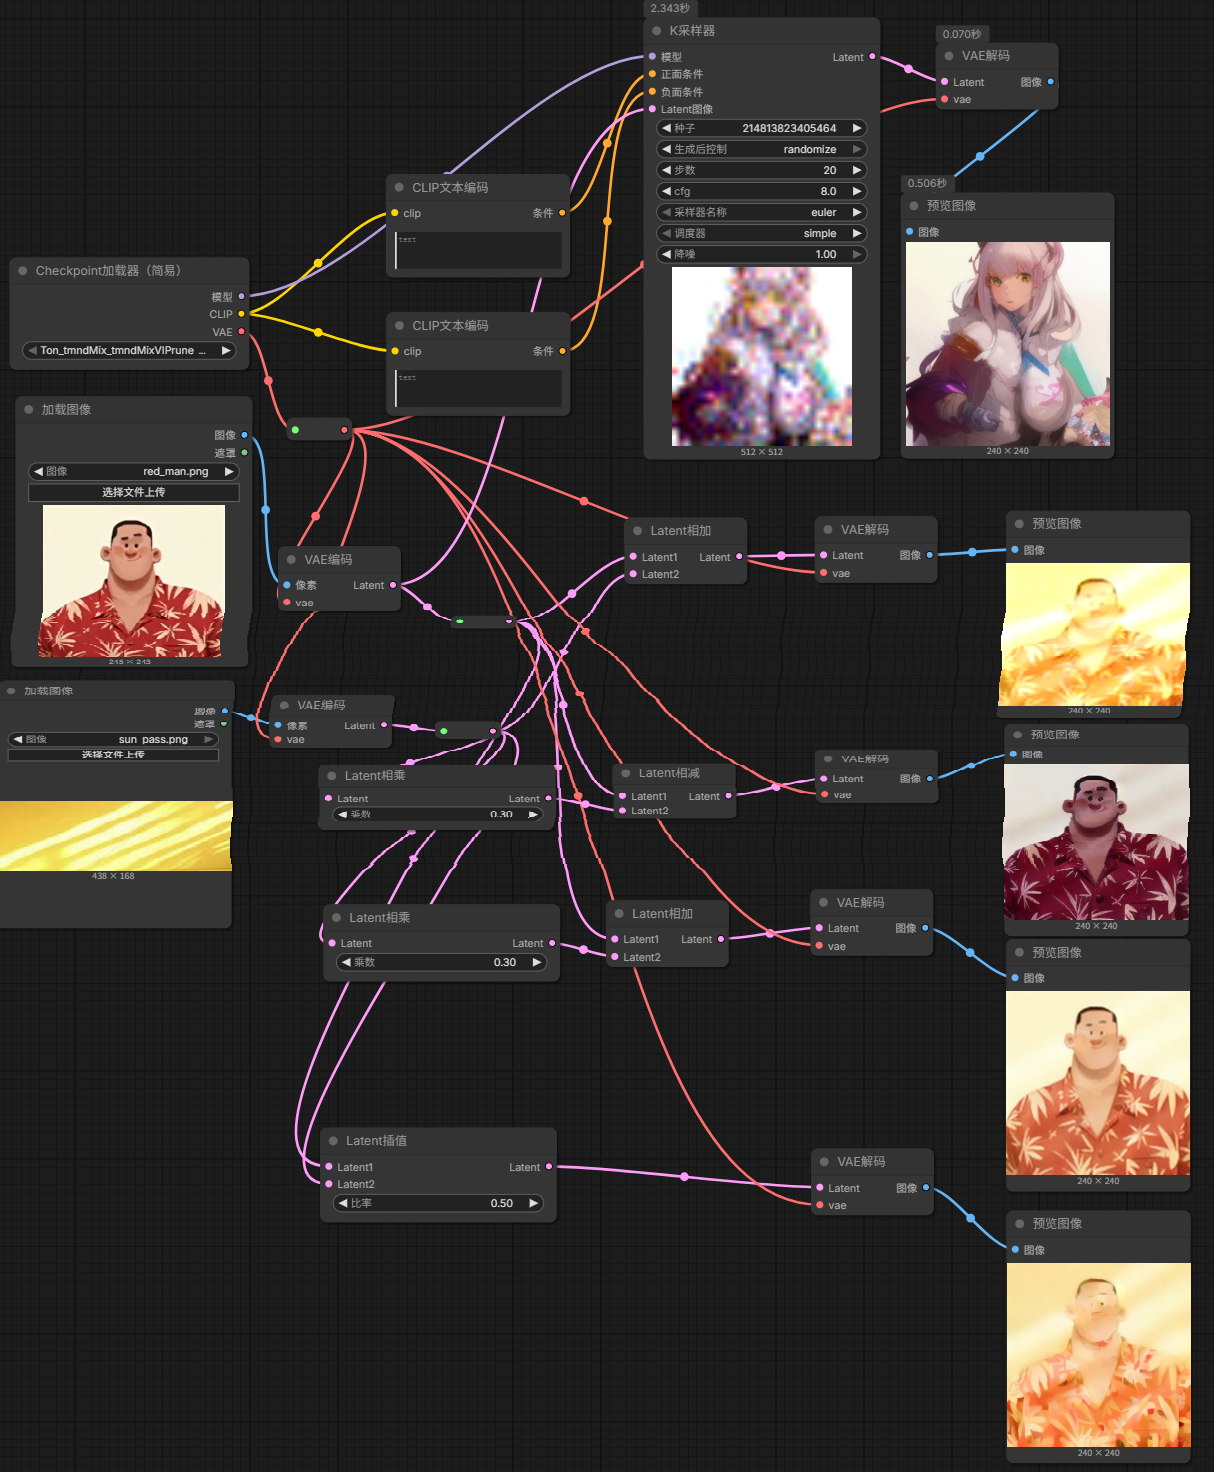
Latent相加、相减、相乘、插值

Latent插值:比率是1,只显示上面的图片;比率是0,只显示下面的图片;比率是0.5,两个图片以插值的方式相互交互在一起
Latent相加:把下面图片亮度最高的地方叠加到上面的图片来
Latent相乘(图片阳光透光) + Latent相加:通过相乘的系数来调整阳光的亮度
Latent相减:和相加相反,上面的图片减去下面阳光最亮的区域(光亮的地方变成阴影)

VAE内补编码器、设置Latent噪波遮罩

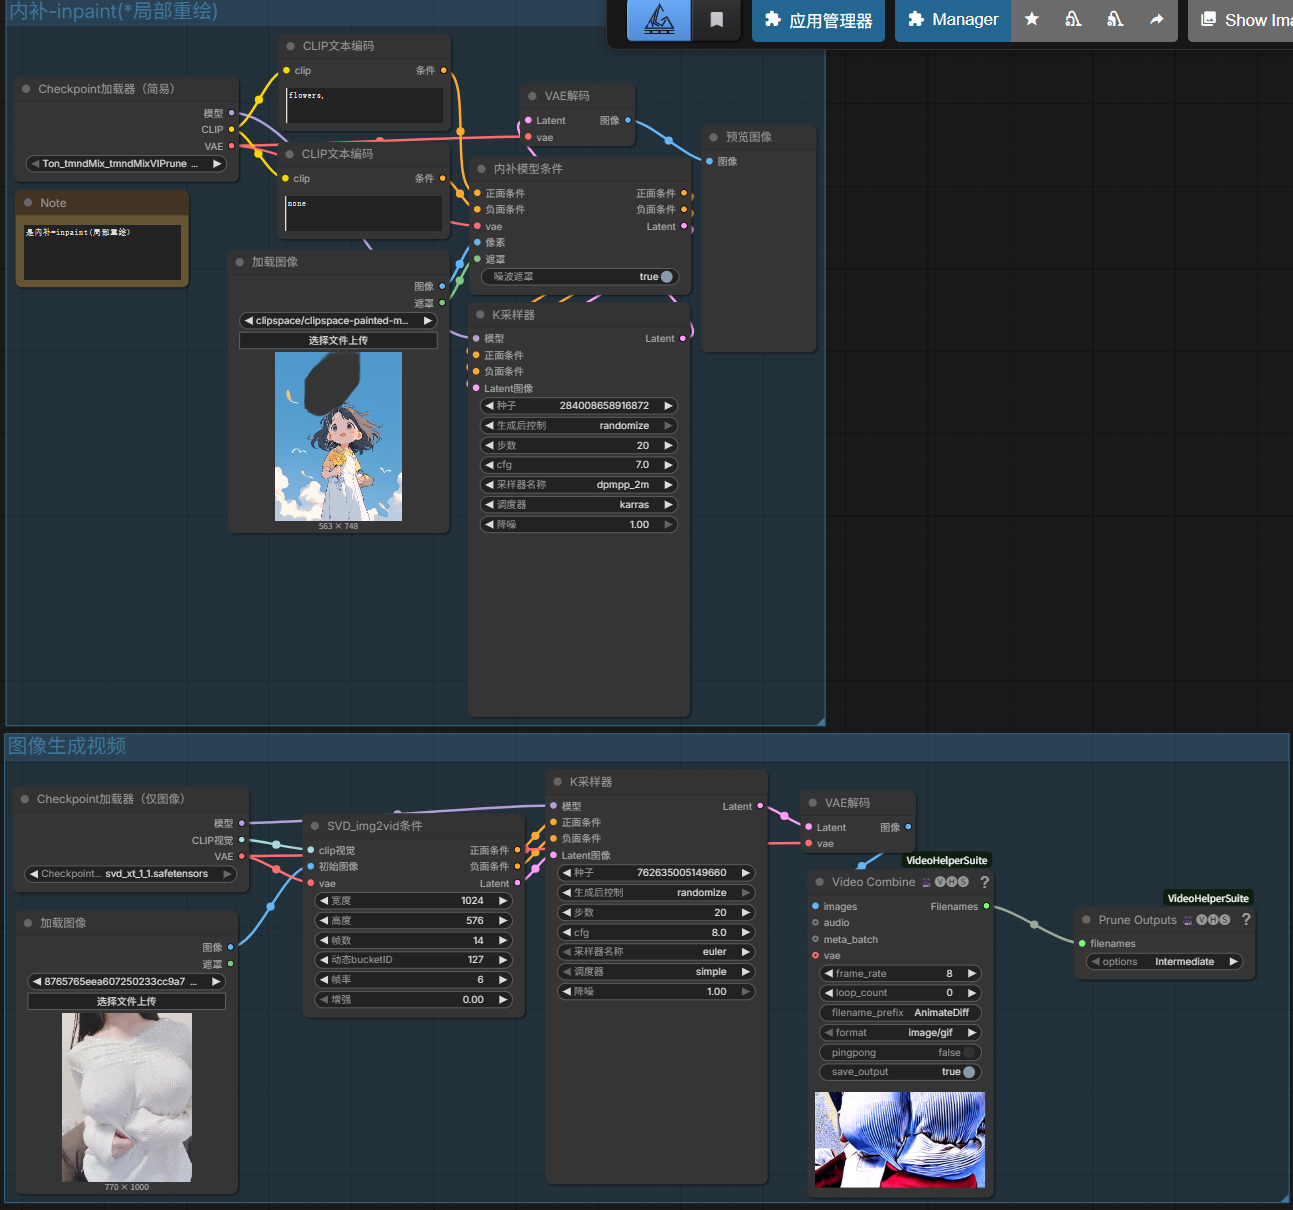
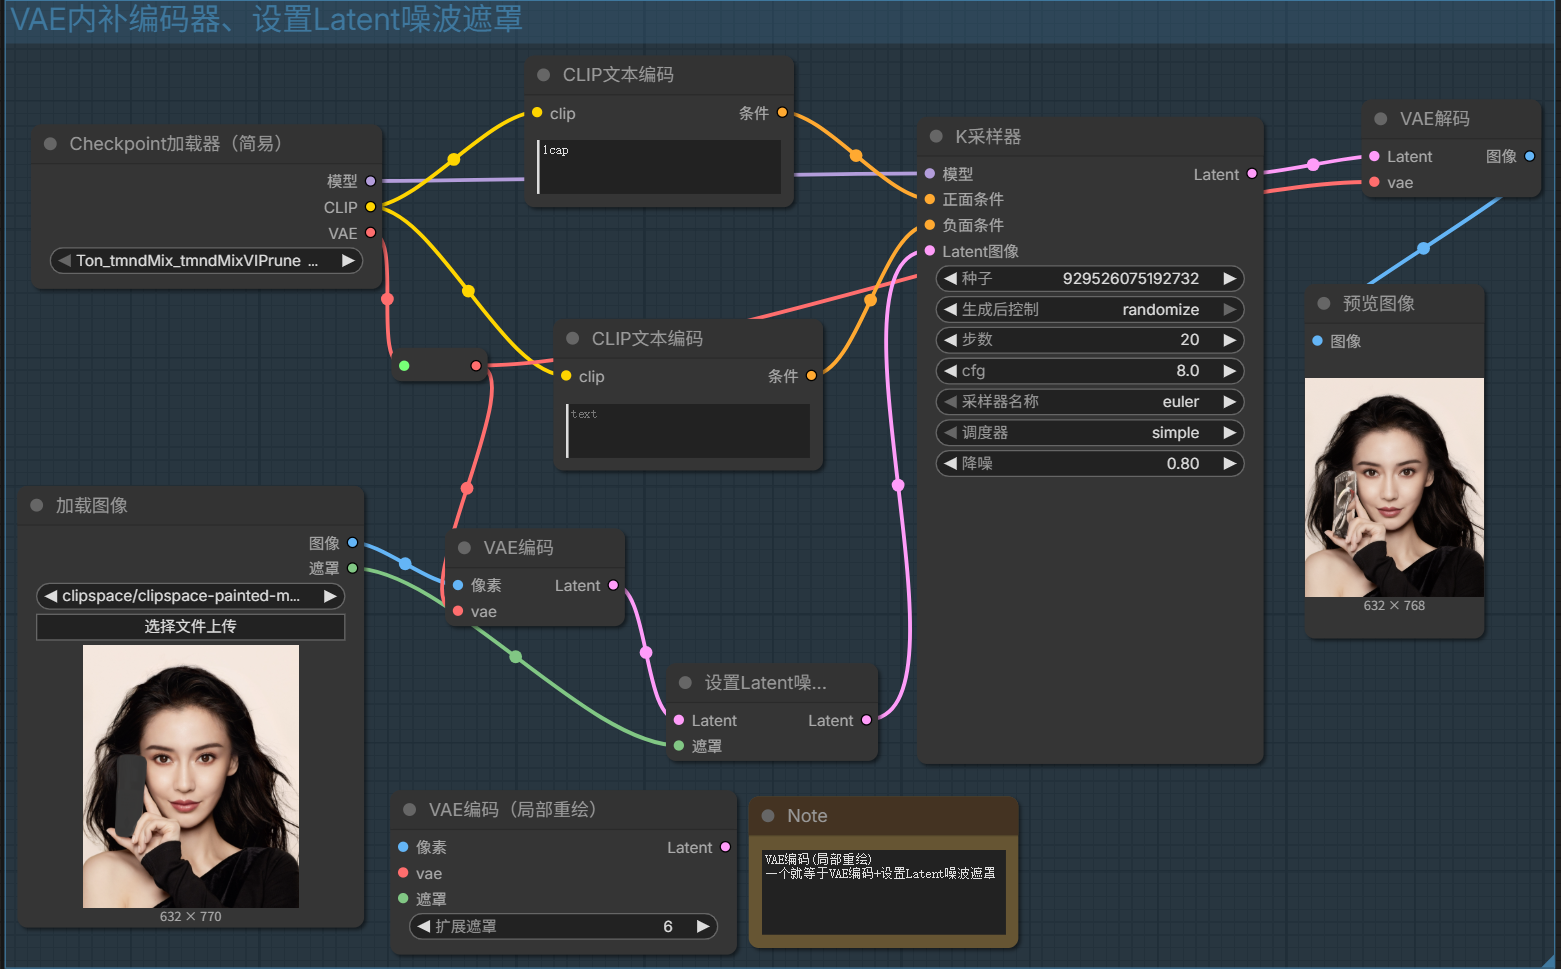
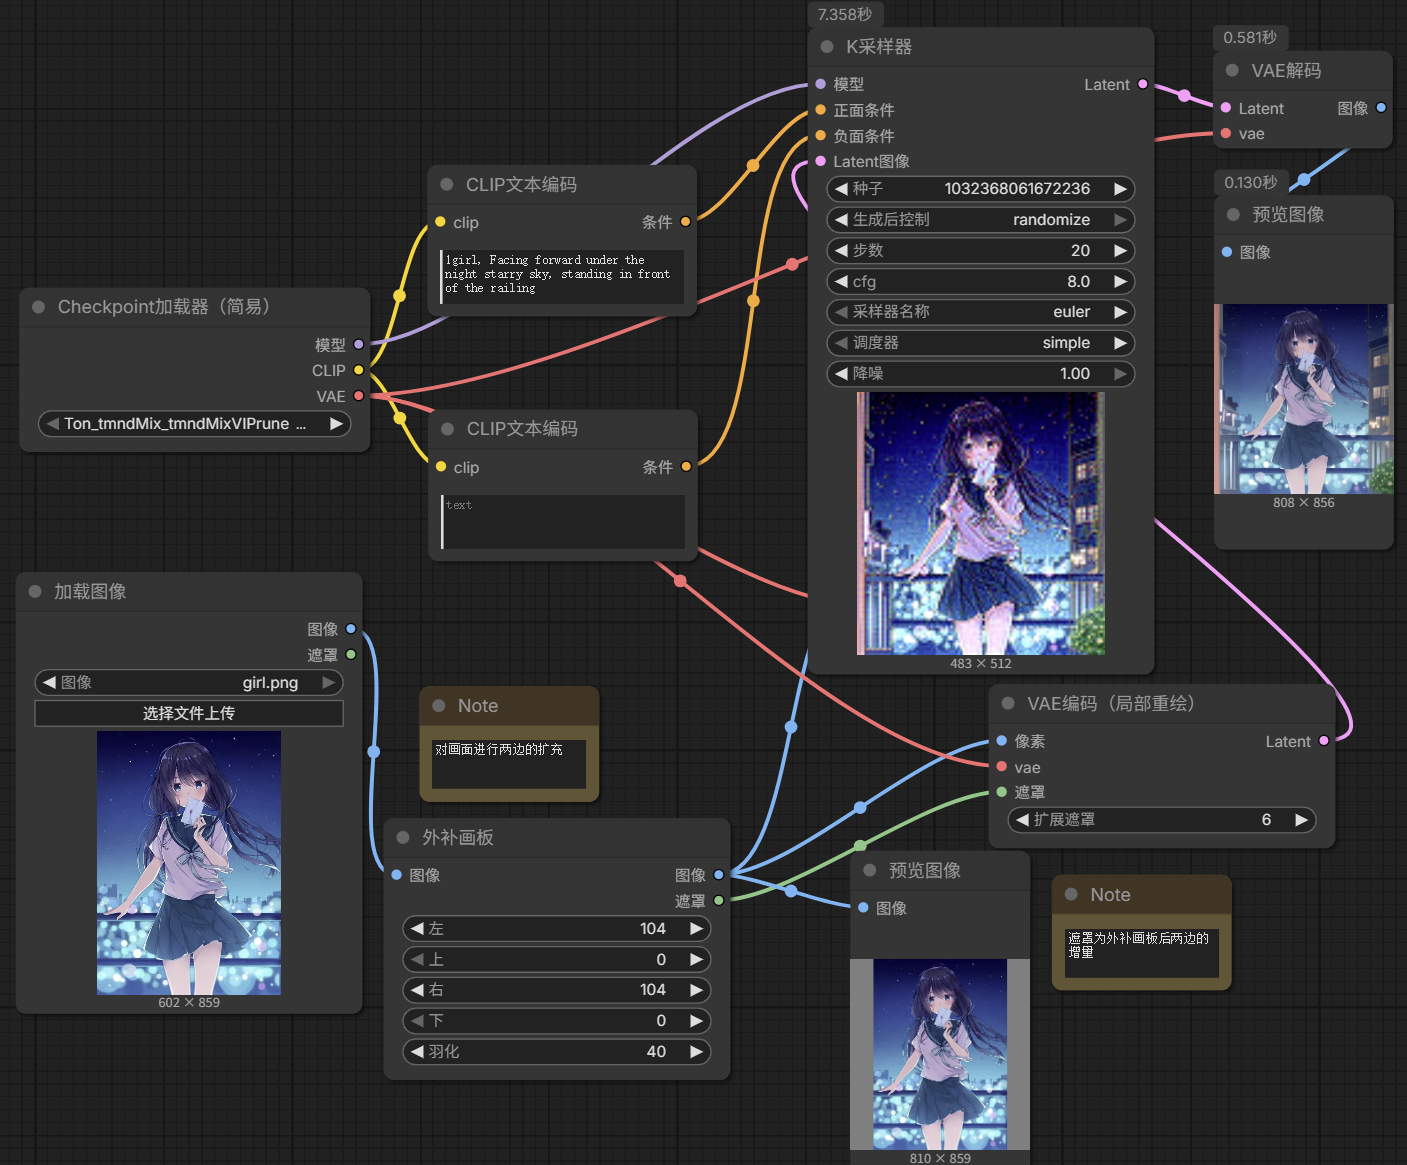
VAE内补编码器(VAE编码+设置Latent噪波遮罩):内补就是inpaint的意思是专门用来进行局部重绘的;其原理是把重绘区域涂抹成白色的潜空间进行重绘
[适合重绘一切和原图没有关系的内容]
设置Latent噪波遮罩:让上传的图片多出遮罩的输入;其原理是原图的基础上进行重绘的,重绘出来的内容会考虑到原图

Latent旋转、翻转、裁剪

可以改变图像的位置和方位以及大小

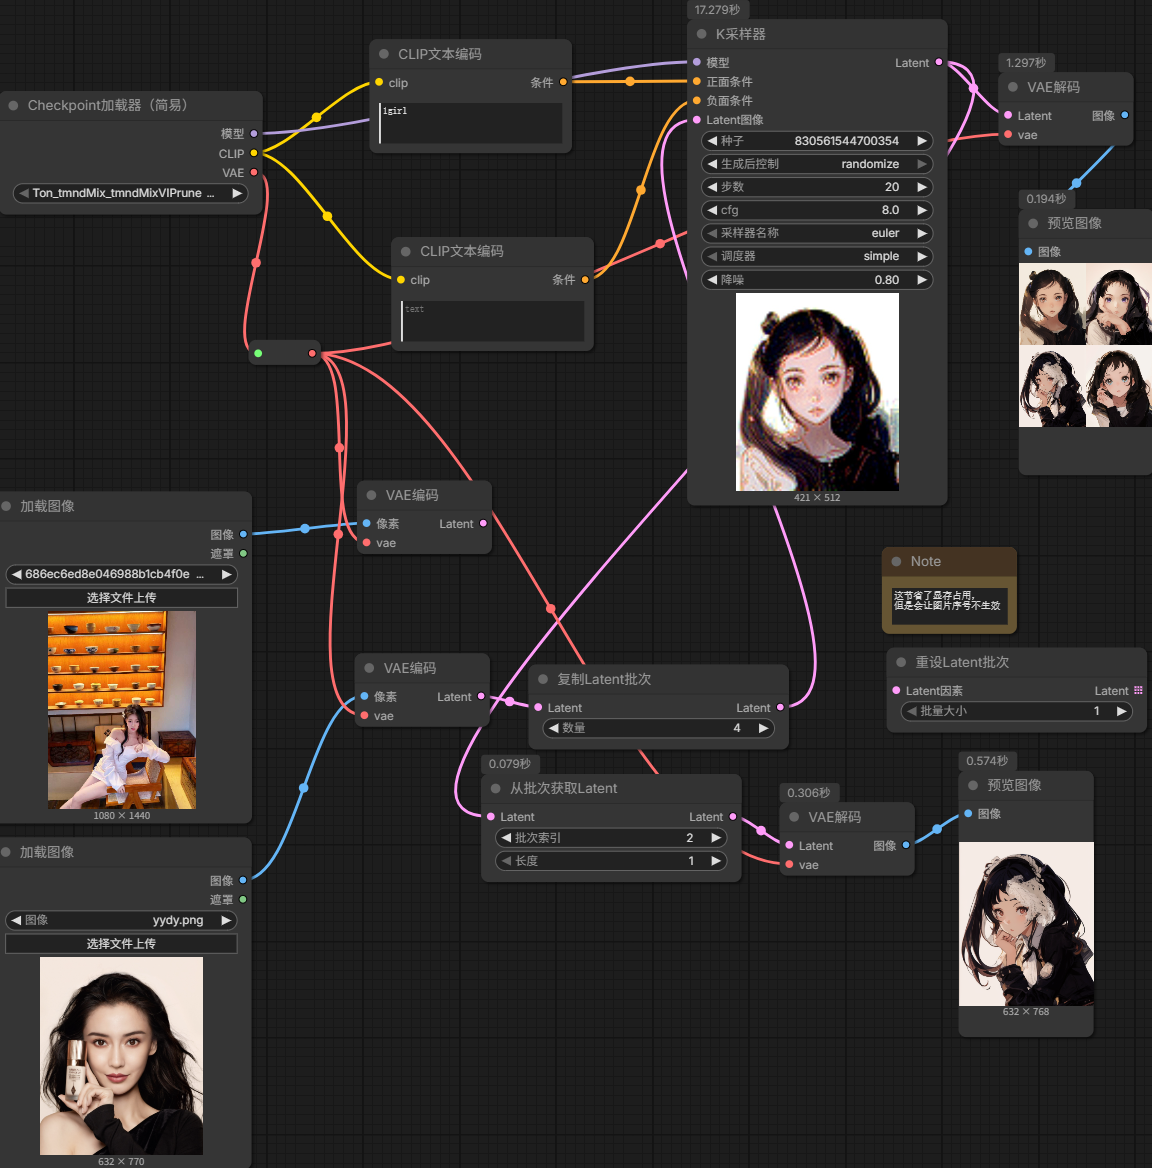
批处理Latent节点【后续进阶批量化出图】

复制Latent批次、重设Latent批次、从批次获取Latent

背景:我们在文生图的工作流里可以通过空Latent的批次大小 来改变一次生成多张图片;但如果是图生图工作流的话没有办法一次生成多个图片;所以需要Latent组合批次
批处理:一次生成多个图片的处理流程

复制Latent批次:连接后可以设置Latent生成图片的数量
重设Latent批次:拆分重组批次节省批量出图显存占用
从批次获取Latent:我想要通过复制Latent批次中的第二个索引(第三张图)的图片,此时只需要设置从批次获取Latent的批次索引为2即可;长度默认是1,也就是可以获取到索引以后的根据长度来断定图的数量

ComfyUI基础节点详解——图像

图像—放大

图像缩放:直接缩放按照宽高

图像按系数缩放按照插值的方式放大:按系数缩放边缘会更加柔和一些

图像缩放(按像素)增加像素点方式放大:按像素缩放会有一定的锯齿感

图像通过模型放大:用不同模型去放大 效果更好一些

可以新建一个Image Comparer来对比

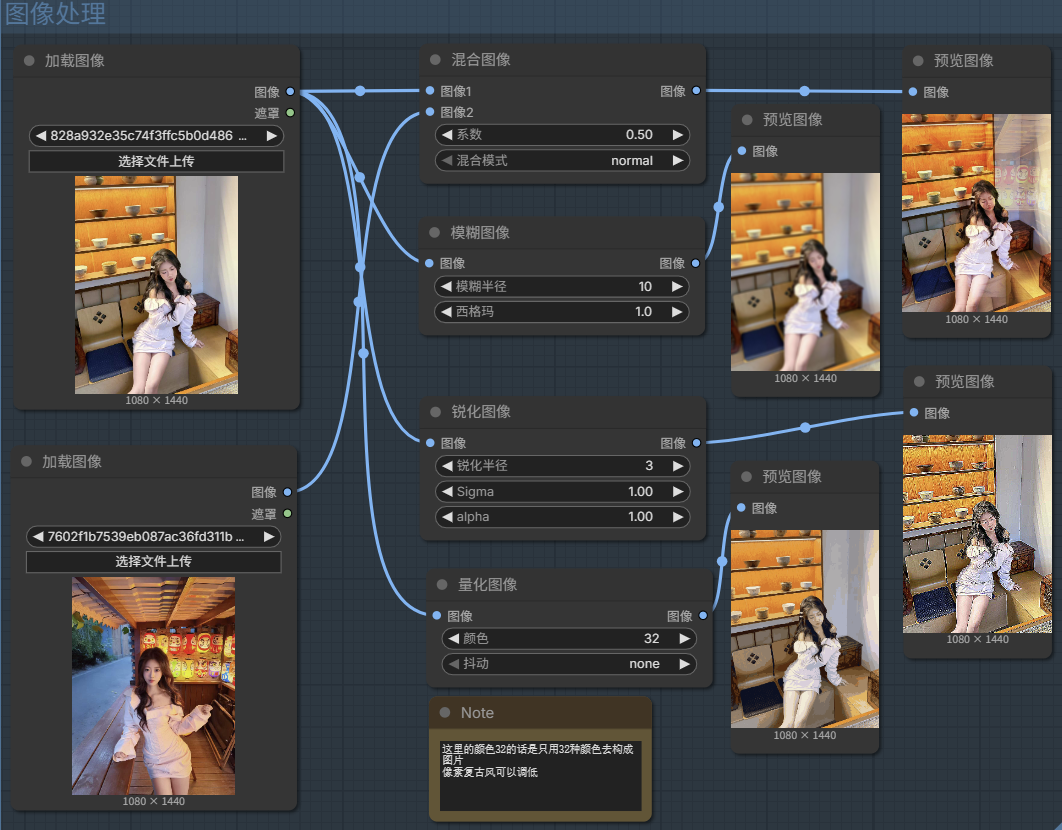
图像—处理

图像—批量

复制图像批次、重设图像批次、ImageFromBatch(这个是拿到某图像批次)

这里的原理跟上方的Latent是一样的

图像—预处理(Canny)

可以把图像变成噪点图像(捕捉图像边缘的Canny节点)!!!

图像—裁剪(图像裁剪)

图像裁剪 X,Y是进行移动位置

图像—动画(保存WEBP、保存APNG)

保存WEBP:把视频保存为适合网页播放的动画格式
保存APNG:把视频保存成一系列的动画序列帧

图像—加载图像

可以加载出图像

图像—空图像

空图像串入VAE编码,在空图像下方再拉出一个预览图像。那么K就会根据预览图像的基准生成

图像—反转

类似于冲洗相片→得到相片底片效果

图像—图像组合批次、图像遮罩复合

这里的原理跟上方的Latent是一样的

图像—预览图像

仅生成图像结果,不会在硬盘中保存

图像—保存图像

生成预览结果的同时,还会保存图片到对应文件夹

图像—外补画板

在图片扩充工作流里经常用的到
有上,下,左,右,羽化的参数;比如可以扩展图像左侧街道的画面 → 左 100
这里注意要对原来的图像进行扩充需要用到之前讲过的VAE内补编码器

ComfyUI基础节点详解——采样器

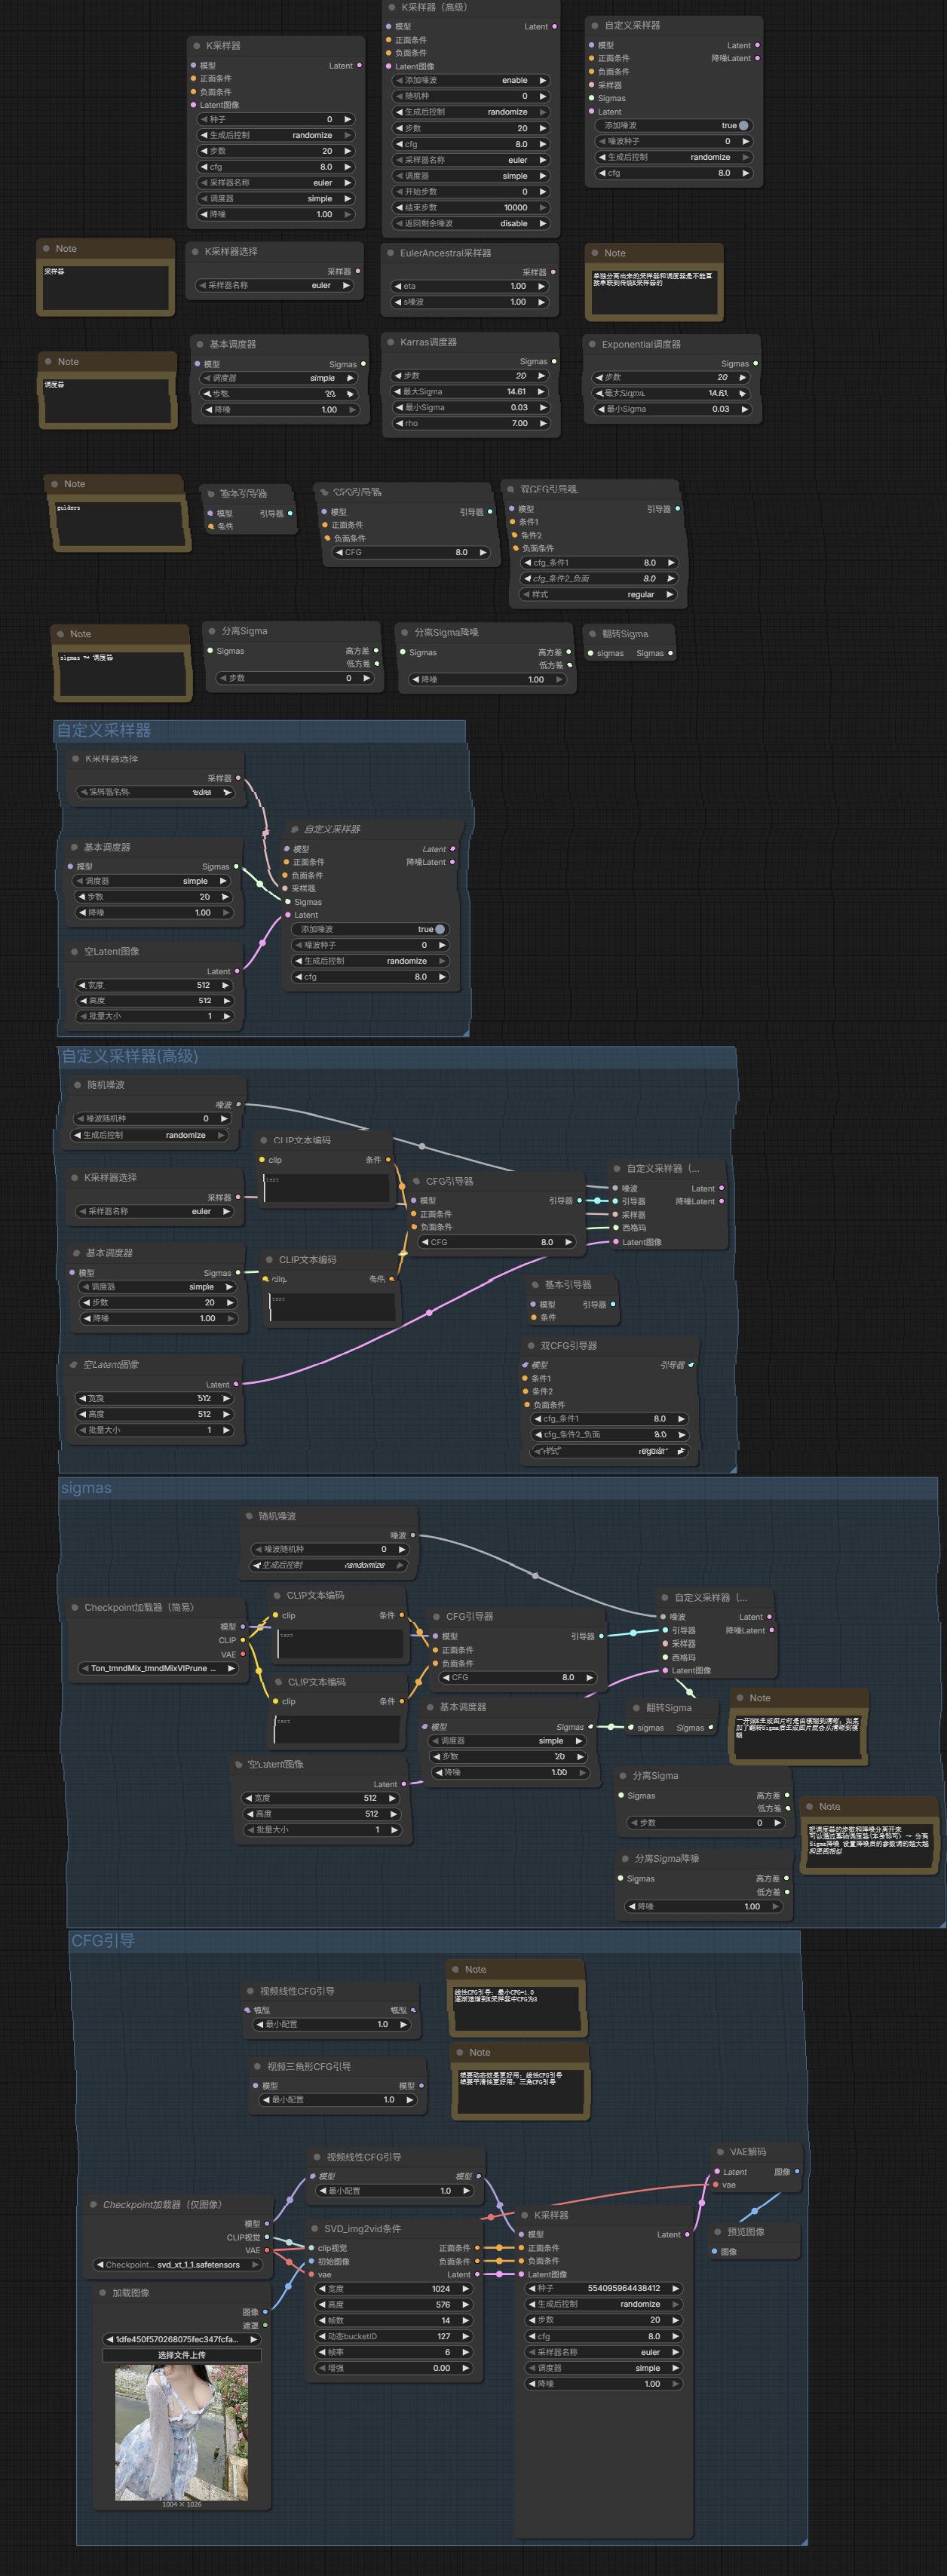
  • **K采样器(高级)**:下面的开始、结束降噪步数专门是给SDXL refiner使用的
  • 自定义采样器:左边输入接口多出了采样器和Sigmas(调度器)
    • K采样器选择
    • 基础调度器
  • 自定义采样器(高级)
    • 随机噪波
    • 基础引导器
    • CFG引导器:CFG值越低,那么AI就会加入越多自己的想法【一般设置低一些(太低会带来画面动态闪烁)】
    • 双CFG引导器

把这些参数一一单独划分出来的好处就是同样的参数,我们分配给多个采样器共用,对多个采样器进行同步控制,增加工作流的灵活性。

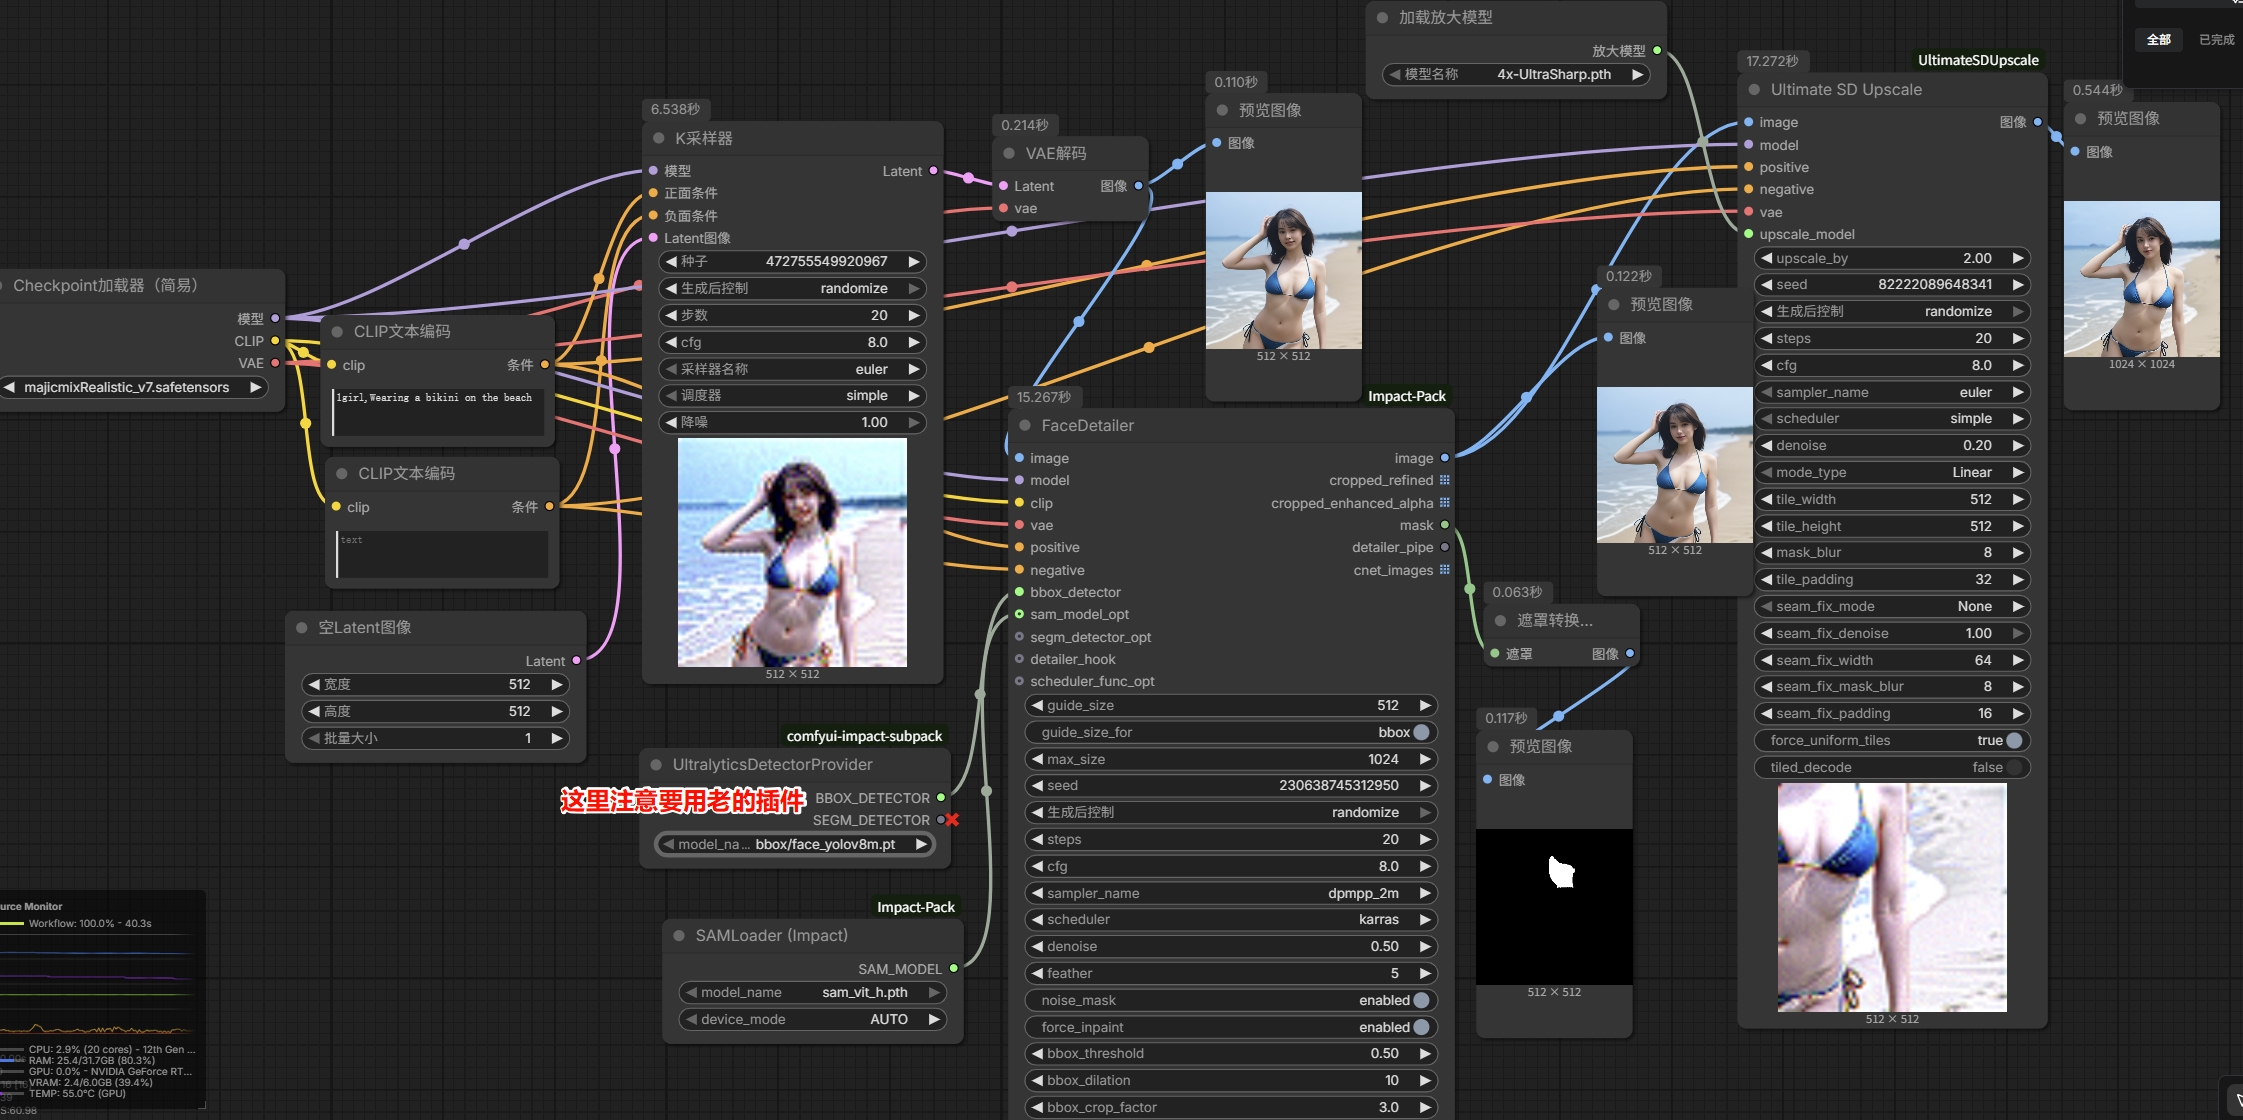
面部检测与面部修复技巧

右键 → 新建节点 → Impact节点 → 简易 → 面部细化(FaceDetailer)

这里有个大坑 新版要安装comfyui-impact-subpack插件,并用老的UltralyticsDetectorProvider

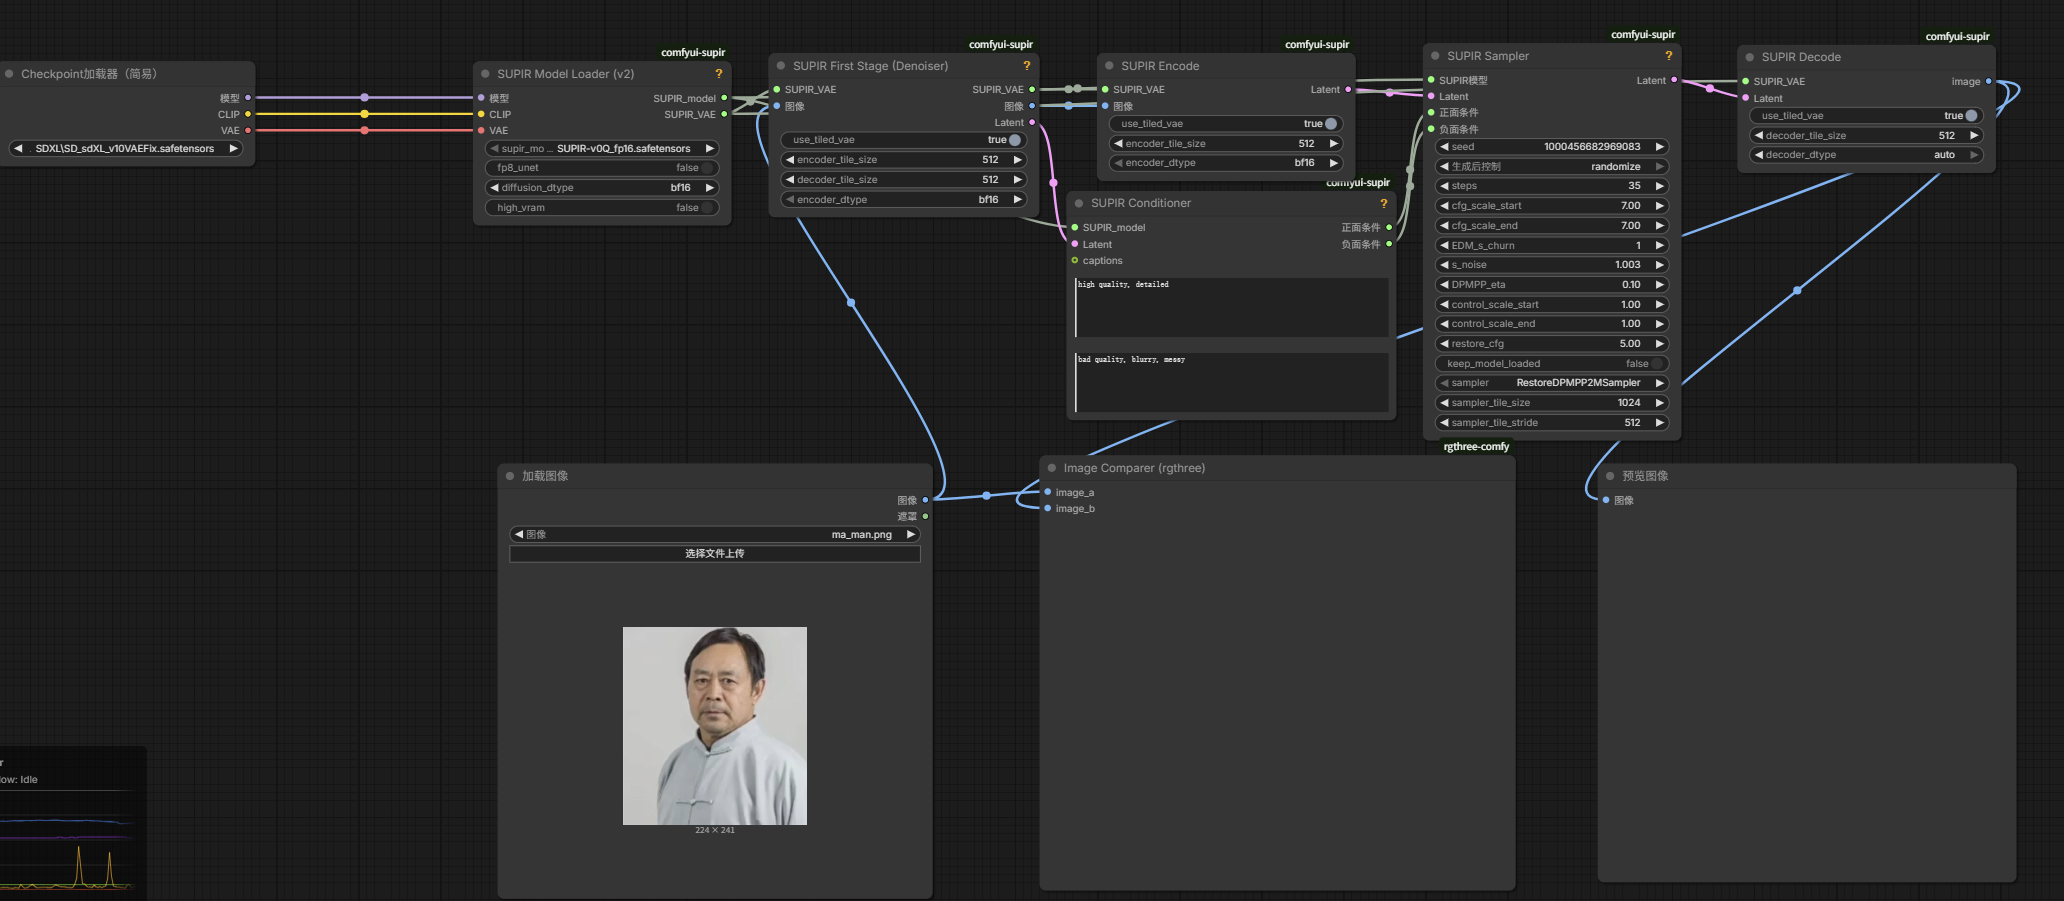
SUPIR智能修复高清放大

下载模型:SUPIR-v0Q.ckpt(适合大部分场景)、而SUPIR-v0f.ckpt(适合暗光场景) 这两个非常吃显卡资源,所以有平替SUPIR-v0Q_fp16.safetensors(容量降低一半的FP16半精度模型)

SUPIR是必须配对SDXL模型才有效果

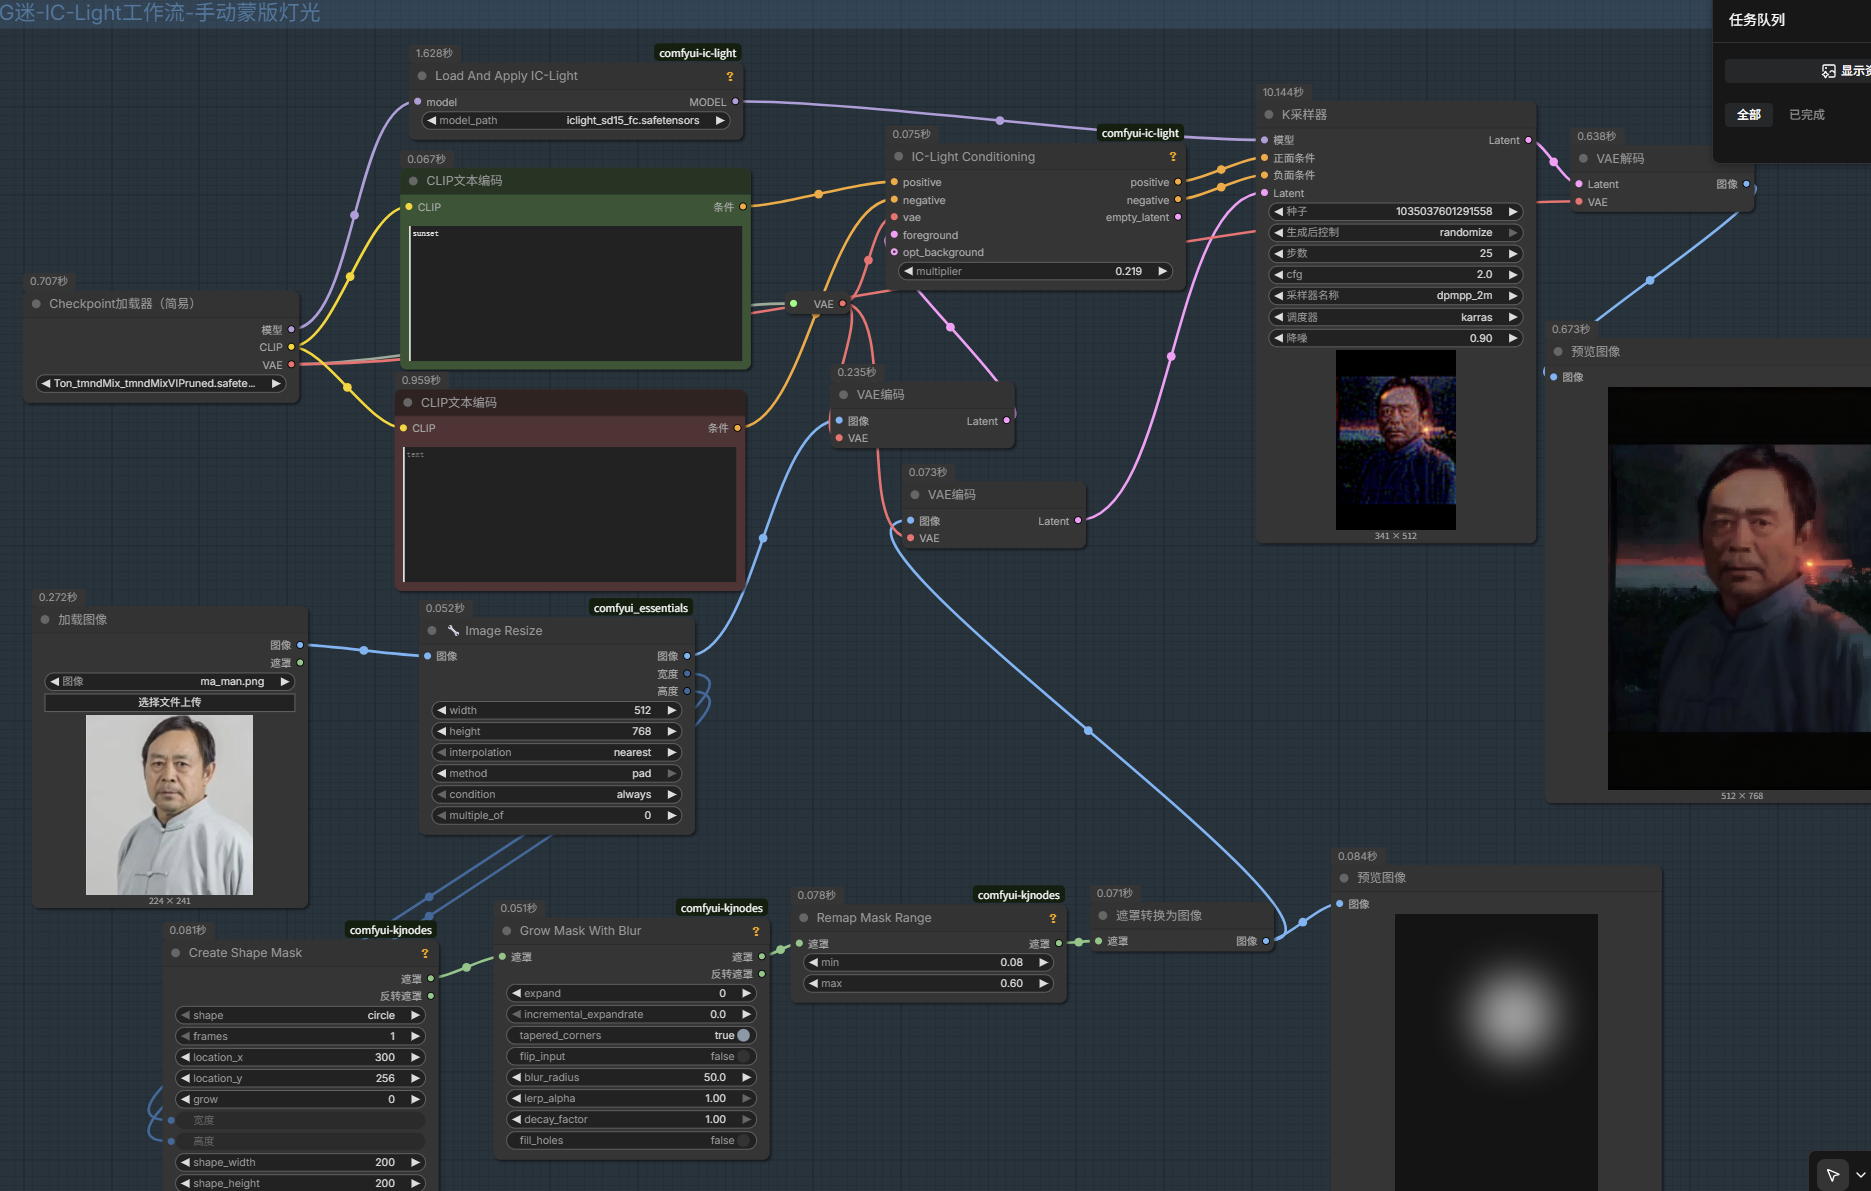
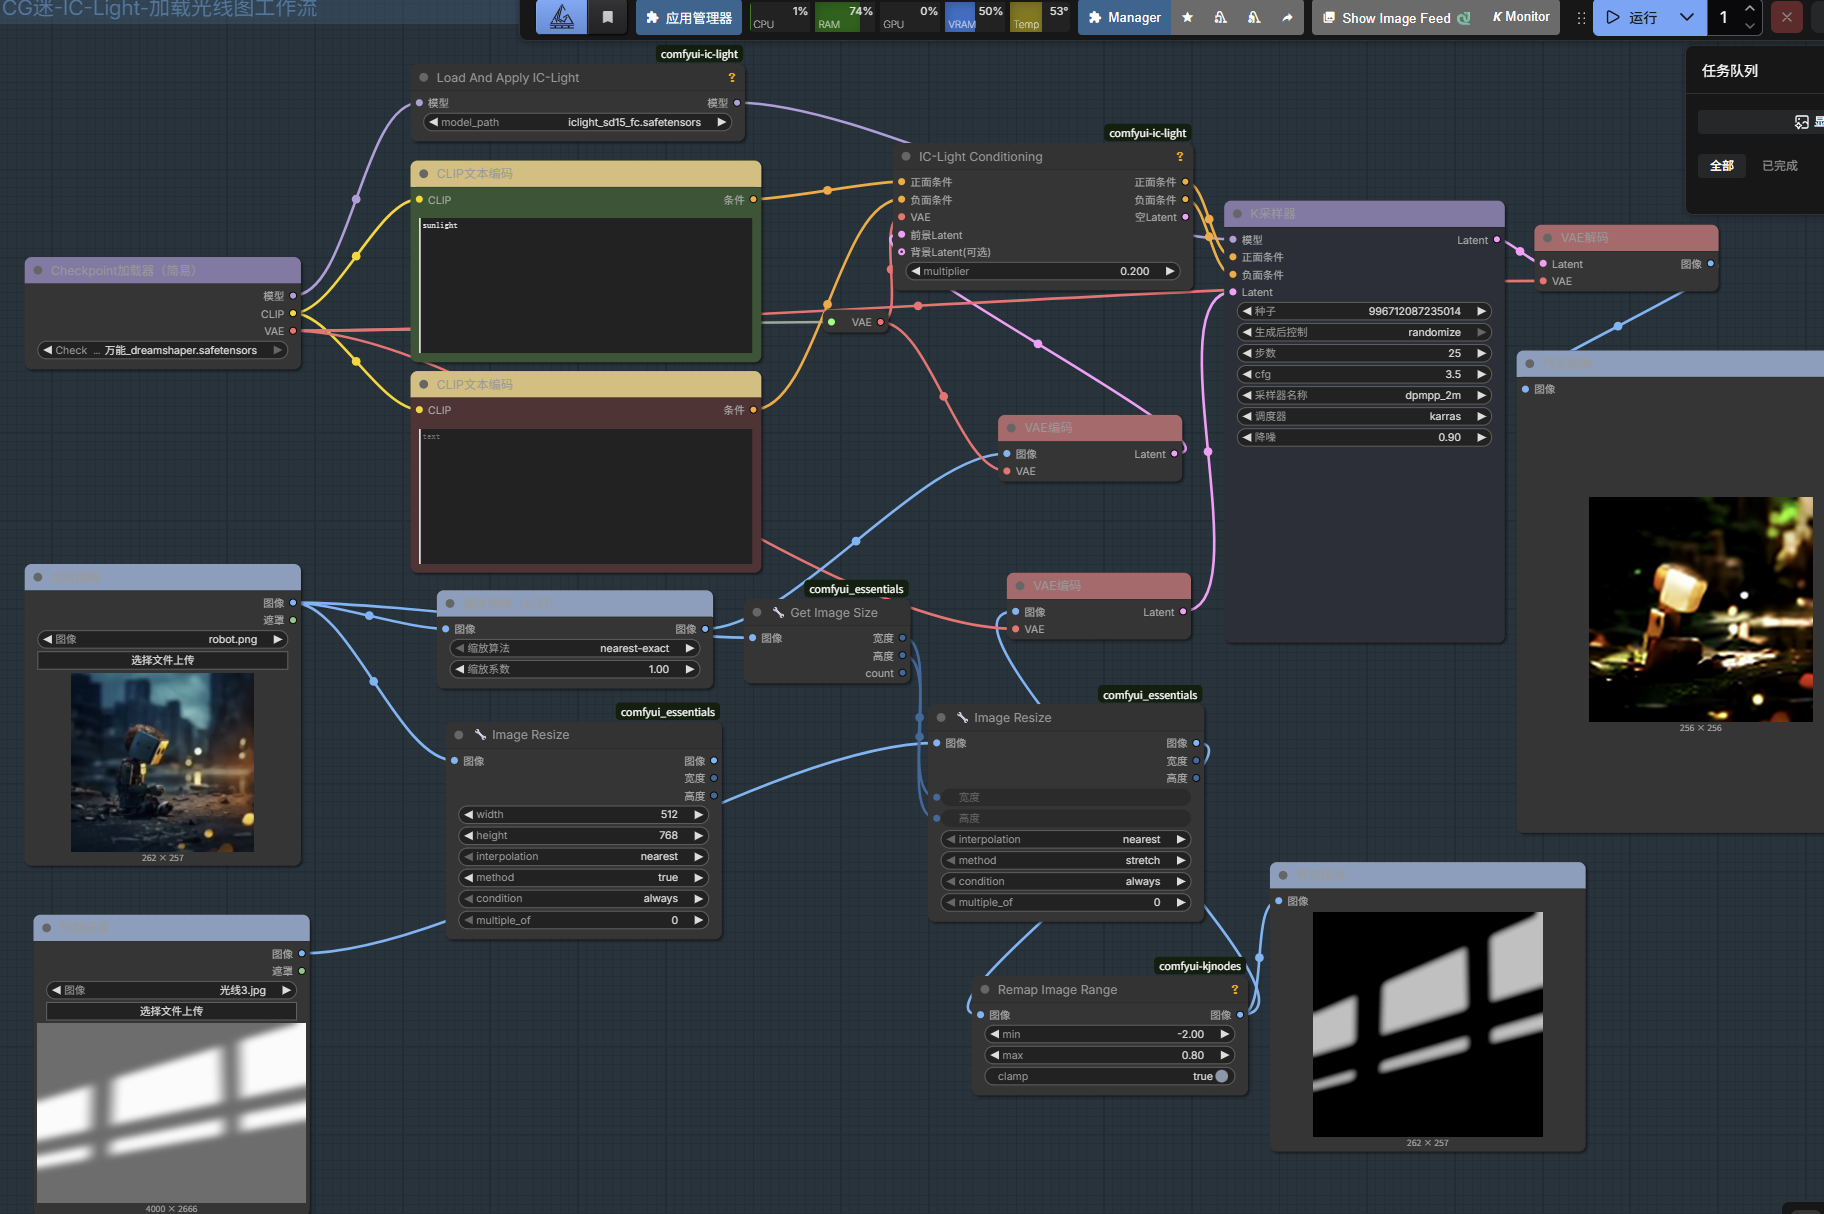
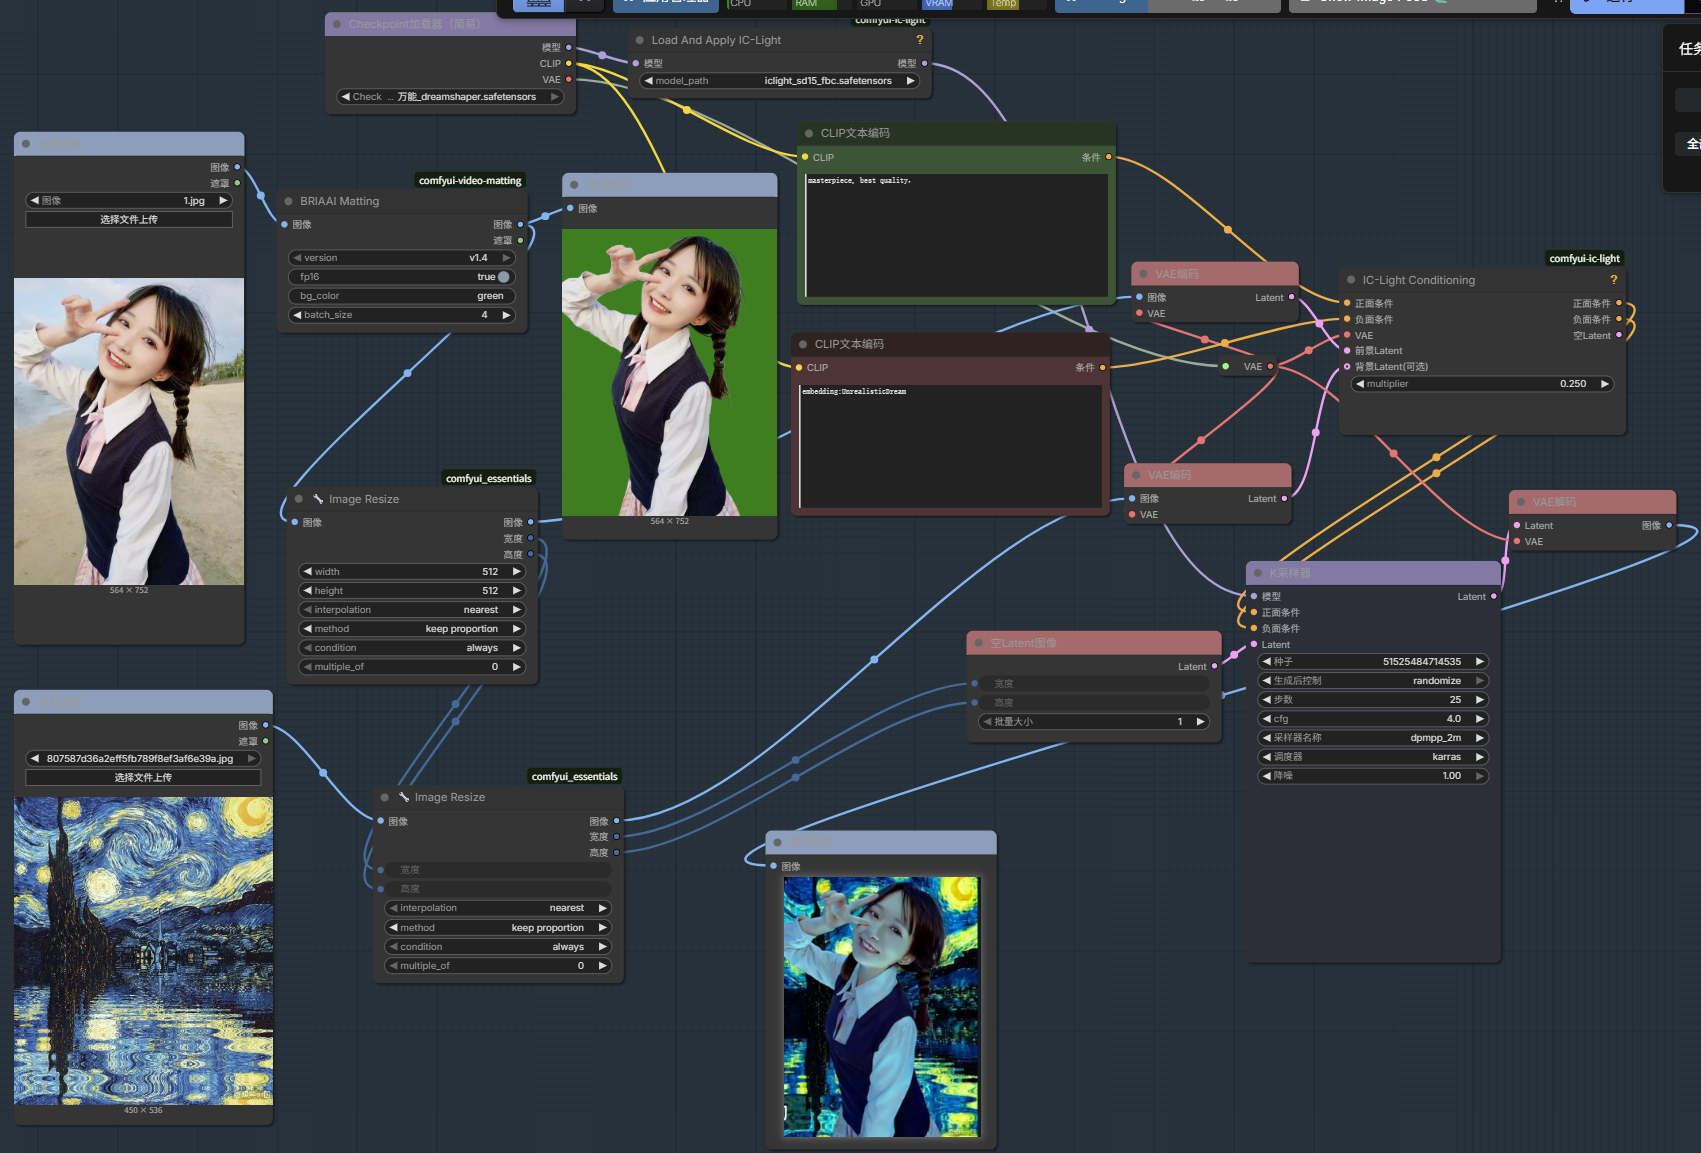
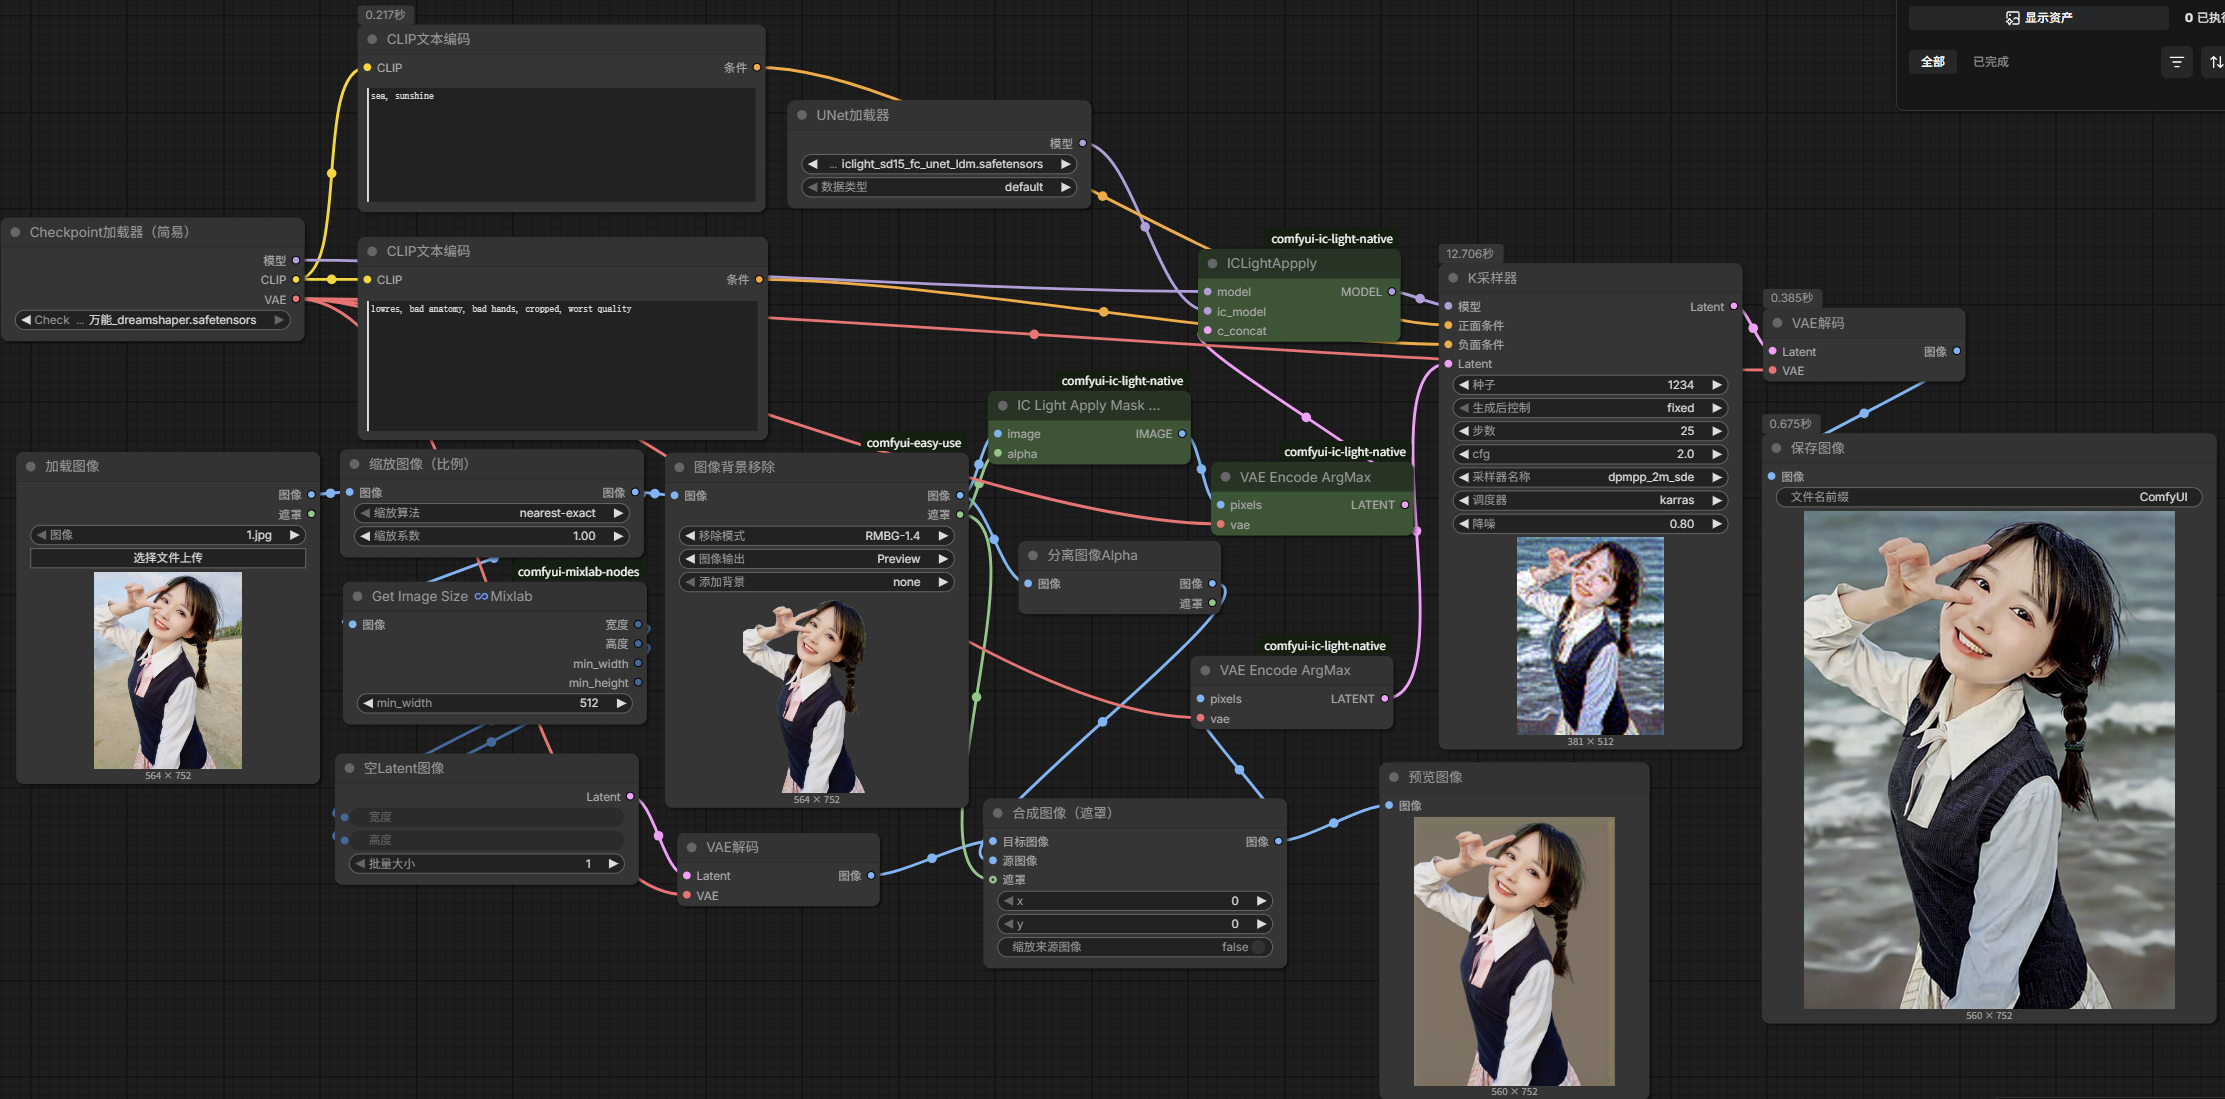
IC-Light智能自定义重打光

IC-Light + kjnode + video-Matting
下载iclight_sd15_fbc.safetensors放在xxx/models/unet/IC-Light文件夹里面

IC-Light-Native自定义背景融合打光

重映射图像范围Remap Image Range中的min 可以变小 就相相当于增加暗光的暗

  • 手动调整光源

  • 直接上传光源图

  • 上传背景图融合

  • 直接创建背景融合(提示词)+也需要抠图节点

需要安装lc-light-native + layerdiffuse插件
把iclight_sd15_fbc_unet_ldm.safetensors和iclight_sd15_fc_unet_ldm.safetensors模型放到E:\ComfyUI-AI_DeskTop\ComfyUI-aki-v3\ComfyUI\models\unet中

节点自定义颜色美化与修改

下载一个组件Jovimetrix Composition Nodes 找一下旁边的调色板

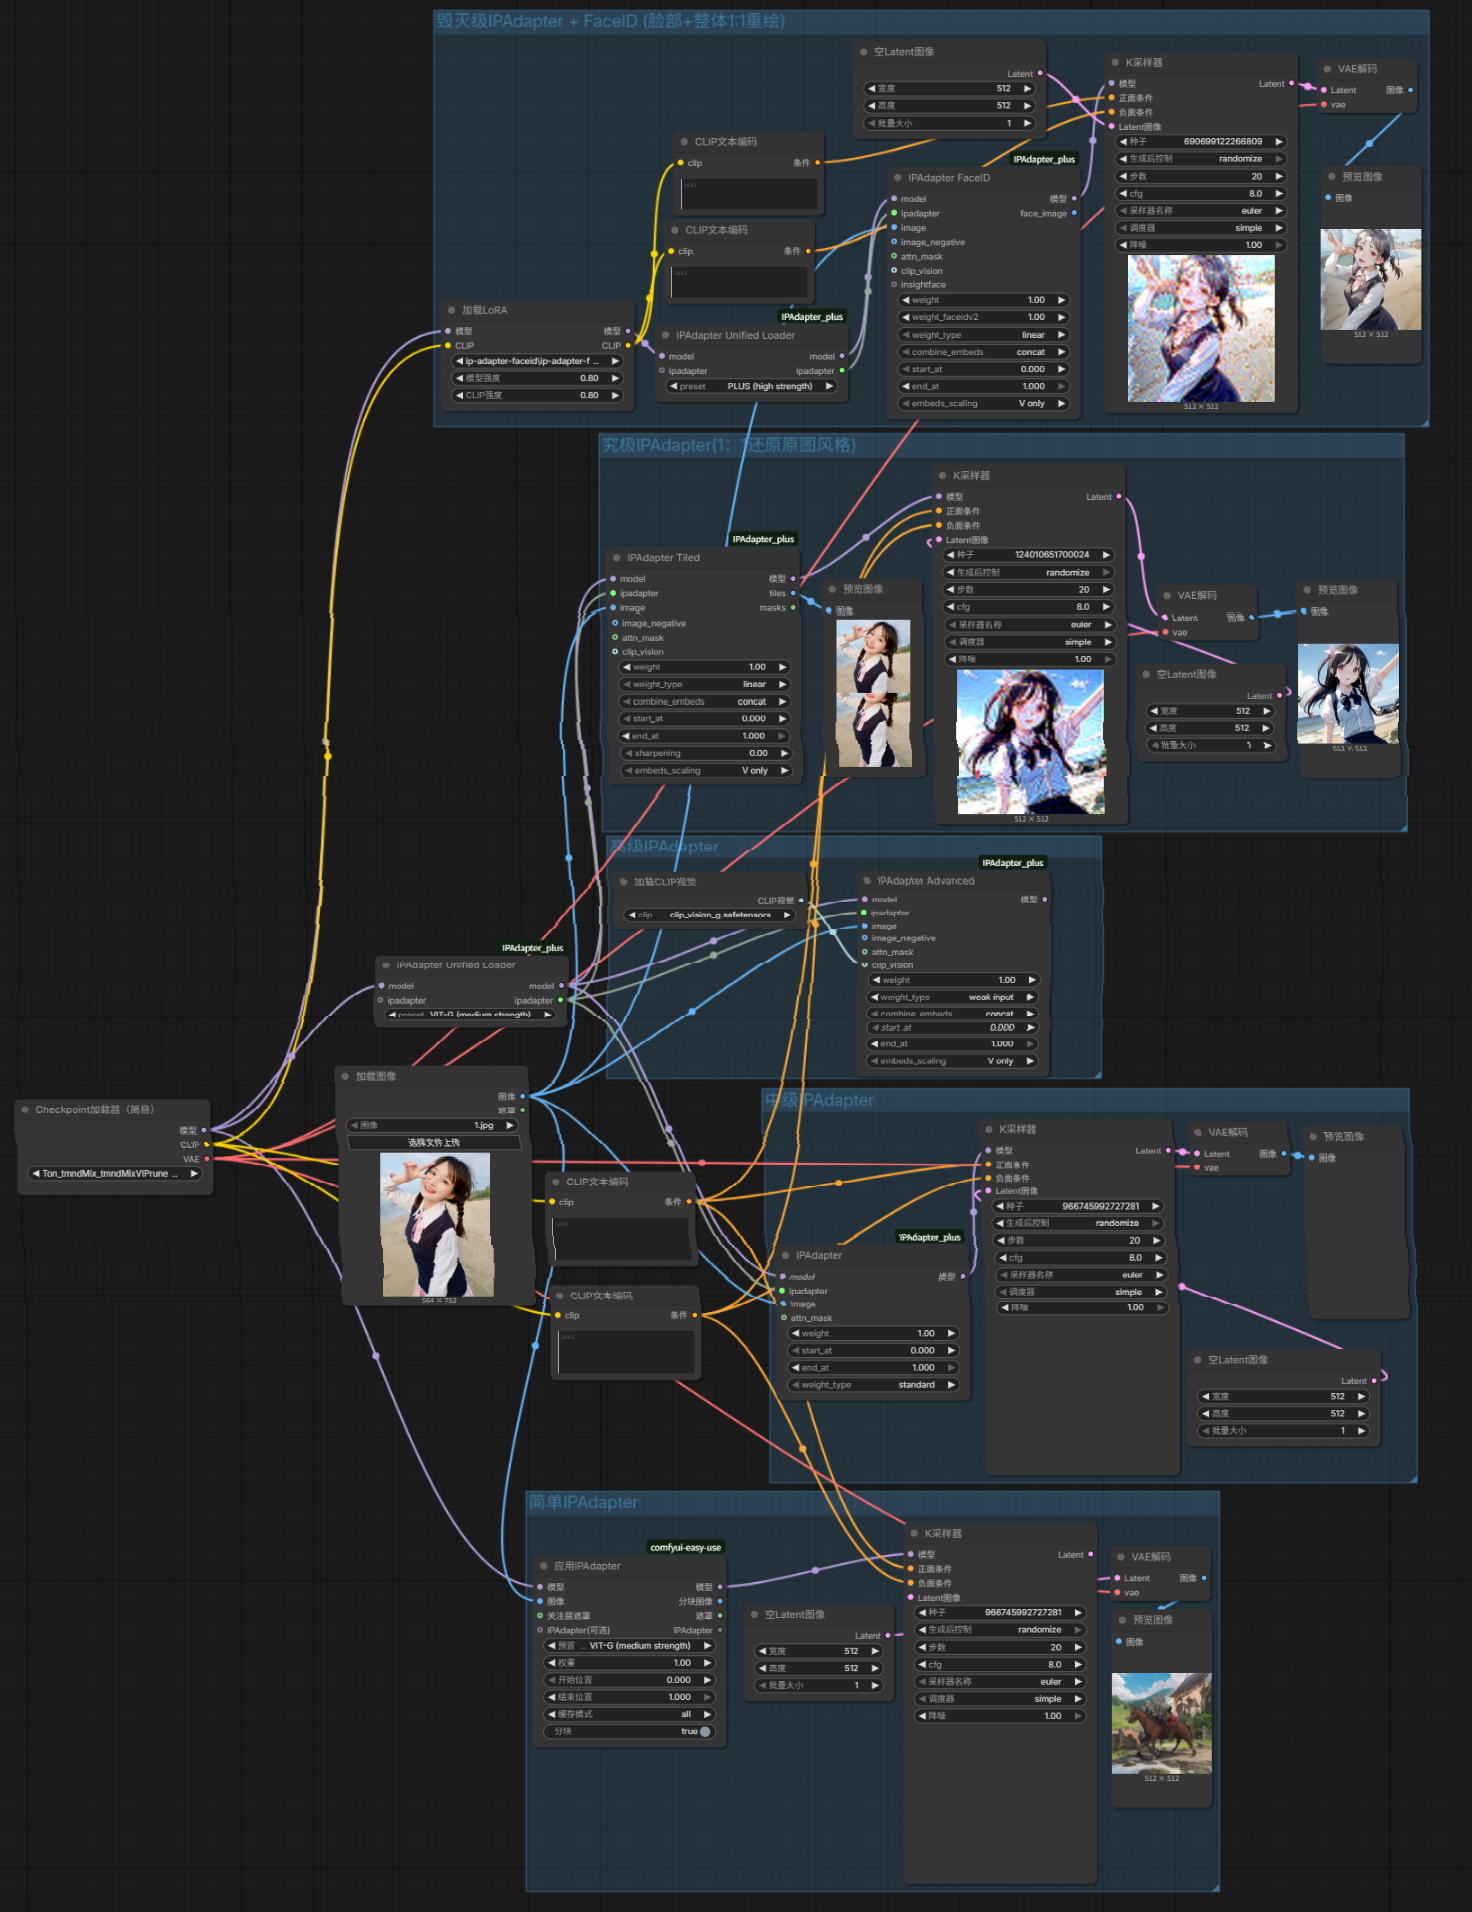
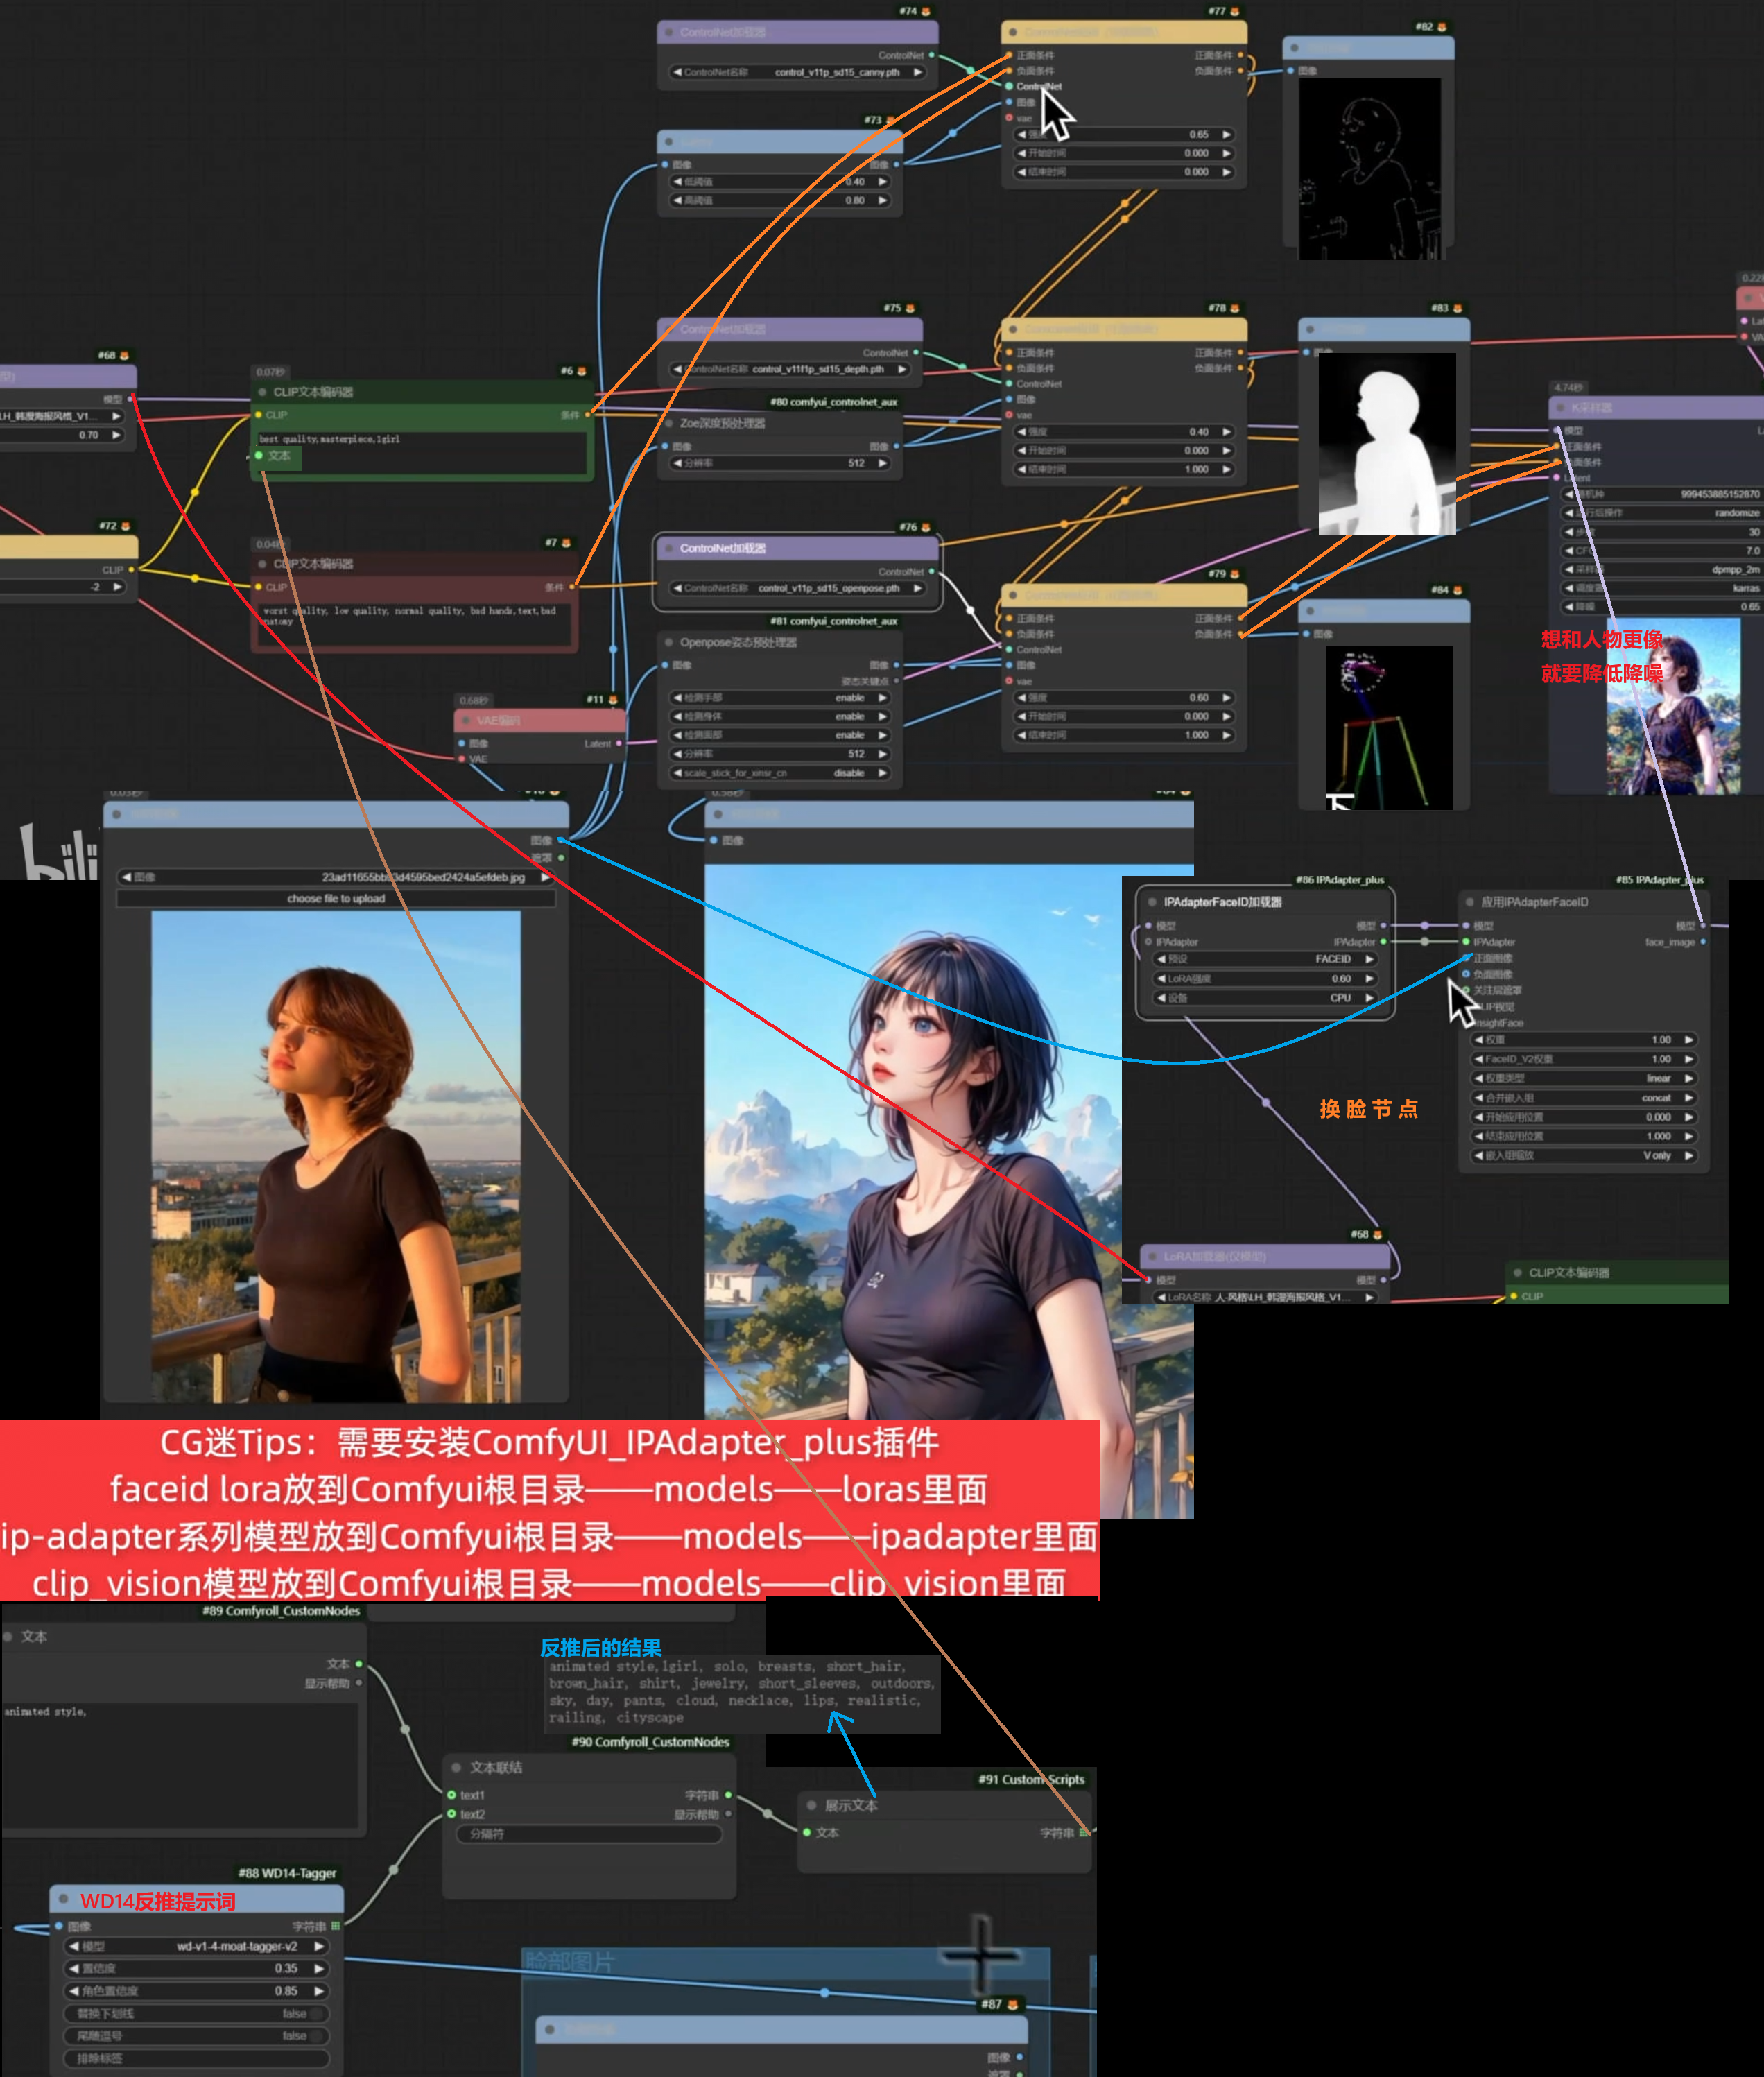
新版IPadapter + FaceID使用方法

下载一个组件esay use + IPAdapter_plus

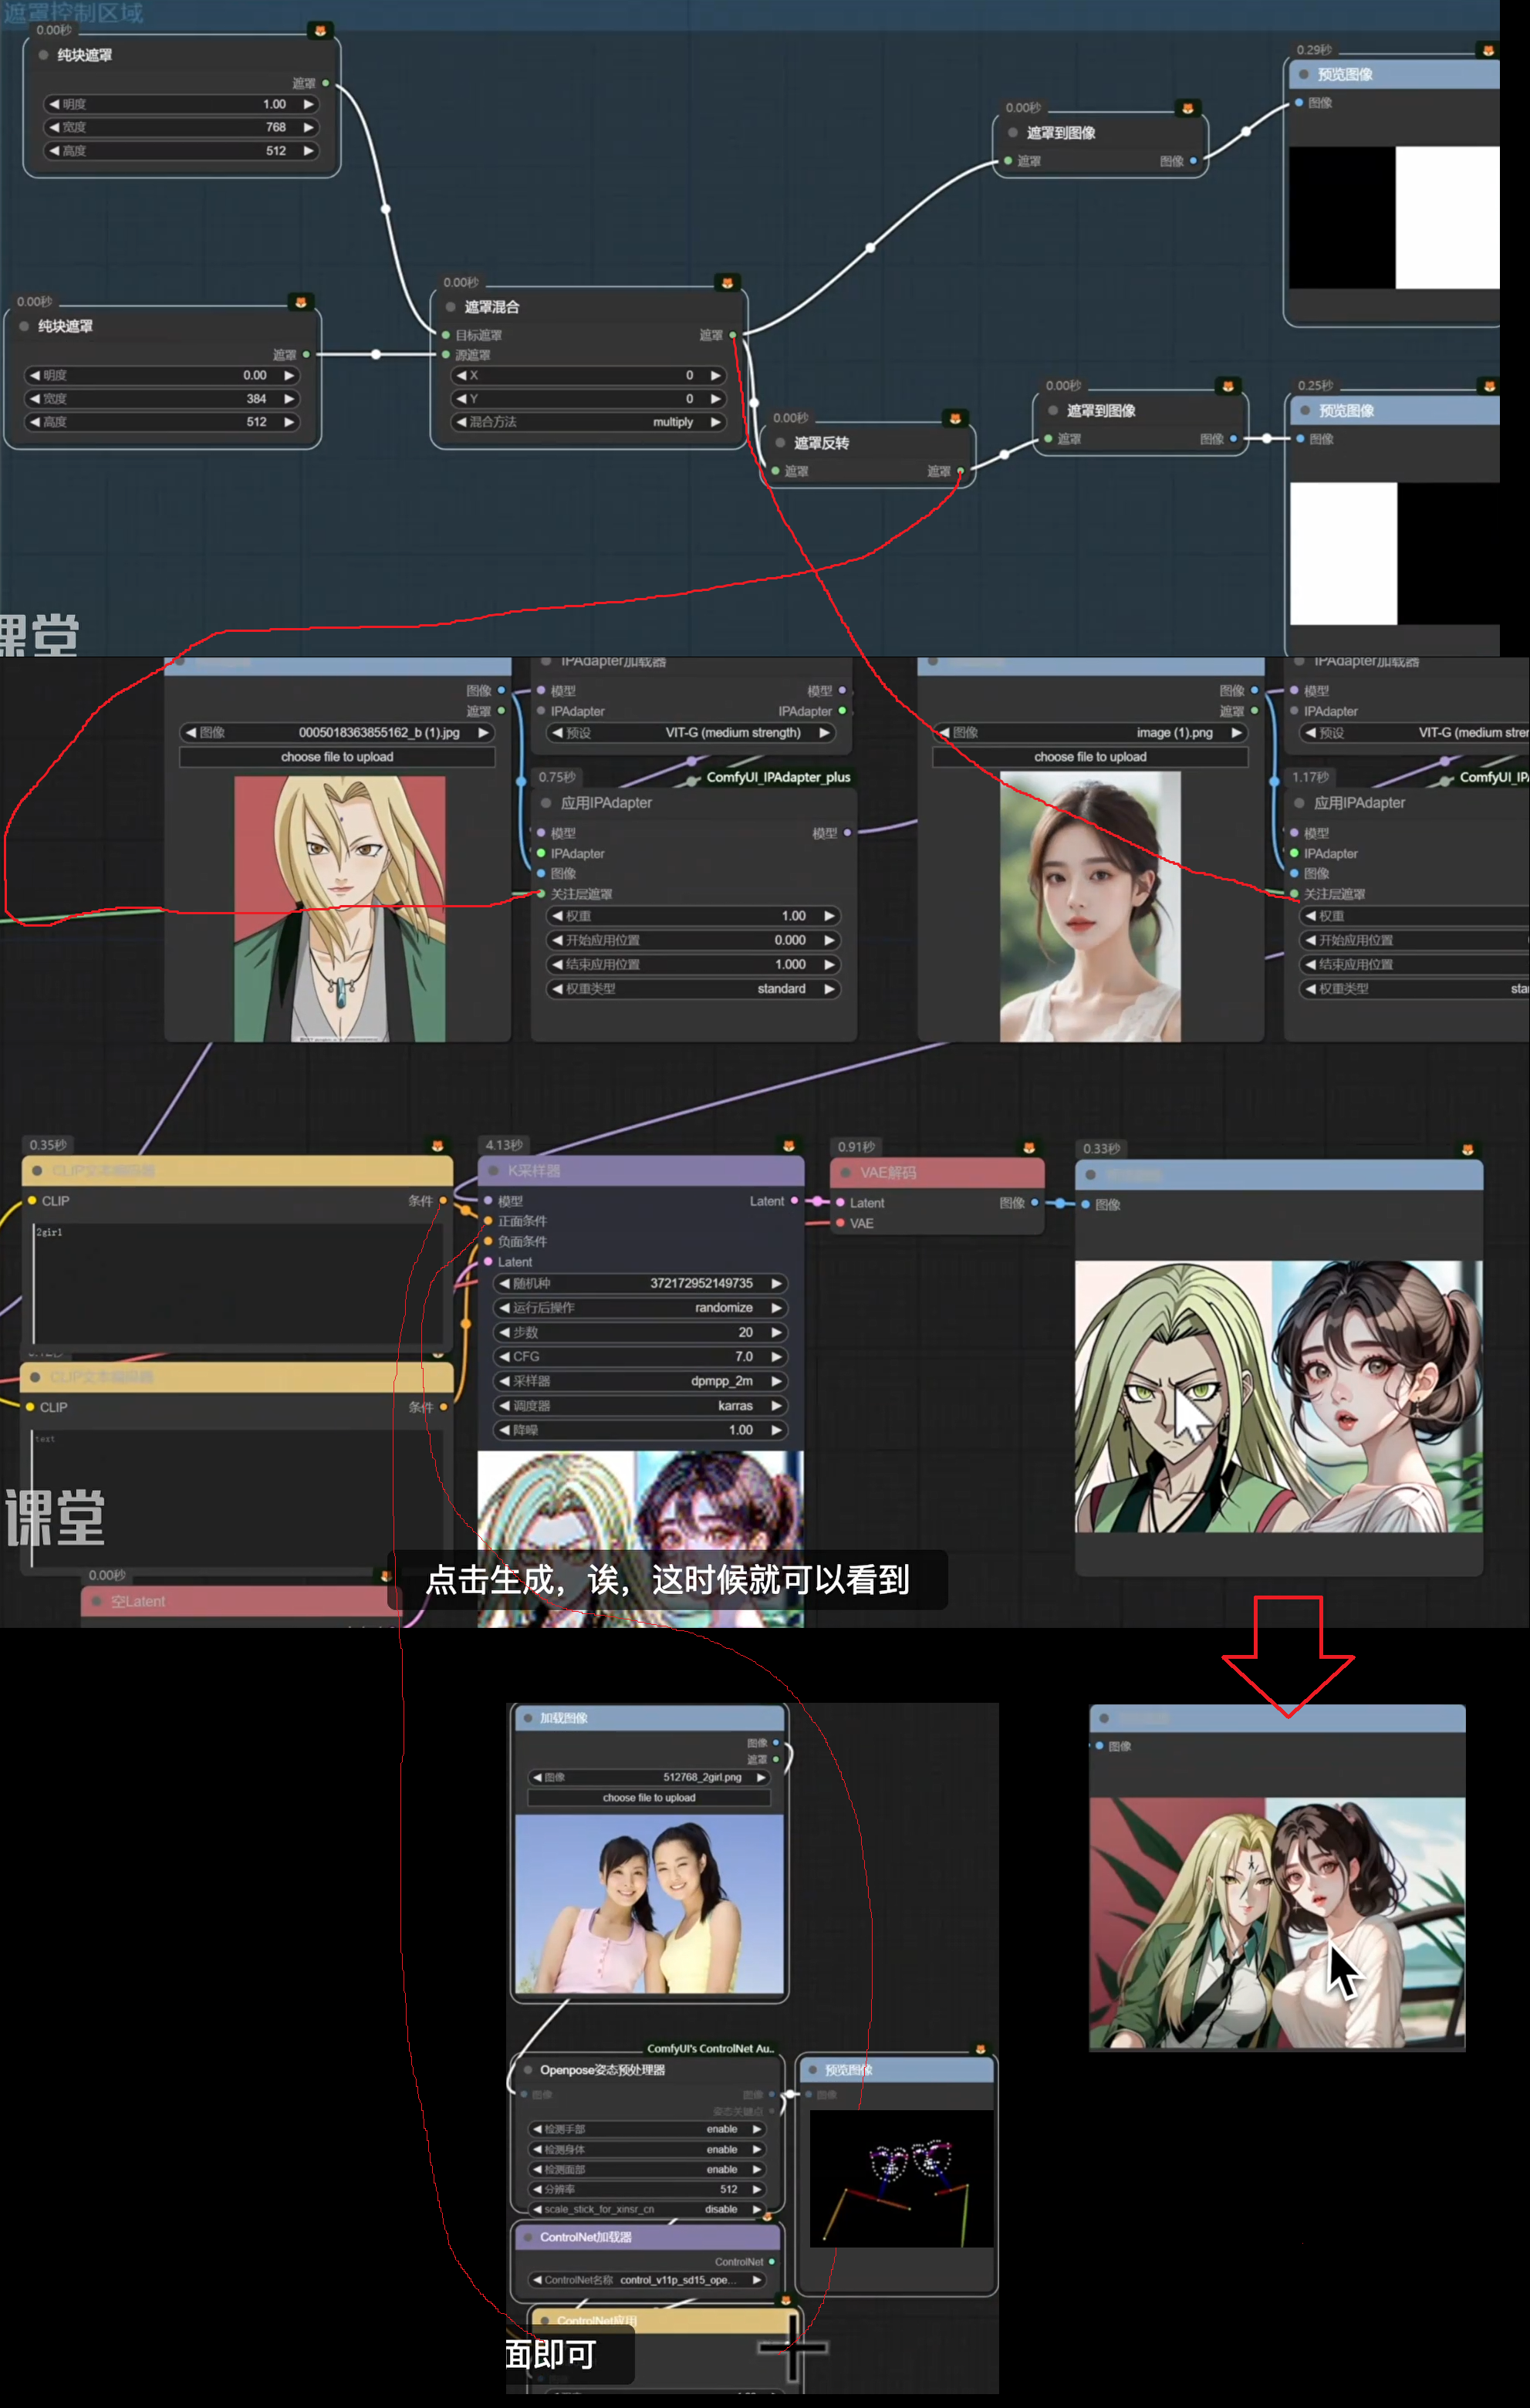
右键新建节点 → EasyUse → 模型适配器 → 有各种IPAdapter

高级一版本:

右键新建节点 → EasyUse → ipadapter → IPAdapter 创建一个Ipadapter应用

★ 初级 + 中级 + 高级 + 究极IPAdapter

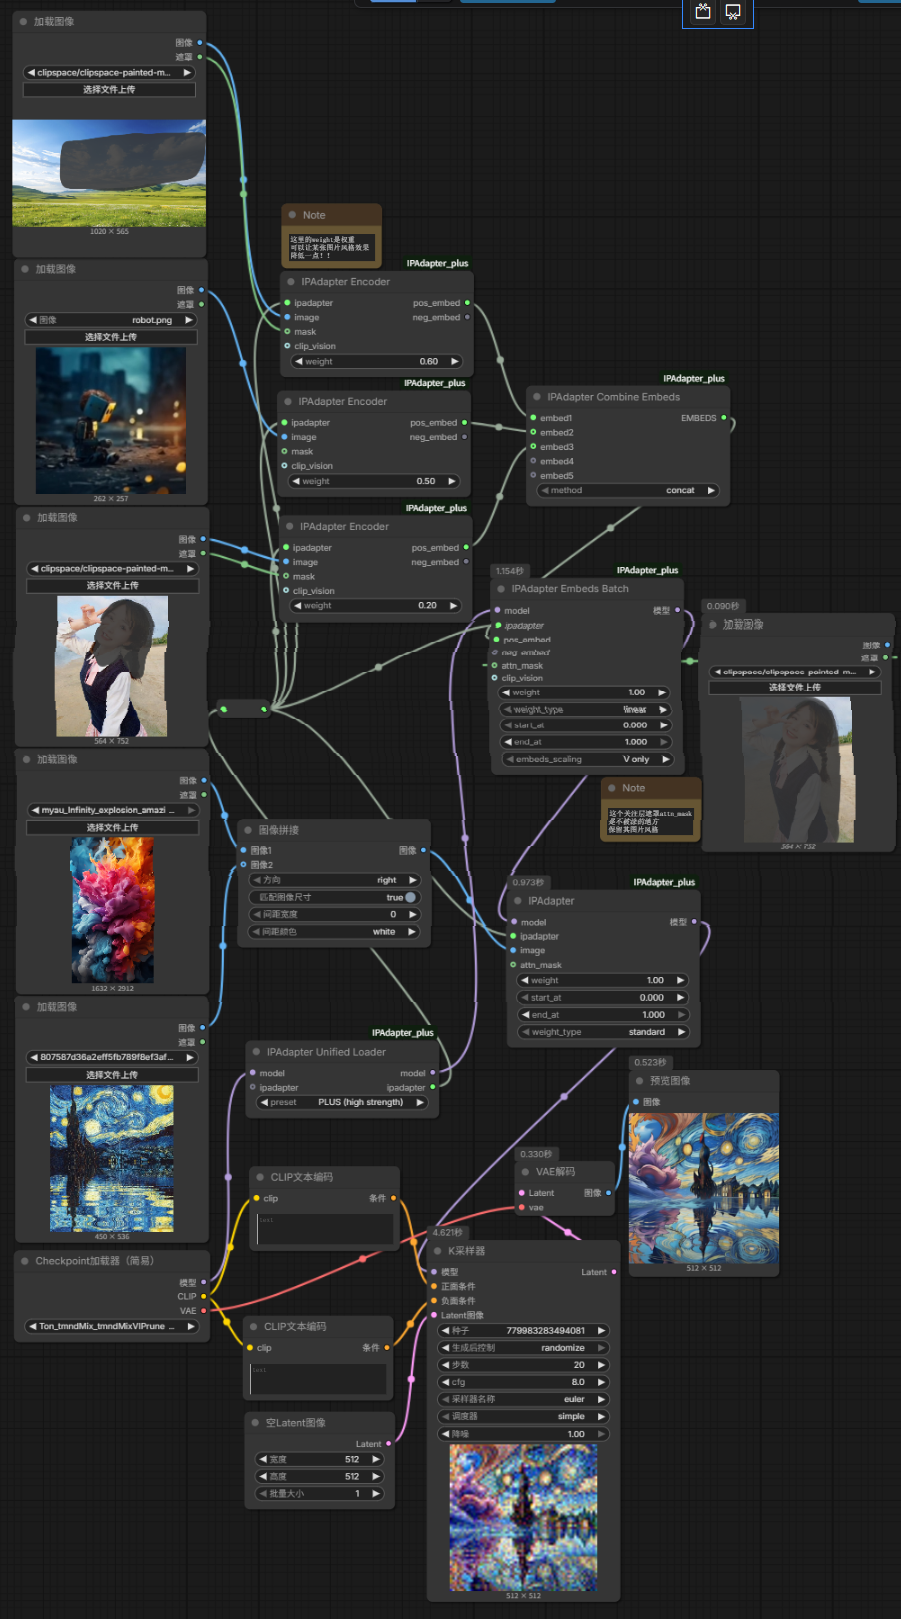
新版IPadapter组合批次与嵌入组

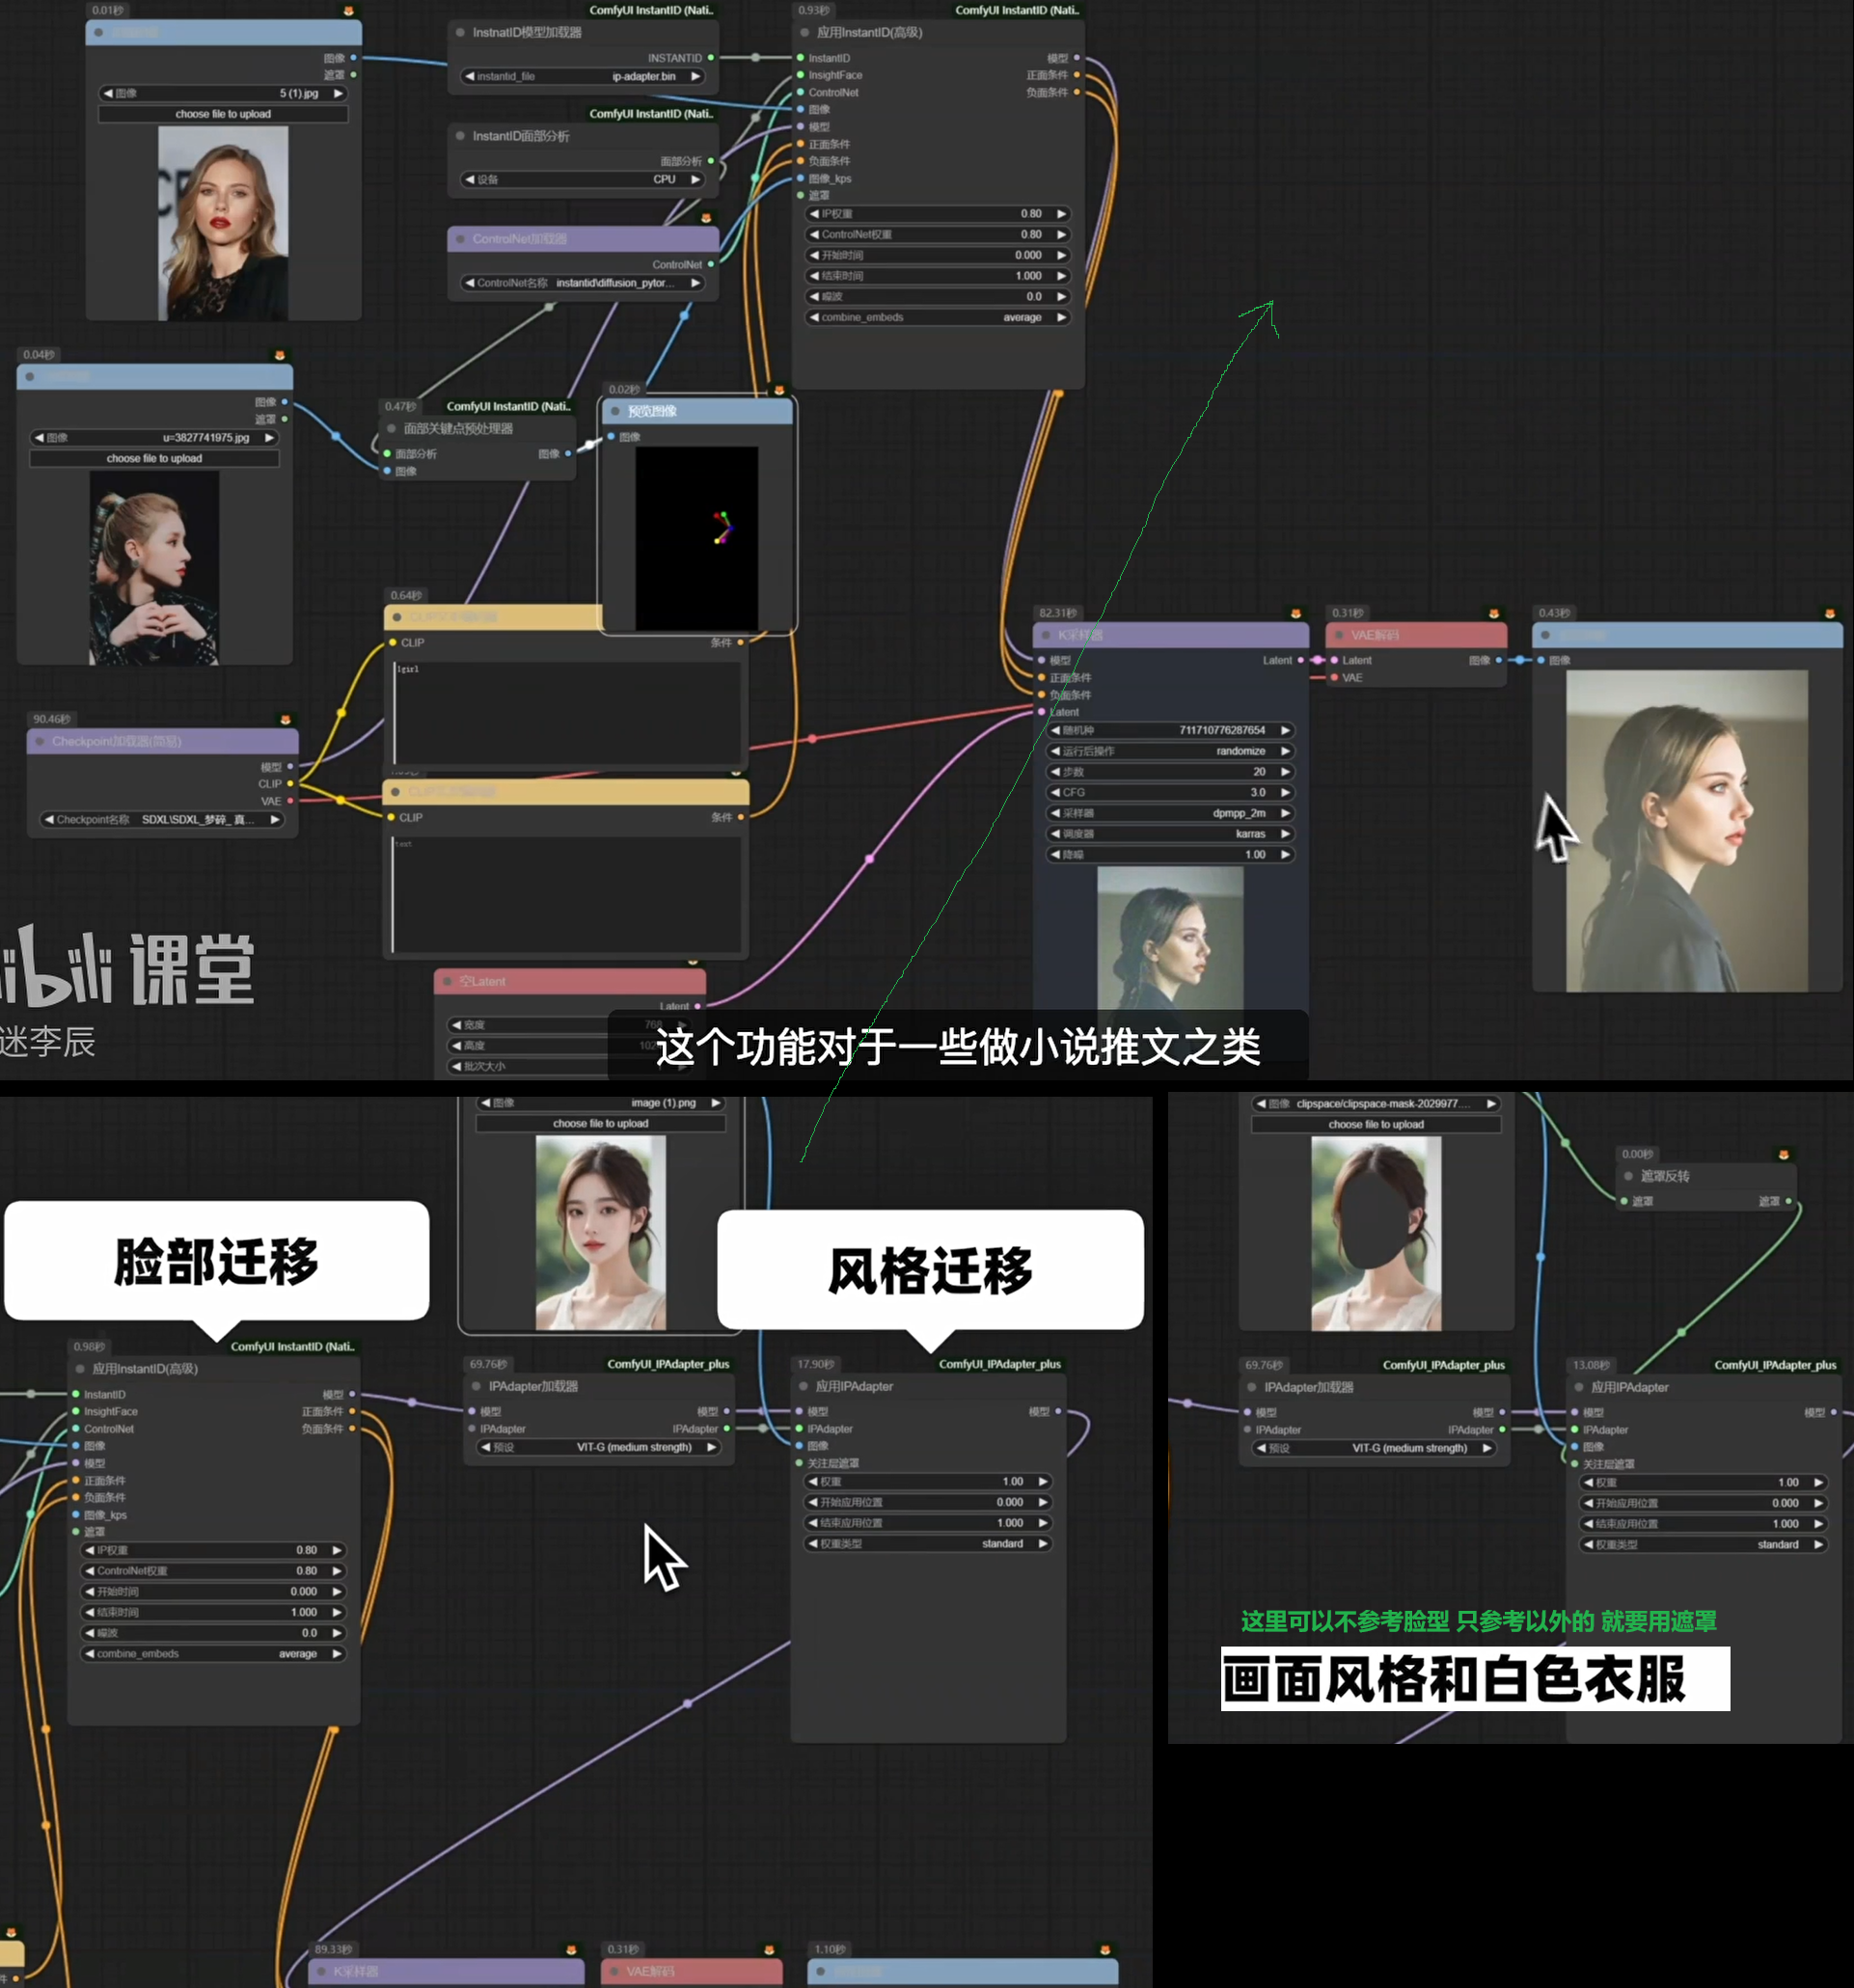
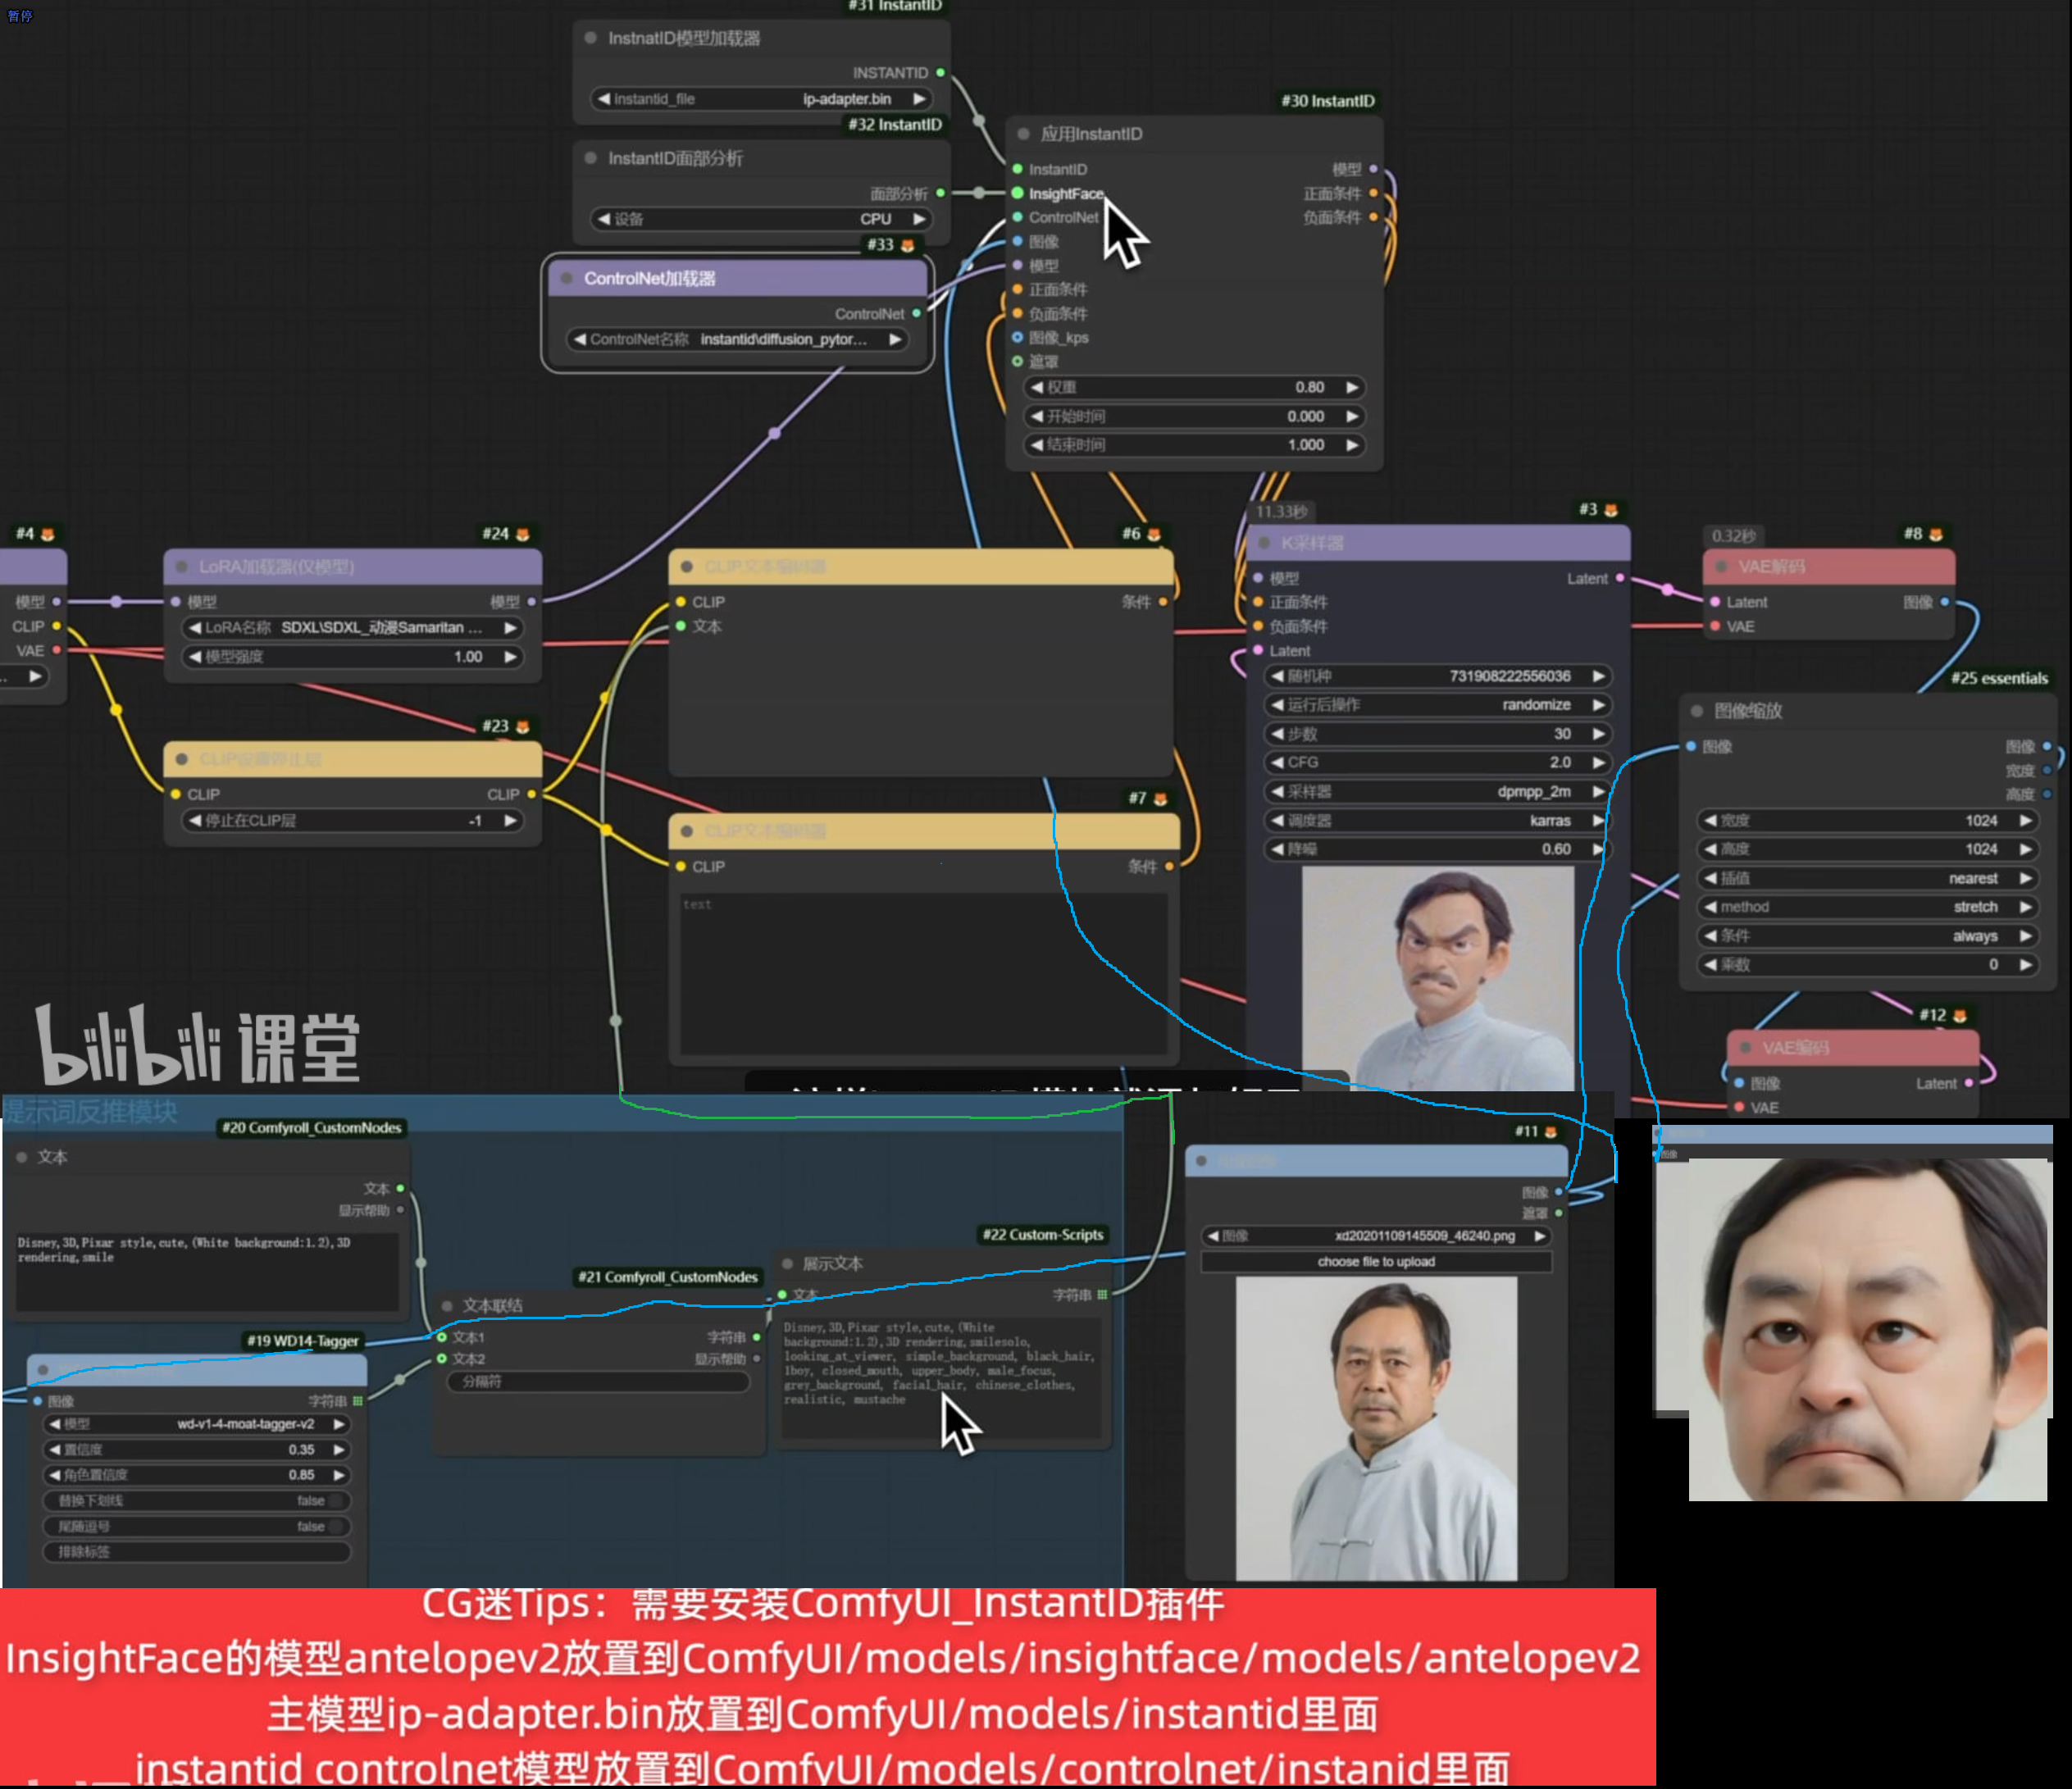
InstantID复刻人物样貌、姿势、角度

可以配合IPAdapter一起使用

专门对SDXL模型的

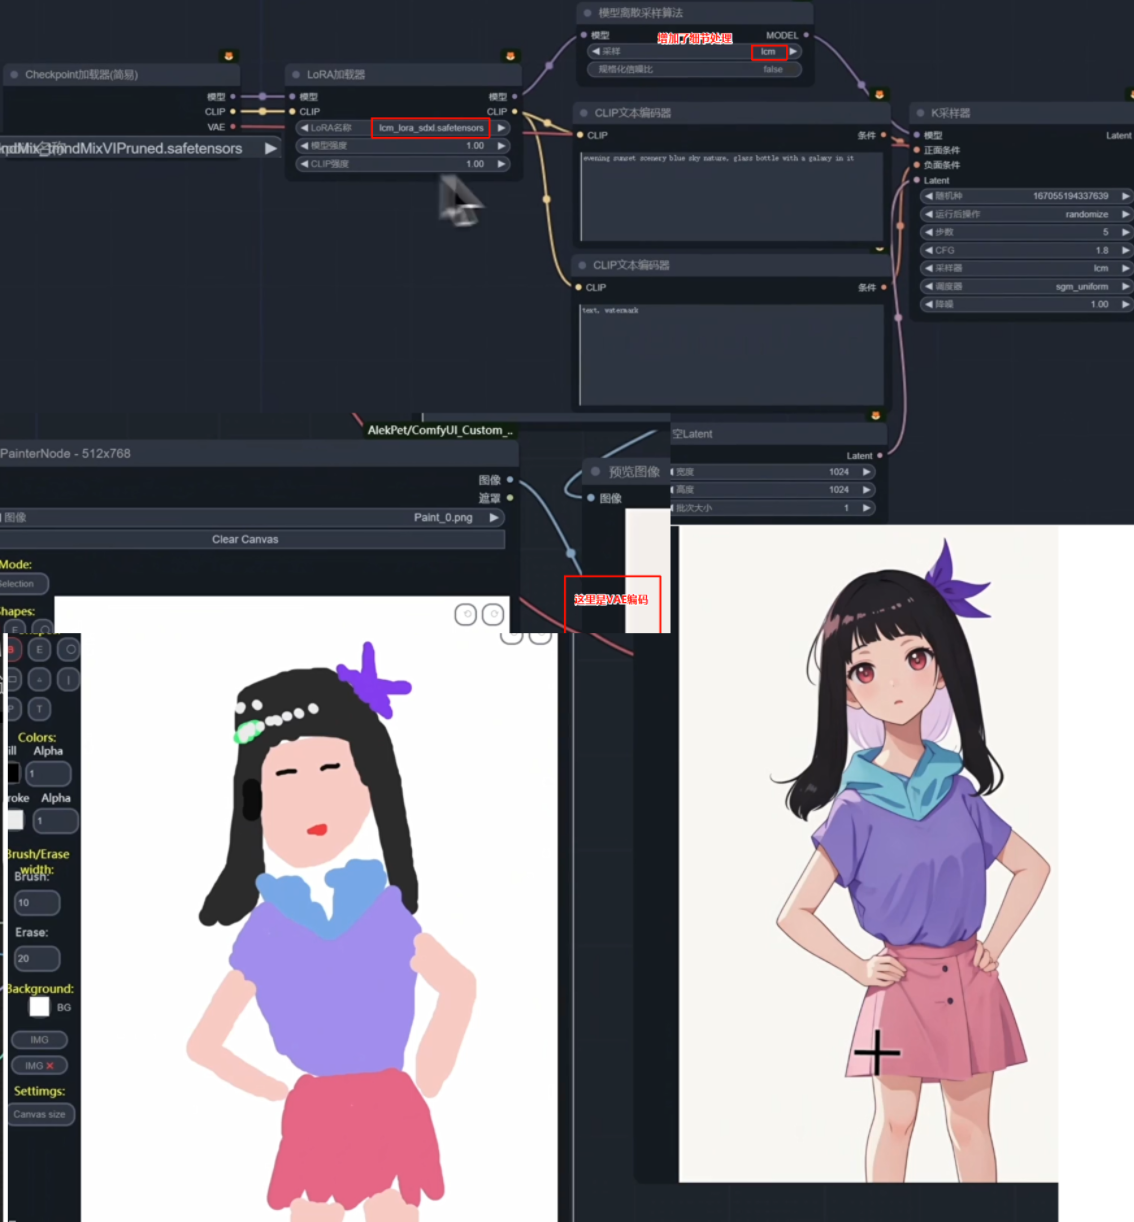
LCM lora与实时绘画

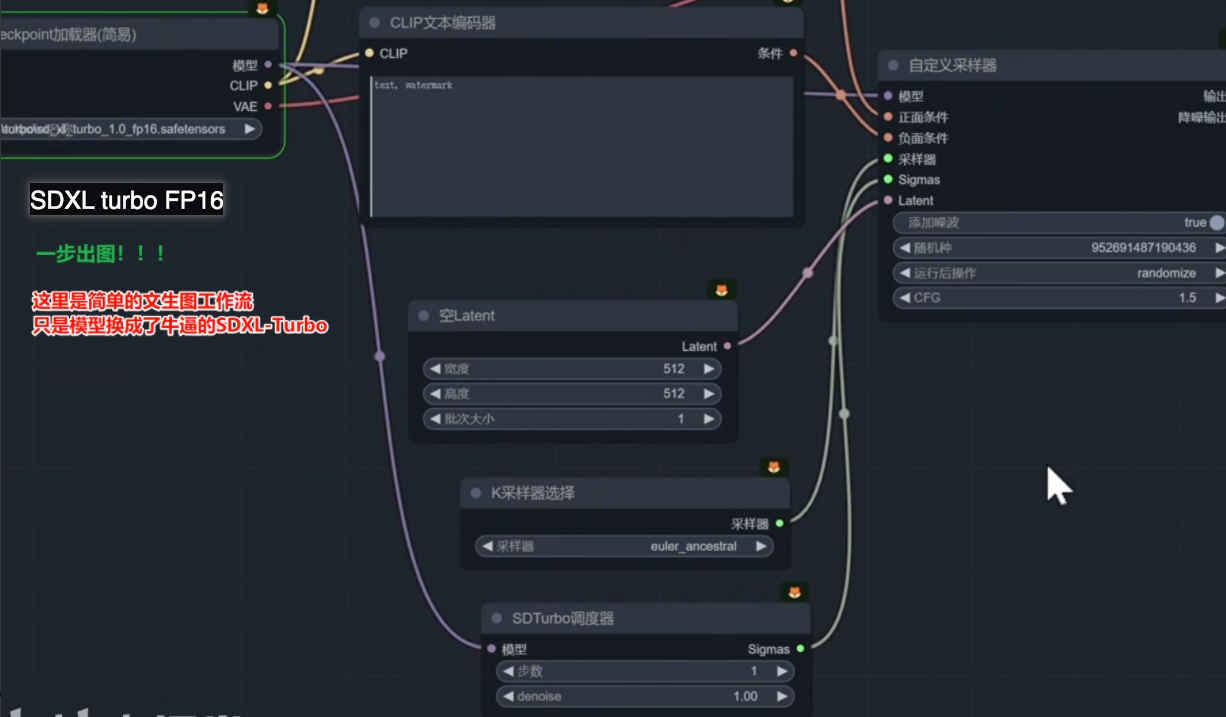
SDXL-Turbo出图速度测试

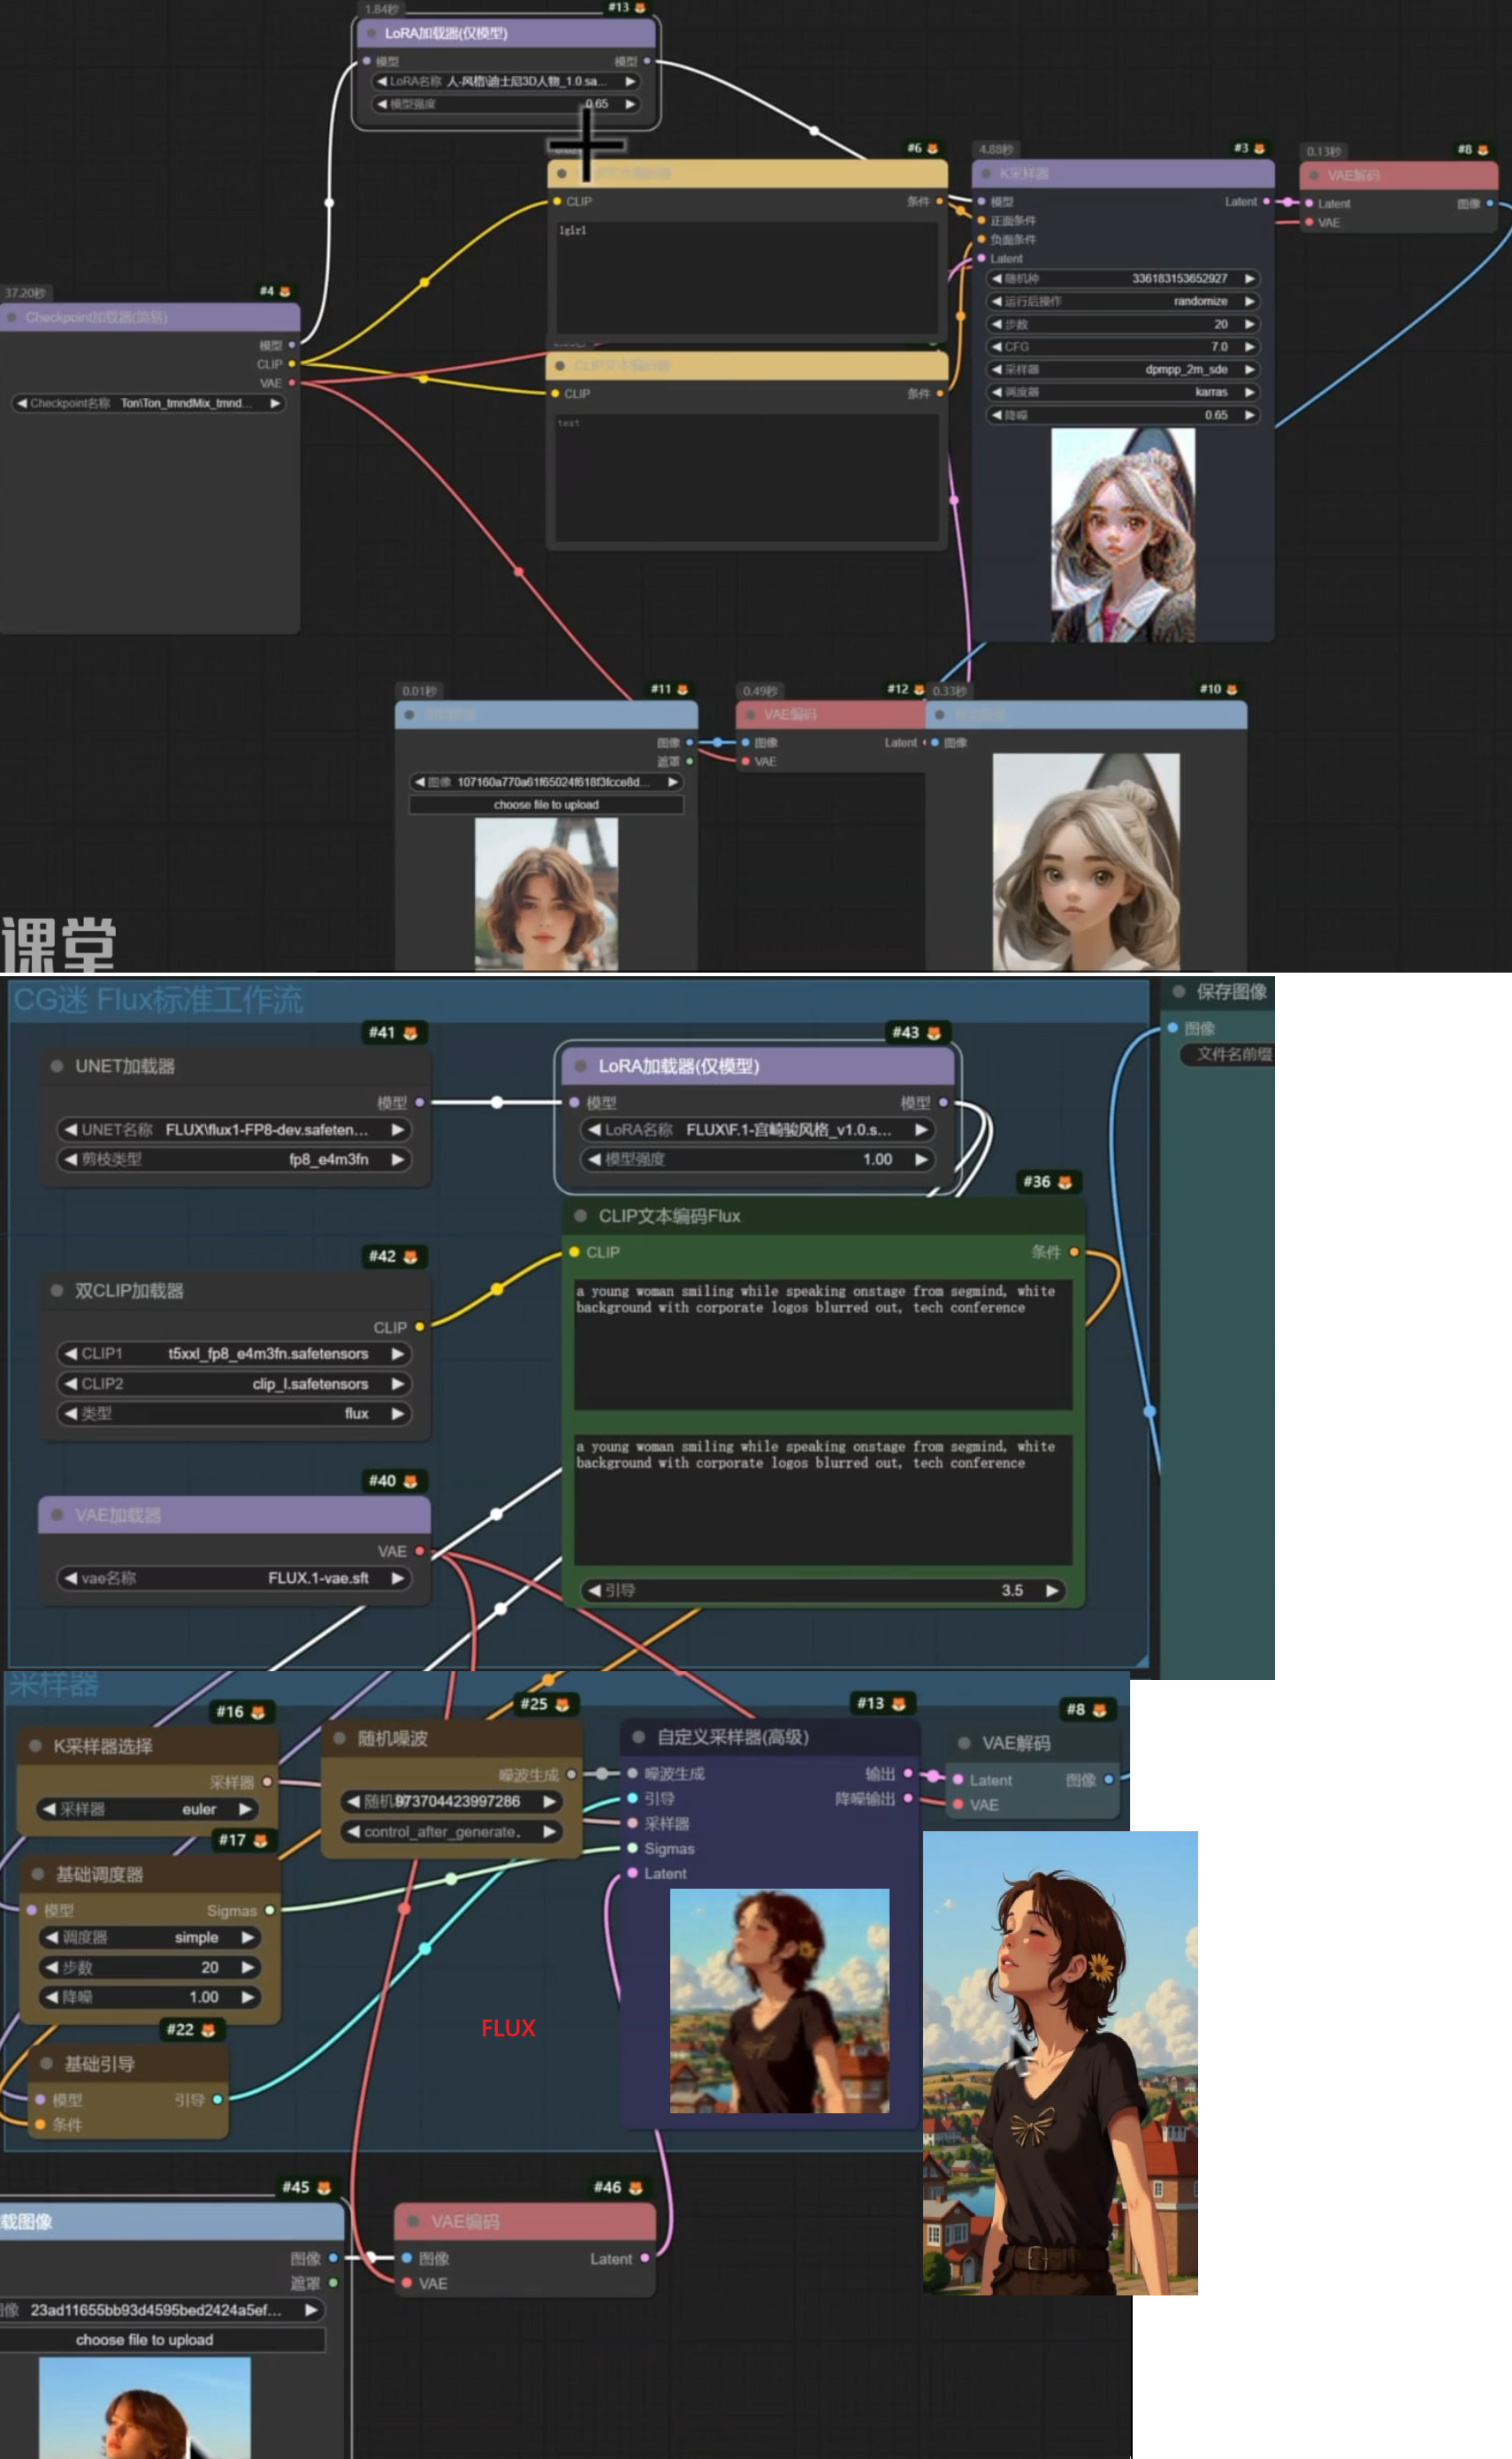
FLUX 七种模型 全方位讲解

FLUX模型优势
  • 画质极佳
  • 改进修手
  • 字体生成与排版
  • 训练参数大,风格多样
  • 分辨率弹性好
  • embeddings通用性好
  • 不需要输入负面提示词
FLUX 7类模型
  • PRO(仅API调用)
  • DEV FP16(至少4090显卡)
  • DEV FP8
  • schnell FP6
  • schnell FP8
  • GGUF需要安装插件
  • NF4需要安装插件

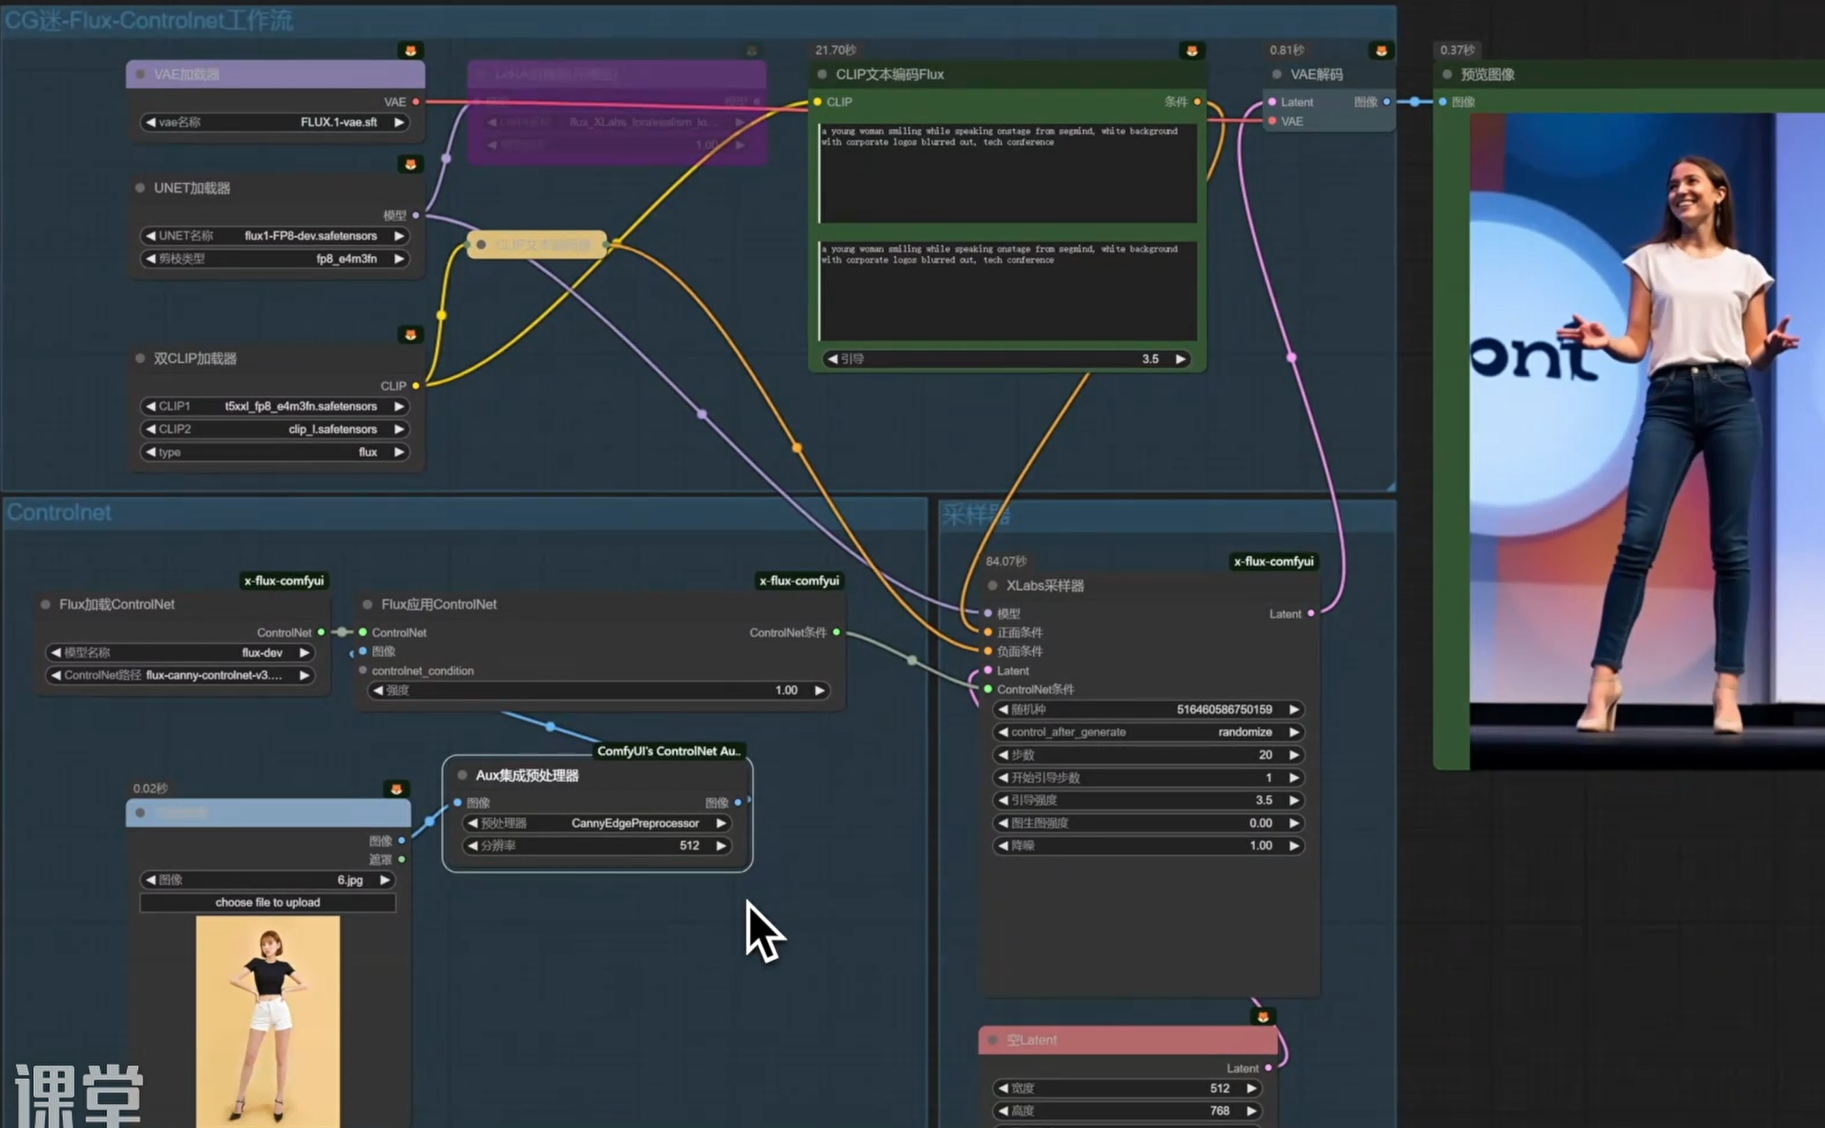
Flux全生态Controlnet工作流

controlnet union

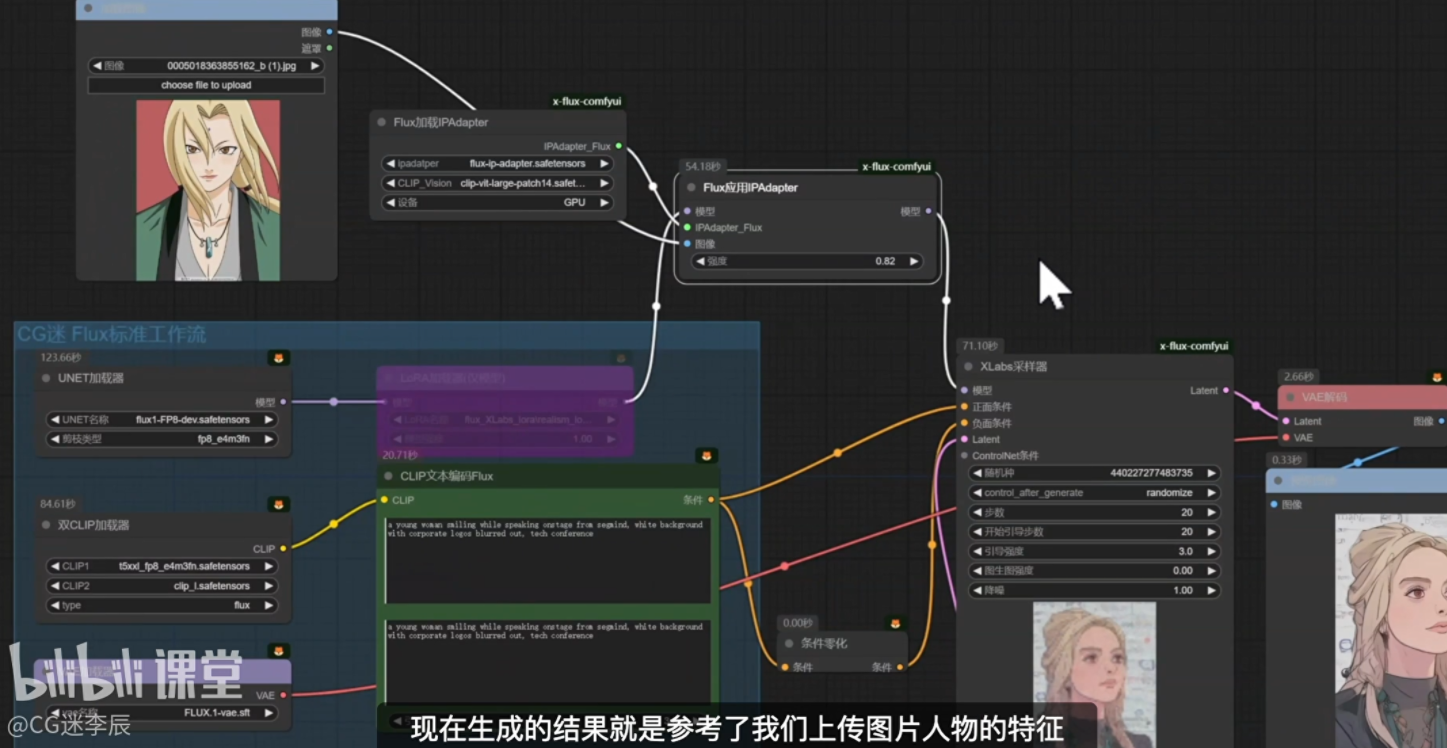
Flux模型IP-adapter工作流

FLUX工作流要使用ip-adapter的话需要安装专门的插件x-flux-comfyui
由于FLUX不需要负面提示词 可以用条件雾化去给它的负面提示词归零

Flux Tools 4款全新模型解析24G、4090也可能爆显存

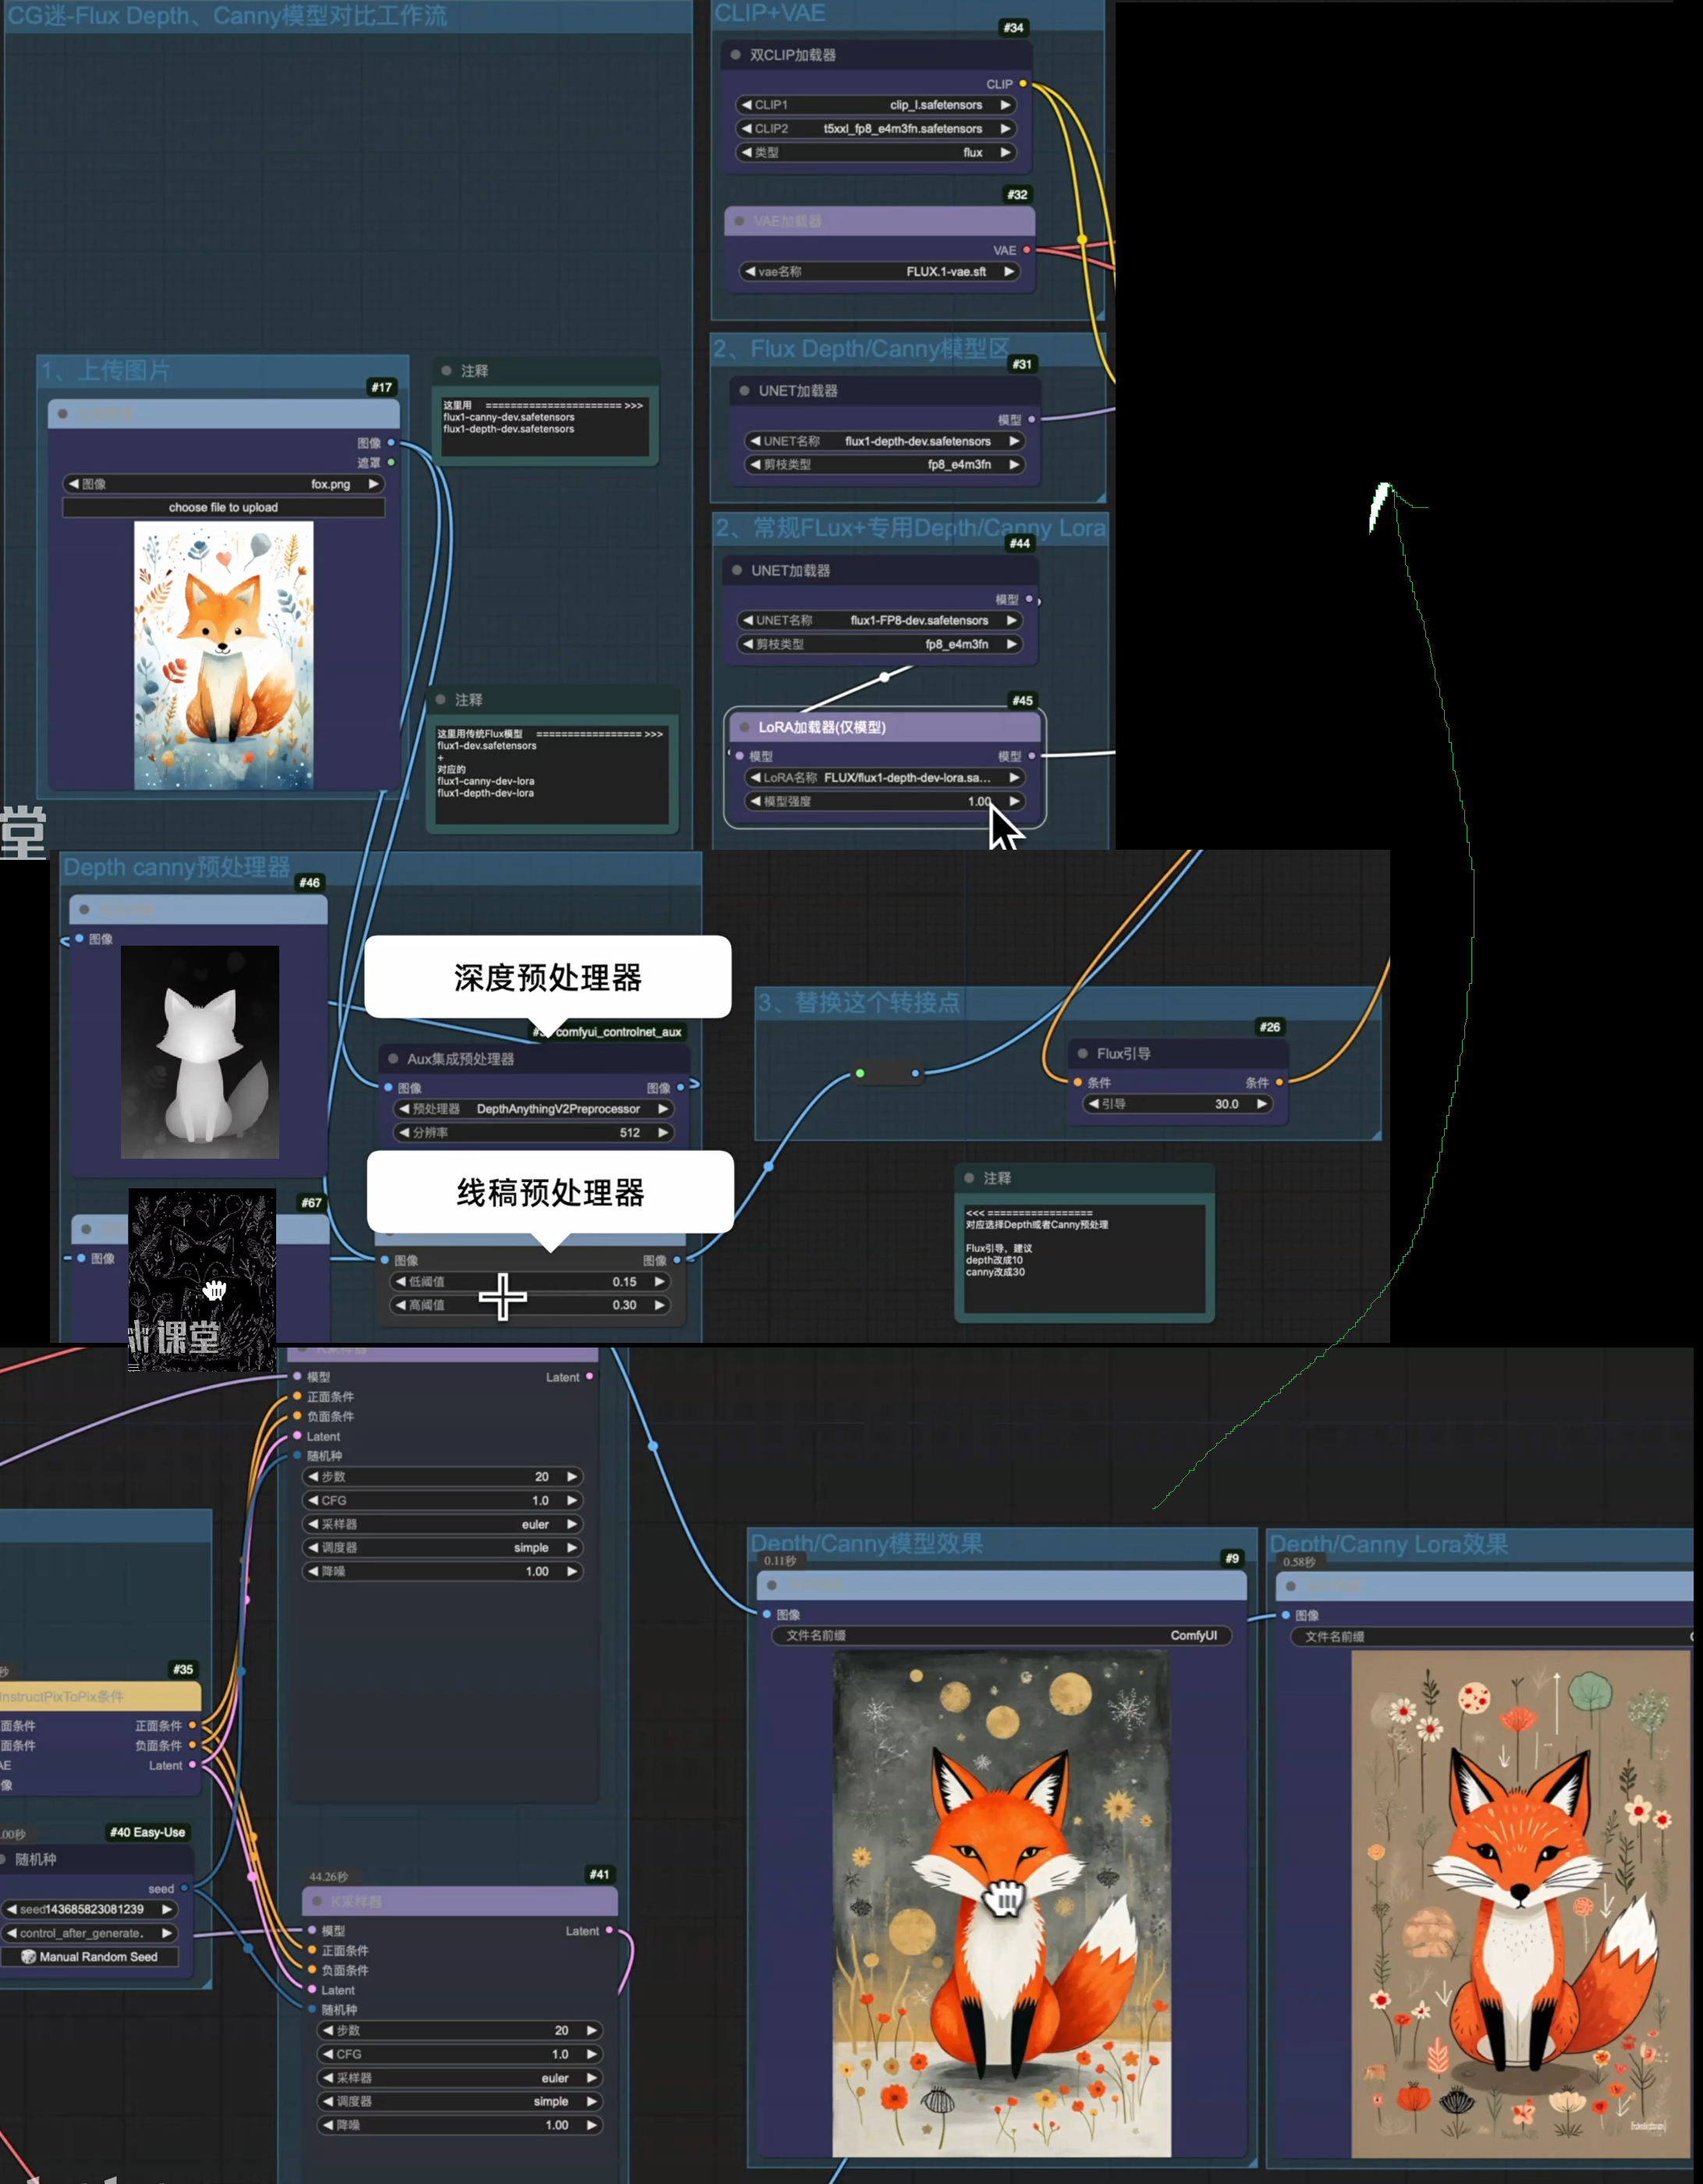
Canny
  • 大模型:flux1-canny-dev(内嵌线稿)
  • Lora:flux1-canny-Lora
Depth
  • 大模型:flux1-depth-dev(内嵌深度)
  • Lora:flux1-depth-Lora
Fill
  • 大模型:flux1-fill-dev (内嵌inpaint)
  • 局部重绘和扩展
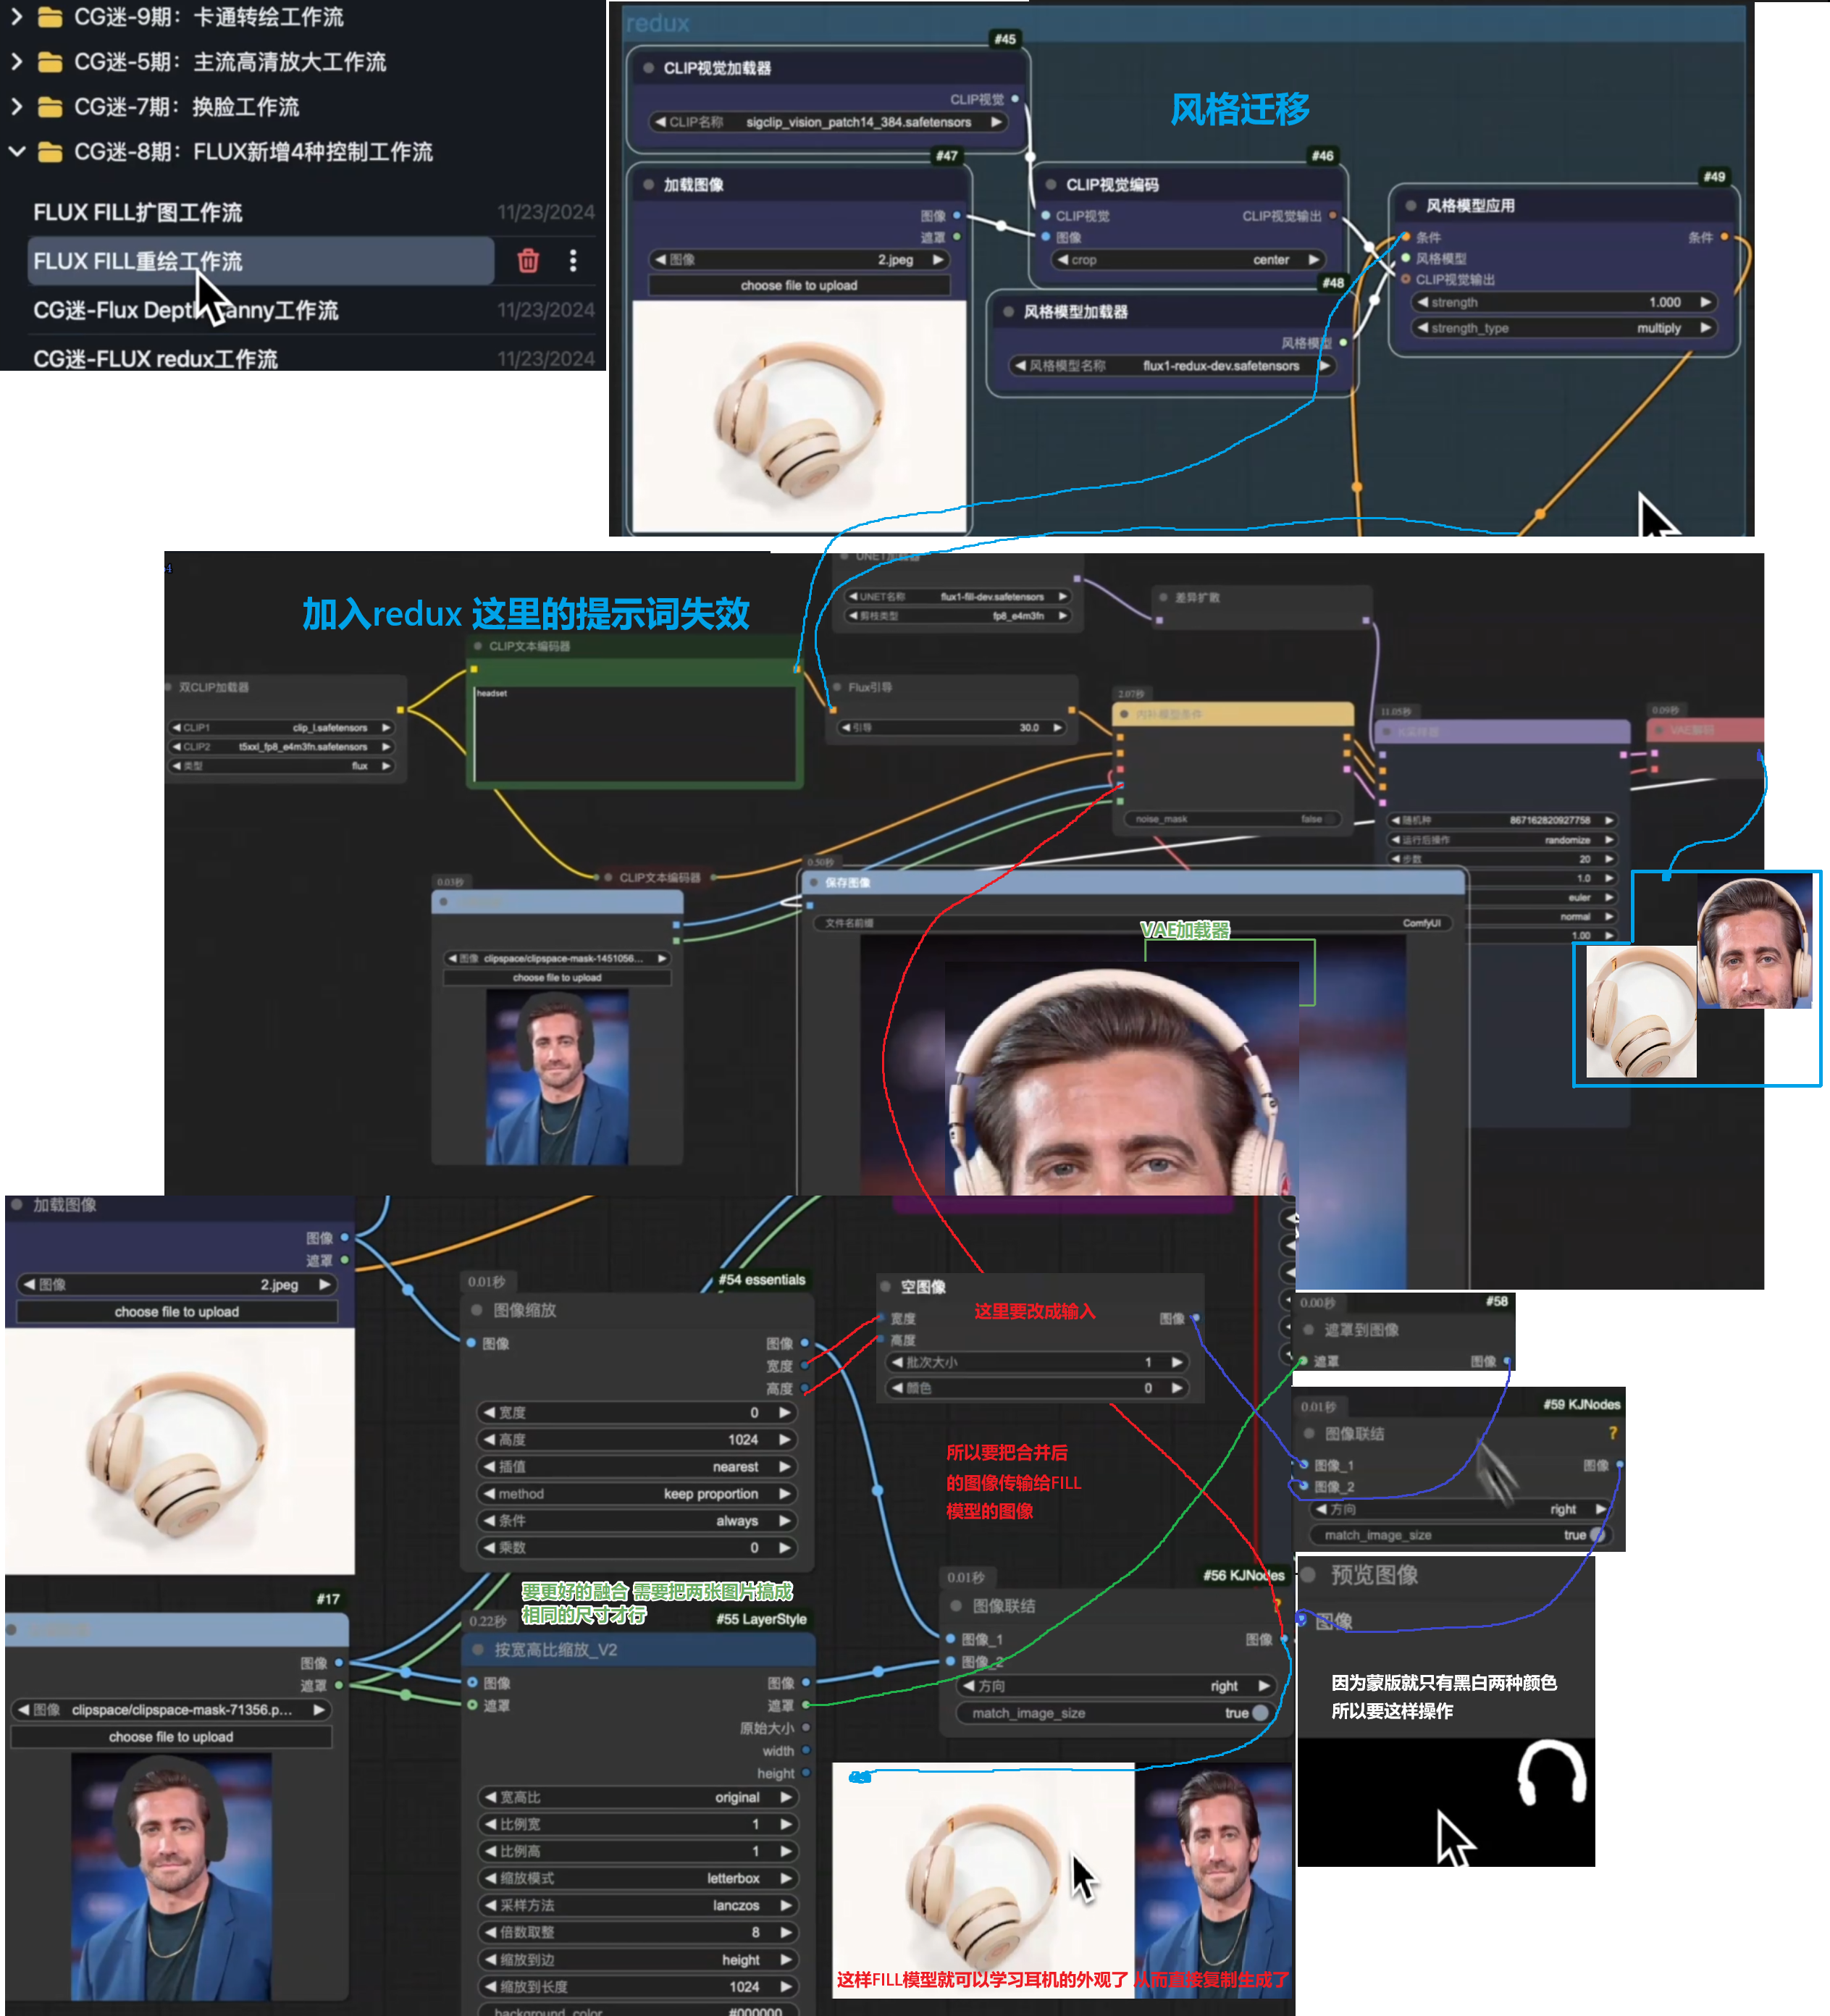
Redux
  • 风格模型:flux1-redux-dev
  • ip-adapter风格迁移作用

Flux Canny、Depth、Fill模型放置到:ComfyUI\models\diffusion_models\里面
Canny、Depth lora模型放置到:ComfyU\models\loras\里面
Redux模型放置到:ComfyUl\models\style_models\里面
sigclip_vision模型放置到:ComfyUl\models\clip_vision\里面

**CFG(Classifier-Free Guidance)**:主要是控制提示词的听话程度;CFG数值越低,AI就越多自己的想法

FLUX Tools Canny和Depth

FLUX Tools Redux风格迁移与工作流优化 这个在Flux Tools 4款全新模型教程里有,将两个图片的风格场景融合到一起

训练Flux 超高效Flux Gym

  • ComfyUI进行打标工作流 可对图片素材进行打标,打标完毕后再导入Flux训练工作流

  • Kohya-ss训练脚本

  • 秋叶训练器

  • FluxGym需要代码从GitHub下载;需要先下载pinokio客户端

可以用智灵SPIRIT可以租显卡
一键裁剪素材birme.ne

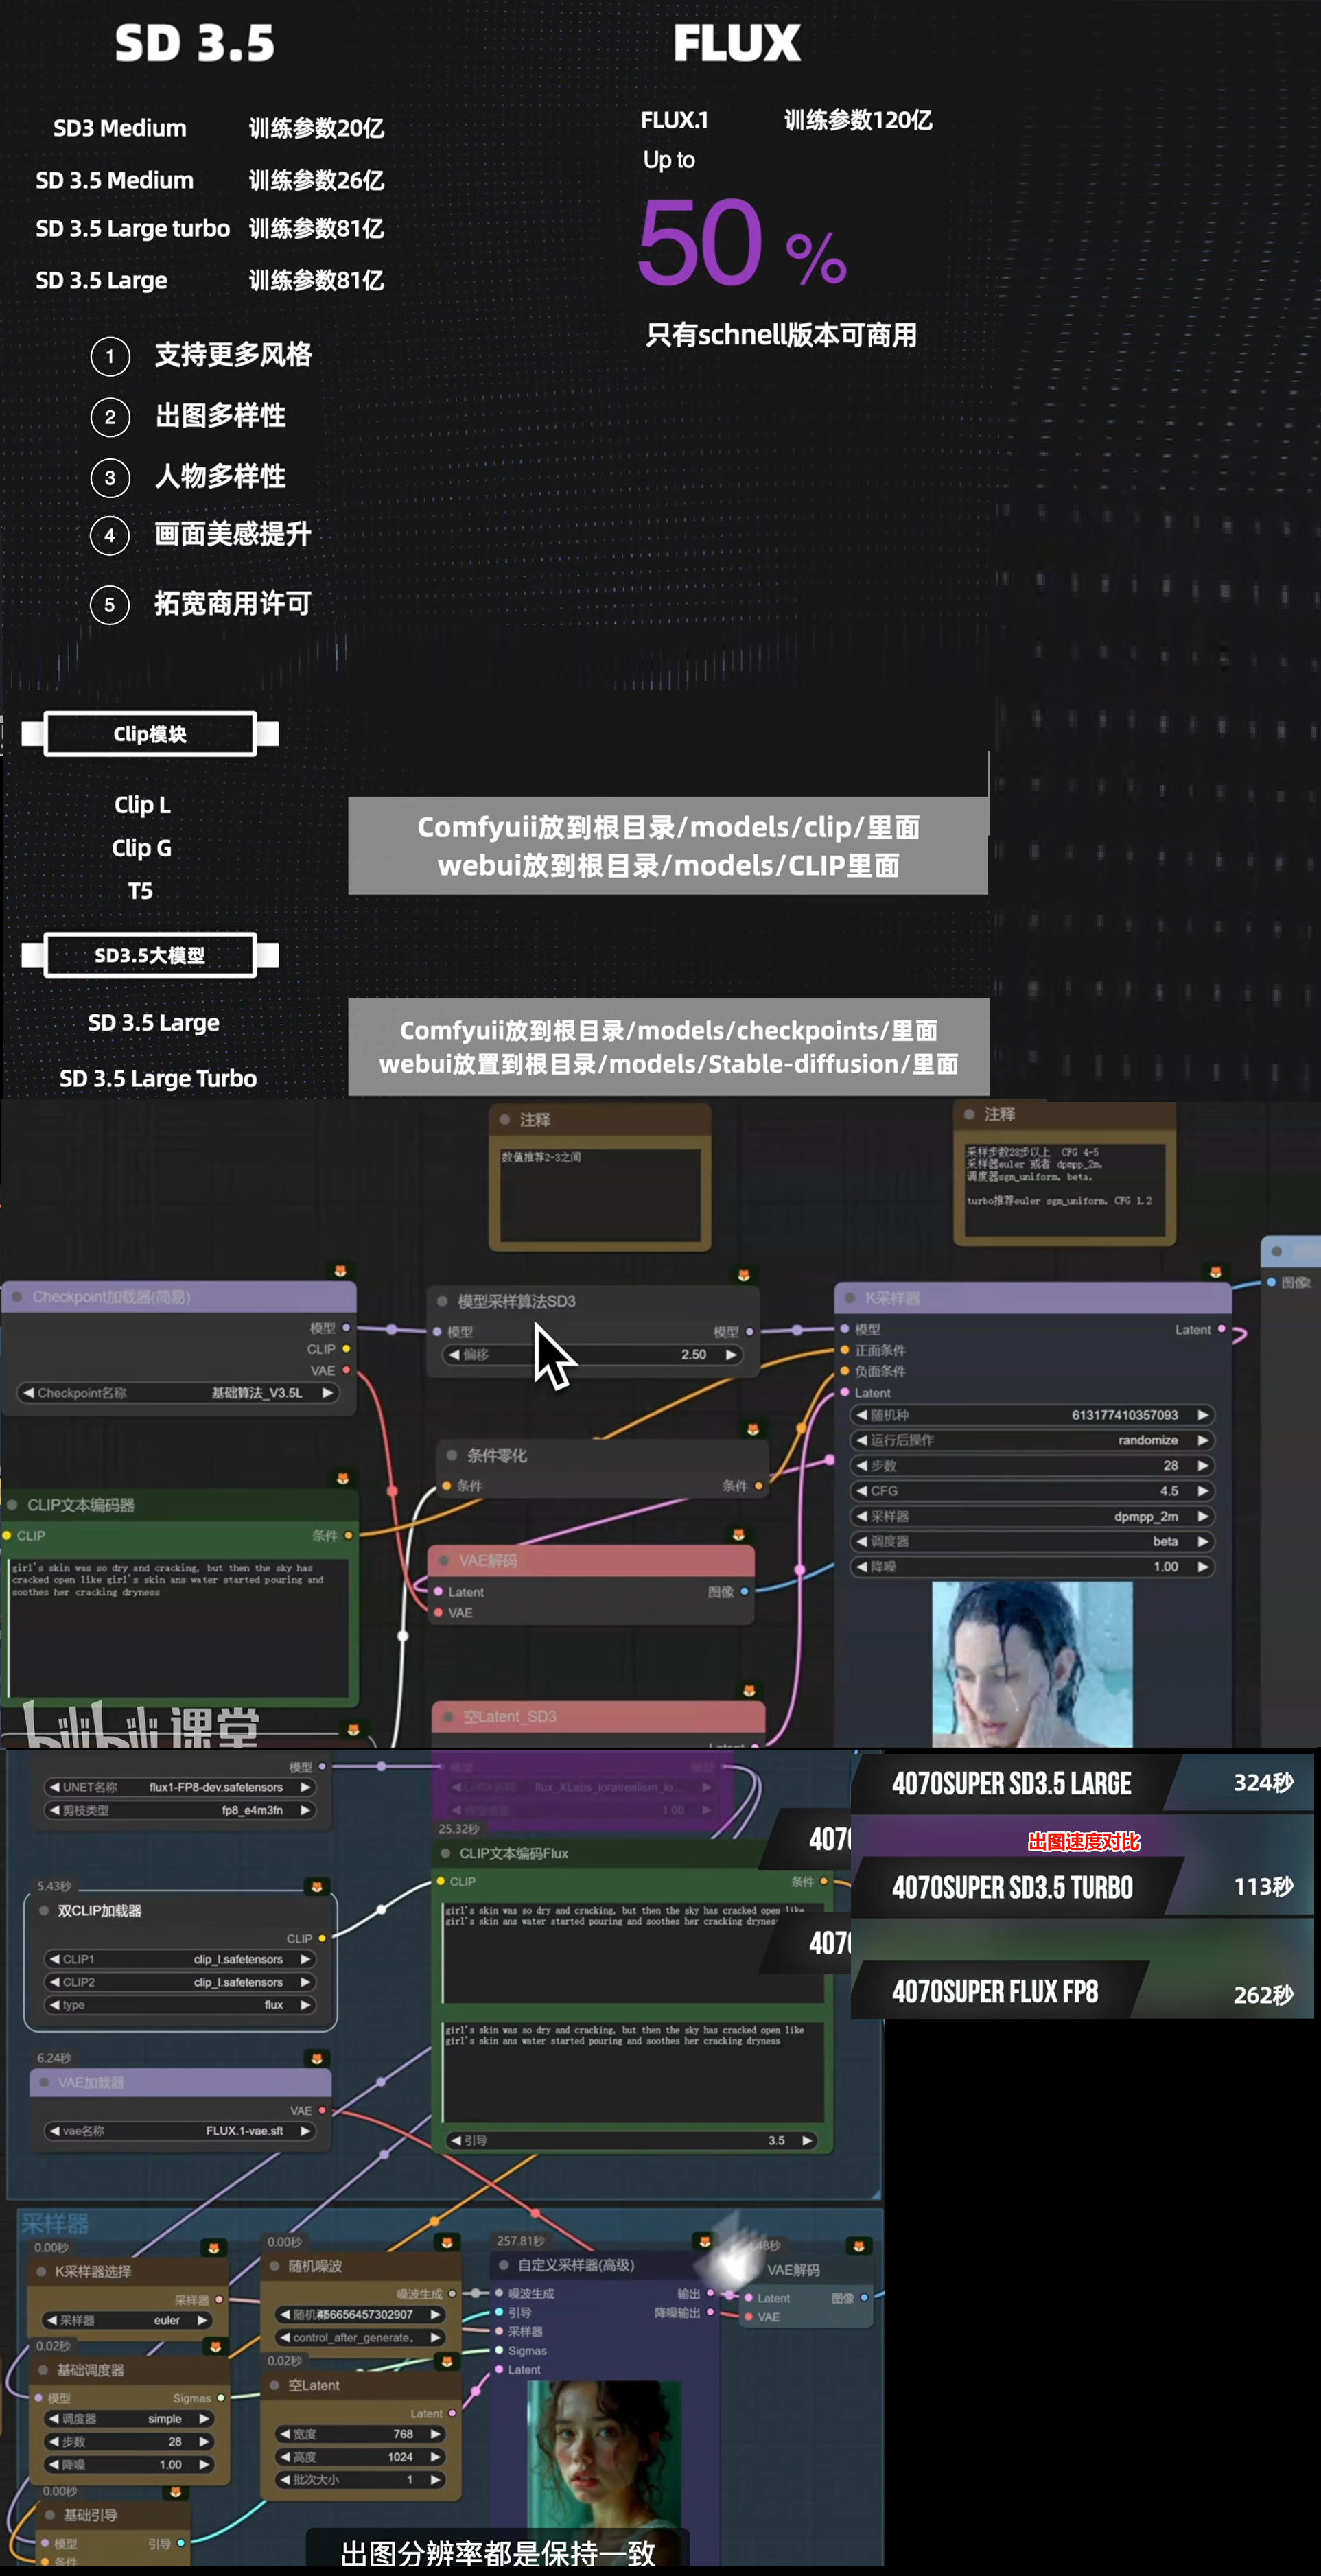
SD3.5与FLUX出图效果

alibaba—FLUX.1-Turbo

要去这里alimama-creative/FLUX.1-Turbo-Alpha
下载模型:alimama-creative/FLUX.1-Turbo-Alpha
放置到ComfyUi\models\loras里面

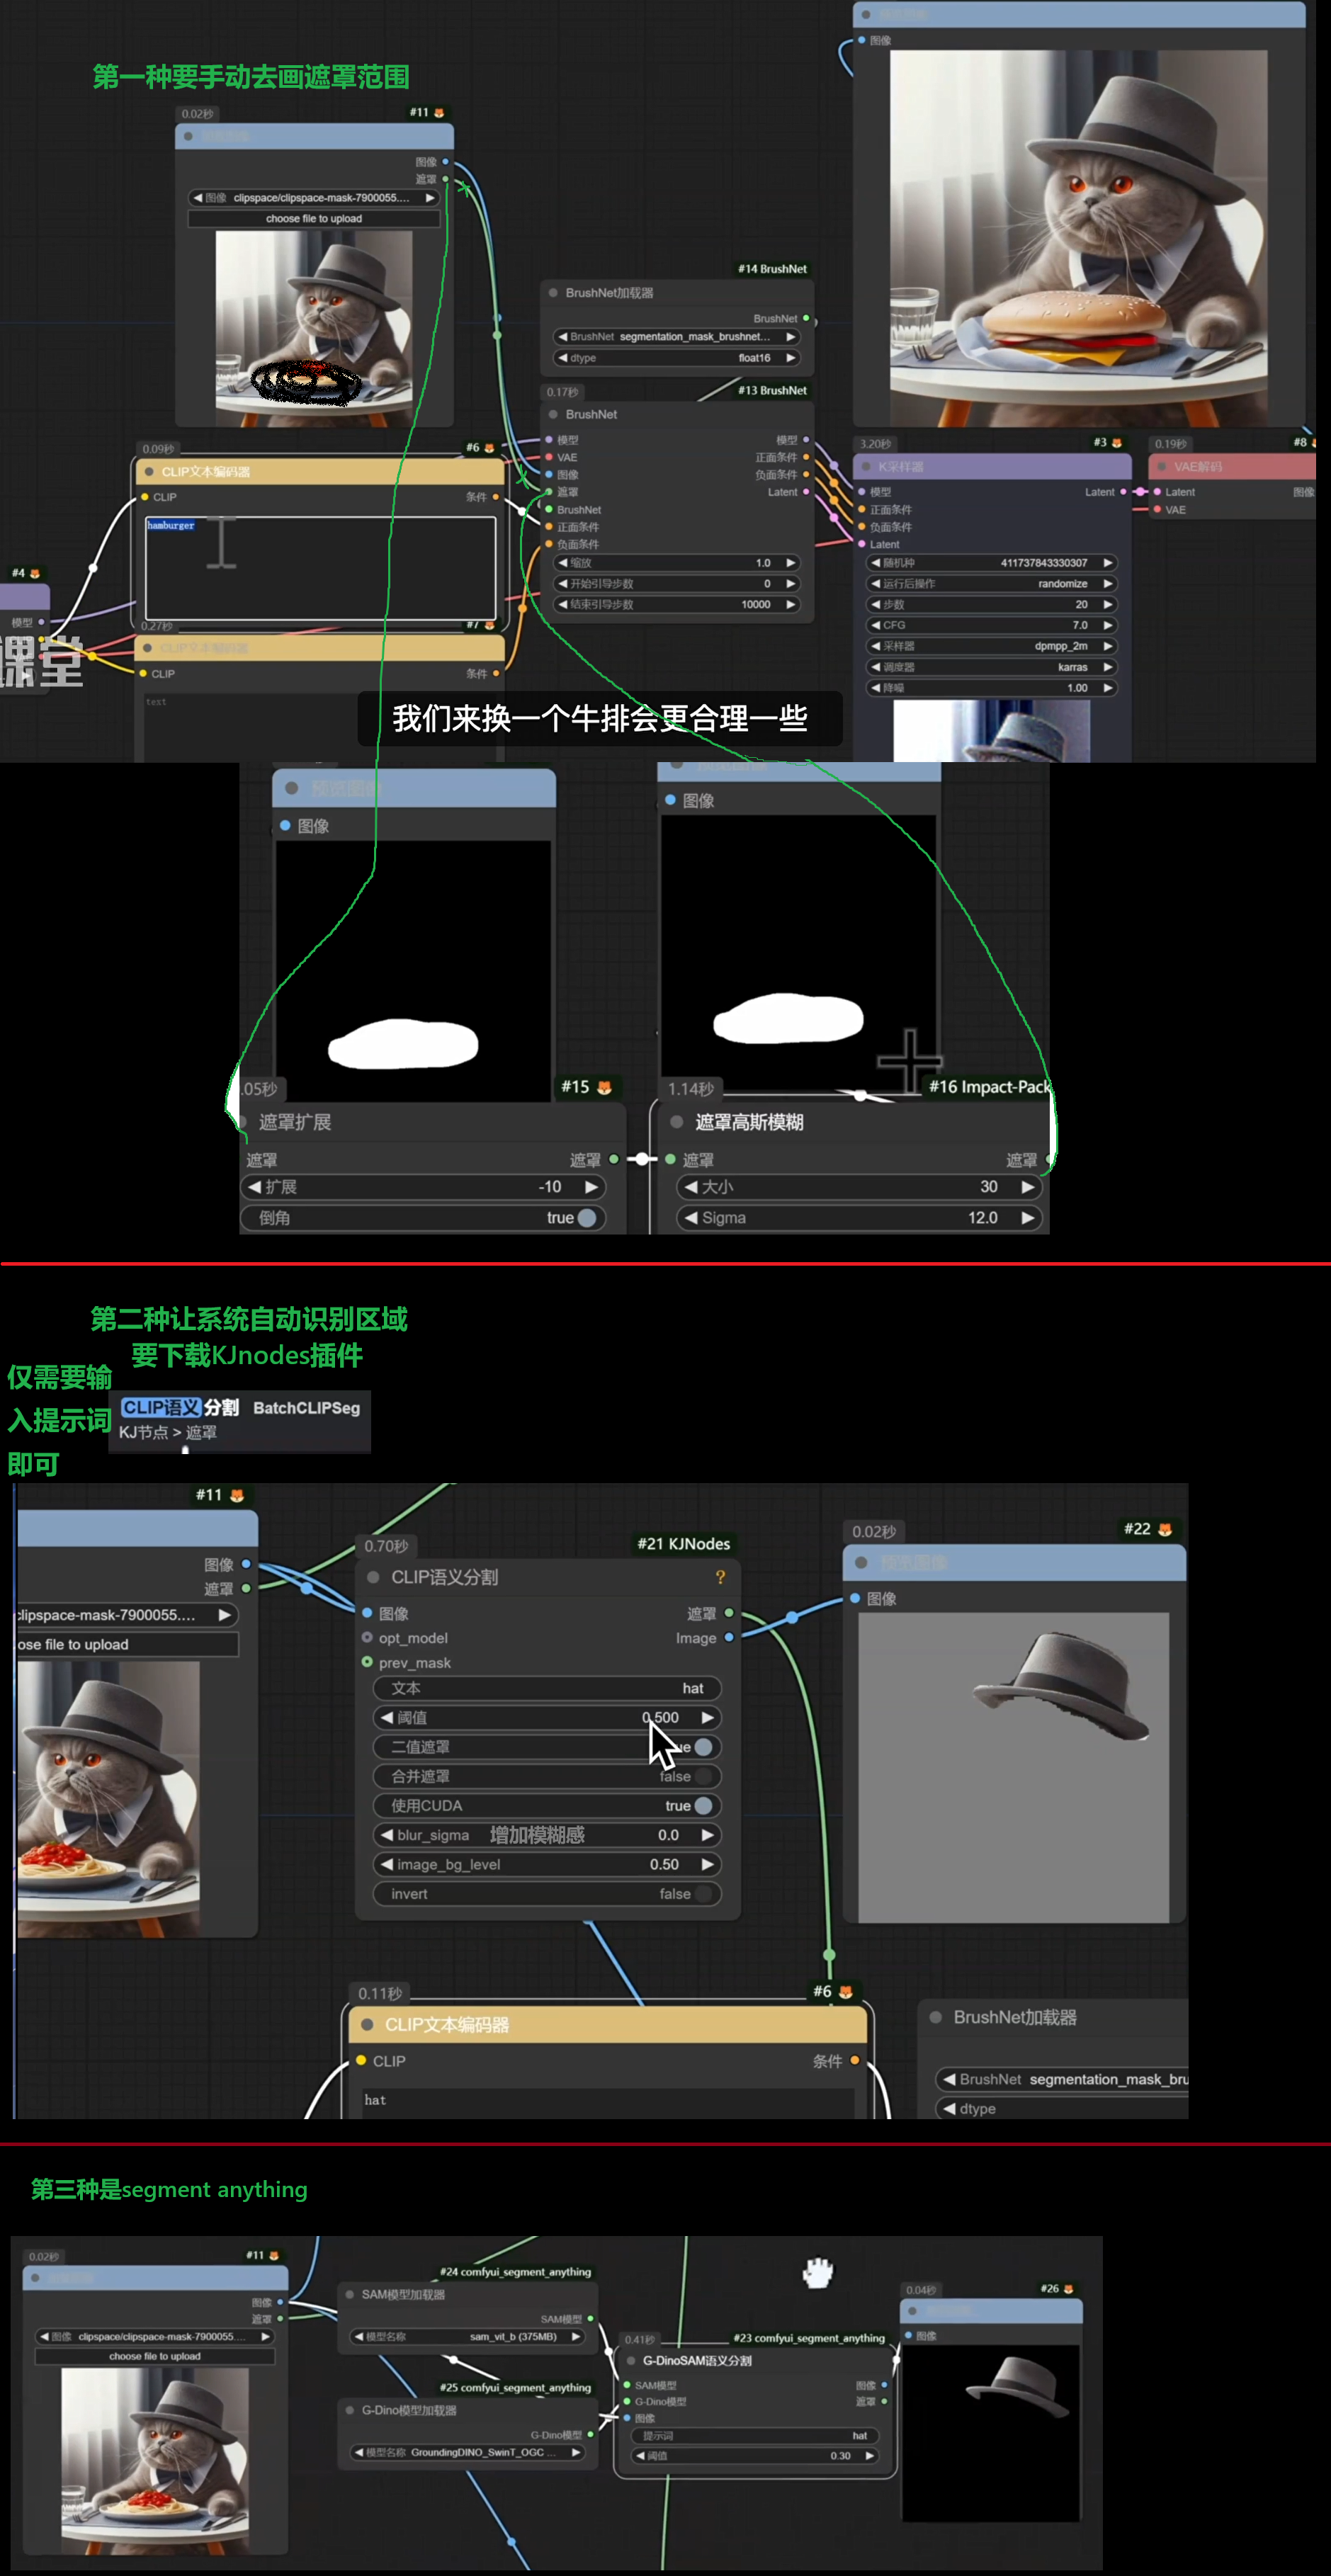
指定遮罩区域控制画面内容生成

区域采样器 指定画面局部内容生成

ComfyUI Impact Pack插件

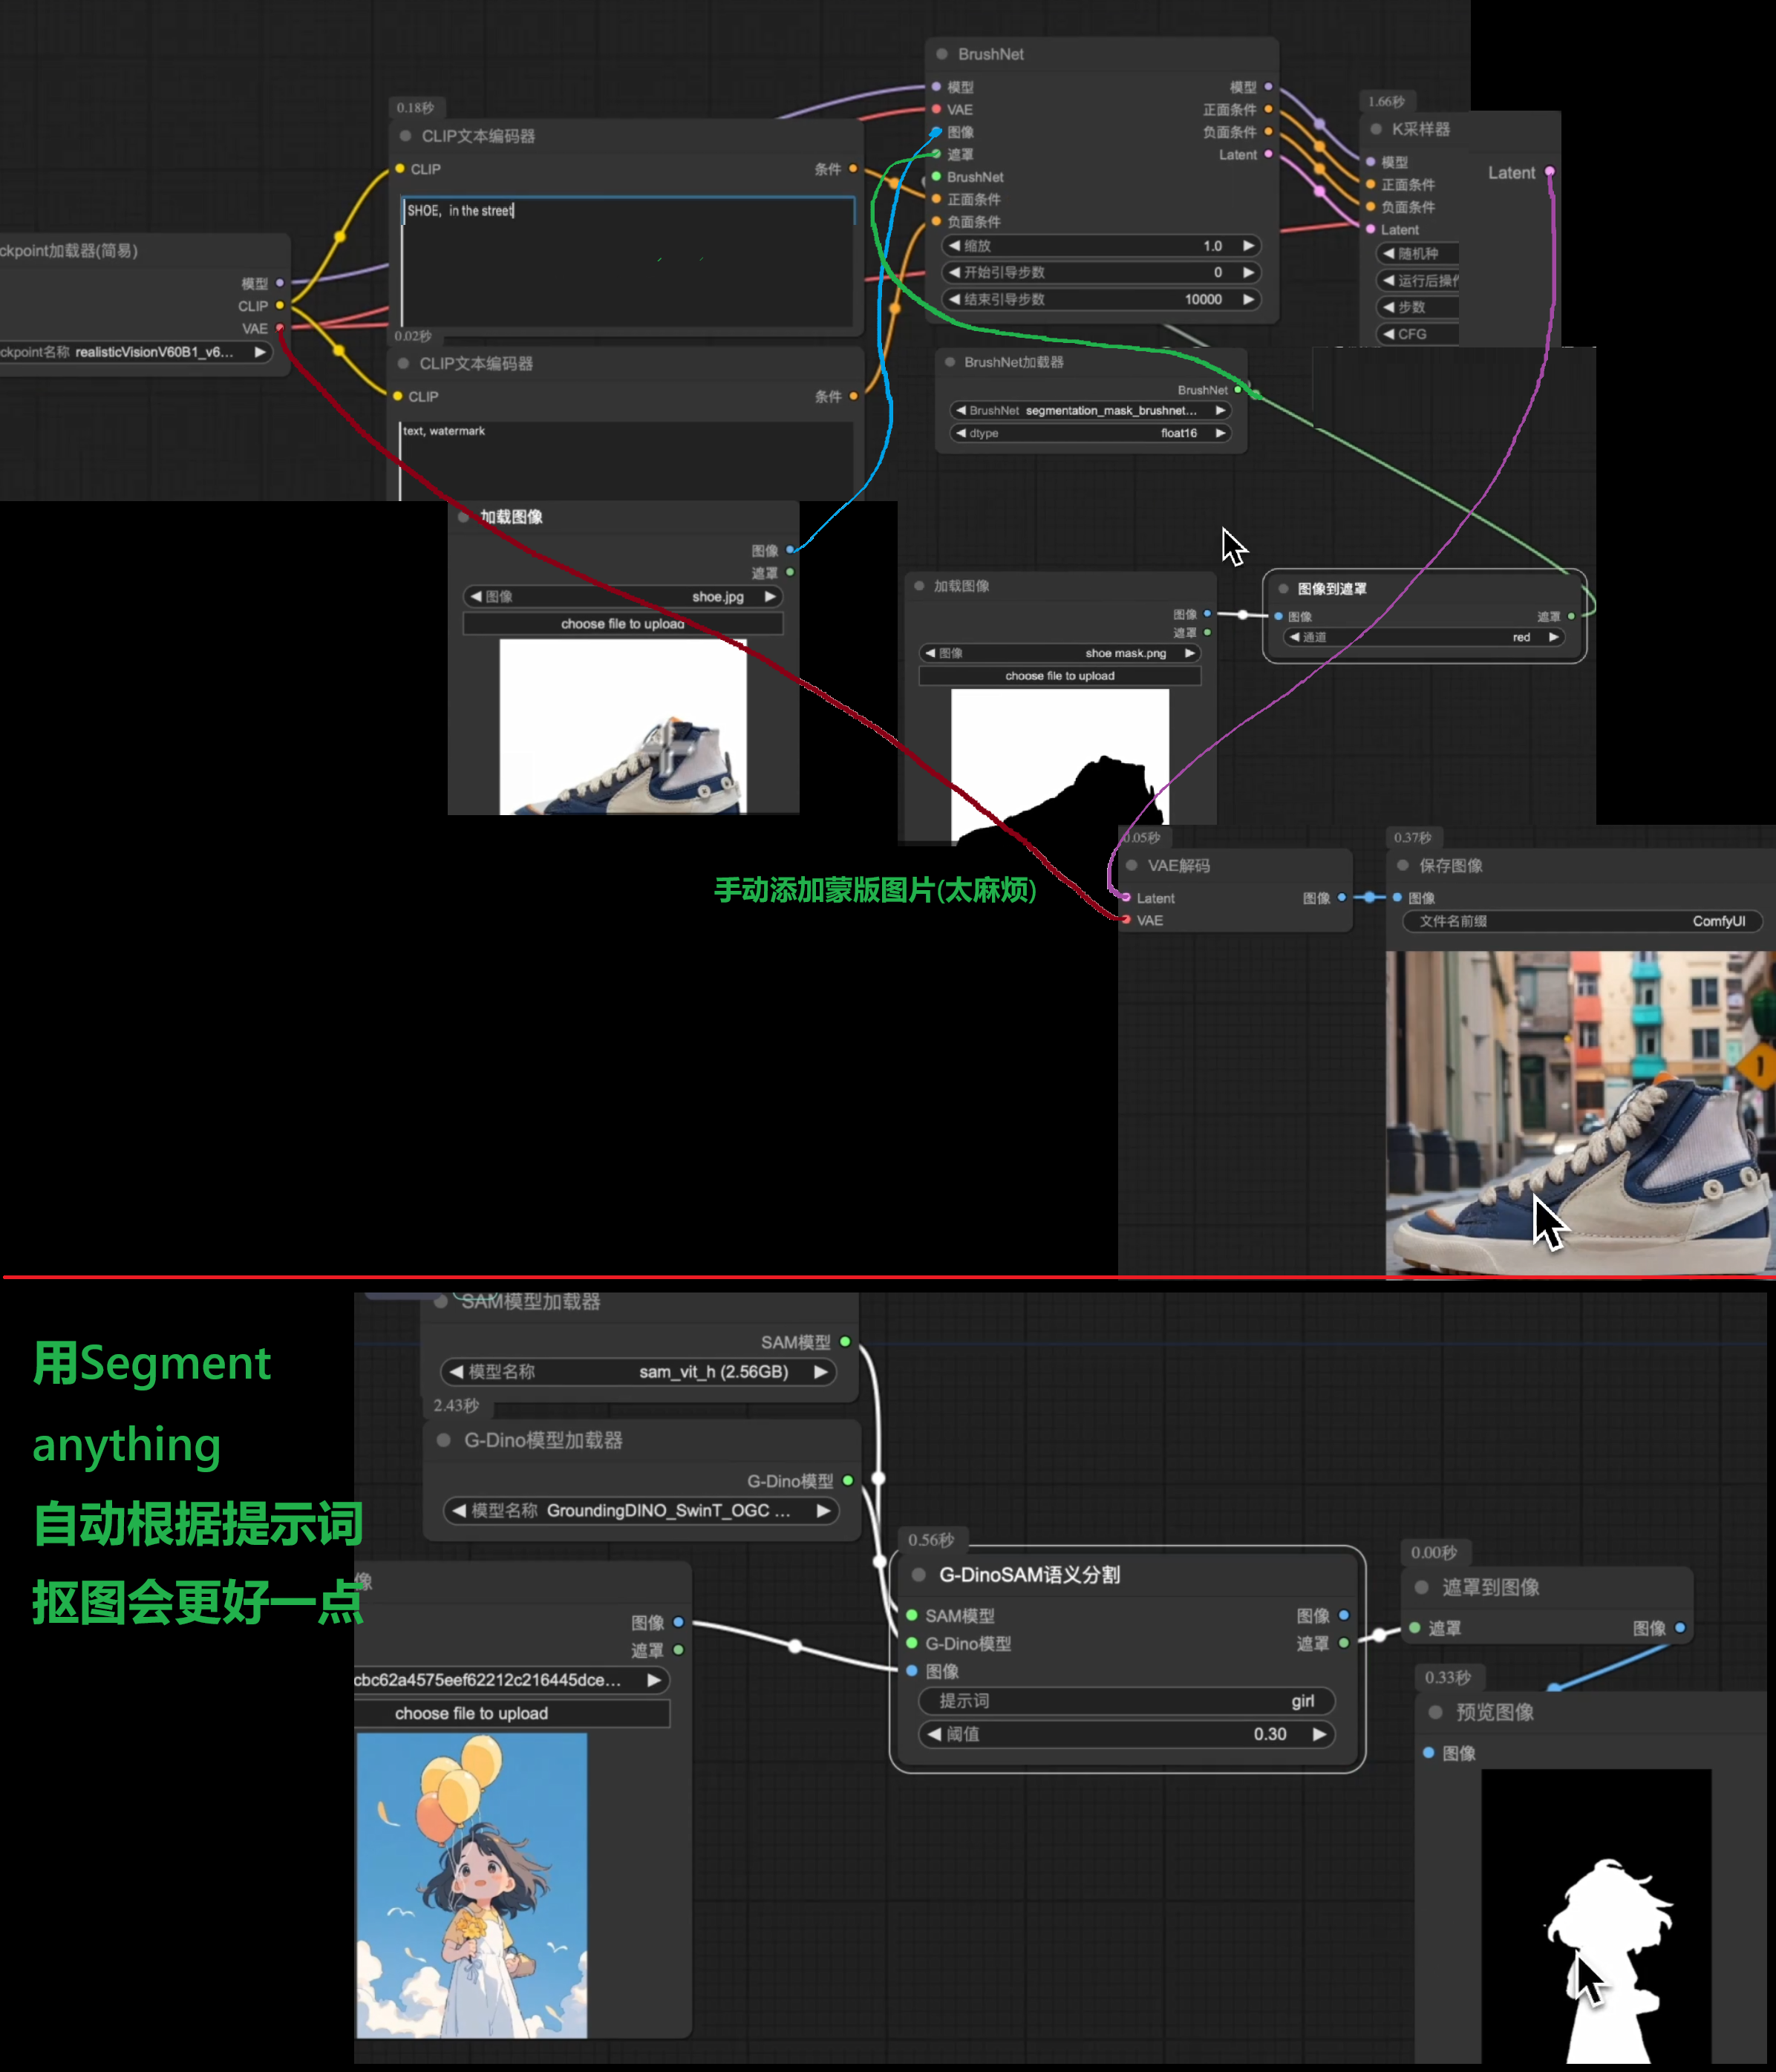
BrushNet + 语义分割局部重绘

BrushNet需要特定的模型segmentation_mask_brushnet...

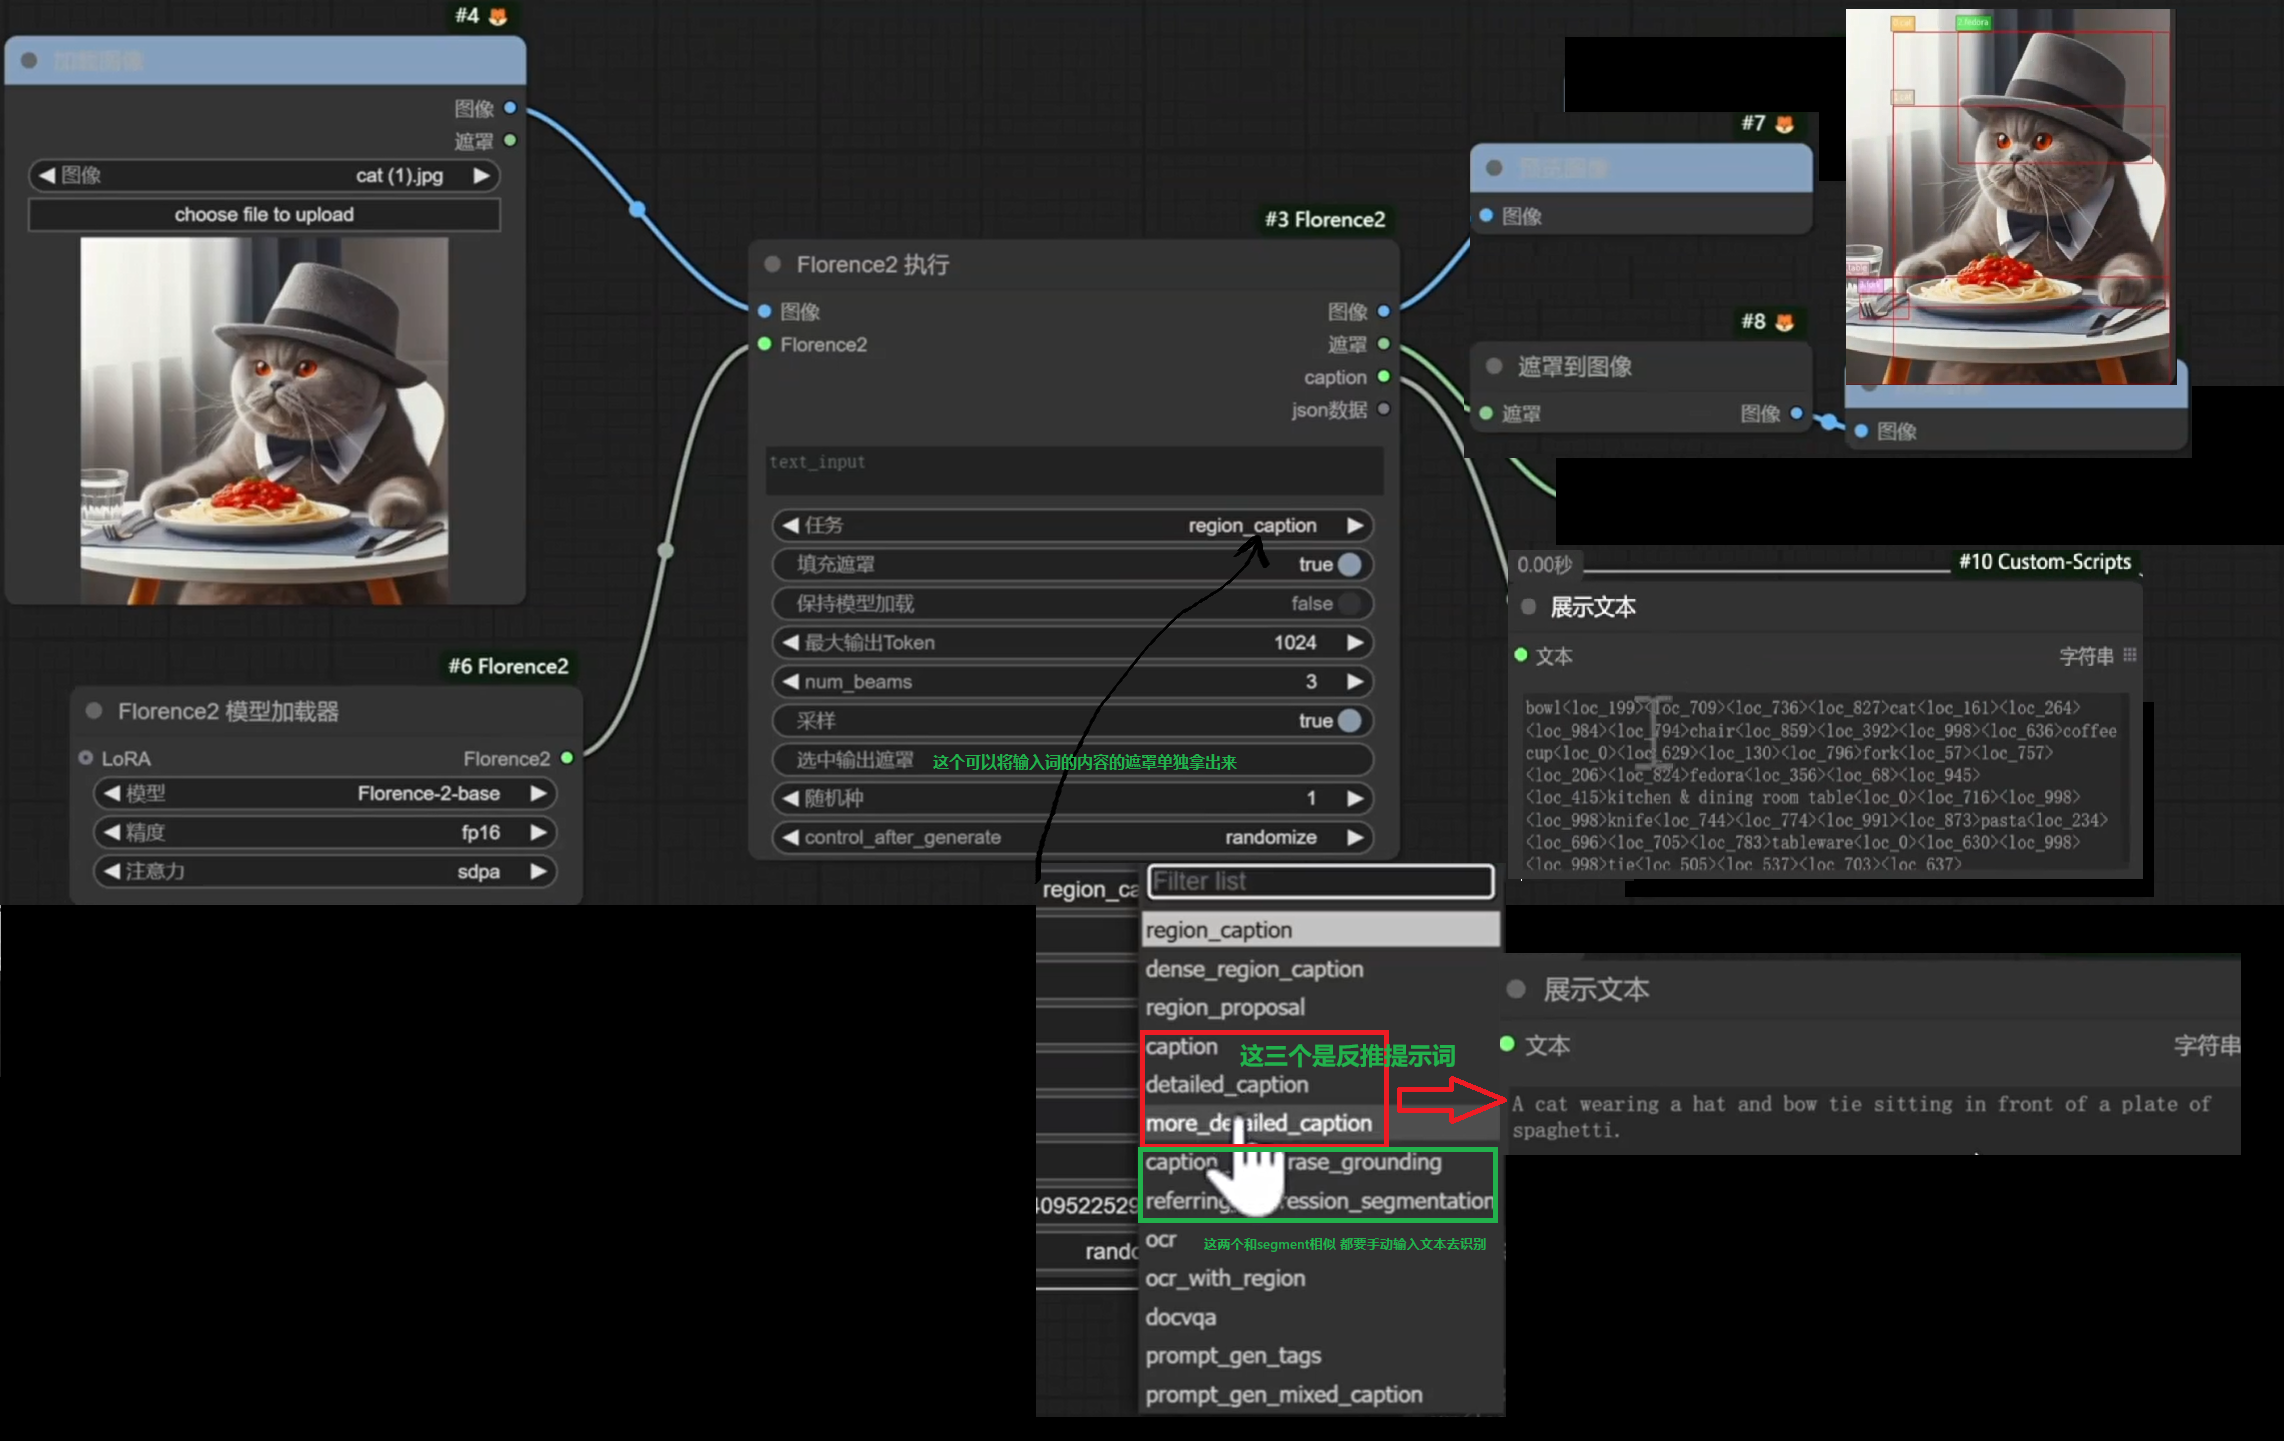
Florence 2提示词反推与区域视觉识别

主要是用到Segment-anything里面的sam模型
下载插件ComfyUI-Florence2(kijai)

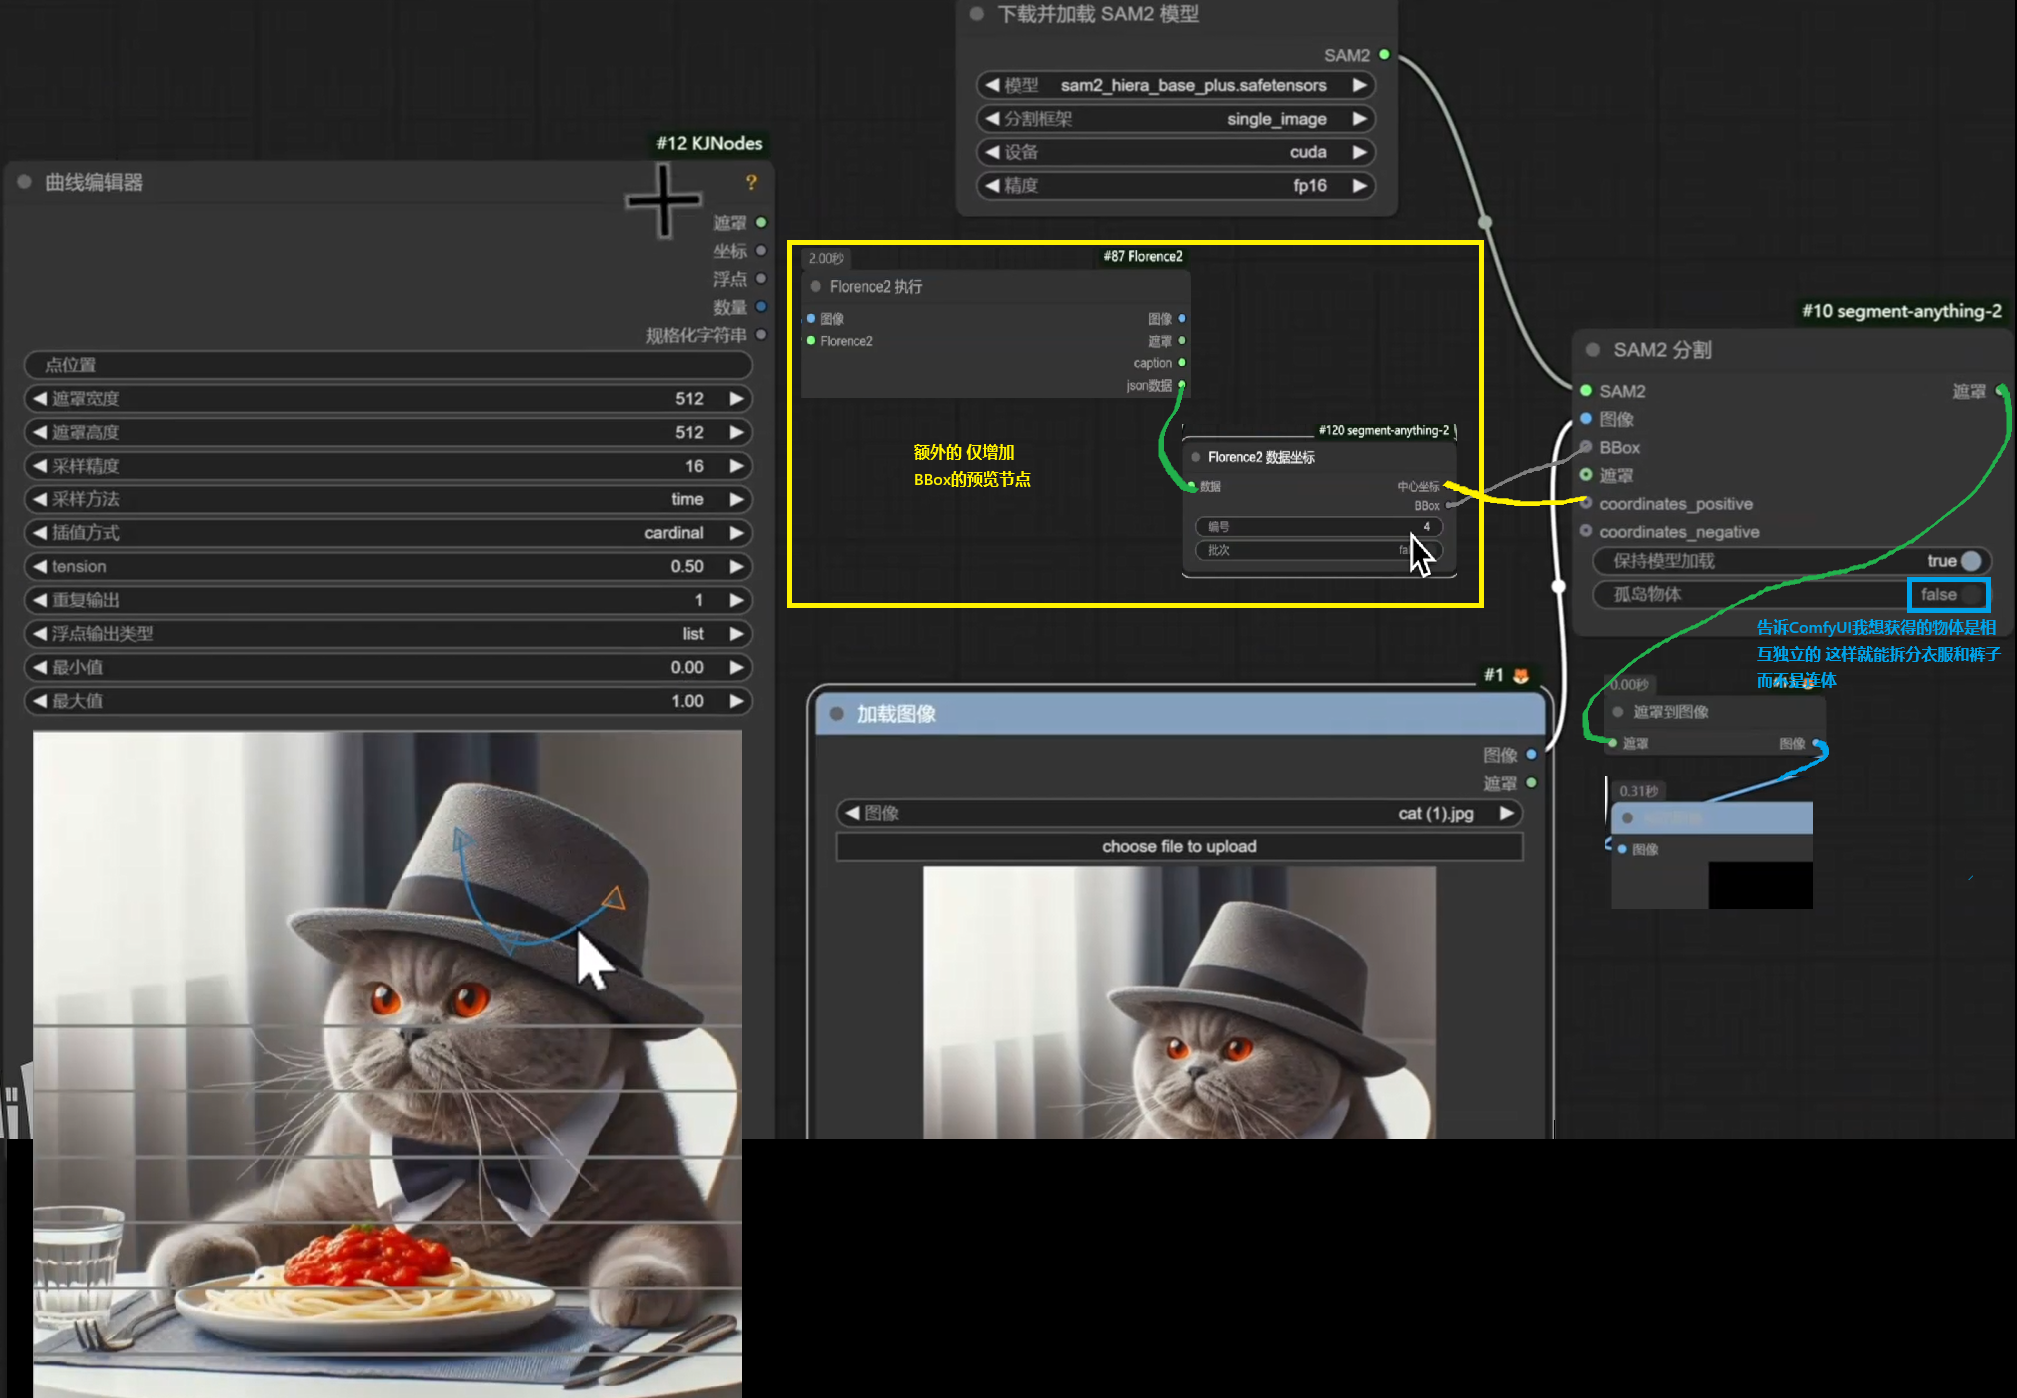
segment anything V2与曲线编辑器

背景:对于某些特定区域语义识别很难(细小物品)

下载插件segment-anything-2
★ 增加曲线节点需要按住Shift不放 再点击插入图片后的空白区域 即可新建一个节点
★ 点击鼠标右键即可删除某个节点!!

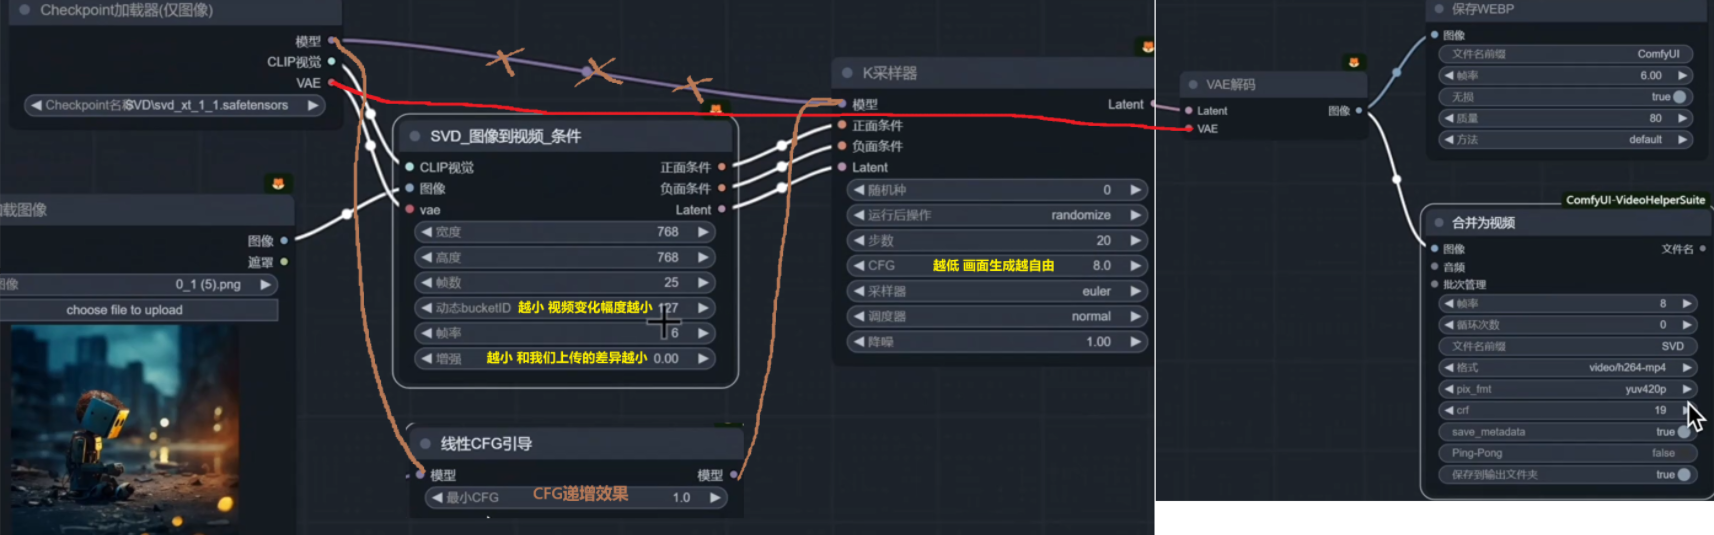
SVD视频工作流(Stable Video Diffusion)

安装ComfyUl-VideoHelperSuite插件 就可以选择很多保存视频的格式了

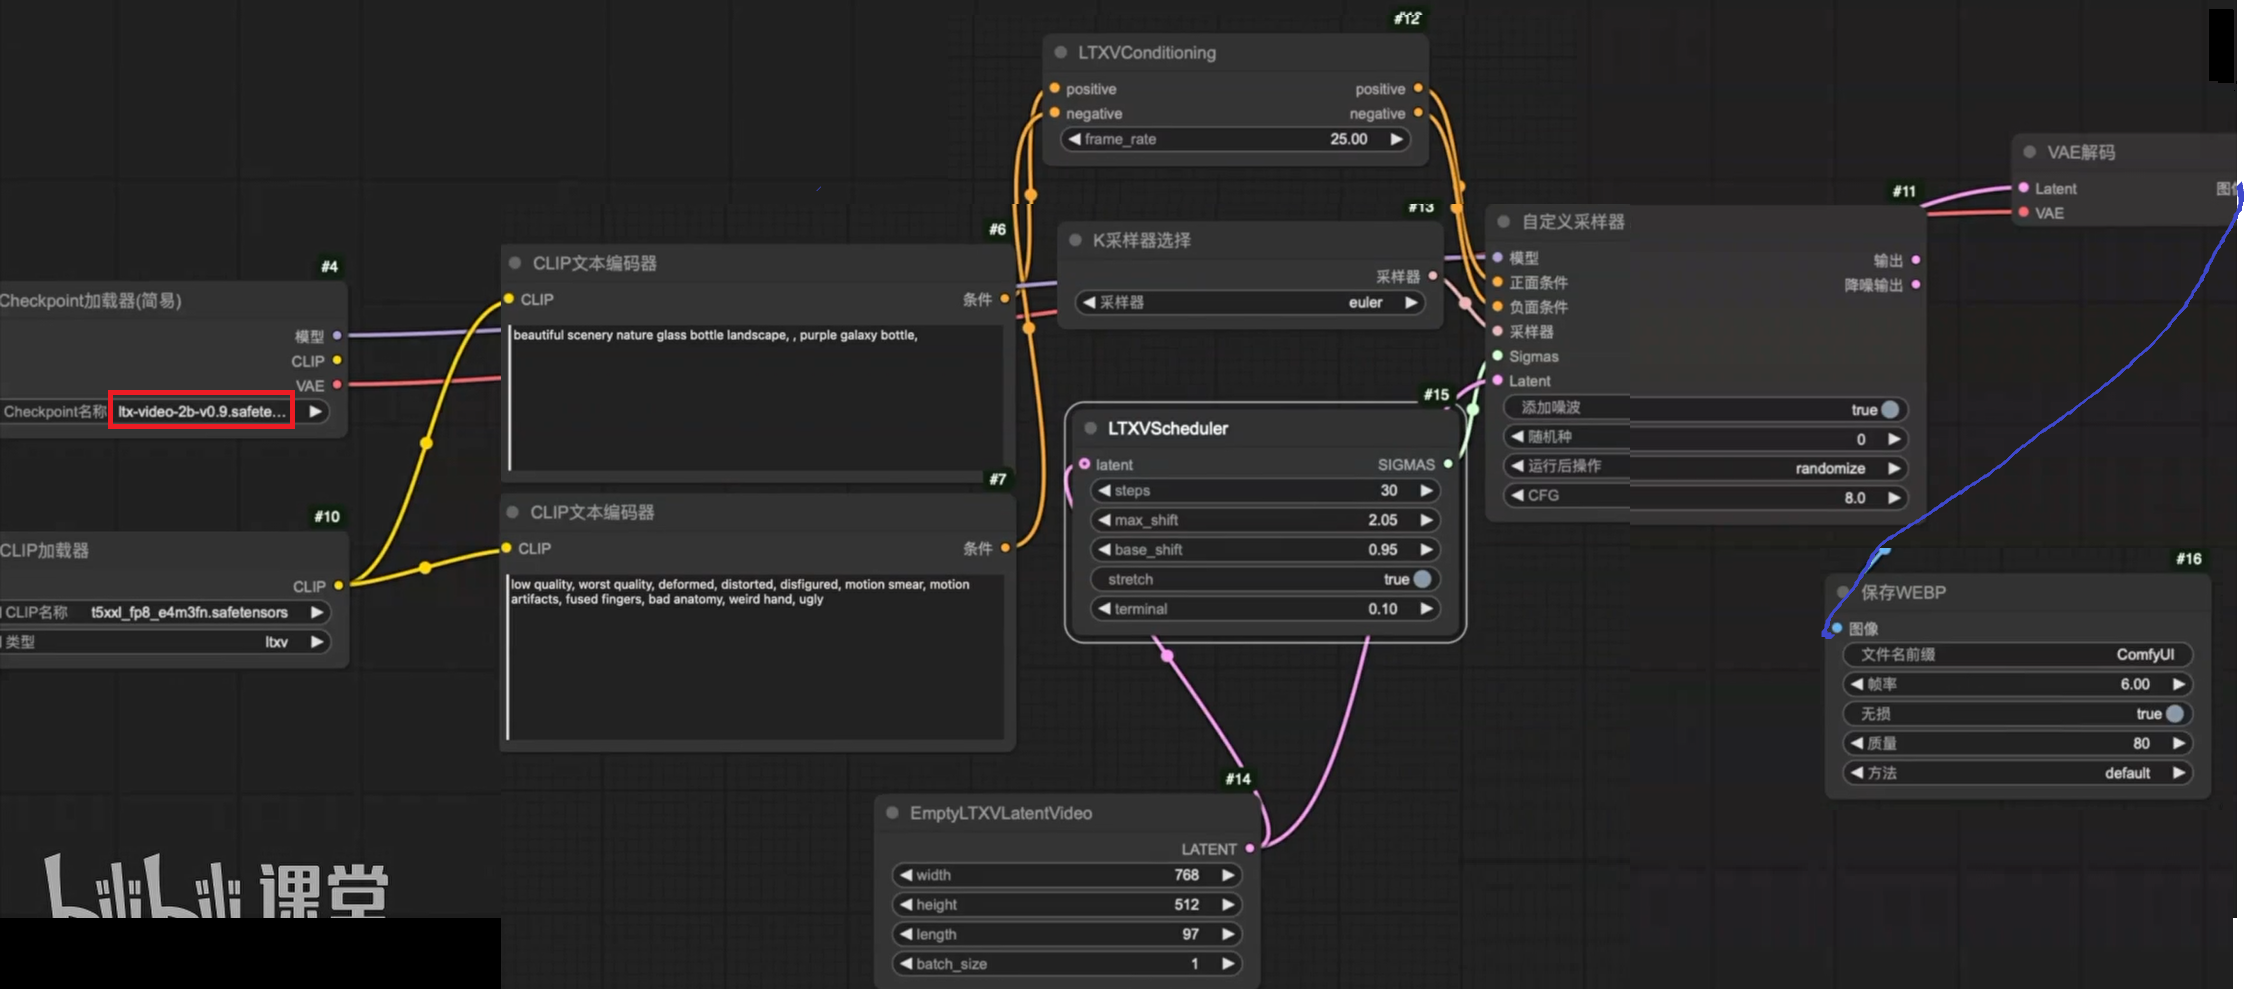
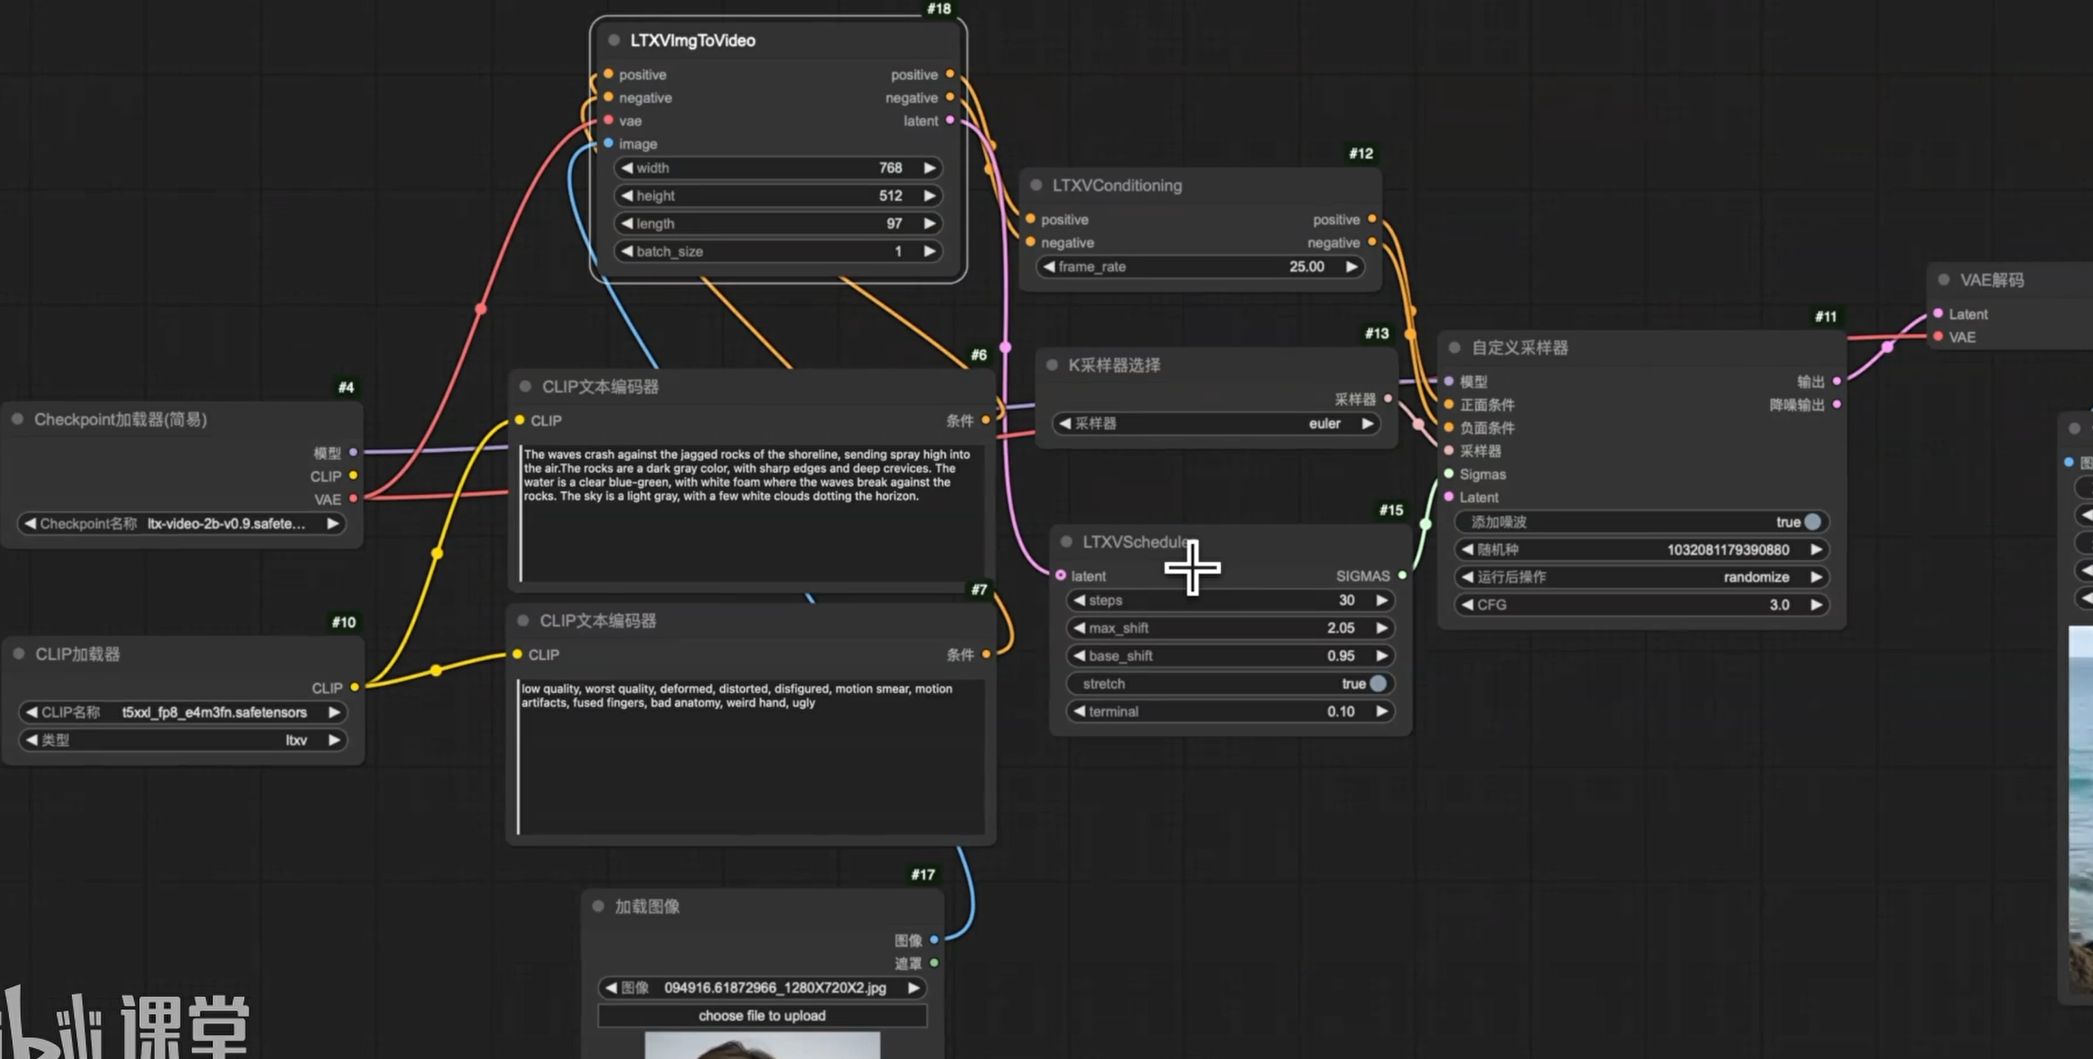
LTX-Video高效快速生成视频模型

文生视频

如果想保存视频,下载插件VideoHelperSuite → 合并为视频

图生视频

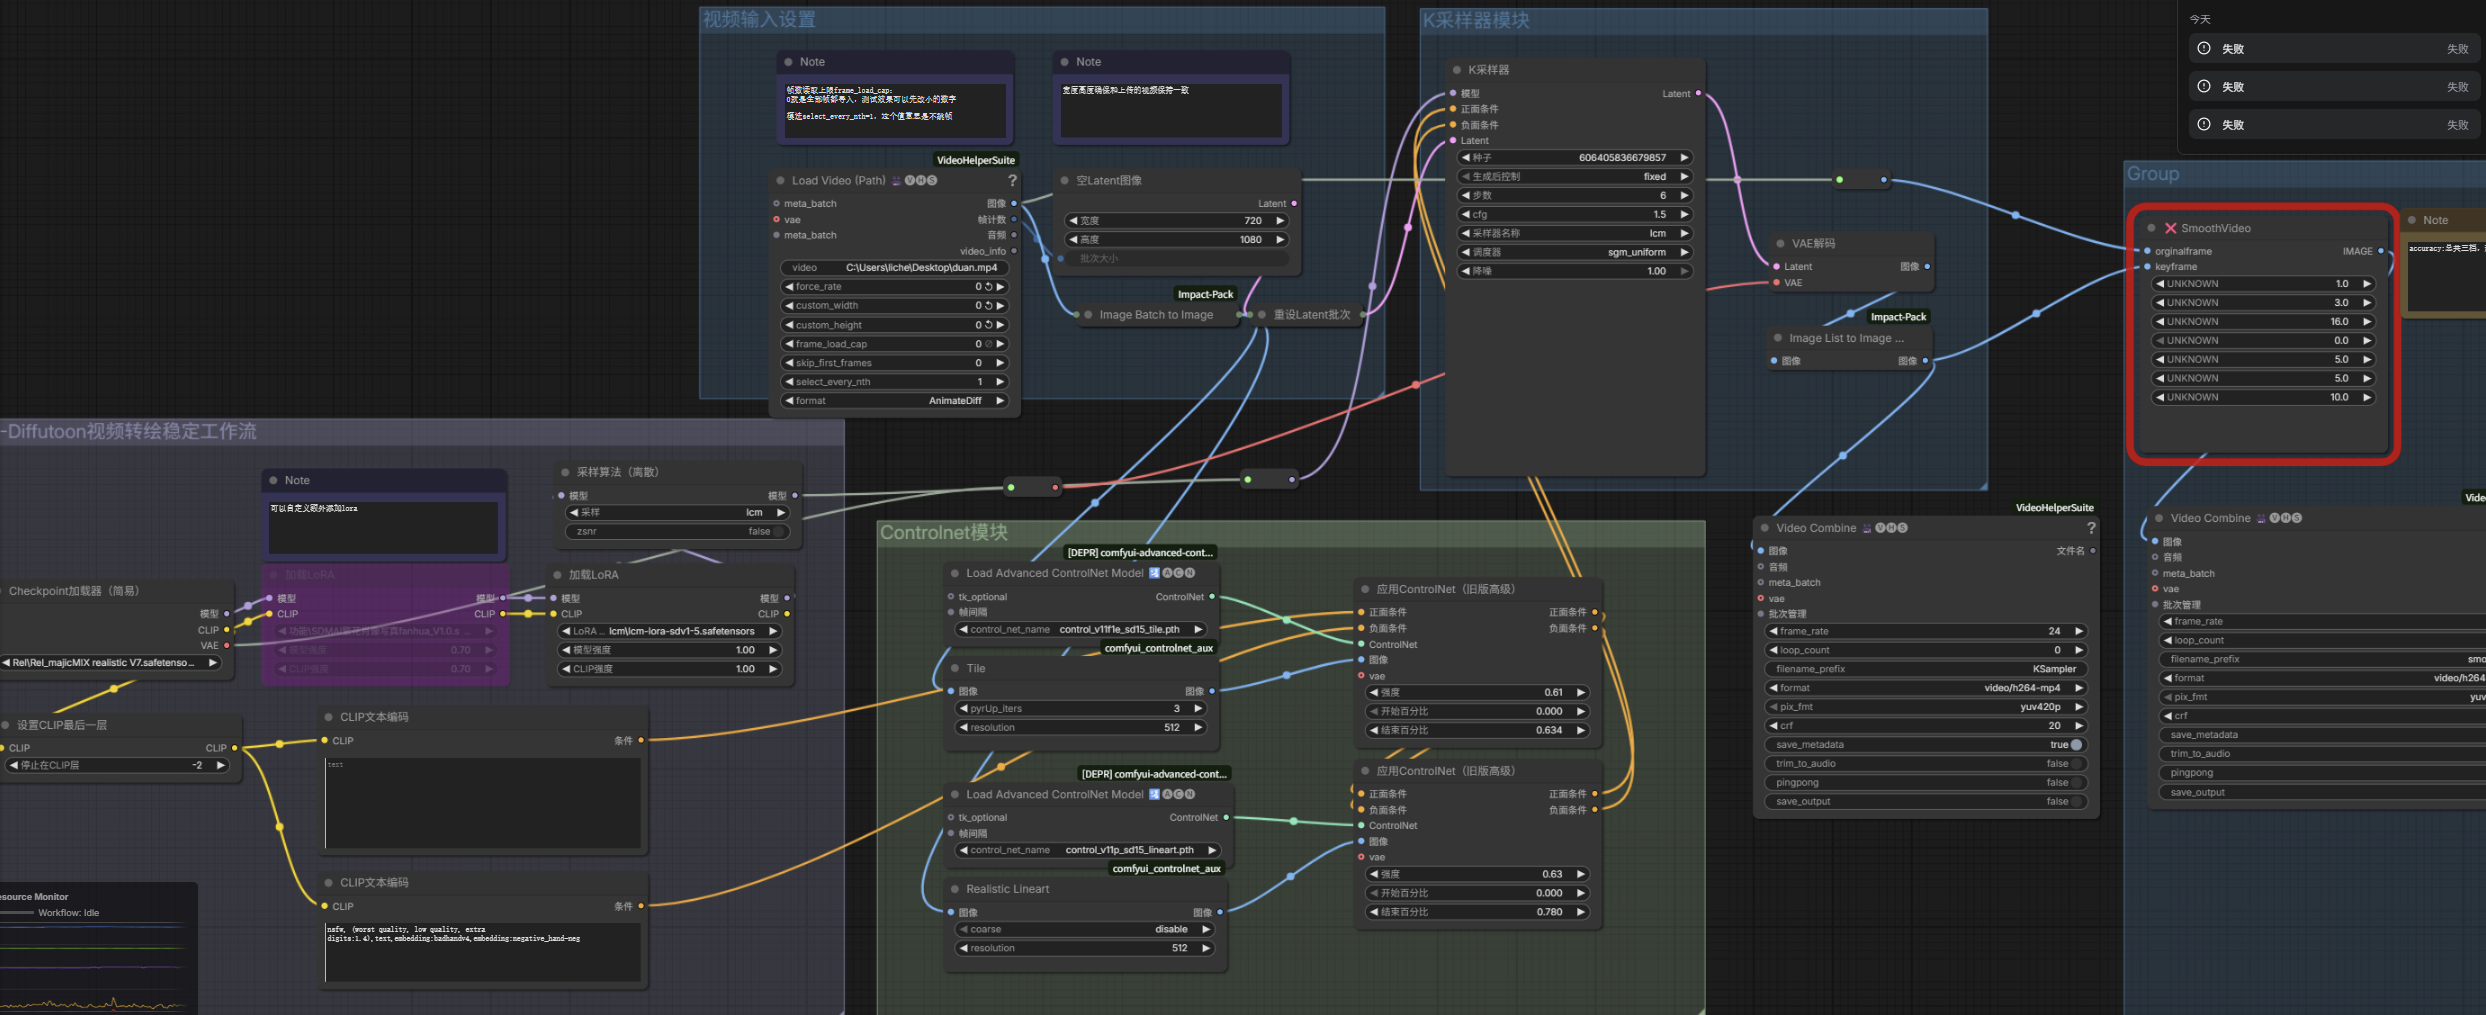
丝滑动画转绘 Diffutoon视频工作流

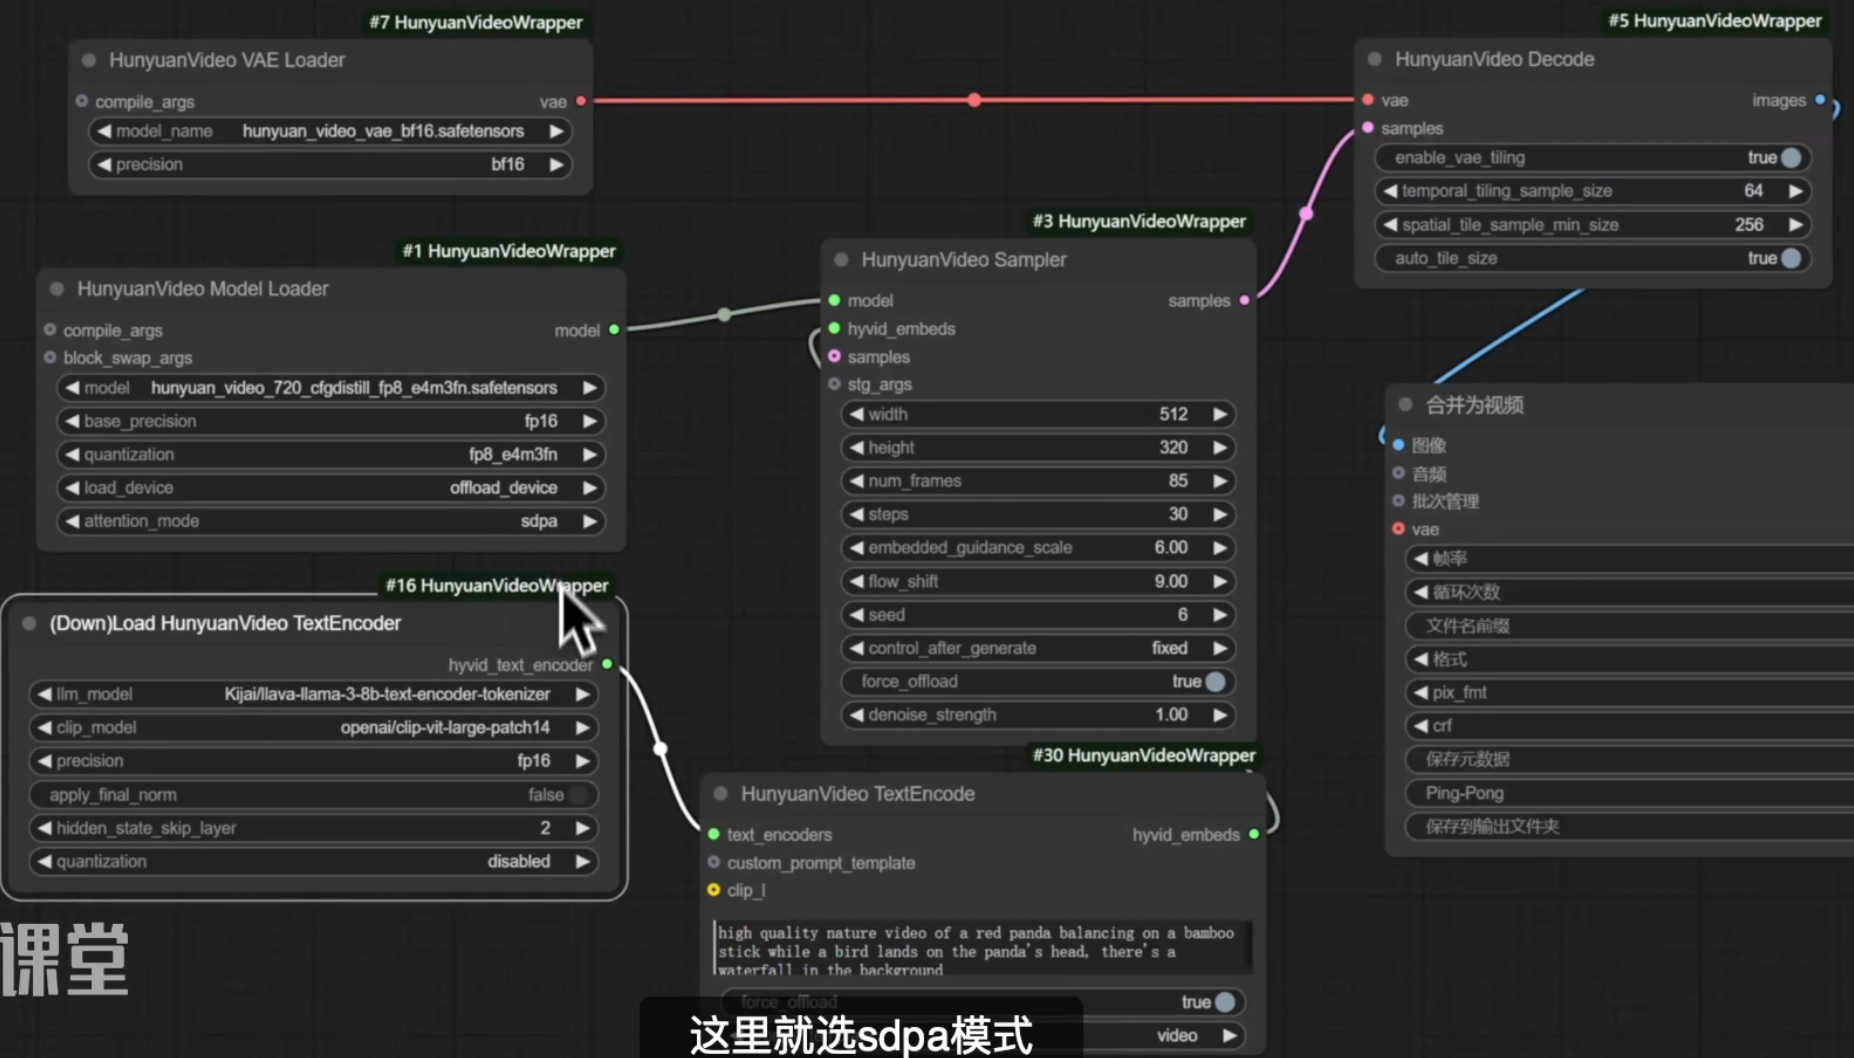
腾讯混元HumyuanVideo开源视频模型

[腾讯混元] (https://hunyuan.tencent.com/)

ComfyUI需要安装HunyuanVideoWrapper插件

提前需要环境要求:(4090+)

1、腾讯混元视频Python环境要求3.11或以上的版本(秋叶的启动器comfyui是3.10),所以推荐用comfyui官方版本,不然整个过程会破坏原本秋叶整合包的环境,切记!
2、需要安装torch+cuda
3、需要安装visual studio
4、配置win环境
5、配置模型

  • hunyuan_video_720_cfgdistill_fp8_e4m3fn.safetensors放置到comfyui目录models的diffusion_models里面
  • clip-vit-large-patch14整个文件夹放置到comfyui目录models的clip里面
  • llava-llama-3-8b-text-encoder-tokenizer整个文件夹放置到comfyui目录models的LLM面
  • hunyuan_video_vae_bf16.safetensors放置到comfyui目录models的vae里面

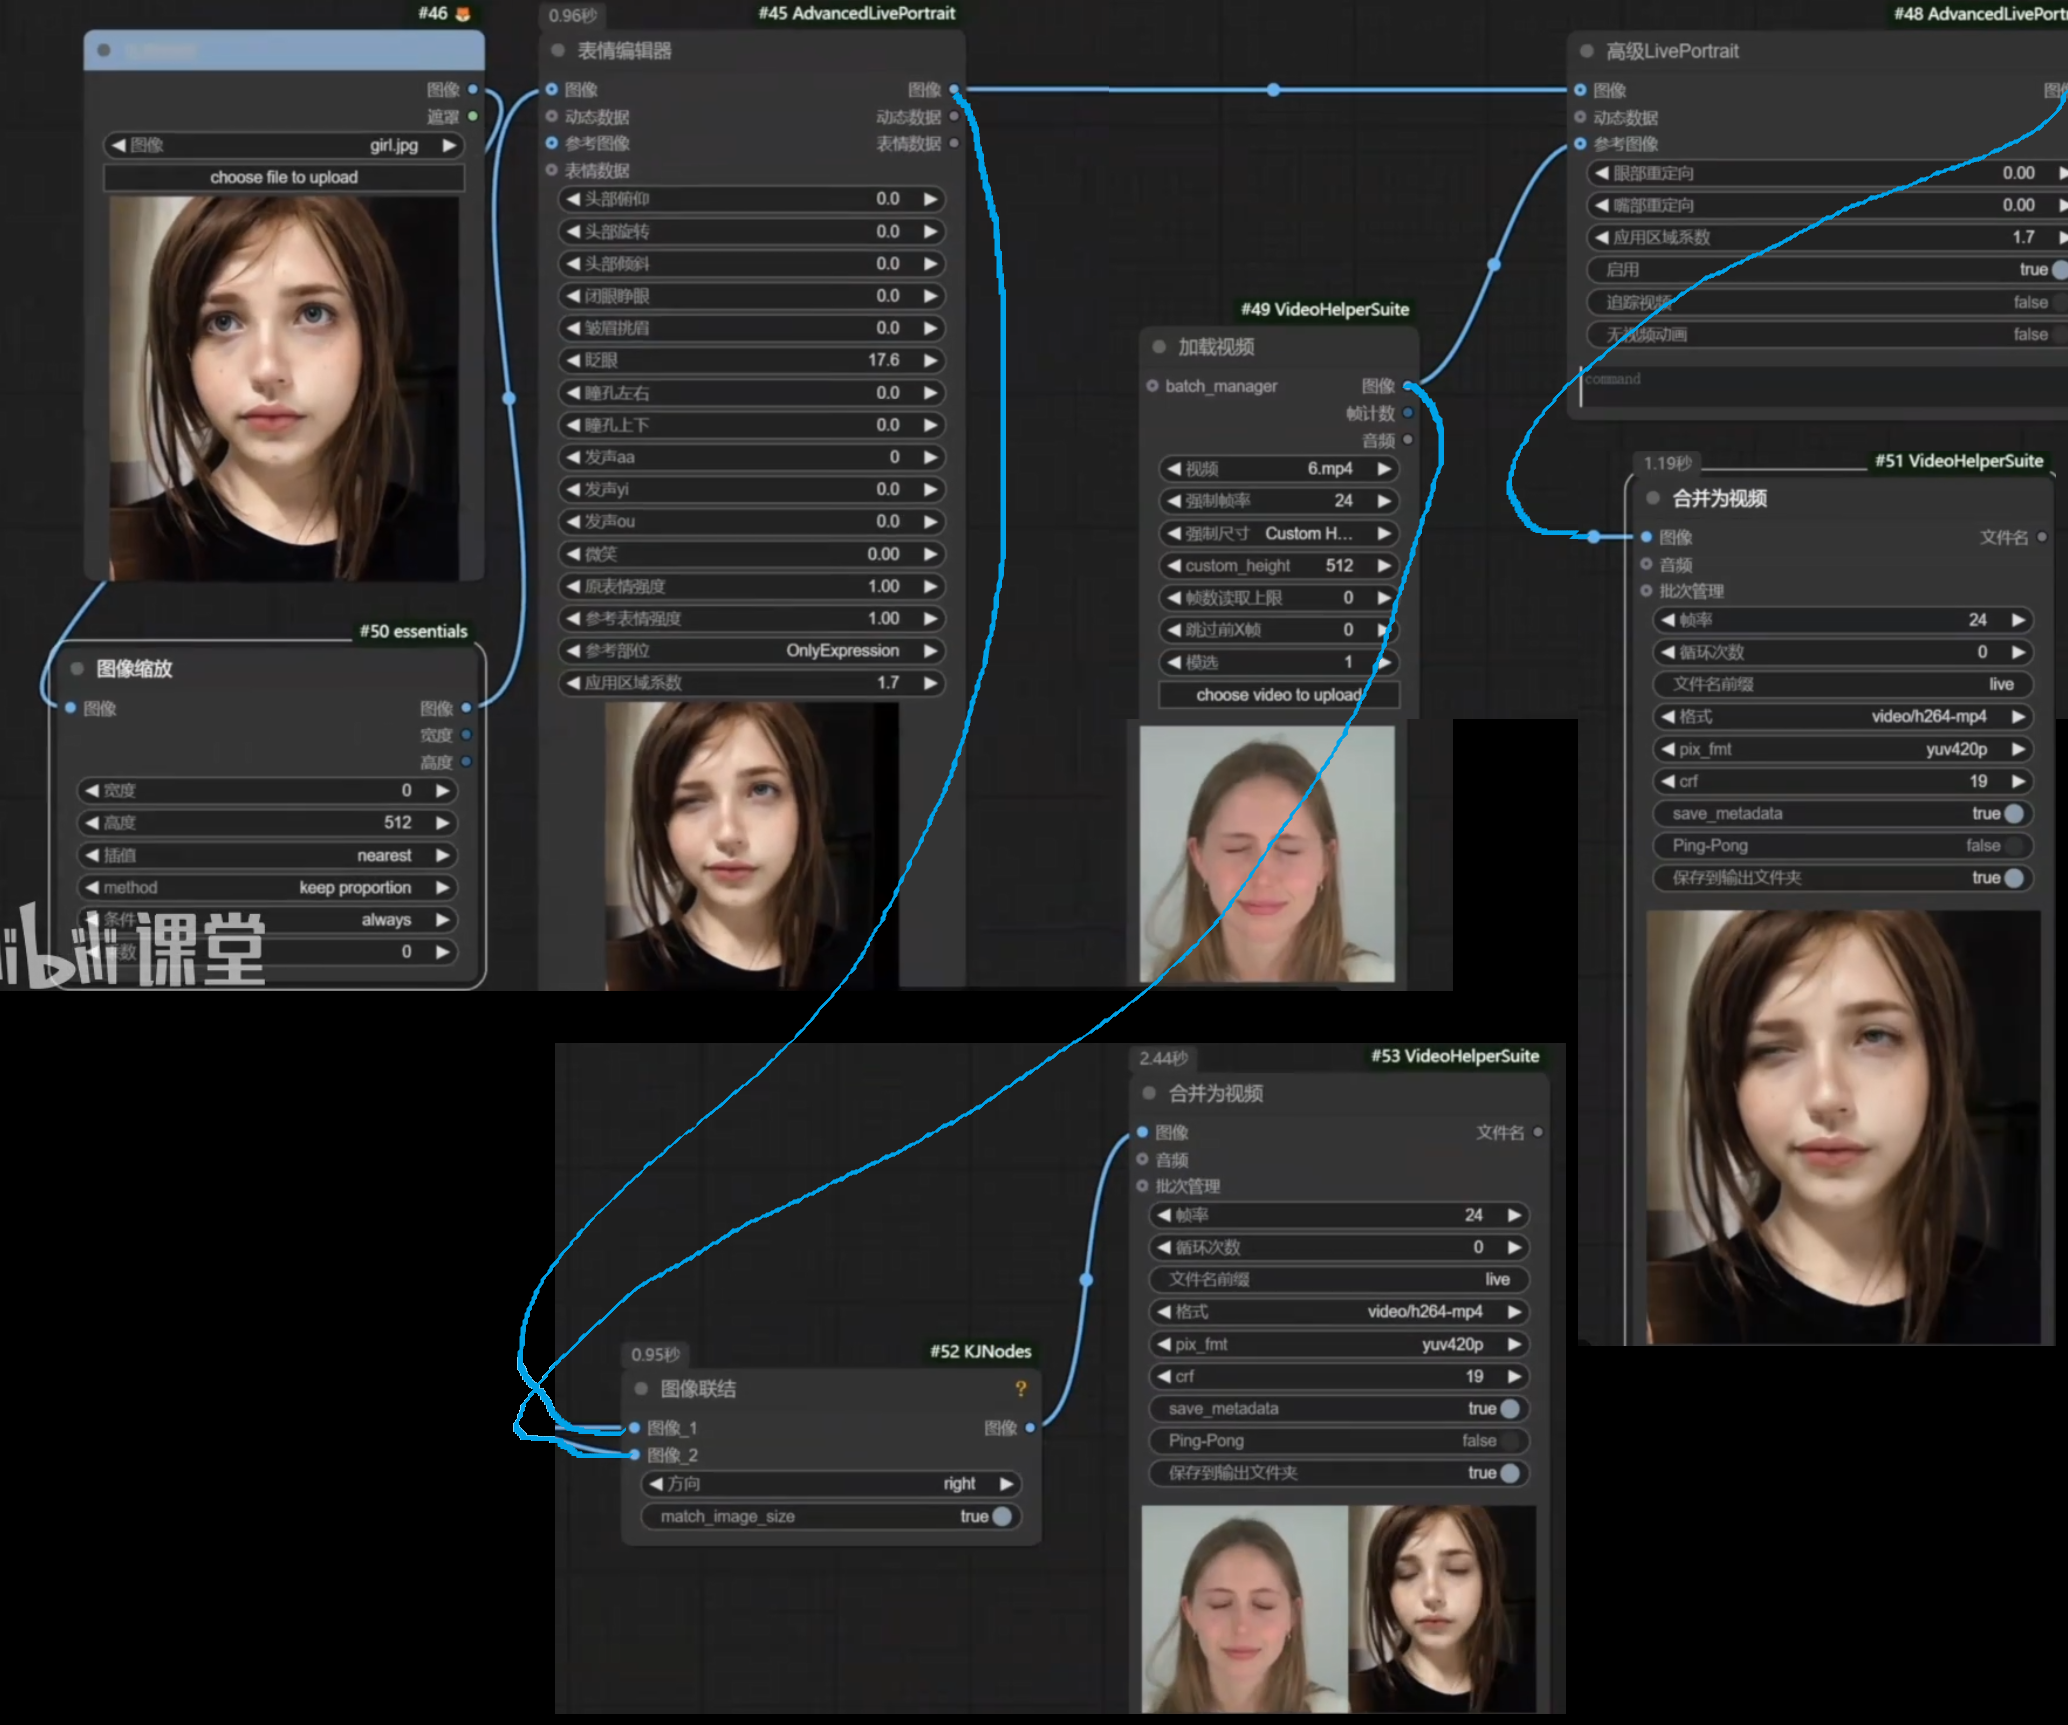
LivePortrait脸部表情改变与脸部驱动

需要下载ComfyUI-AdvancedLivePortrait插件

Segment anything + BrushNet产品背景更换

IC-Light + IP-Adapter光效配合匹配工作流

easy-use + segment anything

无惧放大,电商产品海报最终工作流产品有精细化刻度(手表)

was node suite(调色) + pythongosssss/ComfyUI-Custom-Script(缩放) + Impact Pack(高斯模糊)

E:\ComfyUI\全面掌握Comfyui系统教程\75 无惧放大,电商产品海报终极工作流.mp4
① 反转图层;② 新建模糊图层;③ 50%ADD叠加
CG迷—高清产品工作流

百度网盘里没有工作流.json,看看端脑云里面有没有!!!!!!!!!

瑕疵完美消除 进阶局部重绘和擦除工作流

放大!!

插件放大

SD放大 (UltimateSDUpscale插件) + 高清修复 (EasyUse)
AuraSR—ComfyUI插件

AuraSR-v2模型和config.json文件
放到ComfyUI目录\models\Aura-SR里面

Flux放大
爆炸细节SUPIR放大 需要SUPIR插件 模型放入 models\checkpoints里面

不过任何带有字体文字的都不适合用SUPIR放大!!

手把手模块化搭建Flux模型产品摄影工作流

手把手模块化搭建Flux模型产品摄影工作流

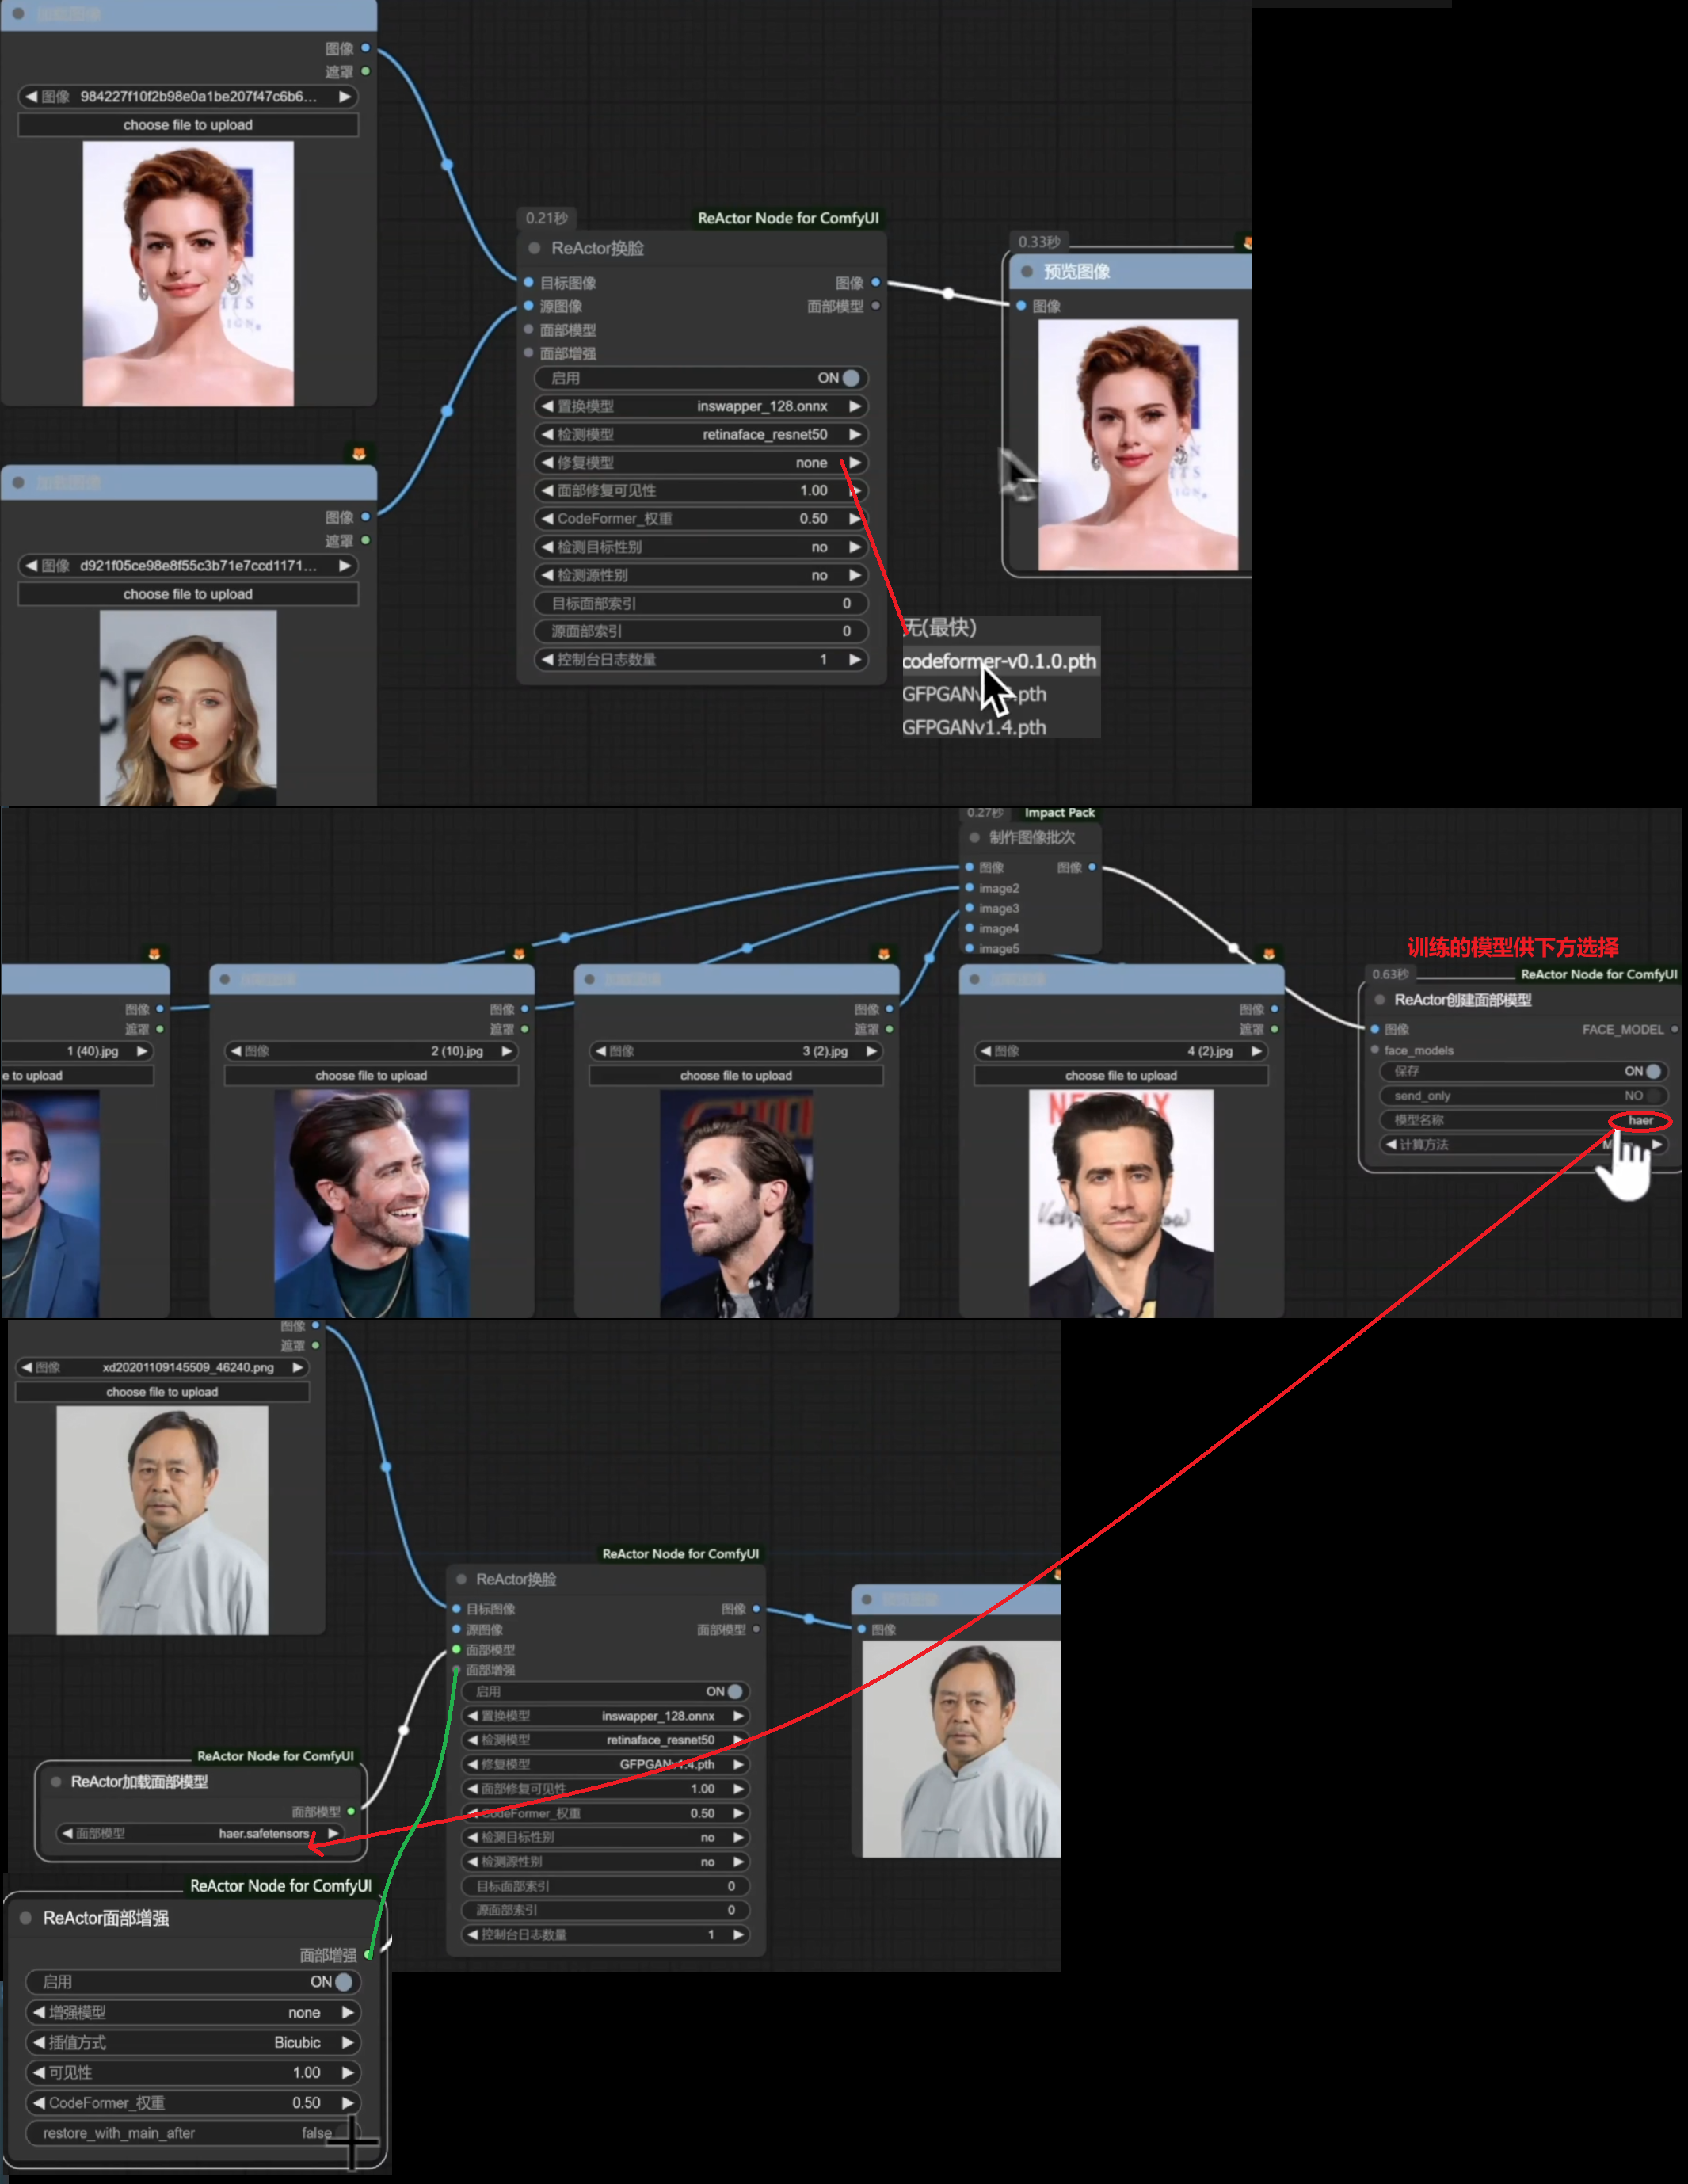
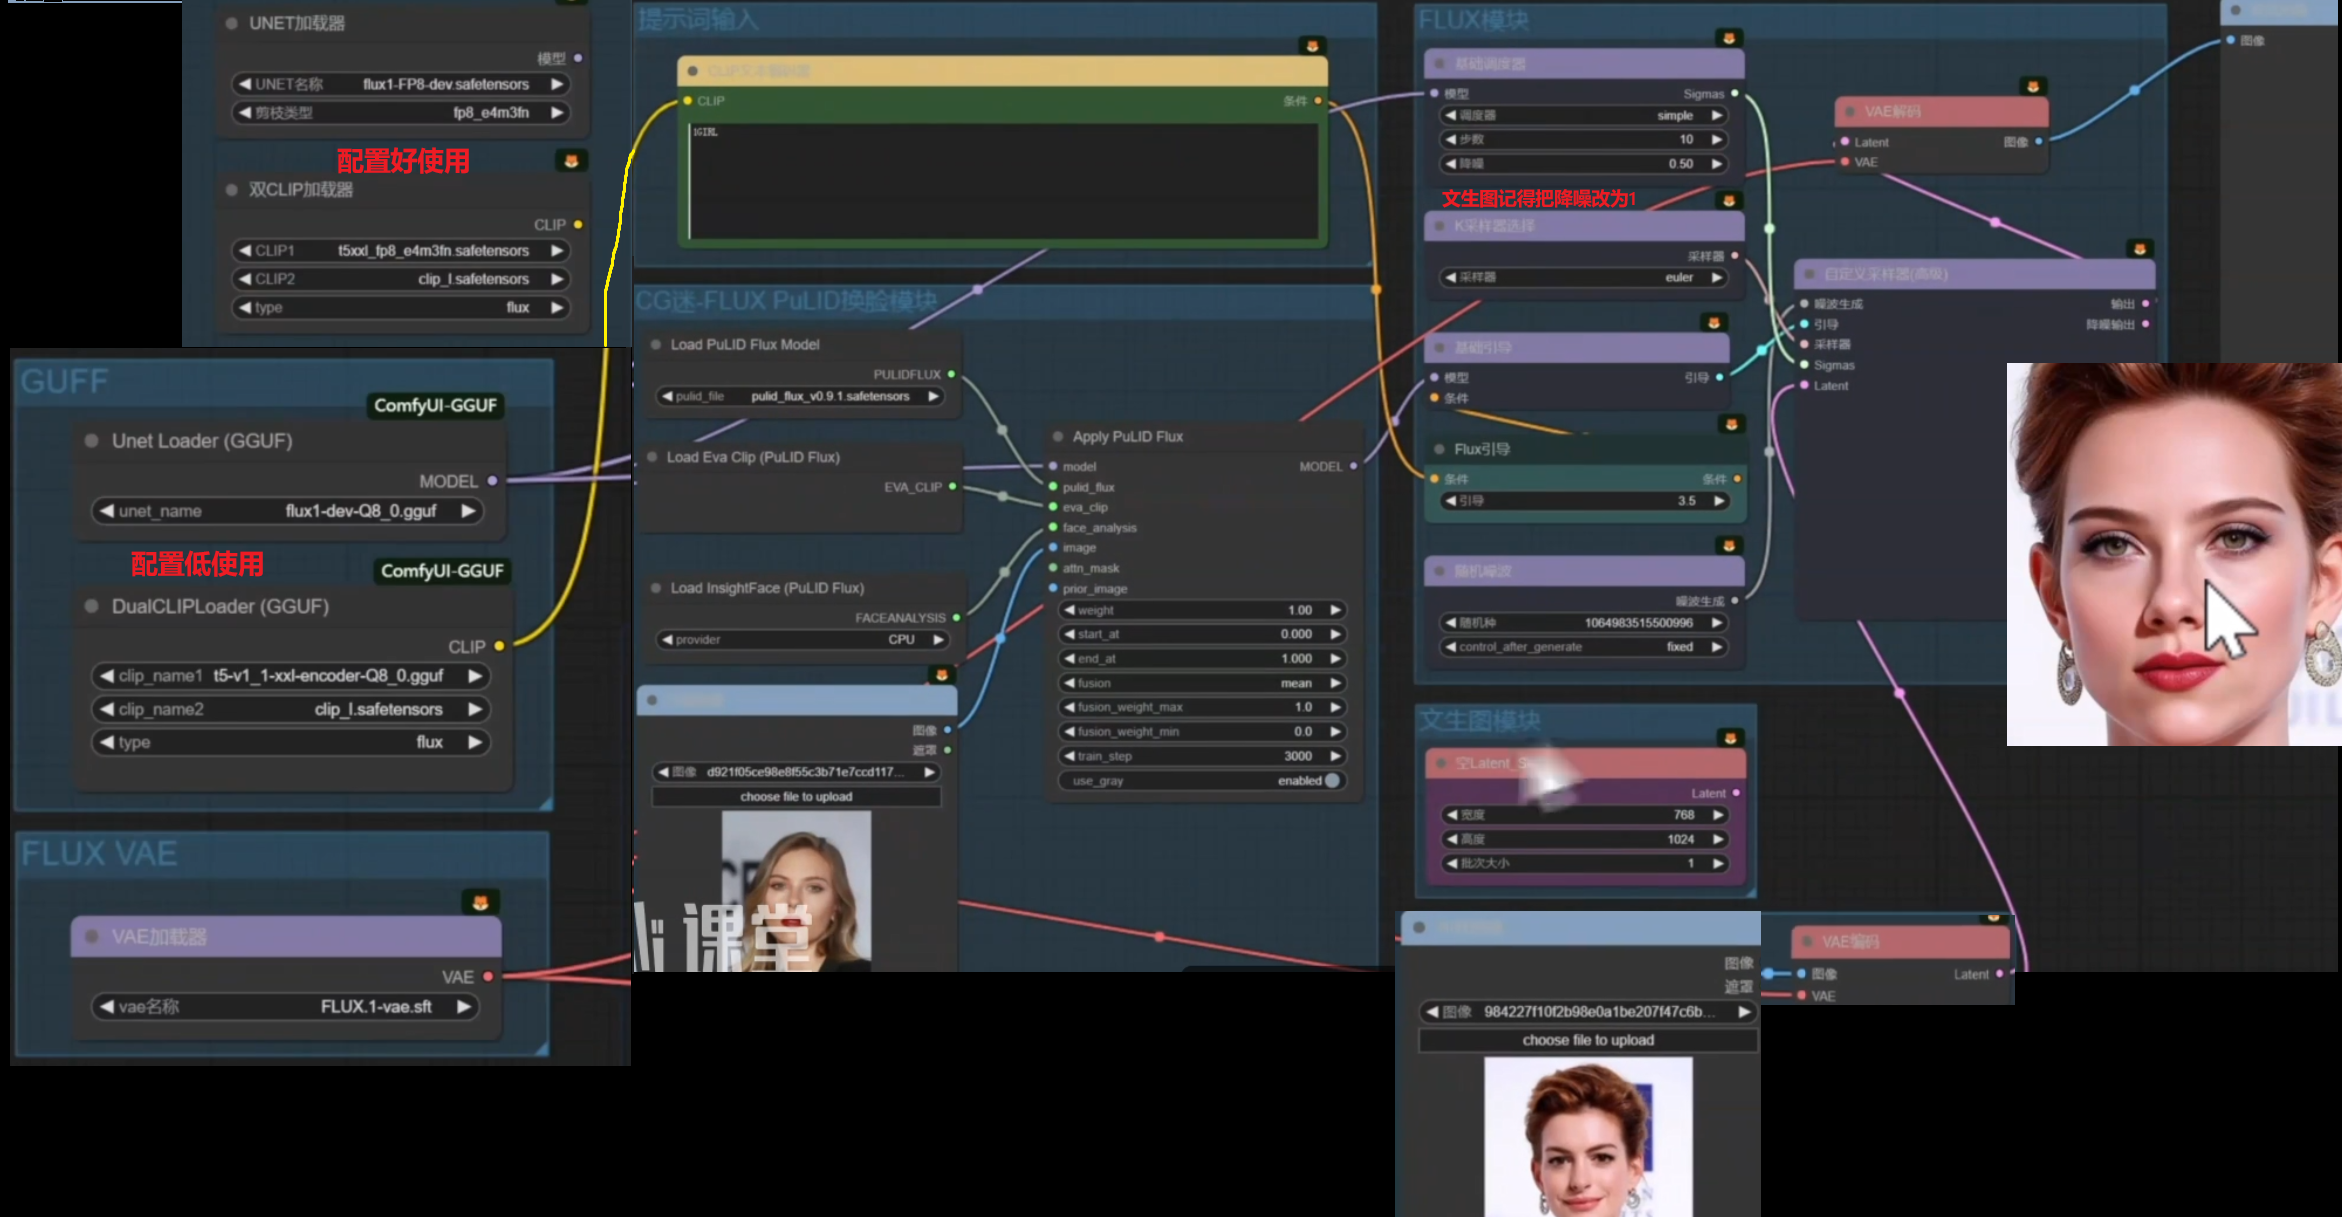
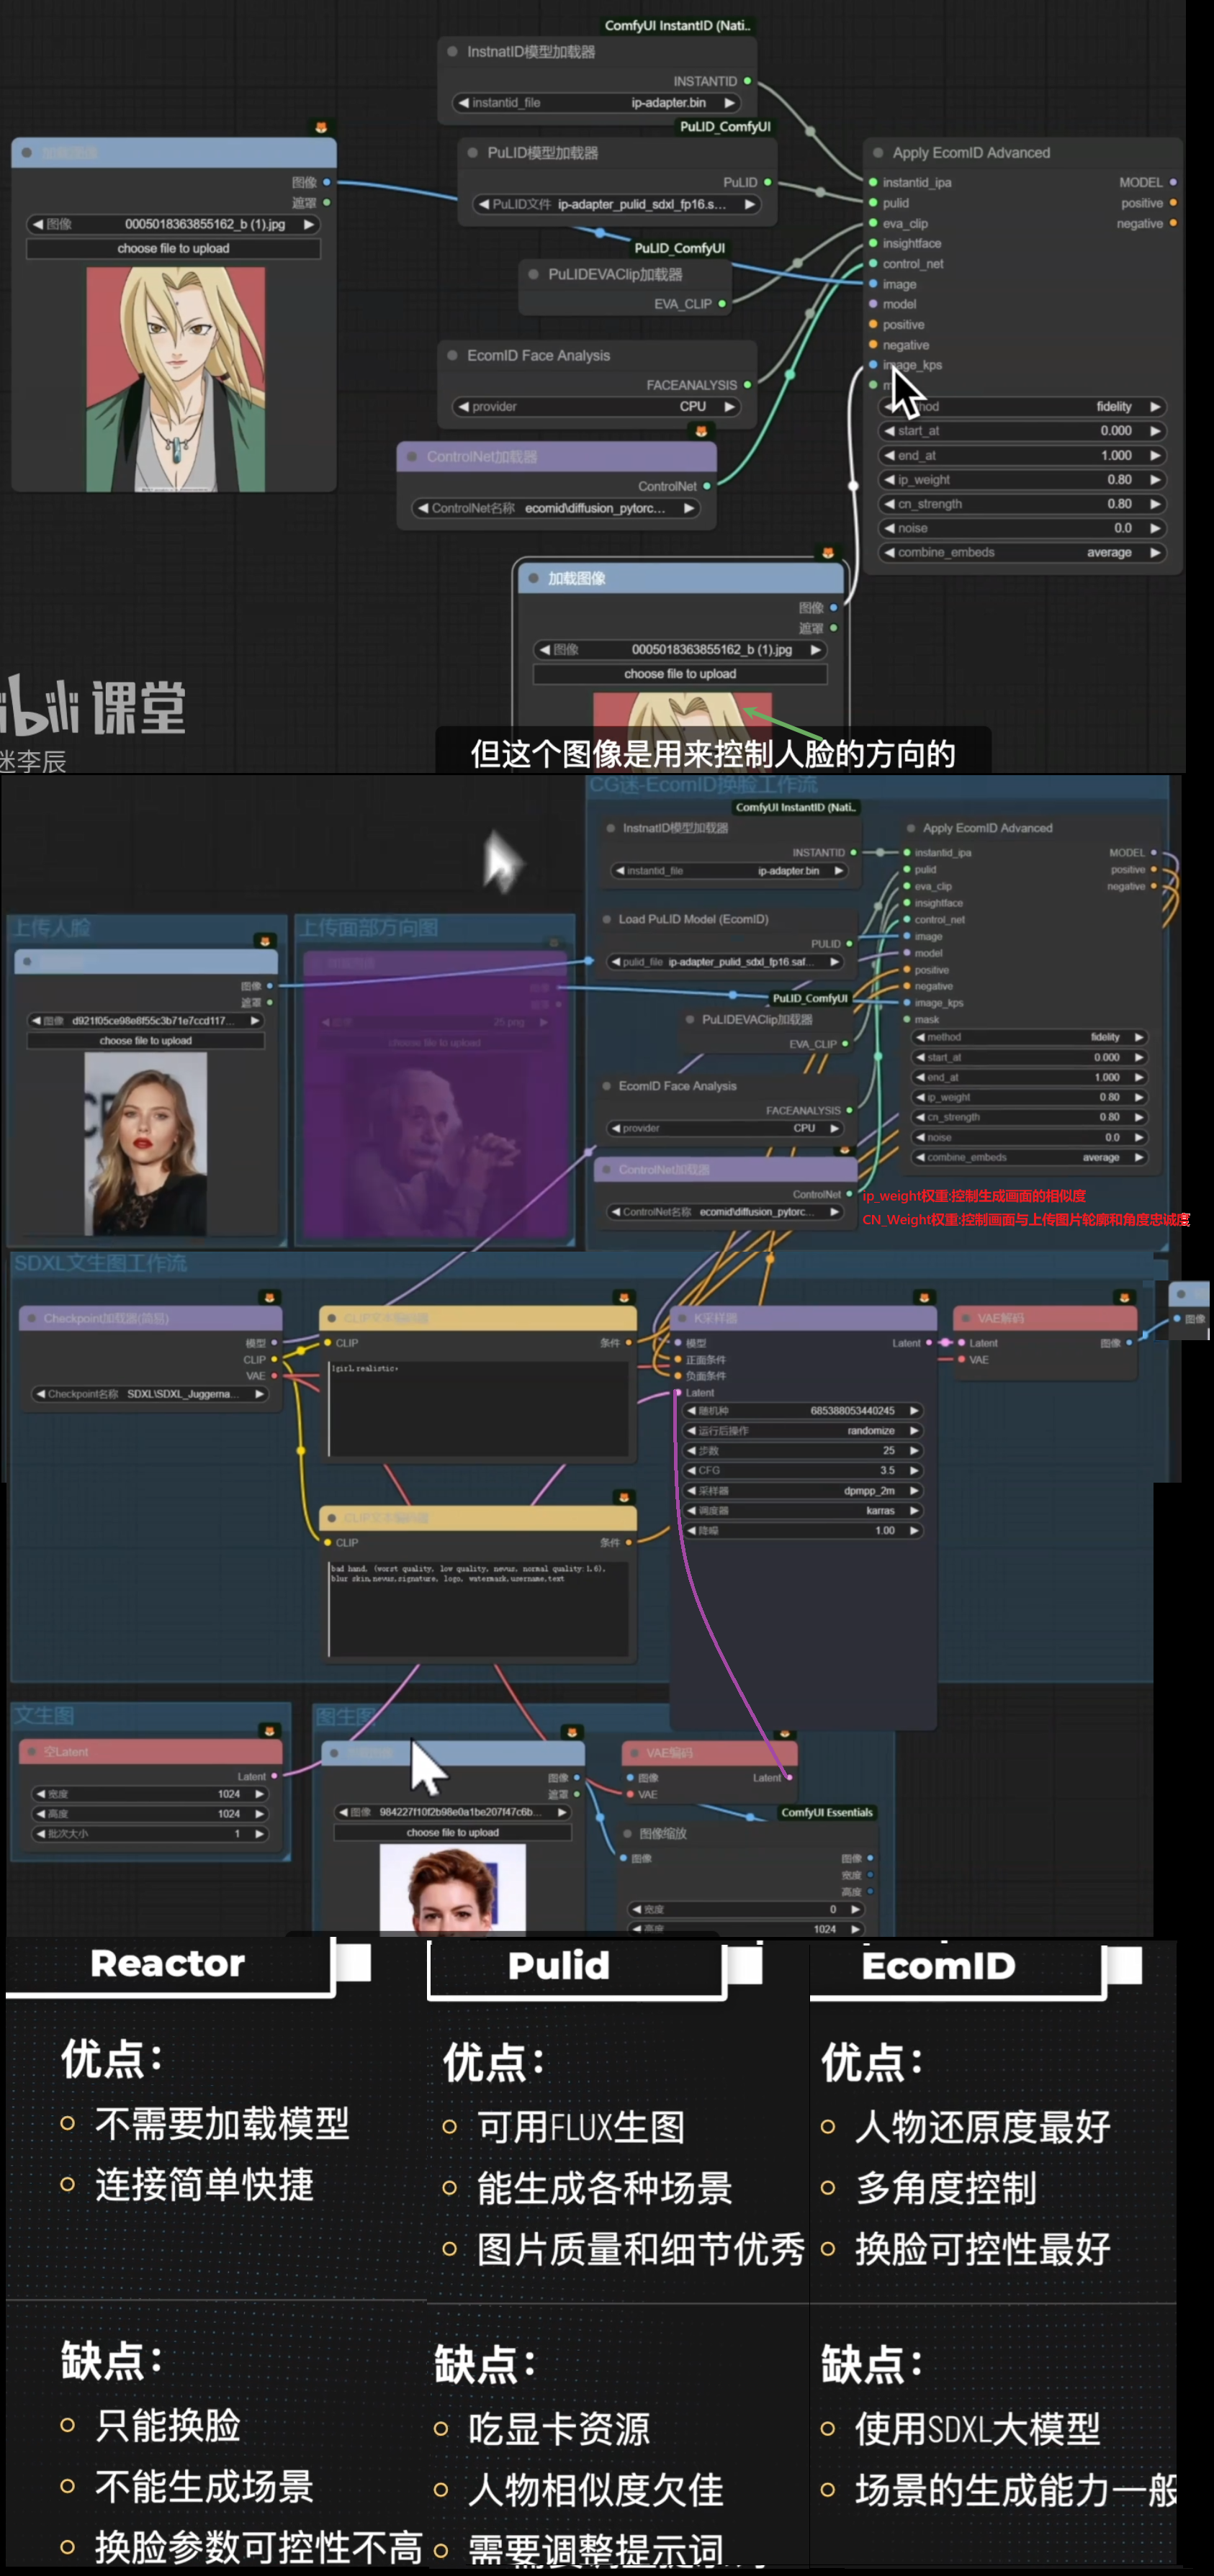
Reactor、Pulid、EcomID换脸插件对比

Reactor

ReActor Node for ComfyUI下载此插件
1、face_yolov8m.pt,放到ComfyUImodels\ultralytics\bbox里面
2、codeformer、GFPGAN脸部修复模型,放到comfyui目录的models\facerestore_models里面
3、inswapper_128.onnx換脸模型,放置到ComfyUNmodels\insightface里面

FLUX Pulid搭配人物指定动作和场景

Alibaba-EcomID

由于需要搭配instantID使用。不能使用FLUX 只能使用SDXL大模型

https://github.com/adityacaturputra/SDXL_EcomlD_ComfyUl下载插件
EcomID同样要调用Pulid节点
1、pulid_sdxl_fp16.safetensors模型,放到ComfyUl/models/pulid/里面
(没有的话手动新建一个文件夹)
2、AntelopeV2系列5个模型,放到ComfyUl/models/insightface/models/antelopev2里面
3、EVA02-CLIP-L-14-336,放到ComfyUI/models/clip里面
(放置未必有效,首次运行开启魔法网络)
4、ip-adapter.bin放置到ComfyUI/models/instantid里面
5、diffusion_pytorch_model.safetensors模型放到ComfyUl/models/controlnet/里面

真人照片卡通风格化转绘

普通

Controlnet + FaceID + 提示词反推 转绘

SDXL + instantID

FLUX超强万物迁移工作流

安装Layer Style类似于ps有图层、滤镜、颜色等节点

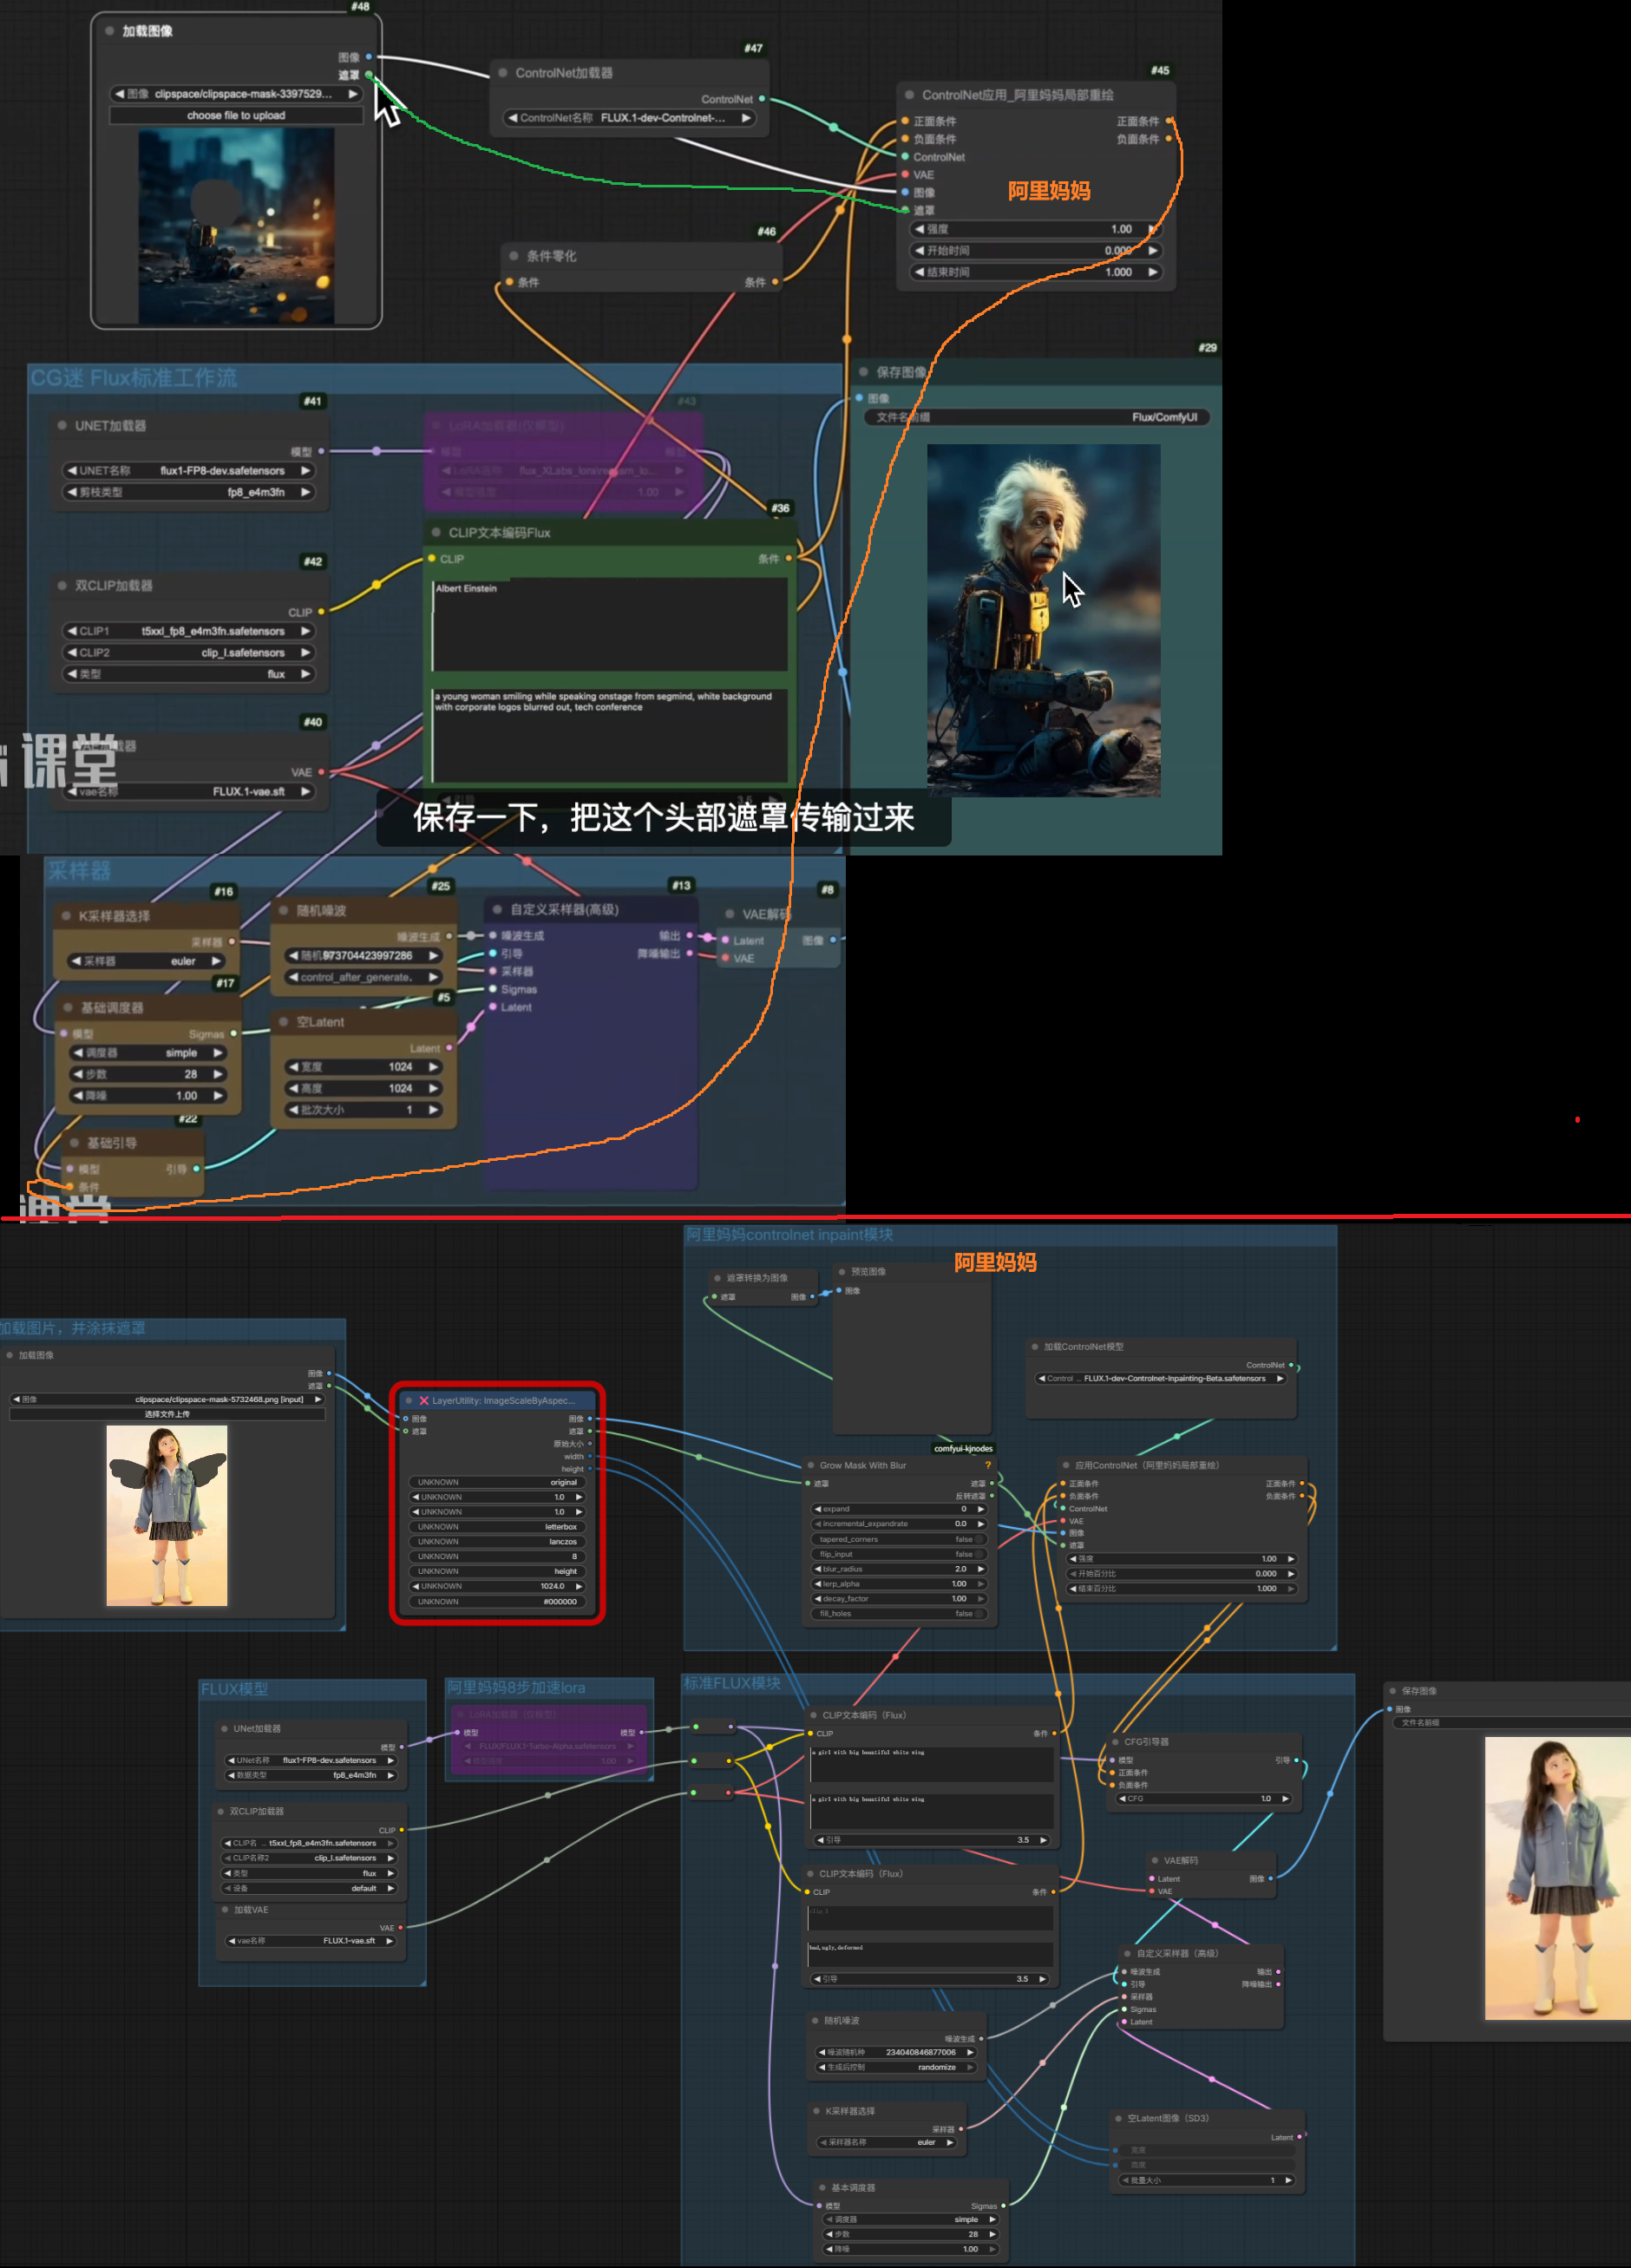
FLUX超强重绘万物 修手神器(阿里妈妈)

这里需要下载alimama-creative/FLUX.1-dev-Controlnet-Inpainting-Bata中的diffusion_pytorch_model.safetensors 下完记得改名成:FLUX.1-dev-Controlnet-Inpainting-Bata

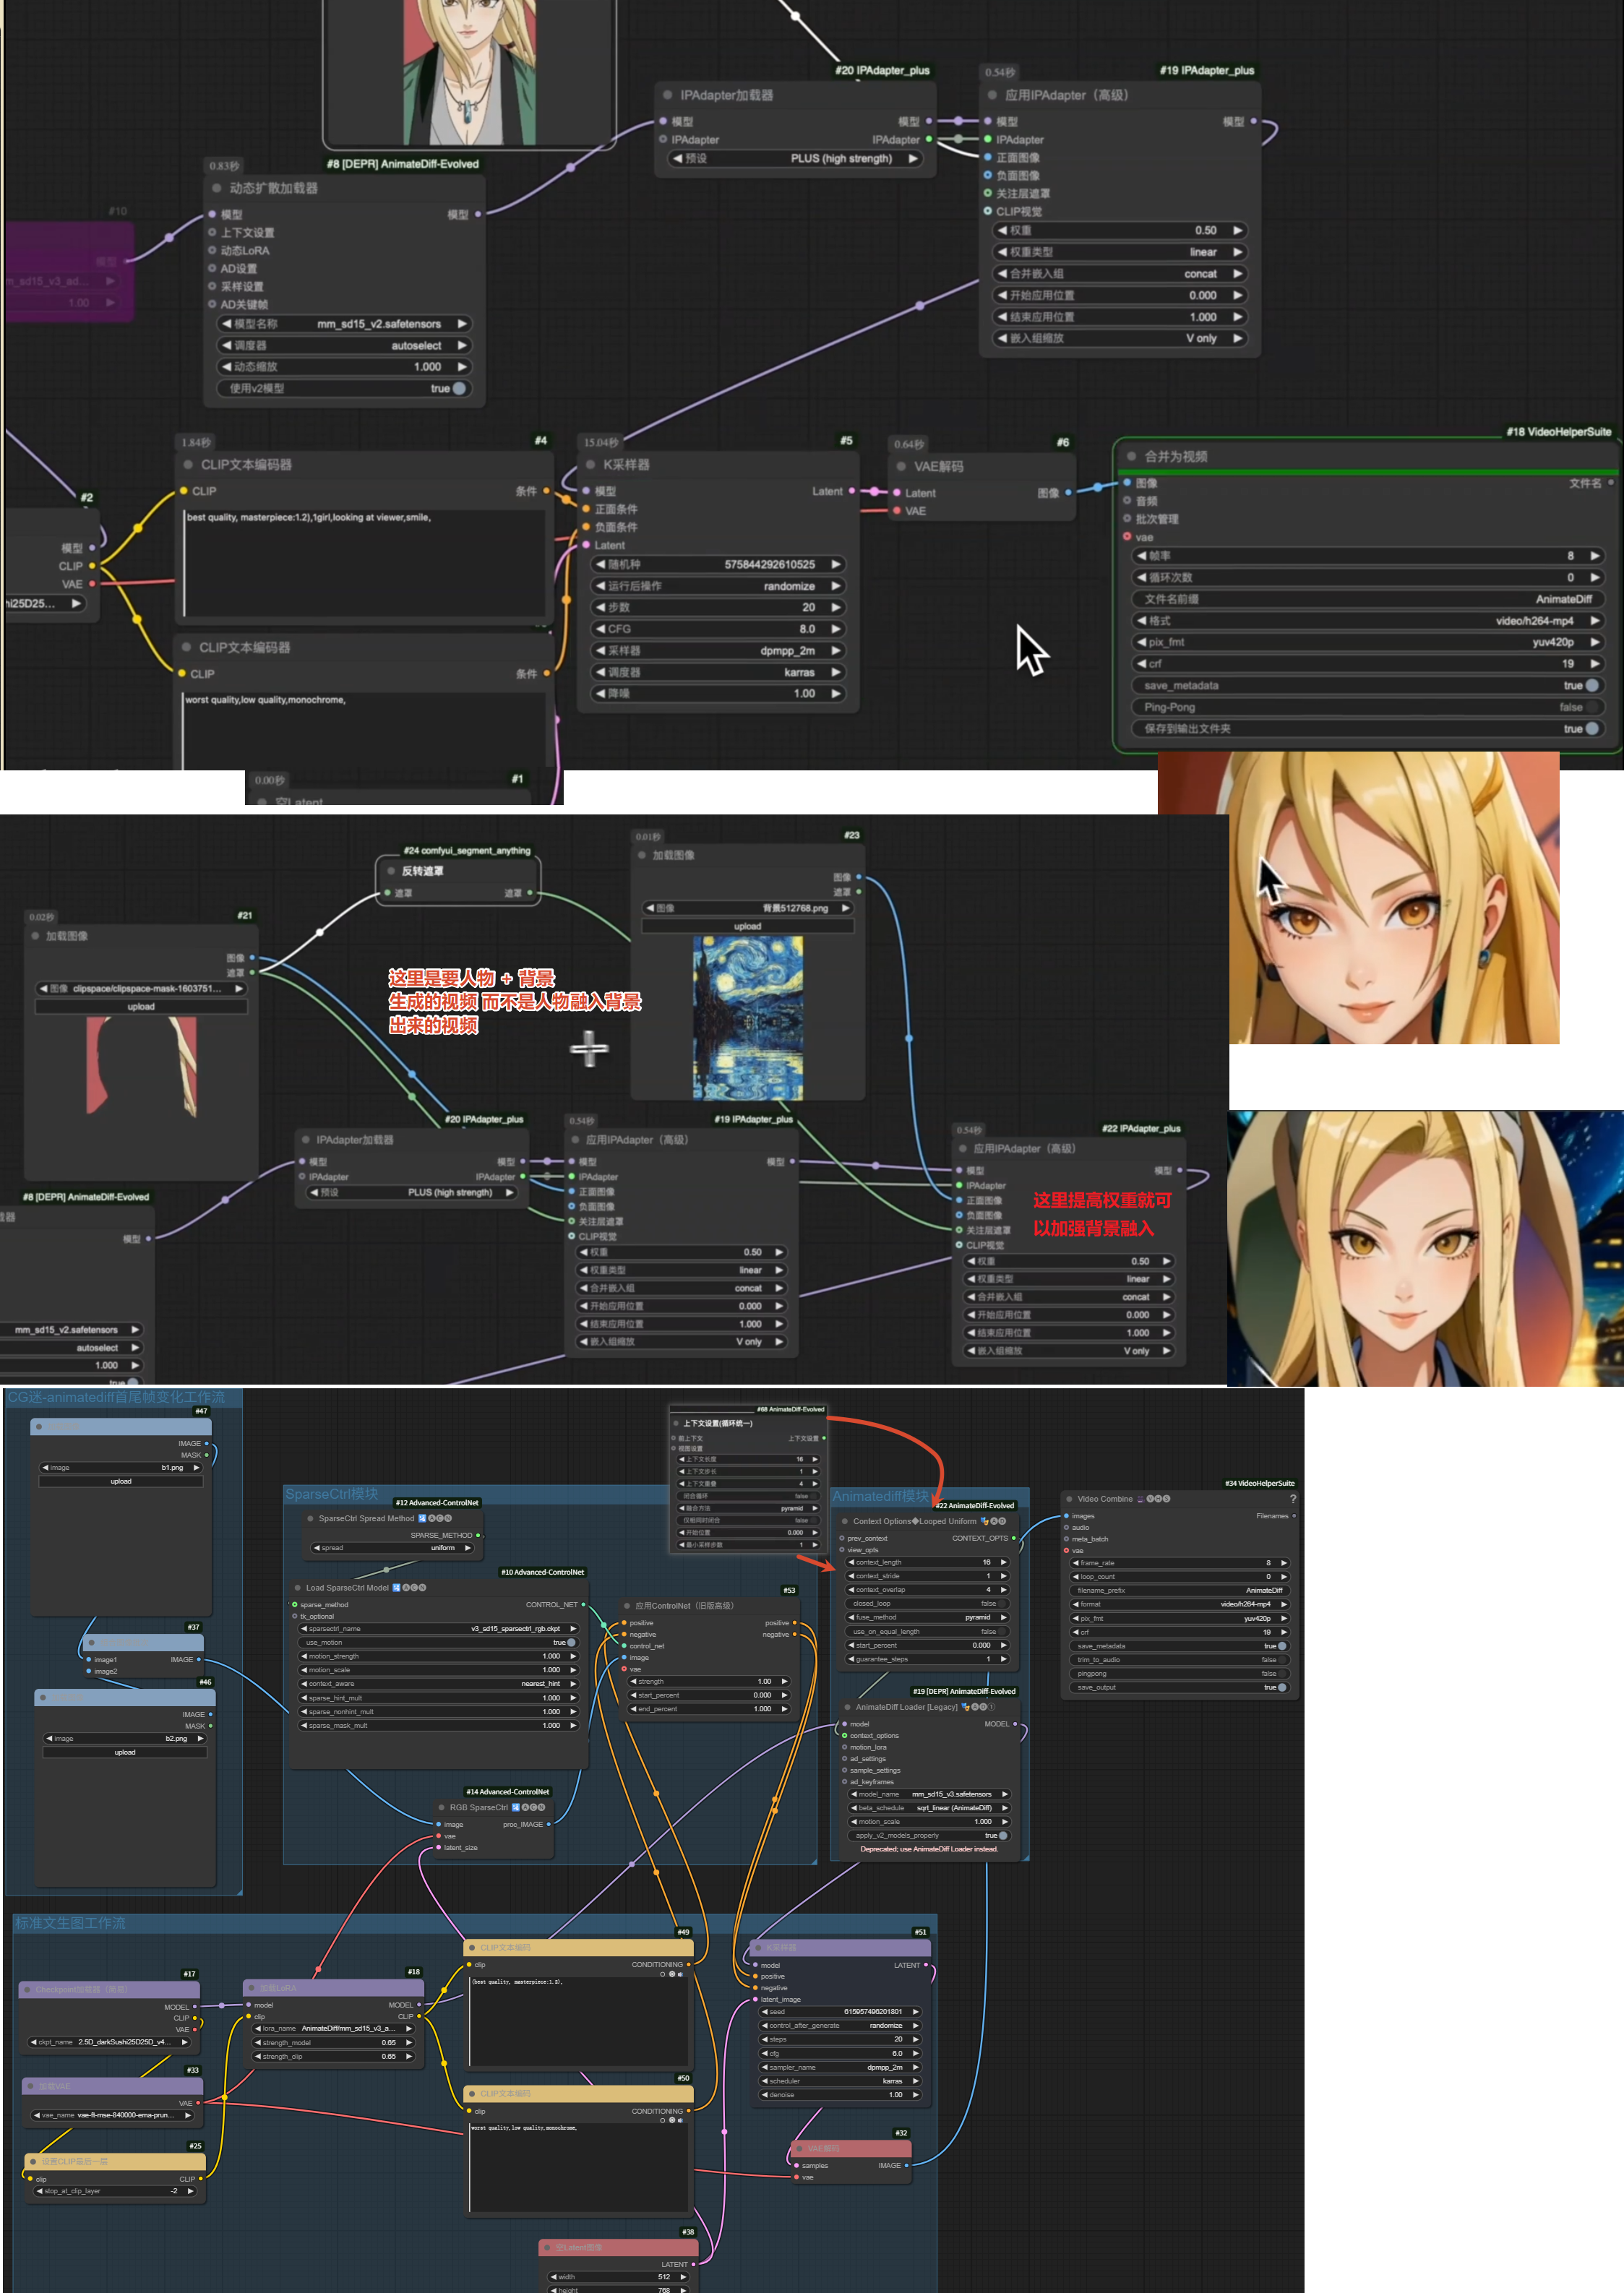
AnimateDiff首尾帧丝滑可控动画工作流

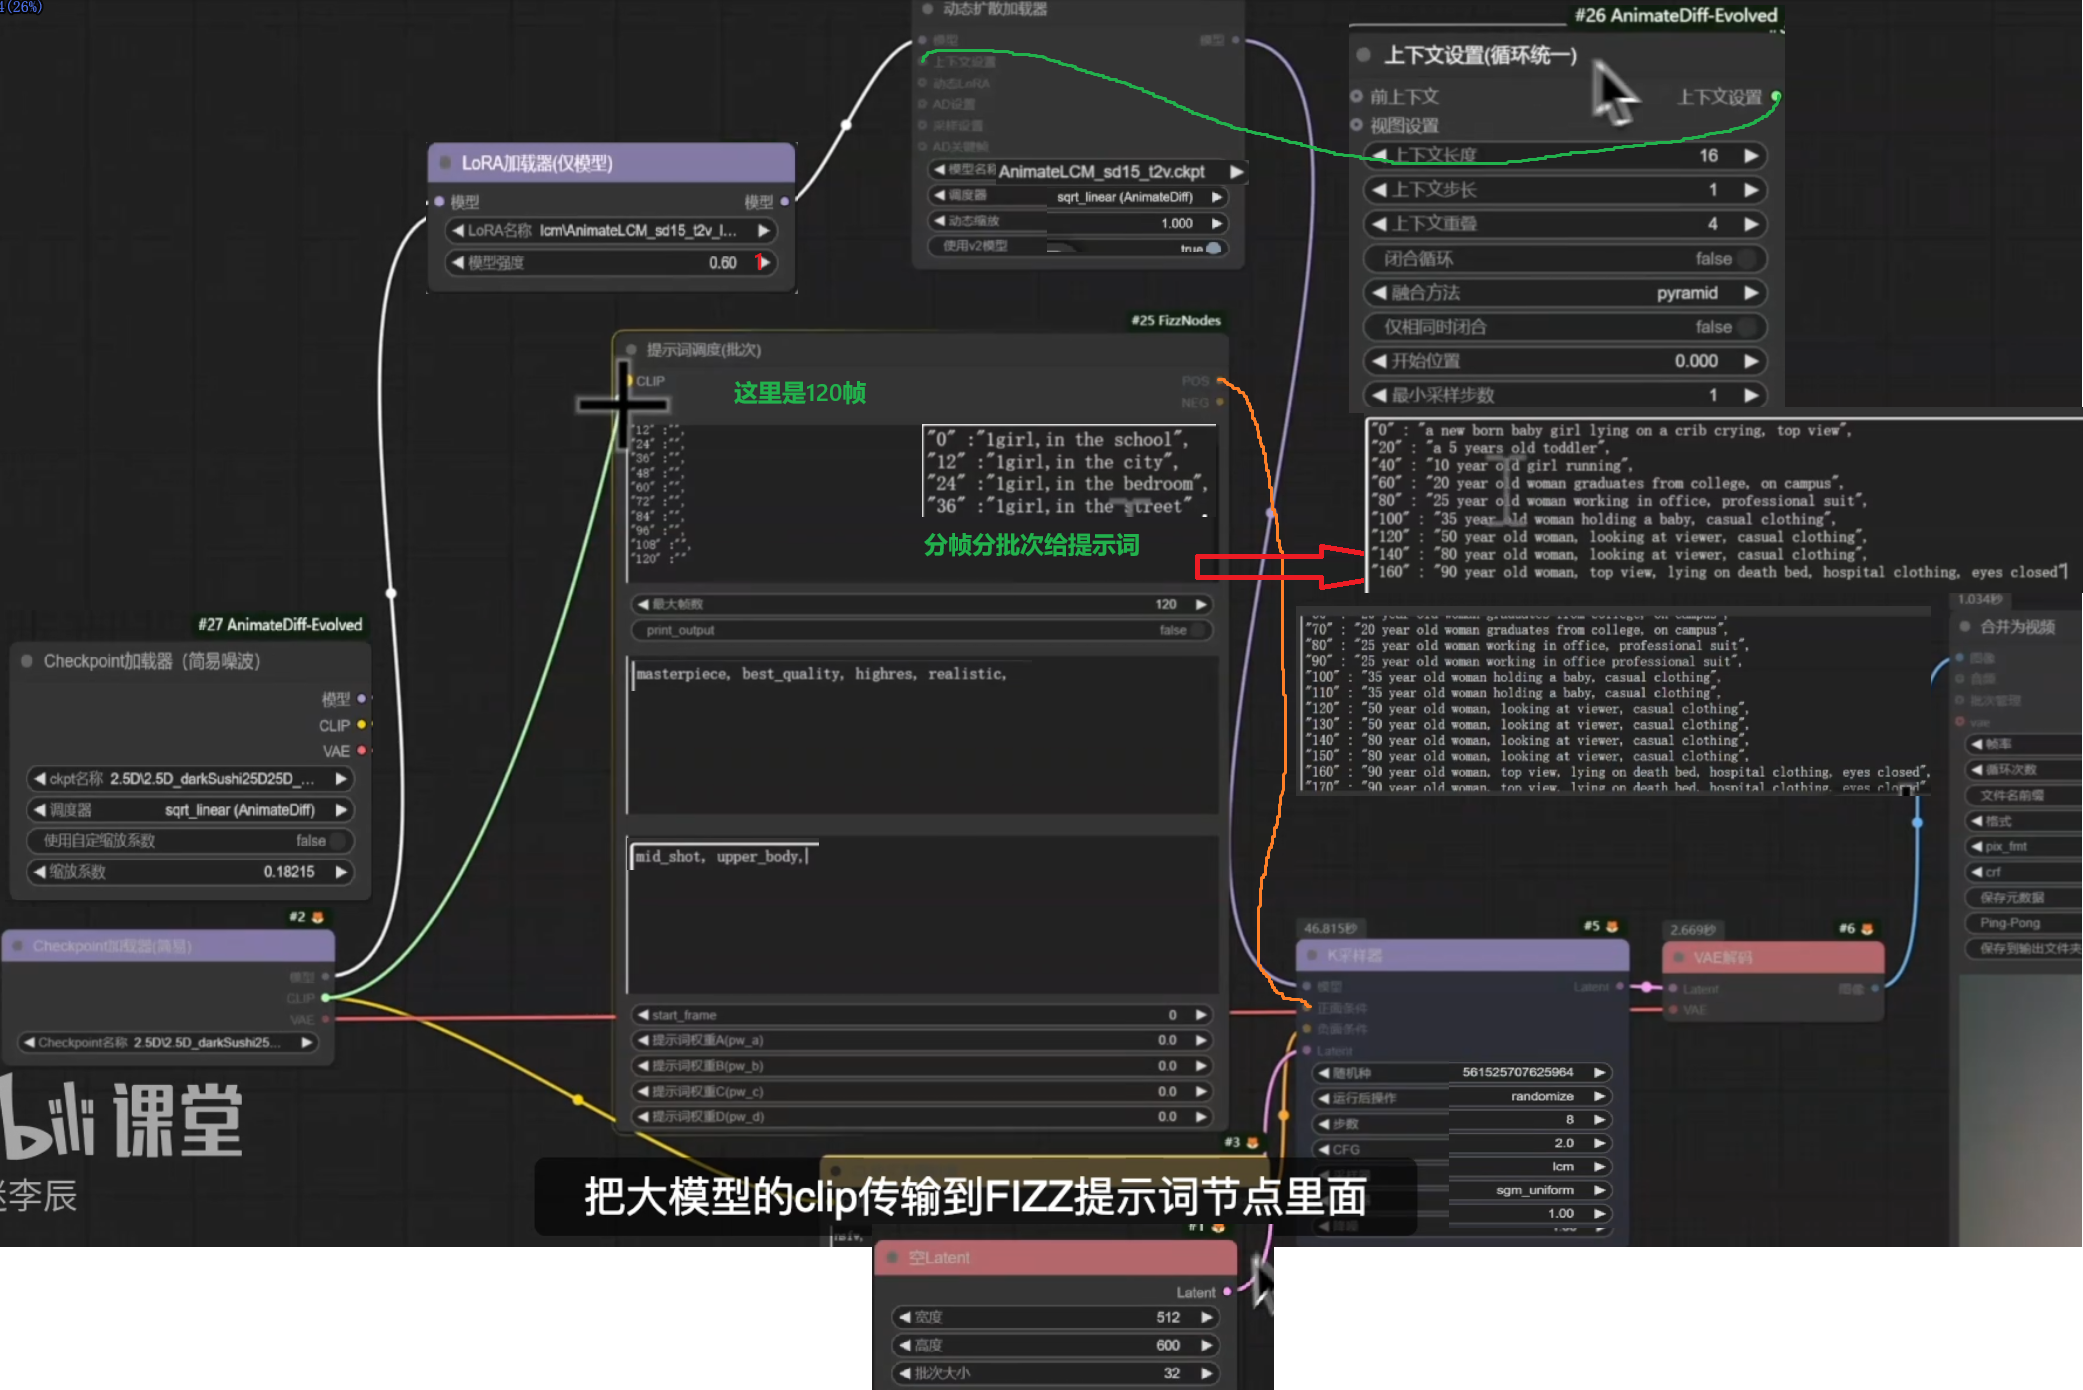
AnimateDiff长视频生成与LCM加速

下载FizzNodes插件 → 提示词调度(批次)
要应用长视频首先要明确指出 第几帧要生成怎么样的画面
LCM是对渲染加速的!!

AnimateLCM_sd15_t2v.ckpt放到comfyui\custom_nodes\ComfyUI-AnimateDiff-Evolved\models里面
AnimateLCM_sd15_t2v_lora.safetensors放到comfyui\models\loras里面

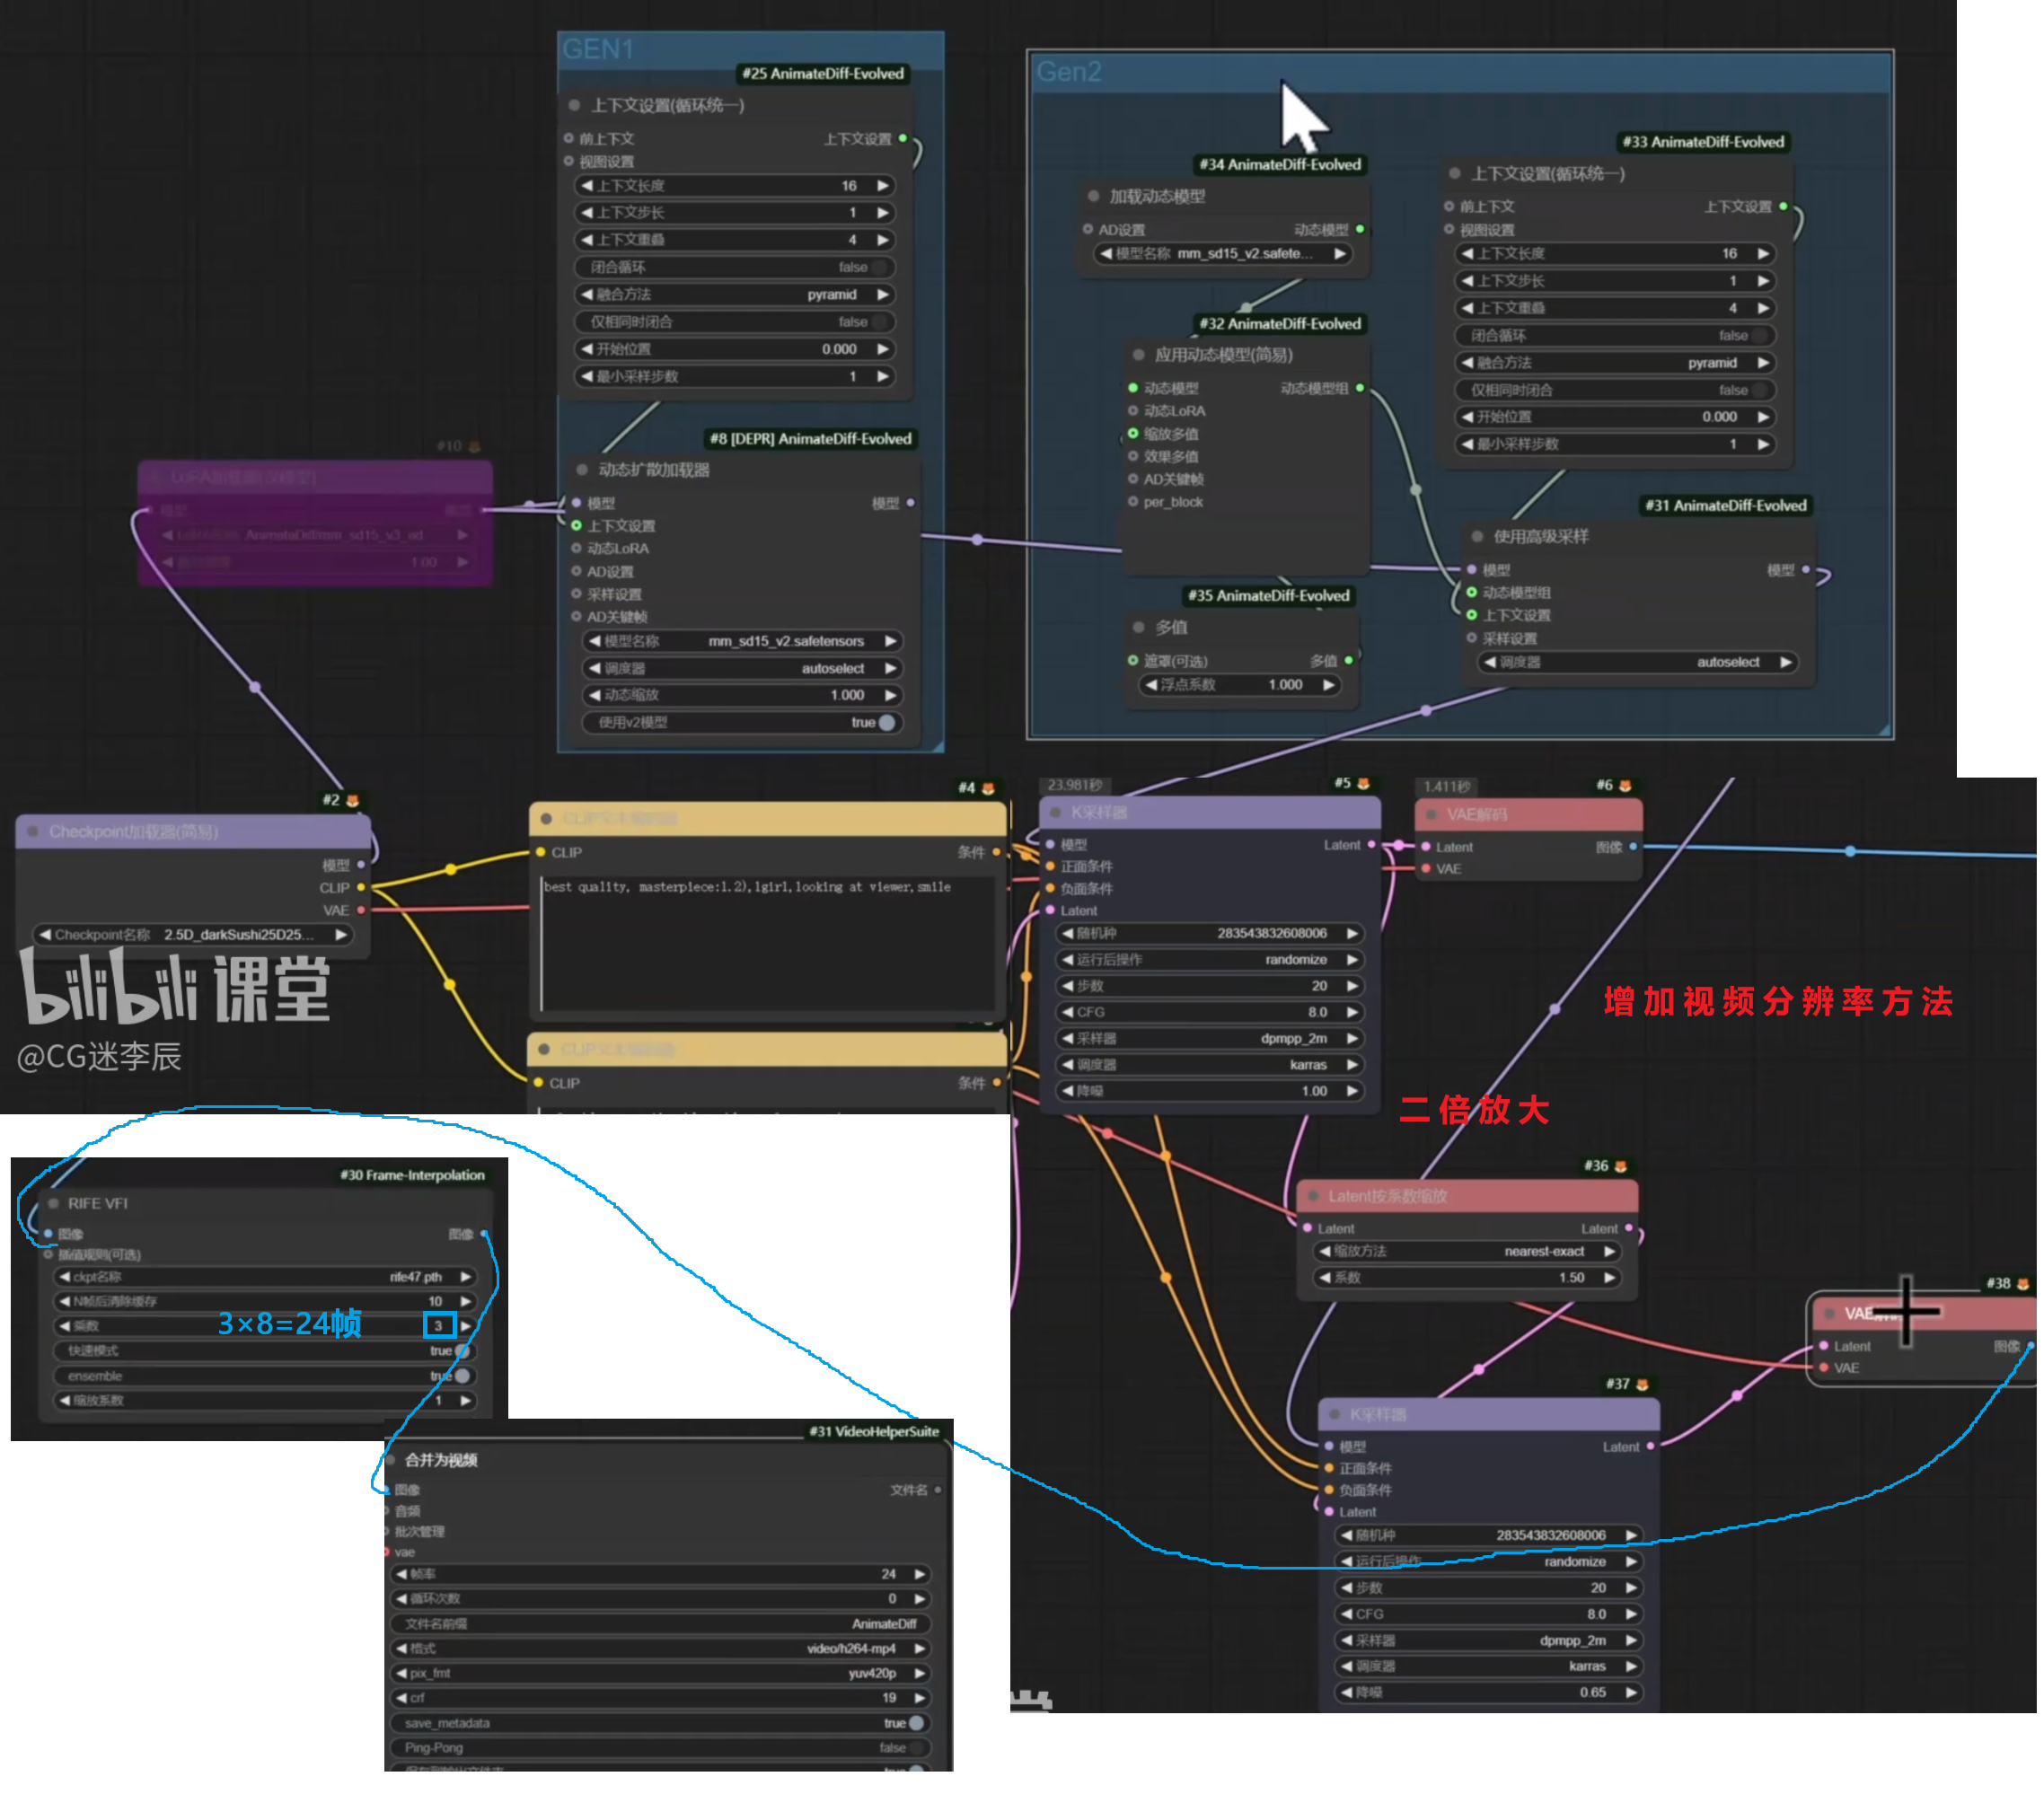
AnimateDiff高级采样与补帧输出优化

增加视频分辨率:用二次放大
增加视频清晰度:用ComfyUI Frame Interpolation → RIFE VFI节点

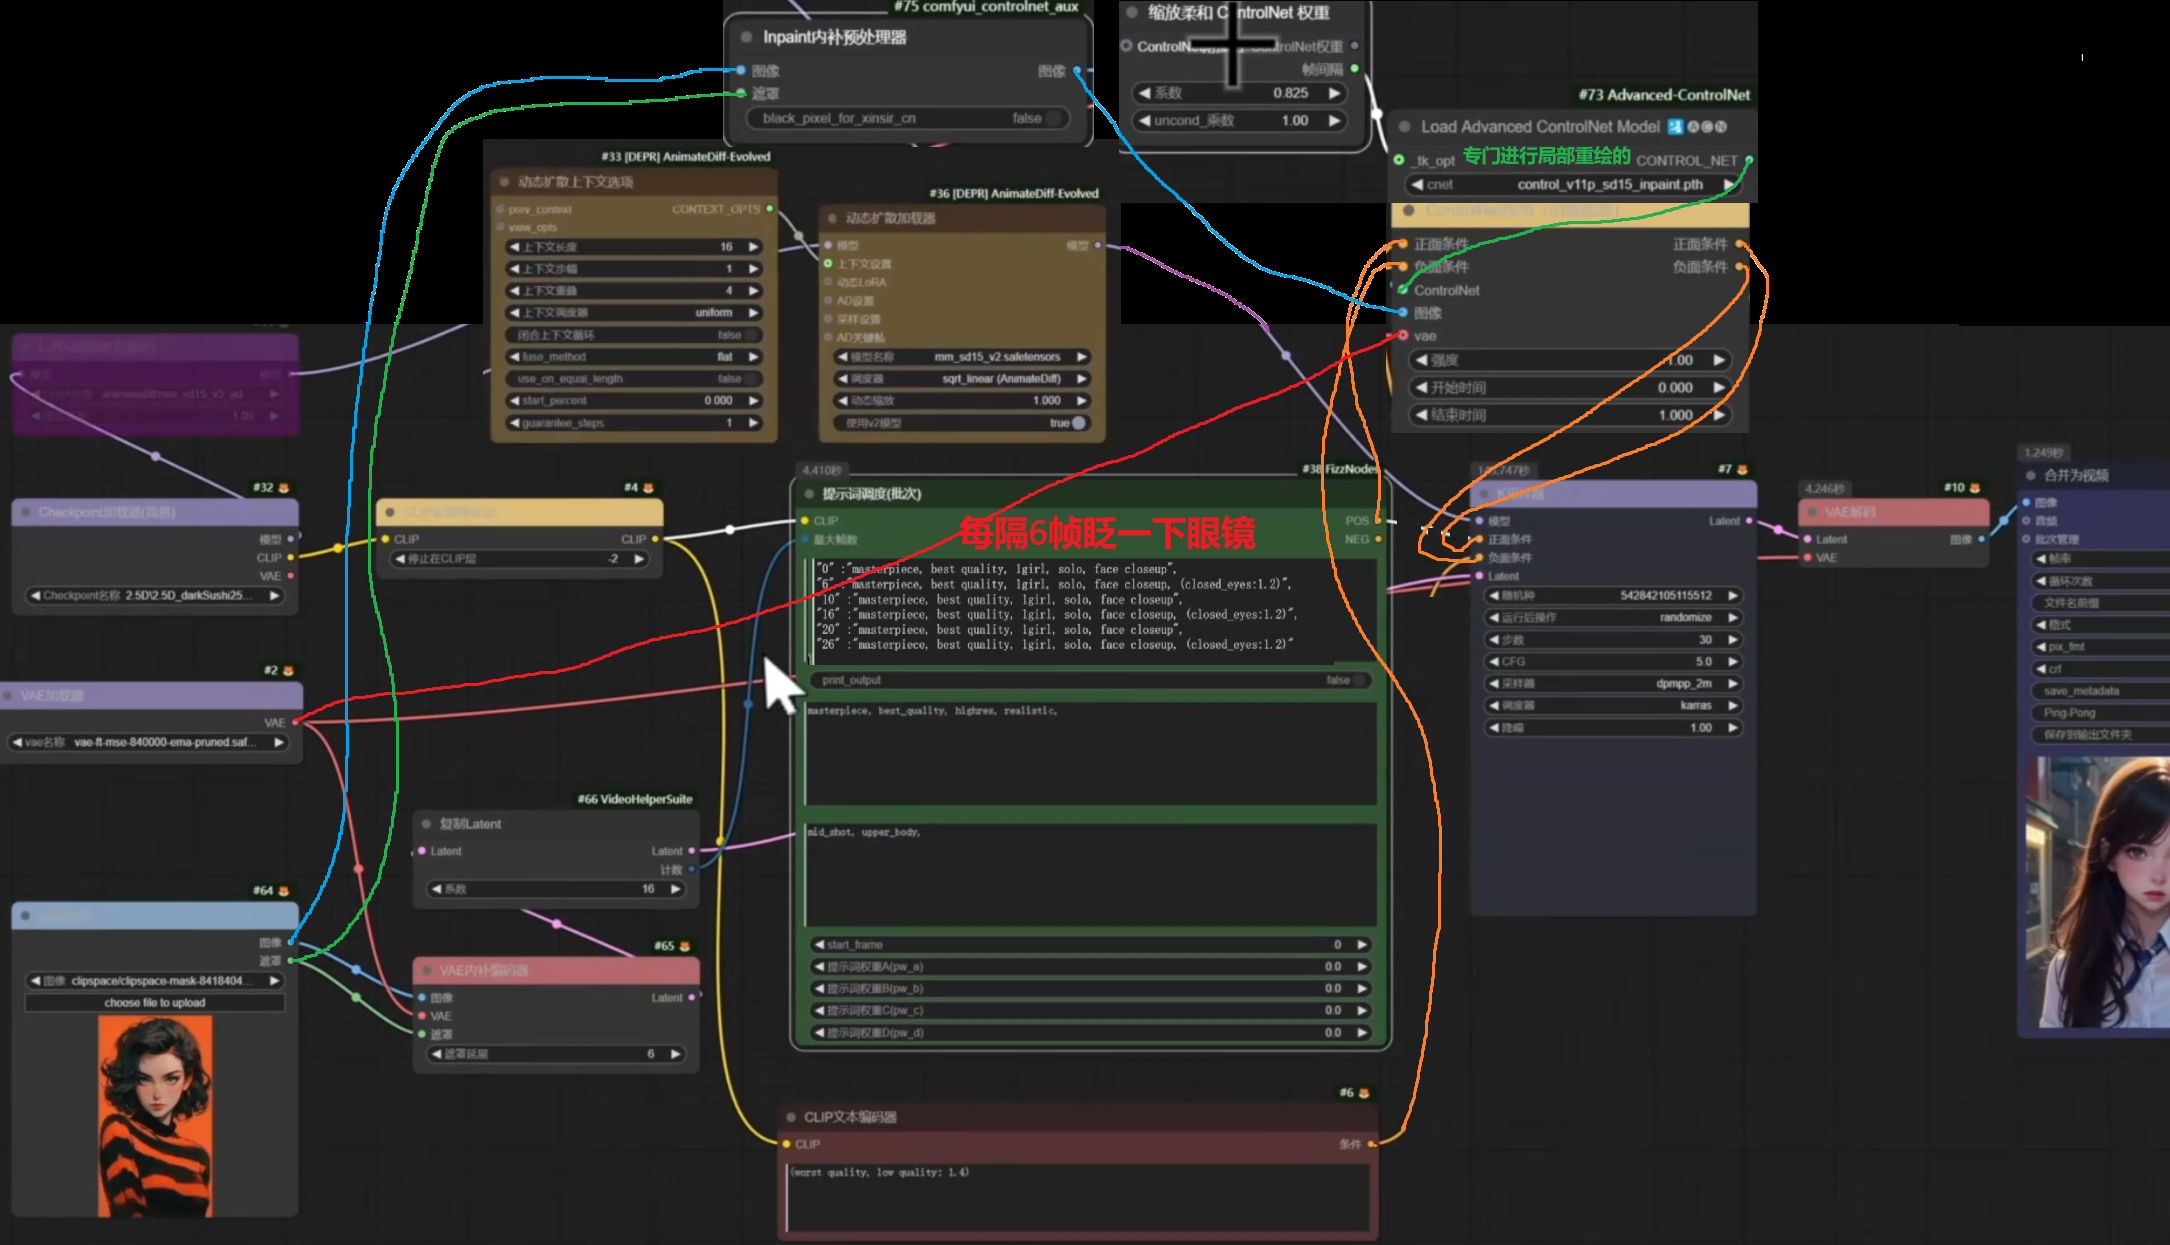
AnimateDiff局部控制指定区域动效

重点是:局部重绘

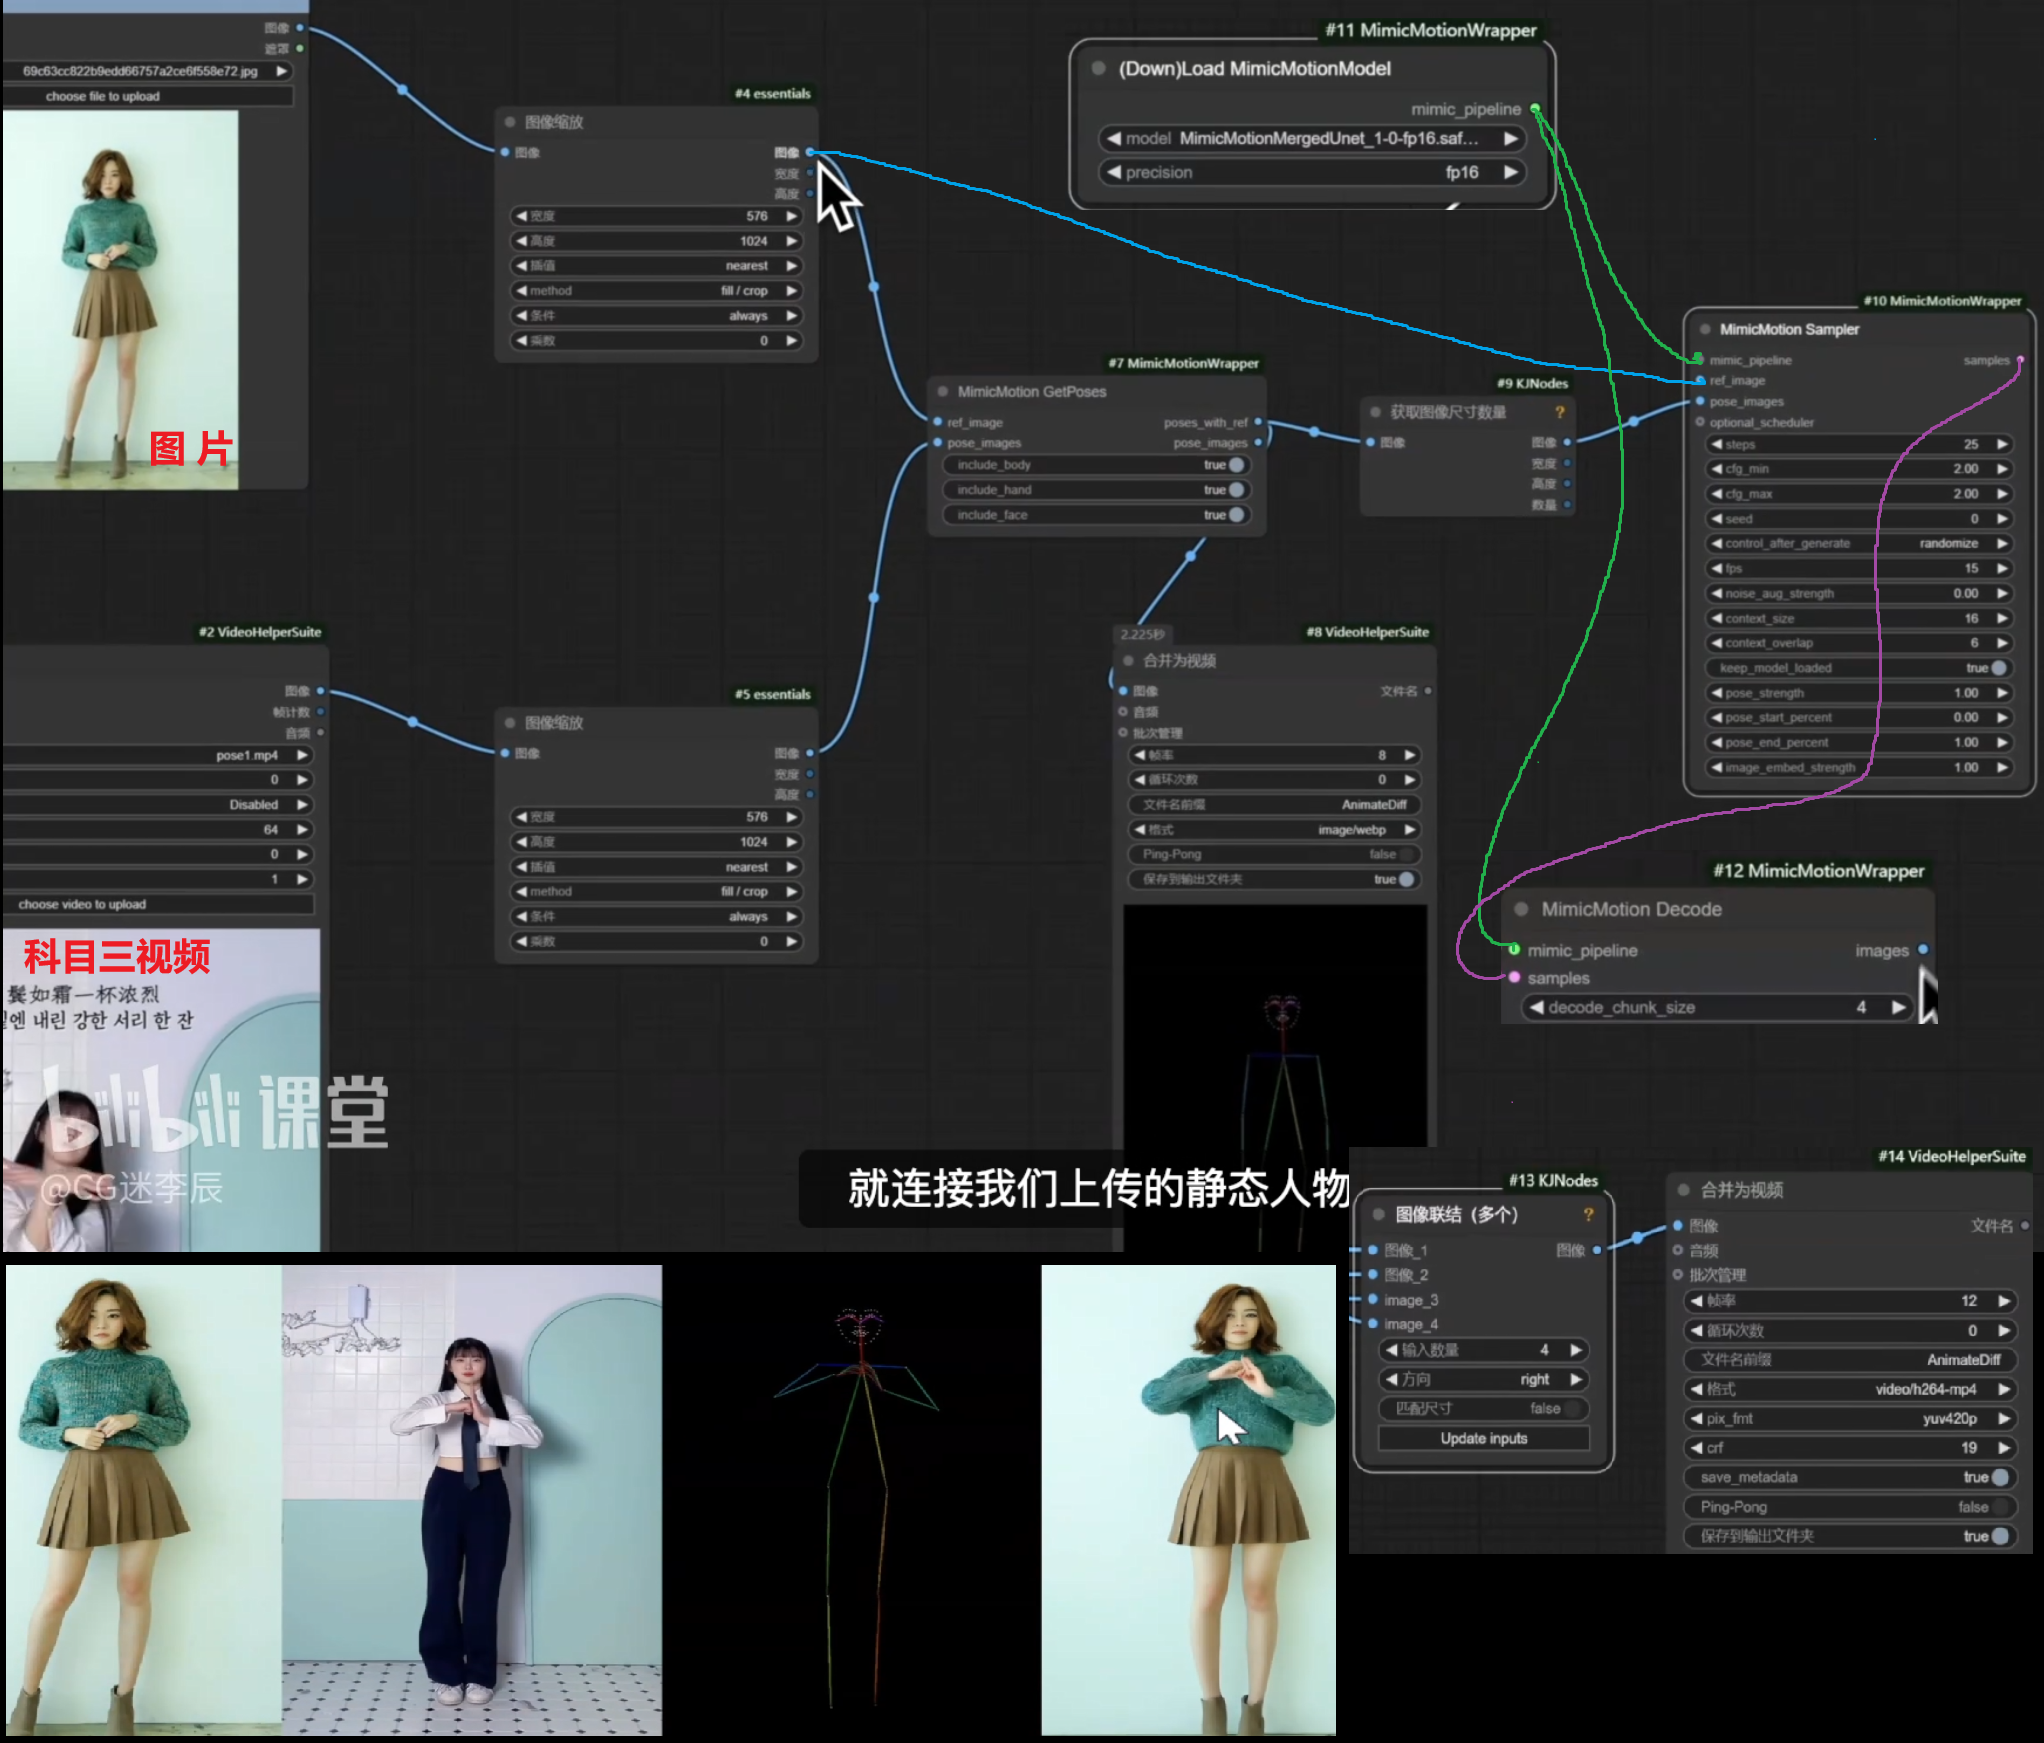
指定动作,视频捕捉,骨骼动画复刻图片模仿视频跳舞

尽量手指背景清晰 手指分叉的
下载插件MimicMotionWrapper + KJNodes

1、MimicMotionMergedUnet大模型,放到ComfyU\models\mimicmotion里面
2、DWPose姿态文件夹,整个文件夹放到ComfyUl\custom_nodes\ComfyUl-MimicMotionWrapper\models里面
3、stable-video-diffusion-img2vid-xt-1-1整个文件夹放到ComfyUl\models\diffusers里面

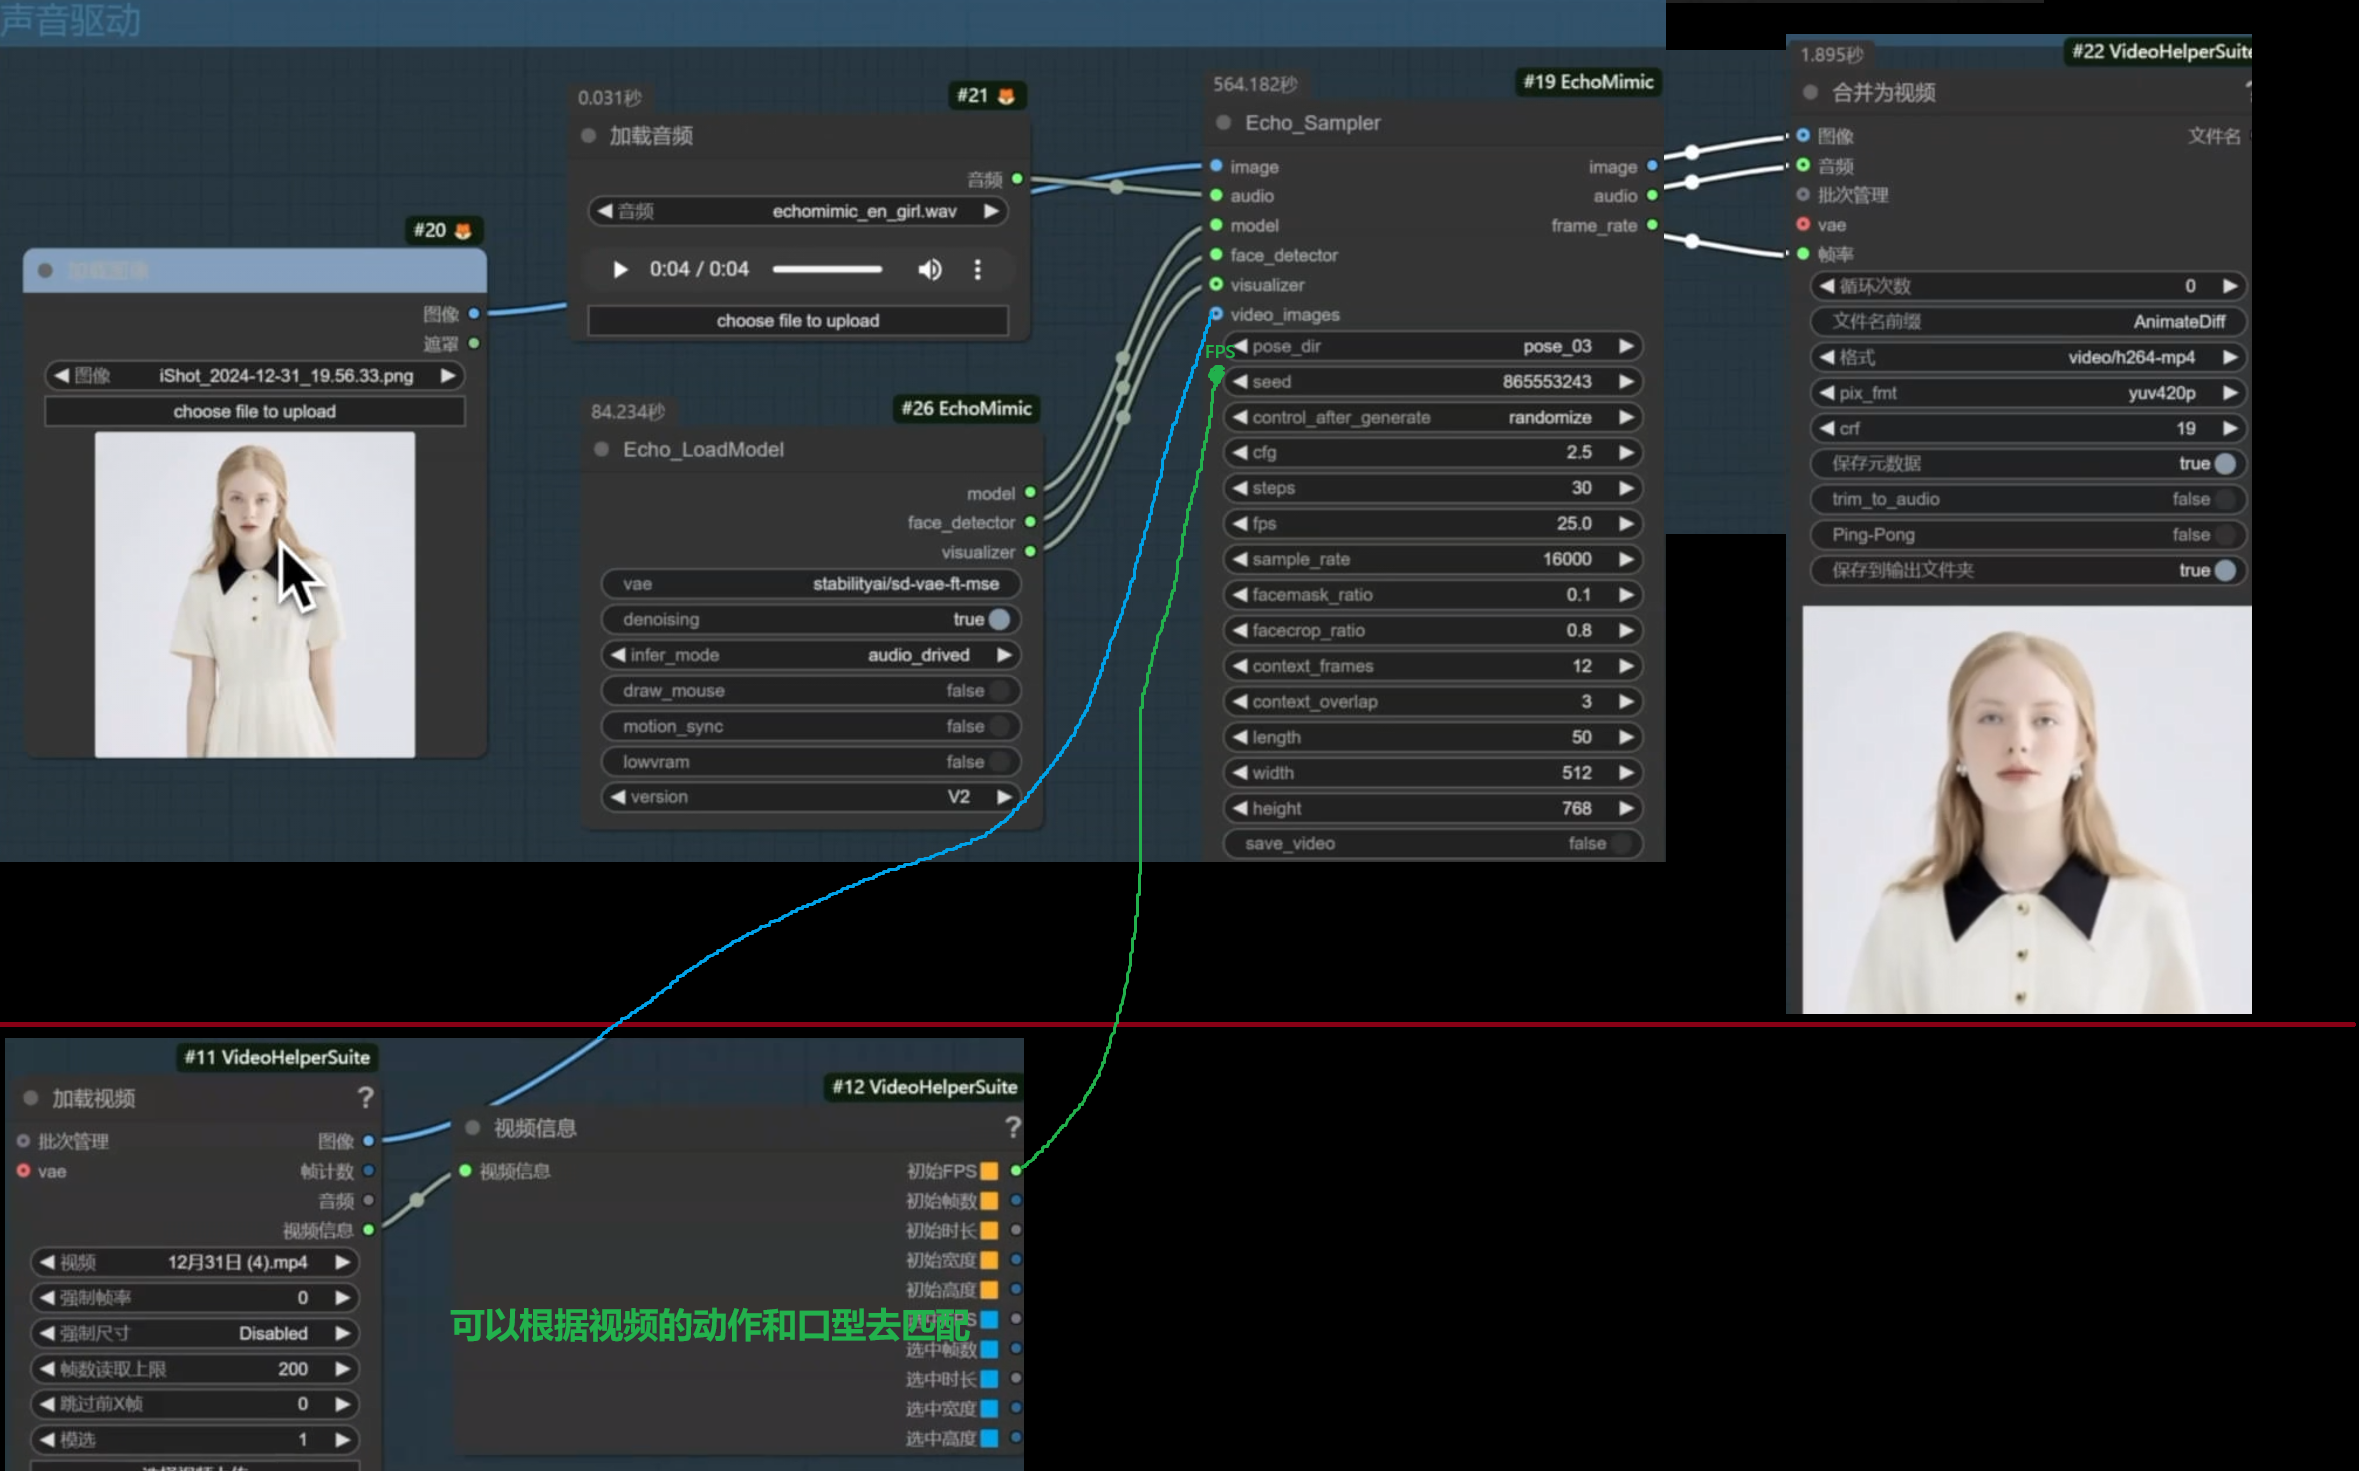
EchoMimic V2打造自己的数字人

把CG迷文件里的echo_mimic所有文件都放到ComfyUI/models/echo_mimic里面即可【42G】
尽量不要上传带手部的照片 半身照即可 干净一点的

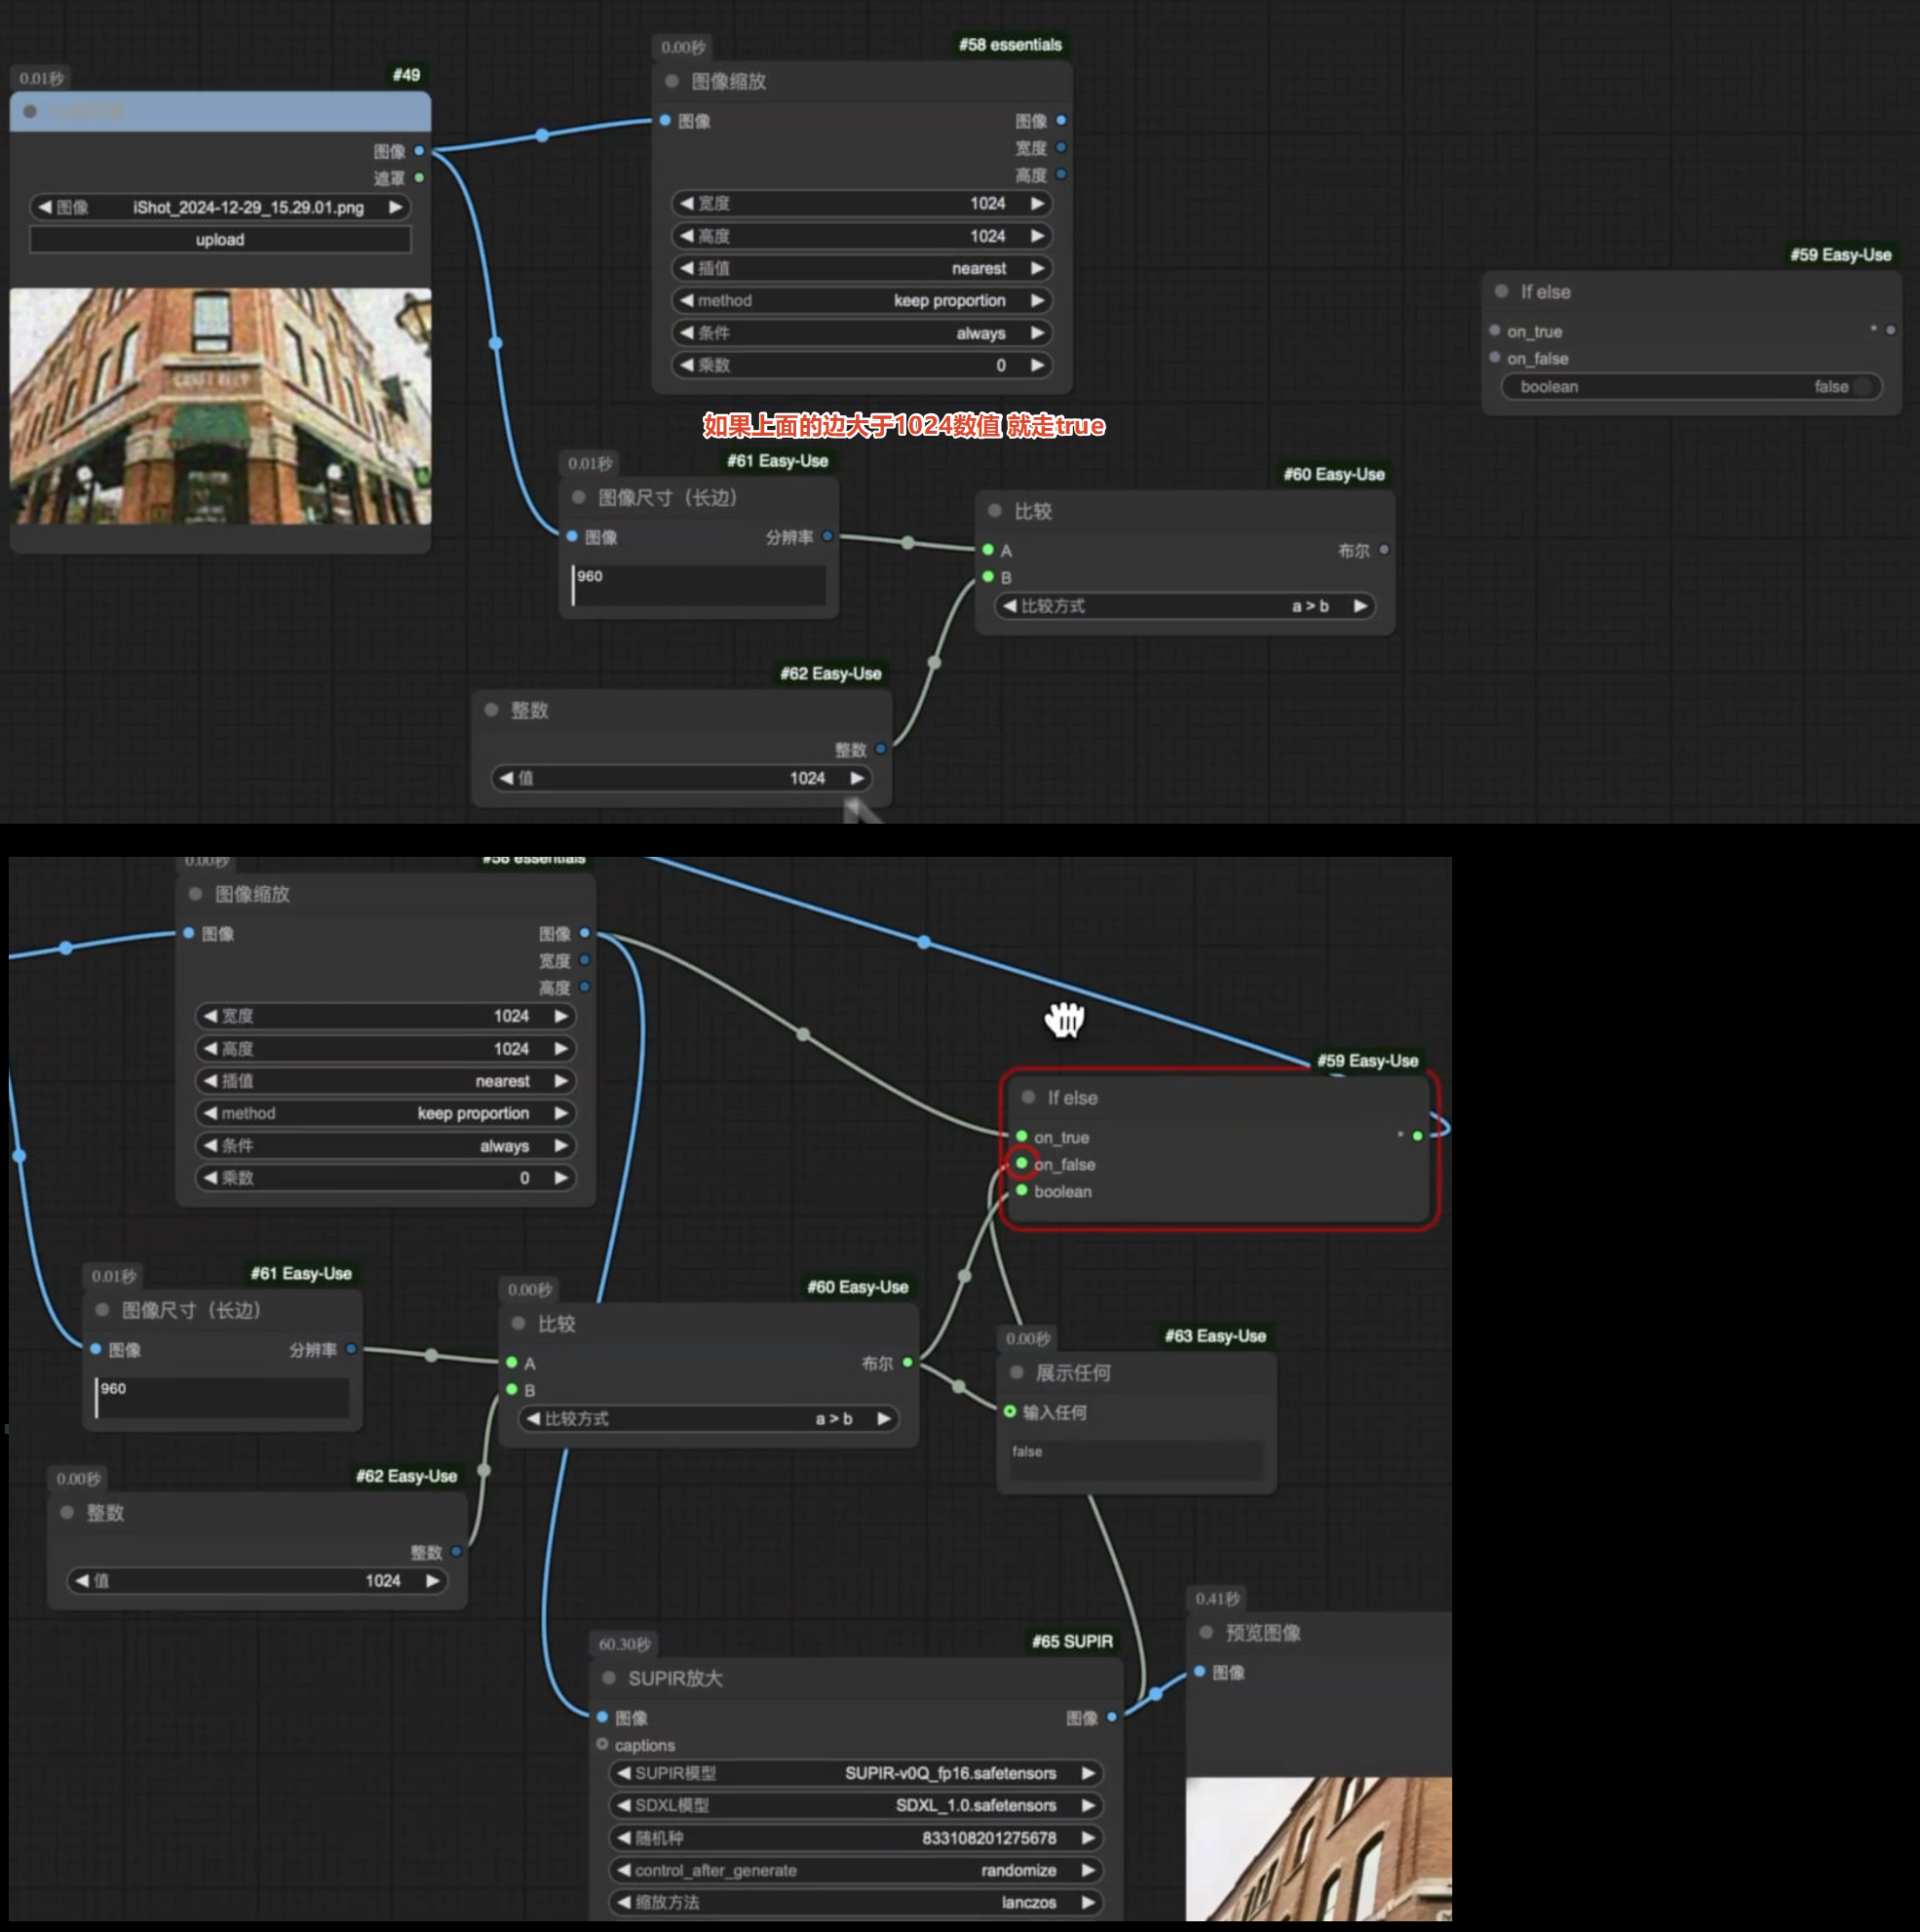
IF—else逻辑节点,让工作流配备双方案

on_true、on_false → true

Flux Upscaler高清放大洗图工作流

找jasperai/Flux.1-dev-Controlnet-Upscaler;下载diffusion_pytorch_model.safetensors后改名
Flux.1-dev-Controlnet-Upscaler 模型放到 ComfyUl/models/controlnet目录下

搞个ControlNet + 加载器,加载器里选择下载的模型即可

完结撒花★,°:.☆( ̄▽ ̄)/$:.°★ 。 2026.4.3 00:23    广州白云沙涌北三巷

阅读全文

go

2026/3/4

你核心想知道的是:Go 里的 Channel(通道)到底有啥用、实际开发中怎么落地?我用新手能懂的话讲透 ——Channel 是 Go 实现 goroutine(协程)间通信的核心工具,也是 “并发安全” 的关键,实际开发中只要写并发逻辑(比如后端接口、任务池、消息队列),几乎必用 Channel。

1. 先给核心结论

  • Channel 的本质:goroutine 之间的 “管道”,专门用来安全地传递数据(比如数字、结构体、指针),同时自带 “同步阻塞” 特性;
  • 核心作用:解决多 goroutine 间的 “通信” 和 “同步” 问题,替代其他语言的 “锁 + 共享变量”,是 Go“不要通过共享内存通信,要通过通信共享内存” 哲学的核心;
  • 使用频率:极高 —— 后端开发中处理并发请求、异步任务、限流、消息传递等场景,Channel 都是标配。

2. 先搞懂:为什么需要 Channel?(没有 Channel 会怎样?)

先看一个 “不用 Channel” 的并发问题,对比就能懂 Channel 的价值:

❶ 无 Channel:共享变量 + 锁(麻烦、易出错)

多个 goroutine 修改同一个变量,必须加锁,否则会出现数据竞争:

package main

import (
    "fmt"
    "sync"
)

var count int
var lock sync.Mutex // 必须加锁

func add(wg *sync.WaitGroup) {
    lock.Lock()   // 加锁
    count++
    lock.Unlock() // 解锁
    wg.Done()
}

func main() {
    var wg sync.WaitGroup
    for i := 0; i < 1000; i++ {
        wg.Add(1)
        go add(&wg)
    }
    wg.Wait()
    fmt.Println(count) // 输出1000(加锁才正确)
}

这种写法不仅要手动管理锁,还容易因漏解锁 / 锁顺序出错导致死锁。

❷ 有 Channel:通信替代共享内存(简洁、安全)

用 Channel 传递数据,天然并发安全,无需加锁:

package main

import "fmt"

func add(ch chan int, wg *sync.WaitGroup) {
    ch <- 1 // 往通道里发数据
    wg.Done()
}

func main() {
    ch := make(chan int, 1000)
    var wg sync.WaitGroup

    // 启动1000个goroutine发数据
    for i := 0; i < 1000; i++ {
        wg.Add(1)
        go add(ch, &wg)
    }
    wg.Wait()
    close(ch) // 发完数据关闭通道

    // 统计总数
    count := 0
    for v := range ch { // 遍历通道接收数据
        count += v
    }
    fmt.Println(count) // 输出1000(天然安全)
}

Channel 帮我们规避了锁的所有坑,代码更简洁、更安全。

3. Channel 的核心用途(实际开发中都这么用)

场景 1:goroutine 间传递数据(最基础)

比如后端接口中,主 goroutine 处理请求,子 goroutine 查数据库,用 Channel 返回结果:

package main

import (
    "fmt"
    "time"
)

// 模拟查数据库
func queryDB(id int, ch chan string) {
    time.Sleep(100 * time.Millisecond) // 模拟耗时
    ch <- fmt.Sprintf("用户%d的信息", id) // 把结果发回通道
}

func main() {
    ch := make(chan string)
    // 启动goroutine异步查库
    go queryDB(100, ch)

    // 主goroutine做其他事(比如处理请求参数)
    fmt.Println("处理其他逻辑...")

    // 接收数据库查询结果(阻塞直到有数据)
    res := <-ch
    fmt.Println("查询结果:", res) // 输出:查询结果:用户100的信息
    close(ch)
}

场景 2:控制并发数(后端高频)

比如接口限流、任务池控制最大并发量(避免打满 CPU / 数据库):

package main

import (
    "fmt"
    "sync"
    "time"
)

func task(id int, ch chan struct{}, wg *sync.WaitGroup) {
    defer wg.Done()
    ch <- struct{}{} // 占用一个并发位(空结构体不占内存)
    defer func() { <-ch }() // 释放并发位

    // 模拟任务耗时
    time.Sleep(500 * time.Millisecond)
    fmt.Printf("完成任务%d\n", id)
}

func main() {
    maxConcurrent := 3 // 最大并发数3
    ch := make(chan struct{}, maxConcurrent)
    var wg sync.WaitGroup

    // 启动10个任务,但最多同时执行3个
    for i := 1; i <= 10; i++ {
        wg.Add(1)
        go task(i, ch, &wg)
    }
    wg.Wait()
    close(ch)
    fmt.Println("所有任务完成")
}

这个场景在后端处理批量任务(比如批量导出、批量更新)时几乎每天都用。

场景 3:等待 goroutine 完成(替代 WaitGroup)

用带缓冲的 Channel 接收所有 goroutine 的完成信号,实现同步:

package main

import "fmt"

func worker(id int, ch chan bool) {
    fmt.Printf("工作协程%d完成\n", id)
    ch <- true // 发送完成信号
}

func main() {
    ch := make(chan bool, 5) // 5个协程,缓冲5

    // 启动5个协程
    for i := 1; i <= 5; i++ {
        go worker(i, ch)
    }

    // 等待所有协程完成
    for i := 1; i <= 5; i++ {
        <-ch // 接收完成信号,阻塞直到有数据
    }
    close(ch)
    fmt.Println("所有协程都完成了")
}

场景 4:单向通道(约束代码,更安全)

实际开发中,为了避免误操作(比如往只读通道发数据),会定义单向通道:

package main

import "fmt"

// 只写通道:只能往里面发数据
func sendData(ch chan<- int) {
    ch <- 10
    ch <- 20
    close(ch)
    // ch <- 30 // 关闭后发数据会panic
}

// 只读通道:只能从里面读数据
func readData(ch <-chan int) {
    for v := range ch {
        fmt.Println("收到数据:", v)
    }
}

func main() {
    ch := make(chan int)
    go sendData(ch)
    readData(ch)
}

这种写法能让代码意图更清晰,编译器也能帮你检查错误(比如往只读通道发数据会直接报错)。

4. Channel 的关键注意事项(避坑)

  • 必须关闭通道吗?:只有 “接收方需要遍历通道(for range)” 时才需要关,否则不用(比如只接收一次数据);关闭已关闭的通道会 panic;

  • 缓冲通道 vs 无缓冲通道

    • 无缓冲:make(chan int),发数据会阻塞直到有接收方,适合同步通信;
    • 有缓冲:make(chan int, 10),缓冲区满了才阻塞,适合异步通信;

    避免死锁

    • 单 goroutine 往无缓冲通道发数据,没有接收方 → 死锁;
    • 接收已关闭的通道 → 返回零值,不会阻塞;

    select+channel

    :后端高频用法,用于多通道监听(比如超时控制):

    // 超时控制示例
    select {
    case res := <-ch:
        fmt.Println("成功:", res)
    case <-time.After(2 * time.Second):
        fmt.Println("超时了")
    }
    

5. 总结

  1. Channel 的核心价值:实现 goroutine 间安全通信 + 同步,替代锁和共享内存,是 Go 并发编程的核心;

  2. 实际开发场景

    :

    • 基础:goroutine 间传递数据;
    • 高频:控制并发数、异步任务结果返回、超时控制;
    • 进阶:实现消息队列、任务池、限流等;
  3. 核心原则:“通信共享内存” 而非 “共享内存通信”,用 Channel 让并发代码更简洁、更安全。

简单记:只要写 Go 的并发逻辑,就用 Channel 来做 goroutine 之间的交互,这是 Go 最地道的写法


你想深入理解 Go 语言中的类型断言,我会用通俗易懂的方式帮你拆解这个知识点,结合你给出的示例讲清楚它的作用、用法和核心逻辑。

一、先搞懂:类型断言到底是干嘛的?

Go 中的接口(比如 interface{},空接口)可以存放任意类型的值,但我们拿到这个接口变量后,往往需要知道它实际存的是什么类型,并把它转回具体类型来使用 —— 这个 “拆包” 的过程就是类型断言。

你可以把空接口 interface{} 想象成一个 “万能快递箱”,能装任何东西(字符串、数字、结构体等),但开箱前你不知道里面是啥;类型断言就是 “开箱检查”:确认里面是你想要的东西(比如字符串),并把它取出来。

二、核心语法拆解

你给出的语法 value.(T) 是最常用的形式,拆解如下:

  • value:必须是接口类型的变量(比如示例中的 i interface{});
  • T:你想要转换的具体类型(比如示例中的 string);
  • 返回值:
    1. 第一个值:转换后的具体类型值(比如示例中的 str);
    2. 第二个值(ok):布尔值,true 表示断言成功,false 表示失败(类型不匹配)。

四、扩展:类型断言的常见场景

比如你有一个函数接收空接口参数,需要根据不同类型做不同处理:

func printType(v interface{}) {
    switch t := v.(type) { // 这里是 type switch,特殊的类型断言
    case string:
        fmt.Printf("这是字符串:%s\n", t)
    case int:
        fmt.Printf("这是整数:%d\n", t)
    default:
        fmt.Printf("未知类型:%T\n", t)
    }
}

func main() {
    printType("Go语言") // 输出:这是字符串:Go语言
    printType(666)      // 输出:这是整数:666
    printType(3.14)     // 输出:未知类型:float64
}

总结

  1. 类型断言的核心是把接口类型转回具体类型,语法是 value.(T);
  2. 推荐使用 val, ok := value.(T) 的安全写法,避免 panic;
  3. 空接口 interface{} 是类型断言的最常用场景,用于处理 “任意类型” 的变量。

一、为什么不直接赋值?

你觉得 “绕一圈”,是因为这个示例为了演示做了简化(故意把字符串塞进空接口再取出来),但实际场景中,我们根本不知道接口变量里存的是什么类型,这时候类型断言才体现价值。

举个贴近实际的例子:

假设你写了一个函数,需要接收 “任意类型” 的参数(比如用户输入、第三方接口返回的数据),你没法提前确定它是字符串、数字还是其他类型,这时候就必须用类型断言来 “识别 + 转换”:

// 处理任意类型的输入
func processInput(input interface{}) {
    // 你不知道调用者传过来的是 string、int 还是 bool
    // 必须先断言,才能确定类型并处理
    str, ok := input.(string)
    if ok {
        fmt.Println("处理字符串:", str)
    } else {
        num, ok := input.(int)
        if ok {
            fmt.Println("处理数字:", num * 2)
        } else {
            fmt.Println("不支持的类型")
        }
    }
}

func main() {
    processInput("Hello")  // 输出:处理字符串:Hello
    processInput(100)      // 输出:处理数字:200
    processInput(true)     // 输出:不支持的类型
}

这个例子里,input 是空接口,能接收任何类型,但你要对不同类型做不同逻辑(字符串直接打印、数字乘 2),必须先通过类型断言确定它的实际类型,根本没法 “直接赋值”—— 因为你提前不知道传进来的是什么。

而你最初的示例,只是为了教学简化,故意把字符串塞进空接口再断言,看起来 “没必要”,但实际开发中,空接口的内容往往是 “未知的”,这时候断言就是唯一的办法。

二、和 Java 的类型检测是不是类似?

是的!Go 的类型断言,和 Java 里的类型检查 + 类型转换几乎是同一个逻辑,对应关系非常清晰:

Go 类型断言 Java 等效写法 说明
str, ok := i.(string) if (i instanceof String) { String str = (String)i; } 安全检测 + 转换,不报错
str := i.(string) String str = (String)i; 强制转换,类型不对会崩溃
switch t := i.(type) if (i instanceof String) {} else if (i instanceof Integer) {} 多类型分支检测

简单说:Go 的类型断言 = Java 的 instanceof(类型检测) + 强制类型转换,是 “检测 + 转换” 二合一的操作。

总结

  1. 示例中 “绕一圈” 是教学简化,实际场景里接口变量的类型是未知的,必须用断言识别;
  2. 类型断言和 Java 的 instanceof + 强制类型转换 逻辑完全一致,核心都是 “先确认类型,再转换成该类型使用”;
  3. 空接口 interface{} 是 Go 的 “万能类型容器”,类型断言是从这个容器里 “安全取出指定类型数据” 的唯一方式。

Go 语言接口

接口(interface)是 Go 语言中的一种类型,用于定义行为的集合,它通过描述类型必须实现的方法,规定了类型的行为契约。

Go 语言提供了另外一种数据类型即接口,它把所有的具有共性的方法定义在一起,任何其他类型只要实现了这些方法就是实现了这个接口。

Go 的接口设计简单却功能强大,是实现多态和解耦的重要工具。

接口可以让我们将不同的类型绑定到一组公共的方法上,从而实现多态和灵活的设计。

接口的特点

隐式实现:

  • Go 中没有关键字显式声明某个类型实现了某个接口。
  • 只要一个类型实现了接口要求的所有方法,该类型就自动被认为实现了该接口。

接口类型变量:

  • 接口变量可以存储实现该接口的任意值。
  • 接口变量实际上包含了两个部分:
    • 动态类型:存储实际的值类型。
    • 动态值:存储具体的值。

零值接口:

  • 接口的零值是 nil。
  • 一个未初始化的接口变量其值为 nil,且不包含任何动态类型或值。

空接口:

  • 定义为 interface{},可以表示任何类型。

接口的常见用法

  1. 多态:不同类型实现同一接口,实现多态行为。
  2. 解耦:通过接口定义依赖关系,降低模块之间的耦合。
  3. 泛化:使用空接口 interface{} 表示任意类型。

接口定义和实现

接口定义使用关键字 interface,其中包含方法声明。

/* 定义接口 */
type interface_name interface {
   method_name1 [return_type]
   method_name2 [return_type]
   method_name3 [return_type]
   ...
   method_namen [return_type]
}

/* 定义结构体 */
type struct_name struct {
   /* variables */
}

/* 实现接口方法 */
func (struct_name_variable struct_name) method_name1() [return_type] {
   /* 方法实现 */
}
...
func (struct_name_variable struct_name) method_namen() [return_type] {
   /* 方法实现*/
}

定义一个简单接口:

type Shape interface {
    Area() float64
    Perimeter() float64
}
  • Shape 是一个接口,定义了两个方法:Area 和 Perimeter。
  • 任意类型只要实现了这两个方法,就被认为实现了 Shape 接口。

实现接口: 类型通过实现接口要求的所有方法来实现接口。

package main

import (
        "fmt"
        "math"
)

// 定义接口
type Shape interface {
        Area() float64
        Perimeter() float64
}

// 定义一个结构体
type Circle struct {
        Radius float64
}

// Circle 实现 Shape 接口
func (c Circle) Area() float64 {
        return math.Pi * c.Radius * c.Radius
}

func (c Circle) Perimeter() float64 {
        return 2 * math.Pi * c.Radius
}

func main() {
        c := Circle{Radius: 5}
        var s Shape = c // 接口变量可以存储实现了接口的类型
        fmt.Println("Area:", s.Area())
        fmt.Println("Perimeter:", s.Perimeter())
}

类型选择(type switch)

type switch 是 Go 中的语法结构,用于根据接口变量的具体类型执行不同的逻辑。

实例

package main

import "fmt"

func printType(val interface{}) {
        switch v := val.(type) {
        case int:
                fmt.Println("Integer:", v)
        case string:
                fmt.Println("String:", v)
        case float64:
                fmt.Println("Float:", v)
        default:
                fmt.Println("Unknown type")
        }
}

func main() {
        printType(42)
        printType("hello")
        printType(3.14)
        printType([]int{1, 2, 3})
}

执行以上代码,输出结果为:

Integer: 42
String: hello
Float: 3.14
Unknown type

Go 语言泛型

泛型是 Go 语言在 1.18 版本中引入的重要特性,它让开发者能够编写更加灵活和可重用的代码。

泛型主要通过以下两个核心概念来实现:

  • 类型参数(Type Parameters):允许你在函数或类型定义中使用一个或多个类型作为参数。
  • 类型约束(Type Constraints):指定类型参数必须满足的条件,确保在函数内部可以安全地操作这些类型。
概念 作用 示例
类型参数 在函数或类型名后声明,表示待定的类型。 [T any]
类型约束 定义类型参数必须满足的条件(如支持的操作符或方法)。 int,float64,comparable,constraints.Ordered,any
any 约束类型参数为任何类型。 [T any]
comparable 约束类型参数为可比较的类型。 [K comparable]

泛型(Generics)允许我们编写不依赖特定数据类型的代码。

在引入泛型之前,如果我们想要处理不同类型的数据,通常需要为每种类型编写重复的函数。

传统方式的局限性:

实例
*// 处理 int 类型的函数*
func MaxInt(a, b int) int {
  **if** a > b {
    **return** a
  }
  **return** b
}

*// 处理 float64 类型的函数*
func MaxFloat(a, b float64) float64 {
  **if** a > b {
    **return** a
  }
  **return** b
}

使用泛型的解决方案:

实例
*// 一个函数处理多种类型*
func Max[T comparable](a, b T) T {
  **if** a > b {
    **return** a
  }
  **return** b
}

泛型语法详解

类型参数声明

泛型函数和类型通过类型参数列表来声明,语法为 [类型参数 约束]。

// 基本语法结构
func 函数名[T 约束](参数 T) 返回值类型 {
    // 函数体
}

type 类型名[T 约束] struct {
    // 结构体字段
}

类型参数命名约定

  • 通常使用大写字母:T、K、V、E 等
  • T:表示 Type(类型)
  • K:表示 Key(键)
  • V:表示 Value(值)
  • E:表示 Element(元素)

约束(Constraints)

约束定义了类型参数必须满足的条件,是泛型的核心概念。

内置约束

1. any 约束

any 是空接口 interface{} 的别名,表示任何类型都可以。

func PrintAny[T any](value T) {
    fmt.Printf("Value: %v, Type: %T\n", value, value)
}

// 使用示例
PrintAny(42)        // Value: 42, Type: int
PrintAny("hello")   // Value: hello, Type: string
PrintAny(3.14)      // Value: 3.14, Type: float64

2. comparable 约束

comparable 表示类型支持 == 和 != 操作符。

func FindIndex[T comparable](slice []T, target T) int {
    for i, v := range slice {
        if v == target {
            return i
        }
    }
    return -1
}

// 使用示例
numbers := []int{1, 2, 3, 4, 5}
fmt.Println(FindIndex(numbers, 3))  // 输出: 2

names := []string{"Alice", "Bob", "Charlie"}
fmt.Println(FindIndex(names, "Bob"))  // 输出: 1

3. 联合约束(Union Constraints)

使用 | 运算符组合多个类型。

// 数字类型约束
type Number interface {
    int | int8 | int16 | int32 | int64 | 
    uint | uint8 | uint16 | uint32 | uint64 | 
    float32 | float64
}

func Add[T Number](a, b T) T {
    return a + b
}

// 使用示例
fmt.Println(Add(10, 20))        // 输出: 30
fmt.Println(Add(3.14, 2.71))    // 输出: 5.85

Go 错误处理

Go 语言通过内置的错误接口提供了非常简单的错误处理机制。

Go 语言的错误处理采用显式返回错误的方式,而非传统的异常处理机制。这种设计使代码逻辑更清晰,便于开发者在编译时或运行时明确处理错误。

Go 的错误处理主要围绕以下机制展开:

  1. error 接口:标准的错误表示。
  2. 显式返回值:通过函数的返回值返回错误。
  3. 自定义错误:可以通过标准库或自定义的方式创建错误。
  4. **panic 和 recover**:处理不可恢复的严重错误。

error 接口

Go 标准库定义了一个 error 接口,表示一个错误的抽象。

error 类型是一个接口类型,这是它的定义:

type error interface {
    Error() string
}
  • 实现 error 接口:任何实现了 Error() 方法的类型都可以作为错误。
  • Error() 方法返回一个描述错误的字符串。

使用 errors 包创建错误

我们可以在编码中通过实现 error 接口类型来生成错误信息。

创建一个简单错误:

package main

import (
    "errors"
    "fmt"
)

func main() {
    err := errors.New("this is an error")
    fmt.Println(err) // 输出:this is an error
}

函数通常在最后的返回值中返回错误信息,使用 errors.New 可返回一个错误信息:

func Sqrt(f float64) (float64, error) {
    if f < 0 {
        return 0, errors.New("math: square root of negative number")
    }
    // 实现
}

在下面的例子中,我们在调用 Sqrt 的时候传递的一个负数,然后就得到了 non-nil 的 error 对象,将此对象与 nil 比较,结果为 true,所以 fmt.Println(fmt 包在处理 error 时会调用 Error 方法)被调用,以输出错误,请看下面调用的示例代码:

result, err:= Sqrt(-1)

if err != nil {
   fmt.Println(err)
}

高级特性

Buffered Channel:

创建有缓冲的 Channel。

ch := make(chan int, 2)

Context:

用于控制 Goroutine 的生命周期。

context.WithCancel、context.WithTimeout。

Mutex 和 RWMutex:

sync.Mutex 提供互斥锁,用于保护共享资源。

var mu sync.Mutex
mu.Lock()
// critical section
mu.Unlock()

并发编程小结

Go 语言通过 Goroutine 和 Channel 提供了强大的并发支持,简化了传统线程模型的复杂性。配合调度器和同步工具,可以轻松实现高性能并发程序。

  • Goroutines 是轻量级线程,使用 go 关键字启动。
  • Channels 用于 goroutines 之间的通信。
  • Select 语句 用于等待多个 channel 操作。

常见问题

死锁 (Deadlock):

  • 示例:所有 Goroutine 都在等待,但没有任何数据可用。
  • 解决:避免无限等待、正确关闭通道。

数据竞争 (Data Race):

  • 示例:多个 Goroutine 同时访问同一变量。
  • 解决:使用 Mutex 或 Channel 同步访问。

Go 语言文件处理

在 Go 语言中,文件处理是一个非常重要的功能,它允许我们读取、写入和操作文件。无论是处理配置文件、日志文件,还是进行数据持久化,文件处理都是不可或缺的一部分。

Go 语言提供了丰富的标准库来支持文件处理,包括文件的打开、关闭、读取、写入、追加和删除等操作。

  1. os 是核心库:提供底层文件操作(创建、读写、删除等),大多数场景优先使用。
  2. io 提供通用接口:如 Reader/Writer,可与文件、网络等数据源交互。
  3. bufio 优化性能:通过缓冲减少 I/O 操作次数,适合频繁读写。
  4. ioutil 已弃用:Go 1.16 后其功能迁移到 os 和 io 包。
  5. path/filepath 处理路径:跨平台兼容(Windows/Unix 路径分隔符差异)。
库名 主要方法/函数 用途说明 示例代码
os Create(name string) (*File, error) 创建文件(若存在则清空) file, err := os.Create("test.txt")
Open(name string) (*File, error) 只读方式打开文件 file, err := os.Open("data.txt")
OpenFile(name string, flag int, perm FileMode) (*File, error) 自定义模式打开文件(可指定读写、追加等) `file, err := os.OpenFile(“log.txt”, os.O_APPEND
ReadFile(name string) ([]byte, error) 一次性读取整个文件内容(小文件适用) data, err := os.ReadFile("config.json")
WriteFile(name string, data []byte, perm FileMode) error 一次性写入文件(覆盖原有内容) err := os.WriteFile("out.txt", []byte("Hello"), 0644)
Remove(name string) error 删除文件或空目录 err := os.Remove("temp.txt")
Rename(oldpath, newpath string) error 重命名或移动文件 err := os.Rename("old.txt", "new.txt")
Stat(name string) (FileInfo, error) 获取文件信息(大小、权限等) info, err := os.Stat("file.txt")
Mkdir(name string, perm FileMode) error 创建单个目录 err := os.Mkdir("mydir", 0755)
MkdirAll(path string, perm FileMode) error 递归创建多级目录 err := os.MkdirAll("path/to/dir", 0755)
ReadDir(name string) ([]DirEntry, error) 读取目录内容 entries, err := os.ReadDir(".")
io Copy(dst Writer, src Reader) (written int64, err error) 从 Reader 复制数据到 Writer(如文件复制) io.Copy(dstFile, srcFile)
ReadAll(r Reader) ([]byte, error) 从 Reader 读取所有数据(类似 os.ReadFile,但针对接口) data, err := io.ReadAll(file)
bufio NewScanner(r Reader) *Scanner 创建逐行扫描器(适合逐行读取) scanner := bufio.NewScanner(file)
NewReader(rd io.Reader) *Reader 创建带缓冲的读取器(提高大文件读取效率) reader := bufio.NewReader(file)
NewWriter(w io.Writer) *Writer 创建带缓冲的写入器(提高写入效率) writer := bufio.NewWriter(file)
ioutil ReadFile(filename string) ([]byte, error) (已弃用,推荐 os.ReadFile) data, err := ioutil.ReadFile("old.txt")
WriteFile(filename string, data []byte, perm os.FileMode) error (已弃用,推荐 os.WriteFile) err := ioutil.WriteFile("out.txt", data, 0644)
TempDir(dir, pattern string) (name string, err error) (已弃用,推荐 os.MkdirTemp) dir, err := ioutil.TempDir("", "tmp")
TempFile(dir, pattern string) (f *os.File, err error) (已弃用,推荐 os.CreateTemp) file, err := ioutil.TempFile("", "temp-*")
path/filepath Join(elem ...string) string 跨平台安全的路径拼接 path := filepath.Join("dir", "file.txt")
Walk(root string, fn WalkFunc) error 递归遍历目录树 filepath.Walk(".", func(path string, info os.FileInfo, err error) error {...})
Abs(path string) (string, error) 获取绝对路径 absPath, err := filepath.Abs("file.txt")

不同场景推荐使用方法

场景 推荐方法 原因
读取小文件 os.ReadFile("file.txt") 简洁高效,自动处理打开/关闭
逐行读取大文件 bufio.NewScanner(file) 内存友好,逐行处理
高效写入大量数据 bufio.NewWriter(file) + writer.WriteString() 缓冲减少磁盘 I/O 次数
递归遍历目录 filepath.Walk("/path", callback) 自动处理子目录和错误
跨平台路径拼接 filepath.Join("dir", "file.txt") 自动处理不同操作系统的路径分隔符(/ 或 \)

文件创建

在 Go 语言中,我们使用 os 包来创建文件。

os.Create 函数用于创建一个文件,并返回一个 *os.File 类型的文件对象。创建文件后,我们通常需要调用 Close 方法来关闭文件,以释放系统资源。

package main

import (
        "log"
        "os"
)

func main() {
        // 创建文件,如果文件已存在会被截断(清空)
        file, err := os.Create("test.txt")
        if err != nil {
                log.Fatal(err)
        }
        defer file.Close() // 确保文件关闭
        
        log.Println("文件创建成功")
}

文件的打开与关闭

在 Go 语言中,我们使用 os 包来打开和关闭文件。

os.Open 函数用于打开一个文件,并返回一个 *os.File 类型的文件对象。打开文件后,我们通常需要调用 Close 方法来关闭文件,以释放系统资源。

打开文件

package main

import (
    "fmt"
    "os"
)

func main() {
    file, err := os.Open("example.txt")
    if err != nil {
        fmt.Println("Error opening file:", err)
        return
    }
    defer file.Close()

    fmt.Println("File opened successfully!")
}

在上面的代码中,我们使用 os.Open 打开了一个名为 example.txt 的文件。如果文件打开失败,程序会打印错误信息并退出。defer file.Close() 确保在函数返回前关闭文件。

关闭文件是一个重要的步骤,它可以防止文件描述符泄漏。在 Go 中,我们通常使用 defer 语句来确保文件在函数结束时被关闭。

文件的读取

Go 语言提供了多种读取文件的方式,包括逐行读取、一次性读取整个文件等。我们可以使用 bufio 包来逐行读取文件,或者使用 ioutil 包来一次性读取整个文件。

逐行读取文件

package main

import (
    "bufio"
    "fmt"
    "os"
)

func main() {
    file, err := os.Open("example.txt")
    if err != nil {
        fmt.Println("Error opening file:", err)
        return
    }
    defer file.Close()

    scanner := bufio.NewScanner(file)
    for scanner.Scan() {
        fmt.Println(scanner.Text())
    }

    if err := scanner.Err(); err != nil {
        fmt.Println("Error reading file:", err)
    }
}

在上面的代码中,我们使用 bufio.NewScanner 创建了一个扫描器,然后通过 scanner.Scan() 逐行读取文件内容,并使用 scanner.Text() 获取每一行的文本。

一次性读取整个文件

package main

import (
    "fmt"
    "io/ioutil"
)

func main() {
    content, err := ioutil.ReadFile("example.txt")
    if err != nil {
        fmt.Println("Error reading file:", err)
        return
    }

    fmt.Println(string(content))
}

在这个例子中,我们使用 ioutil.ReadFile 一次性读取整个文件的内容,并将其转换为字符串打印出来。


文件的写入

Go 语言也提供了多种写入文件的方式,包括逐行写入、一次性写入等。我们可以使用 os 包来创建和写入文件。

package main

import (
        "log"
        "os"
)

func main() {
        // 方式1:直接写入字符串
        file, err := os.Create("write1.txt")
        if err != nil {
                log.Fatal(err)
        }
        defer file.Close()
        
        file.WriteString("直接写入字符串\n")
        
        // 方式2:写入字节切片
        data := []byte("写入字节切片\n")
        file.Write(data)
        
        // 方式3:使用fmt.Fprintf格式化写入
        fmt.Fprintf(file, "格式化写入: %d\n", 123)
}

逐行写入文件

package main

import (
    "bufio"
    "fmt"
    "os"
)

func main() {
    file, err := os.Create("output.txt")
    if err != nil {
        fmt.Println("Error creating file:", err)
        return
    }
    defer file.Close()

    writer := bufio.NewWriter(file)
    fmt.Fprintln(writer, "Hello, World!")
    writer.Flush()
}

在这个例子中,我们使用 os.Create 创建了一个名为 output.txt 的文件,并使用 bufio.NewWriter 创建一个写入器。然后,我们使用 fmt.Fprintln 将字符串写入文件,并调用 writer.Flush() 确保所有数据都被写入文件。

一次性写入文件

package main

import (
    "fmt"
    "io/ioutil"
)

func main() {
    content := []byte("Hello, World!")
    err := ioutil.WriteFile("output.txt", content, 0644)
    if err != nil {
        fmt.Println("Error writing file:", err)
        return
    }

    fmt.Println("File written successfully!")
}

在这个例子中,我们使用 ioutil.WriteFile 一次性将字节数组写入文件。0644 是文件的权限模式,表示文件所有者可以读写,其他用户只能读取。


文件的追加写入

有时候我们需要在文件的末尾追加内容,而不是覆盖原有内容。Go 语言提供了 os.OpenFile 函数来实现这一功能。

package main

import (
    "fmt"
    "os"
)

func main() {
    file, err := os.OpenFile("output.txt", os.O_APPEND|os.O_WRONLY, 0644)
    if err != nil {
        fmt.Println("Error opening file:", err)
        return
    }
    defer file.Close()

    if _, err := file.WriteString("Appended text\n"); err != nil {
        fmt.Println("Error appending to file:", err)
        return
    }

    fmt.Println("Text appended successfully!")
}

在这个例子中,我们使用 os.OpenFile 打开文件,并指定 os.O_APPEND 标志来在文件末尾追加内容。然后,我们使用 file.WriteString 将字符串追加到文件中。


文件的删除

在 Go 语言中,我们可以使用 os.Remove 函数来删除文件。

package main

import (
    "fmt"
    "os"
)

func main() {
    err := os.Remove("output.txt")
    if err != nil {
        fmt.Println("Error deleting file:", err)
        return
    }

    fmt.Println("File deleted successfully!")
}

在这个例子中,我们使用 os.Remove 删除了名为 output.txt 的文件。如果文件删除失败,程序会打印错误信息。


文件信息与操作

获取文件信息

package main

import (
        "fmt"
        "log"
        "os"
)

func main() {
        fileInfo, err := os.Stat("test.txt")
        if err != nil {
                log.Fatal(err)
        }
        
        fmt.Println("文件名:", fileInfo.Name())
        fmt.Println("文件大小:", fileInfo.Size(), "字节")
        fmt.Println("权限:", fileInfo.Mode())
        fmt.Println("最后修改时间:", fileInfo.ModTime())
        fmt.Println("是目录吗:", fileInfo.IsDir())
}

检查文件是否存在

import (
        "fmt"
        "os"
)

func main() {
        if _, err := os.Stat("test.txt"); os.IsNotExist(err) {
                fmt.Println("文件不存在")
        } else {
                fmt.Println("文件存在")
        }
}

重命名和移动文件

package main

import (
        "log"
        "os"
)

func main() {
        err := os.Rename("old.txt", "new.txt")
        if err != nil {
                log.Fatal(err)
        }
        log.Println("重命名成功")
}

目录操作

创建目录

package main

import (
        "log"
        "os"
)

func main() {
        // 创建单个目录
        err := os.Mkdir("newdir", 0755)
        if err != nil {
                log.Fatal(err)
        }
        
        // 递归创建多级目录
        err = os.MkdirAll("path/to/newdir", 0755)
        if err != nil {
                log.Fatal(err)
        }
}

读取目录内容

package main

import (
        "fmt"
        "log"
        "os"
)

func main() {
        entries, err := os.ReadDir(".")
        if err != nil {
                log.Fatal(err)
        }
        
        for _, entry := range entries {
                info, _ := entry.Info()
                fmt.Printf("%-20s %8d %v\n", 
                        entry.Name(), 
                        info.Size(), 
                        info.ModTime().Format("2006-01-02 15:04:05"))
        }
}

删除目录

package main

import (
        "log"
        "os"
)

func main() {
        // 删除空目录
        err := os.Remove("emptydir")
        if err != nil {
                log.Fatal(err)
        }
        
        // 递归删除目录及其内容
        err = os.RemoveAll("path/to/dir")
        if err != nil {
                log.Fatal(err)
        }
}

高级文件操作

文件复制

package main

import (
        "io"
        "log"
        "os"
)

func main() {
        srcFile, err := os.Open("source.txt")
        if err != nil {
                log.Fatal(err)
        }
        defer srcFile.Close()
        
        dstFile, err := os.Create("destination.txt")
        if err != nil {
                log.Fatal(err)
        }
        defer dstFile.Close()
        
        bytesCopied, err := io.Copy(dstFile, srcFile)
        if err != nil {
                log.Fatal(err)
        }
        log.Printf("复制完成,共复制 %d 字节", bytesCopied)
}

文件追加

package main

import (
        "log"
        "os"
)

func main() {
        file, err := os.OpenFile("log.txt", 
                os.O_APPEND|os.O_CREATE|os.O_WRONLY, 0644)
        if err != nil {
                log.Fatal(err)
        }
        defer file.Close()
        
        if _, err := file.WriteString("新的日志内容\n"); err != nil {
                log.Fatal(err)
        }
}

临时文件和目录

package main

import (
        "fmt"
        "log"
        "os"
)

func main() {
        // 创建临时文件
        tmpFile, err := os.CreateTemp("", "example-*.txt")
        if err != nil {
                log.Fatal(err)
        }
        defer os.Remove(tmpFile.Name()) // 清理
        
        fmt.Println("临时文件:", tmpFile.Name())
        
        // 创建临时目录
        tmpDir, err := os.MkdirTemp("", "example-*")
        if err != nil {
                log.Fatal(err)
        }
        defer os.RemoveAll(tmpDir) // 清理
        
        fmt.Println("临时目录:", tmpDir)
}

Go 语言正则表达式

正则表达式(Regular Expression,简称 regex 或 regexp)是一种用于匹配字符串的强大工具。

正则表达式通过定义一种模式(pattern),可以快速搜索、替换或提取符合该模式的字符串,详细可以参见正则表达式教程。

在 Go 语言中,正则表达式通过 regexp 包来实现。


Go 语言中的 regexp 包

Go 语言的标准库提供了 regexp 包,用于处理正则表达式。以下是 regexp 包中常用的函数和方法:

  1. Compile 和 MustCompile
    用于编译正则表达式。Compile 返回一个 *Regexp 对象和一个错误,而 MustCompile 在编译失败时会直接 panic。
  2. MatchString
    检查字符串是否匹配正则表达式。
  3. FindString 和 FindAllString
    用于查找匹配的字符串。FindString 返回第一个匹配项,FindAllString 返回所有匹配项。
  4. ReplaceAllString
    用于替换匹配的字符串。
  5. Split
    根据正则表达式分割字符串。

正则表达式的基本语法

以下是一些常用的正则表达式语法:

  • .:匹配任意单个字符(除了换行符)。
  • *:匹配前面的字符 0 次或多次。
  • +:匹配前面的字符 1 次或多次。
  • ?:匹配前面的字符 0 次或 1 次。
  • \d:匹配数字字符(等价于 [0-9])。
  • \w:匹配字母、数字或下划线(等价于 [a-zA-Z0-9_])。
  • \s:匹配空白字符(包括空格、制表符、换行符等)。
  • []:匹配括号内的任意一个字符(例如 [abc] 匹配 a、b 或 c)。
  • ^:匹配字符串的开头。
  • $:匹配字符串的结尾。

示例代码

以下是一些使用 Go 语言正则表达式的示例:

示例 1:检查字符串是否匹配正则表达式

package main

import (
    "fmt"
    "regexp"
)

func main() {
    pattern := `^[a-zA-Z0-9]+$`
    regex := regexp.MustCompile(pattern)

    str := "Hello123"
    if regex.MatchString(str) {
        fmt.Println("字符串匹配正则表达式")
    } else {
        fmt.Println("字符串不匹配正则表达式")
    }
}

示例 2:查找匹配的字符串

package main

import (
    "fmt"
    "regexp"
)

func main() {
    pattern := `\d+`
    regex := regexp.MustCompile(pattern)

    str := "我有 3 个苹果和 5 个香蕉"
    matches := regex.FindAllString(str, -1)
    fmt.Println("找到的数字:", matches)
}

示例 3:替换匹配的字符串

package main

import (
    "fmt"
    "regexp"
)

func main() {
    pattern := `\s+`
    regex := regexp.MustCompile(pattern)

    str := "Hello    World"
    result := regex.ReplaceAllString(str, " ")
    fmt.Println("替换后的字符串:", result)
}

示例 4:分割字符串

package main

import (
    "fmt"
    "regexp"
)

func main() {
    pattern := `,`
    regex := regexp.MustCompile(pattern)

    str := "apple,banana,orange"
    parts := regex.Split(str, -1)
    fmt.Println("分割后的字符串:", parts)
}

注意事项

  1. 性能问题
    正则表达式的匹配和替换操作可能会消耗较多资源,尤其是在处理大量数据时。建议在性能敏感的场景下谨慎使用。
  2. 转义字符
    在 Go 语言中,正则表达式中的反斜杠 \ 需要写成 \\,因为反斜杠在字符串中也是转义字符。
  3. 错误处理
    使用 Compile 函数时,务必检查返回的错误,以避免程序崩溃。

Go 类型断言

在 Go 语言中,类型断言(Type Assertion)是一种用于检查接口值的实际类型的机制。

类型断言是 Go 语言中处理接口类型的重要工具,它允许我们从接口值中提取出具体的类型,并对其进行操作。

类型断言通常用于处理接口类型的变量,因为接口变量可以存储任何实现了该接口的具体类型的值。

基本语法

类型断言的基本语法如下:

value, ok := interfaceValue.(Type)
  • interfaceValue 是一个接口类型的变量。
  • Type 是你想要断言的类型。
  • value 是断言成功后的具体类型的值。
  • ok 是一个布尔值,表示断言是否成功。

如果断言成功,value 将是 interfaceValue 的实际值,ok 为 true;如果断言失败,value 将是 Type 的零值,ok 为 false。

package main

import "fmt"

func main() {
    var i interface{} = "Hello, Go!"

    // 尝试将 i 断言为 string 类型
    s, ok := i.(string)
    if ok {
        fmt.Println("断言成功:", s)
    } else {
        fmt.Println("断言失败")
    }

    // 尝试将 i 断言为 int 类型
    n, ok := i.(int)
    if ok {
        fmt.Println("断言成功:", n)
    } else {
        fmt.Println("断言失败")
    }
}

输出结果

断言成功: Hello, Go!
断言失败

类型断言的另一种形式

除了上述的 value, ok := interfaceValue.(Type) 形式,Go 还支持另一种形式的类型断言,它不返回布尔值,而是直接在断言失败时引发 panic。

这种形式的语法如下:

value := interfaceValue.(Type)

示例代码

package main

import "fmt"

func main() {
    var i interface{} = "Hello, Go!"

    // 直接断言为 string 类型
    s := i.(string)
    fmt.Println("断言成功:", s)

    // 直接断言为 int 类型(会引发 panic)
    n := i.(int)
    fmt.Println("断言成功:", n)
}

输出结果

断言成功: Hello, Go!
panic: interface conversion: interface {} is string, not int

类型断言的常见用途

1. 处理多种类型的接口值

Go 还提供了特殊的 type switch 语法来测试多种类型:

switch v := i.(type) {
case T1:
    // v的类型是T1
case T2:
    // v的类型是T2
default:
    // 默认情况
}

当接口变量可能存储多种类型的值时,类型断言可以帮助我们根据实际类型执行不同的操作。

func printType(i interface{}) {
    switch v := i.(type) {
    case int:
        fmt.Println("这是一个整数:", v)
    case string:
        fmt.Println("这是一个字符串:", v)
    default:
        fmt.Println("未知类型")
    }
}

2. 从接口中提取具体类型

在处理接口类型的变量时,我们可能需要将其转换为具体的类型以便进行进一步的操作。

func processInterface(i interface{}) {
    if s, ok := i.(string); ok {
        fmt.Println("处理字符串:", s)
    } else if n, ok := i.(int); ok {
        fmt.Println("处理整数:", n)
    } else {
        fmt.Println("无法处理的类型")
    }
}

注意事项

  1. 类型断言只能用于接口类型:类型断言只能用于接口类型的变量,不能用于非接口类型的变量。
  2. 避免 panic:在使用不返回布尔值的类型断言时,务必确保类型断言不会失败,否则会引发 panic。
  3. 类型断言的性能:类型断言在运行时进行类型检查,因此可能会带来一定的性能开销。在性能敏感的场景中,应谨慎使用。

Go 继承

在面向对象编程(OOP)中,继承是一种机制,允许一个类(子类)从另一个类(父类)继承属性和方法。通过继承,子类可以复用父类的代码,并且可以在不修改父类的情况下扩展或修改其行为。

Go 语言并不是一种传统的面向对象编程语言,它没有类和继承的概念。

Go 使用结构体(struct)和接口(interface)来实现类似的功能。


Go 中的 “继承”

Go 语言没有传统面向对象语言中的类(class)和继承(inheritance)概念,而是通过组合(composition)和接口(interface)来实现类似的功能。

1. 组合(Composition)

组合是 Go 中实现代码复用的主要方式。通过将一个结构体嵌入到另一个结构体中,子结构体可以”继承”父结构体的字段和方法。

package main

import "fmt"

// 父结构体
type Animal struct {
    Name string
}

// 父结构体的方法
func (a *Animal) Speak() {
    fmt.Println(a.Name, "says hello!")
}

// 子结构体
type Dog struct {
    Animal // 嵌入 Animal 结构体
    Breed  string
}

func main() {
    dog := Dog{
        Animal: Animal{Name: "Buddy"},
        Breed:  "Golden Retriever",
    }

    dog.Speak() // 调用父结构体的方法
    fmt.Println("Breed:", dog.Breed)
}

代码解释

  • Animal 是父结构体,包含一个字段 Name 和一个方法 Speak。
  • Dog 是子结构体,通过嵌入 Animal 结构体,继承了 Animal 的字段和方法。
  • 在 main 函数中,我们创建了一个 Dog 实例,并调用了 Speak 方法。

2. 接口(Interface)

接口是 Go 中实现多态的主要方式。通过定义接口,不同的结构体可以实现相同的方法,从而实现类似继承的多态行为。

package main

import "fmt"

// 定义接口
type Speaker interface {
    Speak()
}

// 父结构体
type Animal struct {
    Name string
}

// 实现接口方法
func (a *Animal) Speak() {
    fmt.Println(a.Name, "says hello!")
}

// 子结构体
type Dog struct {
    Animal
    Breed string
}

func main() {
    var speaker Speaker

    dog := Dog{
        Animal: Animal{Name: "Buddy"},
        Breed:  "Golden Retriever",
    }

    speaker = &dog
    speaker.Speak() // 通过接口调用方法
}

代码解释

  • Speaker 是一个接口,定义了一个 Speak 方法。
  • Animal 结构体实现了 Speaker 接口。
  • Dog 结构体通过嵌入 Animal 结构体,间接实现了 Speaker 接口。
  • 在 main 函数中,我们将 Dog 实例赋值给 Speaker 接口,并通过接口调用 Speak 方法。

Go 与经典继承的区别

特性 经典继承 Go 的方式
代码复用 通过继承 通过组合(嵌入结构体)
多态 通过继承和方法重写 通过接口实现
关系 “是一个”(is-a)关系 “有一个”(has-a)或”实现了”关系
灵活性 继承关系固定 可以运行时组合

Go Modules

Go Modules 是 Go 语言的官方依赖管理工具,自 Go 1.11 版本开始引入,在 Go 1.16 版本成为默认的依赖管理模式。

Go Modules 解决了 Go 语言长期以来在依赖管理方面的痛点,为开发者提供了版本控制、依赖隔离和可重复构建等核心功能。

Go Modules 是一组相关 Go 包的集合,它们被版本化并作为一个独立的单元进行管理。每个模块都有一个明确的版本标识,允许开发者在项目中精确指定所需依赖的版本。

核心概念解析

模块(Module):包含 go.mod 文件的目录树,该文件定义了模块的路径、Go 版本要求和依赖关系。

版本(Version):遵循语义化版本控制(Semantic Versioning)的标识符,格式为 vMAJOR.MINOR.PATCH。

依赖图(Dependency Graph):模块及其所有传递依赖的层次结构,Go 工具会自动解析和维护。


为什么需要 Go Modules?

传统 GOPATH 的问题

在 Go Modules 出现之前,Go 使用 GOPATH 模式,存在以下局限性:

  1. 工作空间限制:所有项目必须放在 GOPATH 目录下
  2. 版本管理困难:无法精确控制依赖版本
  3. 依赖冲突:多个项目可能使用同一依赖的不同版本
  4. 可重复构建挑战:难以确保不同环境下的构建一致性

Go Modules 的优势

传统 GOPATH vs Go Modules 对比:

特性 GOPATH 模式 Go Modules
项目位置限制 必须放在 GOPATH 下 任意位置均可
版本控制 有限支持 完整的语义化版本控制
依赖隔离 全局共享 项目级隔离
可重复构建 困难 自动保障
离线工作 不支持 支持本地缓存

Go Modules 的核心功能(新手最常用)

1. 核心文件

启用 Go Modules 后,项目根目录会生成两个关键文件:

  • go.mod:记录项目的模块名(模块路径)、Go 版本、依赖包的名称和版本(核心文件,需要提交到代码仓库);
  • go.sum:记录依赖包的哈希值,用于校验依赖包的完整性,防止被篡改(自动生成,建议提交)。

2. 基础使用示例(新手入门)

步骤 1:初始化 Go Modules(创建项目时)
# 进入你的项目目录
cd /your/project/path
# 初始化模块,module名一般是项目的仓库地址(也可以自定义)
go mod init github.com/yourname/yourproject

执行后,项目里会生成 go.mod 文件,初始内容如下:

module github.com/yourname/yourproject

go 1.21  // 你当前使用的Go版本
步骤 2:添加 / 使用依赖

比如你的项目需要用第三方库 github.com/gin-gonic/gin:

// main.go
package main

import "github.com/gin-gonic/gin"

func main() {
    r := gin.Default()
    r.GET("/", func(c *gin.Context) {
        c.String(200, "Hello Go Modules!")
    })
    r.Run()
}

执行 go run main.go,Go Modules 会自动:

  1. 下载 gin 及其依赖包到本地(默认路径:$GOPATH/pkg/mod);
  2. 自动更新 go.mod 和 go.sum,记录依赖的版本:
// 更新后的go.mod
module github.com/yourname/yourproject

go 1.21

require github.com/gin-gonic/gin v1.9.1  // 自动添加的依赖及版本
步骤 3:常用命令(管理依赖)
# 下载go.mod中声明的所有依赖
go mod download

# 清理项目中未使用的依赖(比如你删除了代码中对某个包的引用)
go mod tidy

# 查看依赖树(了解项目依赖的所有包及版本)
go mod graph

# 更新指定依赖到最新版本
go get github.com/gin-gonic/gin@latest

# 指定依赖的具体版本
go get github.com/gin-gonic/gin@v1.9.0

三、核心优势(新手能直接感知到)

  1. 项目无需放 GOPATH:可以把项目放在任意目录,打破 GOPATH 的限制;
  2. 依赖隔离:不同项目的依赖版本相互独立,不会冲突;
  3. 版本可控:明确指定依赖版本,保证项目在任何环境编译、运行结果一致;
  4. 自动管理依赖:无需手动下载依赖,go run/go build 会自动处理。

总结

  1. Go Modules 是 Go 官方的包 / 依赖管理工具,替代了老旧的 GOPATH 模式;
  2. 核心通过 go.mod 记录依赖版本,go.sum 校验依赖完整性,实现依赖隔离和版本可控;
  3. 新手核心记住 go mod init(初始化)、go mod tidy(清理依赖)、go get(添加 / 更新依赖)三个命令即可满足日常使用。
阅读全文

python

2025/12/22

数据类型

基本数据类型
  • 整数 int
  • 浮点数 float
  • 复数 complex
  • 布尔 bool
字符串
  • str
容器类型
  • 列表 list
  • 元组 tuple
  • 集合 set
  • 字典 dict
特殊类型
  • None
上述类型中
  • 不可变的有:数值、字符串、元组
  • 可变的类型有:列表、集合、字典
如果数字比较大,可使用下划线将其中的数字分组,使其更清晰易读。
num1 = 1_000_000_000_000_000
print(num1)  # 1000000000000000
type 与 isinstance 类型判断

可以使用 type() 来查看变量类型,使用 isinstance() 来判断变量类型。
type() 和 isinstance() 的区别在于 type() 不会认为子类是一种父类类型,isinstance() 会认为子类是一种父类类型。

num1 = True
num2 = 10
print(type(num1))  # <class 'bool'>
print(type(num2))  # <class 'int'>
print(type(num1) == type(num2))  # False
print(isinstance(num1, bool))  # True
print(isinstance(num1, int))  # True,Python3中,bool是int的子类
print(isinstance(num2, int))  # True

小整数池

Python将 [-5, 256] 的整数维护在小整数对象池中。这些整数提前创建好且不会被垃圾回收,避免了为整数频繁申请和销毁内存空间。不管在程序的什么位置,使用的位于这个范围内的整数都是同一个对象。

大整数池
一开始大整数池为空,每创建一个大整数就会向池中存储一个。

不同的 Python 实现:小整数池的范围和实现细节可能因 Python 的不同实现(如 CPython、Jython、IronPython 等)而有所不同。上述提到的[-5, 256]范围是 CPython 的默认实现。

有时连续赋值的相同大整数也可能指向同一对象,这是因为Python环境的优化机制,但是这个优化不是绝对的,也取决于解释器以及交互式以及脚本环境。

float浮点型

Python将所有带小数点的数称为浮点数。要注意在使用浮点数进行计算时可能会存在微小误差,可以通过导入decimal解决

num1 = 0.1
num2 = 0.2
print(num1 + num2)  # 0.30000000000000004
from decimal import Decimal
num3 = Decimal('1.0')
num4 = Decimal('0.9')
print(num3-num4)

也可以使用科学计数法表示浮点数。
num1 = 1.3e7
print(num1)  # 13000000.0

在Python中,能够解释为假的值不只有False,还有:

  • None、0、0.0、False、所有的空容器(空列表、空元组、空字典、空集合、空字符串)

为了解决浮点数丢失精度情况,可以借助py其他模块提供的功能

from decimal import Decimal

bool是int的子类型,可以和整数进行运算

num1 = True print(num1 + 10)

*转义字符* *说明*
\ 在行尾作为续行符
\ \ 反斜杠符号
\ ‘ 单引号
\ “ 双引号
*\b* 退格
*\n* 换行
*\t* 横向制表符
*\r* 回车,回到行首
*函数* *说明*
*int(x [,base])* 将x转换为一个整数,x若为字符串可用base指定进制
*float(x)* 将x转换为一个浮点数
*complex(real[,imag])* 创建一个实部为real,虚部为imag的复数
*str(x)* 将对象x转换为一个字符串
repr(x) 将对象x转换为一个字符串,可以转义字符串中的特殊字符
*eval(x)* 执行x字符串表达式,并返回表达式的值
*bin(x)* 将一个整数转换为一个二进制字符串
*oct(x)* 将一个整数转换为一个八进制字符串
*hex(x)* 将一个整数转换为一个十六进制字符串
*ord(x)* 将一个字符转换为它的ASCII整数值
*chr(x)* 将一个整数转换为一个Unicode字符
*tuple(s)* 将序列s转换为一个元组
*list(s)* 将序列s转换为一个列表
set(s) 转换s为可变集合
num_int = 123
num_str = "456"
print("num_int 数据类型为:",type(num_int))
print("类型转换前,num_str 数据类型为:",type(num_str))
num_str = int(num_str)    # 强制转换为整型
print("类型转换后,num_str 数据类型为:",type(num_str))
num_sum = num_int + num_str
print("num_int 与 num_str 相加结果为:",num_sum)
print("sum 数据类型为:",type(num_sum))
输出:
num_int 数据类型为: <class 'int'>
类型转换前,num_str 数据类型为: <class 'str'>
类型转换后,num_str 数据类型为: <class 'int'>
num_int 与 num_str 相加结果为: 579
sum 数据类型为: <class 'int'>
输入
# Python开始等待你的输入。这时,你可以输入任意字符,然后按回车后完成输入。
input_str = input("请输入:")
# 输入完成后,不会有任何提示,刚才输入的内容存放到input_str变量里了
print("input_str数据类型为:",type(input_str))
# 输出input_str查看变量内容
print(input_str)
输出
使用 print() 可将内容打印。
print("Hello Python")

多个内容之间可以使用逗号隔开。
print("Hello", " Python")

可以使用 end= 来控制 print() 以什么结尾。
print("使用\\n结尾", end="\n")  # 用\n结尾,等同于print("使用\\n结尾")
print('使用""结尾', end="")  # 用空字符串结尾
print("Hello")
格式化输出
(1)字符串中使用 % 占位
int1 = 10
float1 = 3.14159

str1 = "int1 = %d, float1 = %f" % (int1, float1)
print(str1)  # int1 = 10, float1 = 3.141590

字符串.format()

方式1:不设置指定位置,按默认顺序
int1 = 10
float1 = 3.14159
bool1 = True
str2 = "int1 = {}, float1 = {}, bool1 = {}".format(int1, float1, bool1)
print(str2)  # int1 = 10, float1 = 3.14159, bool1 = True

方式2:设置指定位置,不能和方式1混合使用
int1 = 10
float1 = 3.14159
bool1 = True
str2 = "int1 = {0}, float1 = {1}, bool1 = {2}".format(int1, float1, bool1)
print(str2)  # int1 = 10, float1 = 3.14159, bool1 = True

方式3:设置参数
int1 = 10
float1 = 3.14159
bool1 = True
str2 = "int1 = {i1}, float1 = {f1}, bool1 = {b1}".format(i1=int1, f1=float1, b1=bool1)
print(str2)  # int1 = 10, float1 = 3.14159, bool1 = True
f-字符串
字符串前加上一个 f ,字符串中的{}内写入变量名。
int1 = 10
float1 = 3.14159
str3 = f"int1 = {int1}, float1 = {float1}"
print(str3)  # int1 = 10, float1 = 3.14159
{}内变量名后可以加上 = ,打印时会在变量值前加上 变量名=
int1 = 10
float1 = 3.14159
str3 = f"{int1 = }, {float1 = }"
print(str3)  # int1 = 10, float1 = 3.14159
num1 = 10
num2 = 20
num3 = 30

print(f"num1 = {num1}, num2 = {num2}, num3 = {num3}")
print(f"{num1=}, {num2=}, {num3=}")
{}外再套一层{},即{ { } },会转义
int1 = 10
float1 = 3.14159
str3 = f"{{int1 = }}, {{float1 = }}"
print(str3)  # {int1 = }, {float1 = }

成员运算符

运算符 说明 实例
in 在指定的序列中找到值返回 True,否则返回 False a in [‘a’, ‘b’, ‘c’]
not in 在指定的序列中没有找到值返回 True,否则返回 False a not in [‘a’, ‘b’, ‘c’]
# -------------成员运算符---------------
num6 = 1
num7 = 20
test_list = [1,2,3,4,5]
print(test_list)
print(num6 in test_list) # True 判断1是不是列表中的的成员
print(num7 not in test_list) # True

身份运算符

运算符 说明 实例
is 判断两个标识符是不是引用自相同对象 a is b,类似id(a) == id(b)。如果引用的是同一个对象则返回True,否则返回False
not is 判断两个标识符是不是引用自不同对象 a is not b,类似id(a) != id(b)。如果引用的不是同一个对象则返回True,否则返回False
# -------------身份运算符---------------
m = 20
n = 20
q = 30
print(m is n)  # True 判断m和n在内存中是否指向同一个地址 都在小整数池里
print(n is q)  # False
print(n is not q)  # True
# id() 用于获取对象在内存中的地址
print(id(m) == id(n)) # True

print("-" * 30)
# -------------is和==的区别---------------
a = [1,2,3]
b = a 

print(b is a)  # True
print(b == a)  # True

b = a[:]  # 快速复刻一个新的列表并给b
print(b)
print(b is a)  # False
print(b == a)  # True

单分支

语法:

if 表达式:
    语句

双分支

语法:

if 表达式:
    语句1
else:
    语句2

双分支

语法:

if 表达式1:
    语句1
elif 表达式2:
    语句2
elif 表达式3:
    语句3
else:  # else如不需要可以省略
    语句4

嵌套分支

语法:
if 表达式1:
    if 表达式2:
        语句1
    else:
        语句2
else:
    if 表达式3:
        语句3
    else:
        语句4

match case语句

语法:
match x:
    case a:
        语句1
    case b:
        语句2
    case _:
        语句3
match month := 3:
    case 1 | 3 | 5 | 7 | 8 | 10 | 12:
        print(f"{month}月有31天")
    case 4 | 6 | 9 | 11:
        print(f"{month}月有30天")
    case 2:
        print(f"{month}月可能有28天")
    case _:
        print(f"{month}月有?天")

三目运算符

num1 = 2
num2 = 3
max_num = num1 if num1 > num2 else num2
print(max_num)

循环

while
while 表达式:
    语句-循环体
import time

num = 1
while num < 100:
    print("\r" + "=" * num, end="")
    num += 1
    time.sleep(0.05)
while else

while 后可以加上 else,当 while 表达式结果为 False 时会执行 else 中的语句。

rabbit = 2
week = 1
while week < 10:
    rabbit = rabbit + rabbit * 2
    week += 1
else:
print(f"第{week}周有{rabbit}只兔子")

for循环

语法

for 循环可以用来遍历可迭代对象,如列表或字符串

for 临时变量 in 可迭代对象:
    语句

for 循环后也可以加上 else,循环结束后会执行 else 中语句

for 临时变量 in 可迭代对象:
    语句1
else:
    语句2
(1)遍历列表
for i in [2, 3, 5, 7, 11, 13, 17, 19]:
    print(i)
    
(2)遍历字符串
for i in "hello world":
    print(i)
    
(3)遍历range数列
for i in range(10):
    print(i)

range()

range([start,] stop[, step]) 函数可以生成数列,它返回一个可迭代对象。
指定生成到stop(不包含stop)的数列,默认从0开始

for i in range(10):
    print(i)

指定生成数列的范围,从start到stop(不包含stop),可设定步长,默认步长为1,步长可正可负。

or i in range(-10, 10):
    print(i)

for i in range(10, -10, -3):
    print(i)

continue

跳过当前循环块中的剩余语句,继续进行下一轮循环。一般写在if判断中。

案例,打印0-9,跳过偶数

for i in range(10):
    if i % 2 == 0:
        continue
    print(i)

break

跳出当前for或while的循环体,一般写在if判断中。
如果for 或while循环通过break终止,循环对应的else 将不执行。

案例:求0-9每个数自己幂自己的加和,如果大于10000000则循环终止。

sum = 0
for i in range(10):
    sum = sum + i**i
    if sum > 10000000:
        break
    print(i, sum)
else:
    print("循环完成,sum = ", sum)

pass【循环体或函数写的时候思考的占位】

pass是空语句,是为了保持程序结构 的完整性。
pass不做任何事情,一般用做占位语句。

例如:在一个循环中,如果循环体为空,语法会提示报错,
这个时候我们就可以使用pass占位

for i in range(10):
    pass
while True:
    pass

循环相关的关键字:::::
   continue
         跳出当前正在进行的循环,继续下次循环
   break
        跳出整个循环
   pass
           循环体的占位

容器数据类型

list  列表
tuple 元组
set   集合
dict  字典
不可变类型:数组、字符串、元组
可变类型:列表、集合、字典

按ctrl+p可以看某个函数所需要填的元素

序列

序列(Sequence)是一种基本且核心的数据结构,它允许我们以有序的方式存储和操作数据。序列可以包含不同类型的元素,并且支持通过索引来访问和修改这些元素。常见的序列类型包括:列表(List)、元组(Tuple)、字符串(String)

序列的操作

Ø 索引:sequence[0]
Ø 切片:sequence[1:3]
Ø 相加:sequence1 + sequence2
Ø 乘法:sequence * 3
Ø 检查成员:x in sequence
Ø 计算长度:len(sequence)
Ø 计算最大值、最小值:max(sequence)、min(sequence)

列表List

Ø 列表是一个可变的、有序的元素集合
Ø 列表使用 [] 定义,数据之间使用 , 分隔。
Ø 列表中每个元素都有对应的位置值,称为索引或下标,索引从起始从0开始向后逐个递增,并且从末尾从-1开始逐个向前递减。
Ø 列表中元素可以是不同的类型。

创建列表

list1 = [100, 200, 300, 400, 500]

访问列表
通过索引获取列表中元素
list1 = [100, 200, 300, 400, 500]
print(list1[1])  # 200
print(list1[-2])  # 400
列表切片
list1 = [100, 200, 300, 400, 500]
print(list1)  # 取全部元素
print(list1[:])  # 复制整个列表
print(list1[2:4])  # 取索引从2开始到4(不包含)的元素
print(list1[2:])  # 取索引从2开始到末尾的元素
print(list1[:2])  # 取索引从0开始到2(不包含)的元素
print(list1[2:-1])  # 取索引从2开始到-1(不包含)的元素
print(list1[::-1])  # 倒序取元素
向列表中添加元素【append】
list1 = [100, 200, 300, 400, 500]
list1.append(600) # 在列表末尾追加元素
list1.insert(2,700) # 在列表指定的位置追加元素
print(list1)
列表相加
list1 = [100, 200, 300]
list2 = ["a", "b", "c"]
print(list1 + list2)  # [100, 200, 300, 'a', 'b', 'c']
列表乘法
list1 = [100, 200, 300]
print(list1 * 2)  # [100, 200, 300, 100, 200, 300]

修改列表中元素

通过下标修改
list1 = [100, 200, 300, 400, 500]
list1[0] = -1
print(list1)
通过切片修改
list1 = [100, 200, 300, 400, 500]
list1[2:4] = ["a", "b", "c"]
print(list1)
检查成员是否为列表中元素
list1 = [100, 200, 300]
print(100 in list1)  # True
获取列表长度
list1 = [100, 200, 300]
print(len(list1))  # 3
5.2.9 求列表中元素的最大值、最小值、加和
list1 = [100, 200, 300, 400, 500]
print(max(list1))  # 500
print(min(list1))  # 100
print(sum(list1))  # 1500

5.2.10 遍历列表
1)直接遍历列表元素
list1 = [100, 200, 300, 400, 500]
for i in list1:
    print(i)
    
2)通过下标遍历列表
list1 = [100, 200, 300, 400, 500]
for i in range(len(list1)):
    print(i, list1[i])
    
3)使用enumerate()同时获取列表的下标和元素
list1 = [100, 200, 300, 400, 500]
for i, val in enumerate(list1):
    print(i, val)
——-——————————————————————————
0 100
1 200
2 300
3 400
4 500
    
5.2.11 删除列表指定位置元素或者切片
list1 = [100, 200, 300, 400, 500]
del list1[2]
print(list1)

5.2.12 嵌套列表
列表中元素可以为列表。
list1 = [[1, 2, 3], [4, 5, 6], [7, 8, 9]]
for inner_list in list1:
    print(inner_list)

list2 = [100,200,300,400,500]
list2.insert(3,300)
# 删除第一次出现的x
list2.remove(300)
print(list2)
列表推导式

列表推导式是 Python 中一种简洁创建列表的方式,它将一个可迭代对象(如列表、元组、集合、字符串等)的元素通过某种运算或条件筛选后生成一个新的列表。

(1)基础的列表推导式
squares = [x**2 for x in range(5)]
print(squares)  # [0, 1, 4, 9, 16]

(2)带条件的列表推导式
squares = [x**2 for x in range(10) if x % 2 == 0]
print(squares)  # [0, 4, 16, 36, 64]

(3)使用现有列表的列表推导式
list1 = [1, 2, 3, 4, 5]
squares = [x**2 for x in list1]
print(squares)  # [1, 4, 9, 16, 25]

(4)包含多个循环的列表推导式
list1 = [1, 2, 3, 4, 5]
list2 = ["a", "b", "c", "d", "e"]
tuple_list = [(i, j) for i in list1 for j in list2]
print(tuple_list)

# i,j 为元素 组合成了(i,j)元组
# i在list1中 j在list2中

zip()函数

zip() 函数可将多个可迭代对象中对应元素打包为一个个元组。

list1 = [1, 2, 3, 4, 5]
list2 = ["a", "b", "c", "d", "e"]
zipped = zip(list1, list2)
print(list(zipped))
# [(1, 'a'), (2, 'b'), (3, 'c'), (4, 'd'), (5, 'e')]

列表常用方法

# 在指定位置插入x
list.insert(index,x)
# 在列表末尾追加x
list.append(x)
# 在列表1的末尾追加列表2的数据    
list1.extend(list2)    
# 删除指定位置的数据或切片
del list[index]    
# 删除第一次出现的x
list.remove(x)    
# 删除指定位置的数据,默认为末尾数据
list.pop([index])
# 清空列表中元素    
list.clear()    
# 修改指定位置的数据
list[index] = x    
# 修改列表切片的数据
list1[start:end] = list2    
# 返回排序后的新列表,可选降序
sorted(list[,reverse=True])    
# 对列表就地排序,可选降序
list.sort([reverse=True])
# 反转列表中的元素    
list.reverse()    
# 返回x在列表中首次出现的位置,可指定起始和结束范围
list.index(x[,start,[,end]])    
# 返回x的数量
list.count(x)    
# 返回列表元素个数
len(list)    
# 返回列表中最大值
max(list)    
# 返回列表中最小值
min(list)    
# 返回列表中所有元素和
sum(list)    
# 拷贝列表
list.copy()    
# 将序列转换为列表
list(x)    

列表元素遍历

list1 = [100, 200, 300, 400, 500]
for i in range(0,len(list1)):
    print(i, list1[i])

0 100
1 200
2 300
3 400
4 500

列表 list

  • list是可变的,可以对list中的元素进行修改
  • list是有序的,每个元素都有对应的下标(索引),可以通过索引获取元素以及对list进行切片操作
  • list中可以存放不同类型的元素
  • 使用[]定义list

字符串 String(是不可变的)

  • str是不可变的,不能直接对原字符串进行修改, 如果修改会创建新的对象
  • str是有序的,字符串中的每个字符都有对应的下标(素引) ,可以通过索引获取字符以及队str进行切片操作
  • str的定义方式:
单引号
双引号 
# 三引号可以保留字符串的样式
三引号
str1 = """abc
def"""

# 获取字符以及字符串切片
print(str1[3])
print(str1[1:5])
print(str1[:5])
print(str1[:]) #原输出
print(str1[::-1]) #逆向获取
5.3.1创建字符串
str1 = "hello world"

5.3.2访问字符串
str1 = "hello world"
print(str1[0])
print(str1[-1])
print(str1[4:-3])

5.3.3字符串相加
str1 = "hello world"
str2 = "dlrow olleh"
print(str1 + str2)  # hello worlddlrow olleh

5.3.4字符串乘法
str1 = "hello world"
print(str1 * 2)  # hello worldhello world

5.3.5检查成员是否为字符串中元素
str1 = "hello world"
print("lo" in str1)  # True

5.3.6原始字符串
所有的字符串按照字面意思处理,没有转义字符。需在字符串前加上r / R。
print("hello\nworld")
print(r"hello\nworld")
print(R"hello\t\tworld")

常用函数

函数 说明
str.replace(old,new[,max]) 把将字符串中的old替换成new,如果指定max,则替换不超过max次
str.split([x][,n]) 按x分隔字符串,默认按任何空白字符串分隔并在结果中丢弃空字符串。可指定最大分隔次数
str.rsplit([x] [,n]) 与split()类似,从右边开始分隔
join(seq) 以x作为分隔符,将序列中所有的字符串合并为一个新的字符串
str.strip([x]) 截掉字符串两边的空格或指定字符
str.lstrip([x]) 截掉字符串左边的空格或指定字符
str.rstrip([x]) 截掉字符串右边的空格或指定字符
list1 = ["a","b","c","d","e","f"]
str1 = "-".join(list1)
print(str1)
# a-b-c-d-e-f

list1 = "abcdefg"
str1 = list1.find("g")
print(str1)
# 6

str1 = list1.find("d",3,5)
print(str1)
# 3

元组 tuple

  • tuple是不可变的,不能直接队元组中的元素进行修改
  • tuple是有序的,每个元素都有对应的下标(索引),可以通过索引获取元组中以及队元组进行切片
  • tuple中可以存放不同类型的数据
  • 使用()定义tuple
# 创建元组对象
tup = (100,200,300,400,500)
# 如果元组中只有一个元组,那么在元素的后面也需要加','
tup1 = (100,)
# 使用元组推导式 创建元组
list1 = [i*2 for i in range(10)]

print(tup)
print(tup1, type(tup1))
# (100, 200, 300, 400, 500)
# (100,) <class 'tuple'>


# 访问元组
tuple1 = (100,200,300,400,500)
print(tuple1[-2])
# 400


#元组相加
tuple1 = (100, 200, 300)
tuple2 = ("a", "b", "c")
print(tuple1 + tuple2)  
# (100, 200, 300, 'a', 'b', 'c')


#元组相乘
tuple1 = (100, 200, 300)
print(tuple1 * 2)  
# (100, 200, 300, 100, 200, 300)


#检查成员是否为元组中元素
tuple1 = (100, 200, 300, 400, 500)
print(300 in tuple1)  
# True


#获取元组长度
tuple1 = (100, 200, 300, 400, 500)
print(len(tuple1))  
# 5


#求元组中元素的最大值、最小值、加和
tuple1 = (100, 200, 300, 400, 500)
print(max(tuple1))  # 500
print(min(tuple1))  # 100
print(sum(tuple1))  # 1500


#遍历元组
tuple1 = (100, 200, 300, 400, 500) 

for i in tuple1:
    print(i)

for i in range(len(tuple1)):
    print(i, tuple1[i])

for i, val in enumerate(tuple1):
    print(i, val)
    

元组的不可变

元组的不可变指的是元组所指向的内存中的内容不可变,但可以重新赋值

tuple1 = (100, 200, 300)
print(id(tuple1), tuple1)
tuple1 = tuple1 + (1, 2, 3)
print(id(tuple1), tuple1)

如果元组中元素是可变数据类型,其嵌套项可以被修改

tuple1 = (100, 200, 300, [1, 2, 3])
tuple1[3].append(4)
print(tuple1)  # (100, 200, 300, [1, 2, 3, 4])

集合Set

  • 集合是无序的,且不包含重复元素。
  • 集合使用 {} 定义,数据之间使用 , 分隔,也可以使用set()定义。
  • 集合没有索引,所以不能通过切片方式访问集合元素。
  • 集合中元素可以是不同的类型。
  • 集合可以进行数学上的集合操作,如并集、交集和差集。
  • 集合适用于需要快速成员检查、消除重复项和集合运算的场景。

创建集合

可以通过{}或set()创建集合,但创建空集合需要使用set()而非{},因为{}会创建空字典。

set1 = {1, 2, 3}
set2 = set([1, 2, 3])  # 使用set()函数从列表创建集合
set3 = set()
print(set1, set2, set3)

也可以通过集合推导式创建集合。

set1 = {x for x in range(10) if x % 2 == 0}
print(set1)  # {0, 2, 4, 6, 8}

向集合中添加元素

set1 = {1, 2, 3}
set1.add(4)
set1.add(5)
print(set1)

从集合中删除元素

set1 = {1, 2, 3}
set1.remove(2)
print(set1)

检查成员是否为集合中元素

set1 = {1, 2, 3, 4, 5}
print(2 in set1)  # True

获取集合长度

set1 = {1, 2, 3, 4, 5}
print(len(set1))  # 5

求集合中元素的最大值、最小值、加和

set1 = {1, 2, 3, 4, 5}
print(max(set1))  # 5
print(min(set1))  # 1
print(sum(set1))  # 15

遍历集合

set1 = {1, 2, 3, 4, 5}
for item in set1:
  print(item)

# 变量去掉 不需要
for _ in rang(len(set1))
  print(set1.pop())
#添加元素
set.add(x)
#添加元素,x可以为列表、元组、字符串、字典等可迭代对象
set.update(x)    
#添加元素后返回一个新的集合,x可以为列表、元组、字符串、字典等可迭代对象
set.union(x)    
#从集合中移除x,x不存在则报错 
set.remove(x)    
#从集合中移除x,x不存在也不报错
set.discard(x)     
#【随机取出】集合中的一个元素,如果集合为空则报错
set.pop()
#清空集合
set.clear()    
#求set1和x1的差集,返回一个新的集合
set.difference(x1,...)
#求set1和x1的差集
set.difference_update(x1,...)    
#求set1和x1的交集,返回一个新的集合
set.intersection(x1,...)    
#求set1和x1的交集
set.intersection_update(x1,...)    
#两集合求交集
set1 & set2    
#两集合求并集
set1 | set2    
#两集合求差集
set1 - set2    
#判断两集合是否没有交集
set1.isdisjoint(set2)
#判断set1是否为set2的子集
set1.issubset(set2)    
#判断set2是否为set1的子集
set1.issuperset(set2)    
#求两集合中不重复的元素,返回一个新的集合
set1.symmetric_difference(set2)    
#求两集合中不重复的元素
set1.symmetric_difference_update(set2)    
#拷贝集合
set.copy()    
#返回集合元素个数
len(set)
#求集合中元素的最大值
max(set)    
#求集合中元素的最小值
min(set)    
#求集合中元素的加和
sum(set)    

字典Dictionary [k:v键值对形式]

  • 一个无序的键值对集合,键是唯一的,而值可以重复。
  • 字典使用 {} 定义,键(key)和值(value)使用 : 连接,每个键值对之间使用 , 分隔。如{key1 : value1**,** key2 : value2}
  • 字典没有索引。
  • 字典可以通过键来获取对应的值。
  • 值可以取任何数据类型,但键必须是不可变的,如字符串、数字、元组。
空集合可以通过dict1={}或set=()去创建
可以通过{}或dict()创建字典
dict1 = {}
dict2 = dict()
dict3 = {"name": "Alice", "age": 18, "gender": "male"}
dict4 = dict(name="Bob", age=20, gender="female")
dict5 = dict([("name", "Tom"), ("age", 22), ("gender", "male")])
print(dict1)
print(dict2)
print(dict3)
print(dict4)
print(dict5)
也可以通过字典推导式创建字典
squares = {x: x**2 for x in range(4)}
print(squares)  # {0: 0, 1: 1, 2: 4, 3: 9}
访问字典

可通过 [] 访问字典中的元素。key不存在时会报错

dict1 = {"name": "Alice", "age": 18, "gender": "male"}
print(dict1["name"])  # Alice
print(dict1["age"])  # 18
print(dict1["gender"])  # male
print(dict1["address"])  # 报错

也可以通过get()获取字典中的元素。key不存在时会返回None,也可以指定默认值。

dict1 = {"name": "Alice", "age": 18, "gender": "male"}
print(dict1.get("name"))  # Alice
print(dict1.get("age"))  # 18
print(dict1.get("gender"))  # male
print(dict1.get("address"))  # None
# 这里earth是默认值 如果找不到address的value就默认是earth
print(dict1.get("address", "earth"))  # earth
向字典中添加元素

为字典指定的key赋值value,若key原本不存在则会被添加

dict1 = {"name": "Alice", "age": 18, "gender": "male"}
dict1["address"] = "earth"
print(dict1)

#{'name': 'Alice', 'age': 18, 'gender': 'male', 'address': 'earth'}
修改字典中元素

通过key修改对应的value

dict1 = {"name": "Alice", "age": 18, "gender": "male"}
dict1["name"] = "Bob"
print(dict1)

#{'name': 'Bob', 'age': 18, 'gender': 'male', 'address': 'earth'}
检查成员是否为字典中的key
dict1 = {"name": "Alice", "age": 81, "gender": "male"}
print("name" in dict1)  # 检查key是否存在
print("Alice" in dict1)  # 无法直接检查value是否存在

获取字典长度

dict1 = {"name": "Alice", "age": 81, "gender": "male"}
print(len(dict1))  # 3
遍历字典
dict1={"name":"tom","age":18}
#遍历所有k
allKeys = dict1.keys()
for i in allKeys:
    print(i)
print("*********")

#遍历所有v
allValues = dict1.values()
for k in allValues:
    print(k)
print("*********")

#遍历所有k-v
for i in allKeys:
    print(i + "---" + str(dict1[i]))
或
    print(f"{i}---{dict1[i]}")
print("*********")

------------------------------------
*********
tom
18
*********
name---tom
age---18
*********
方法2

item一般对容器来讲 是代表当前容器的元素项
对于字典来讲 是每个元素是配对键值对形式

items = dict1.items()
print(items)
print(type(items))
for item in items:
    print(item)
----------------------
dict_items([('name', 'tom'), ('age', 18)])
<class 'dict_items'>
('name', 'tom')
('age', 18)
删除字典元素
my_dict = {'Name': 'Tom', 'Age': 17}
del my_dict['Name'] # 删除键 'Name'
# my_dict.clear()     # 清空字典
# del my_dict         # 删除字典

print (my_dict)
常用函数
#根据key删除键值对
del dict[key]
#获取key所对应的value,同时删除该键值对,可设置默认值
dict.pop(key[,default])
#取出字典中的最后插入的键值对,字典为空则报错
dict.popitem()
#清空字典
dict.clear()
#将dict2中的键值对更新到dict1中
dict1.update(dict2)
#获取字典中key对应value,可设置默认值
dict.get(key[,default])
#获取字典中key对应value,可设置默认值。若key不存在于字典中,将会添加key并将value设为默认值
dict.setdefault(key[,default])
#获取字典所有的key,返回一个视图对象。字典改变,视图也会跟着变化
dict.keys()
#获取字典所有的value,返回一个视图对象
dict.values()
#获取字典所有的(key,value),返回一个视图对象
dict.items()
#拷贝字典
dict.copy()
#以序列seq中元素做字典的key创建一个新字典,可设置value的默认值
dict.fromkeys(seq[,default])

列表、元组、字典和集合的区别

数据结构 是否可变 是否重复 是否有序 定义符号
列表【List】 可变 允许 有序 []或list()
元组【Tuple】 不可变 允许 有序 ()或tuple()
字典【Dictionary】 可变 键不允许,值允许 键无序(Python 3.7+版本中保持插入顺序) {}或dict()
集合【Set】 可变 允许 无序 {}或set()

函数

  • 直观理解,带名字的代码块
  • 将完成某一块功能的代码抽取出来,取一个名字,就是函数。如果以后再要完成这个功能的时候,就不需要再编写整体代码了,直接通过名字去调用函数即可。
案例:打印两次2x3的*
'''
    该案例演示了函数的抽取以及调用
    打印如下图形
        ***
        ***
        -------
        ***
        ***
'''
# 定义一个函数,该函数完成打印输出2*3 "*"的功能
def printStar() :
    '''
        这是对函数功能的说明
    '''
    row = 2
    while row > 0 :
        print("*" * 3)
        row -= 1

# 调用函数
printStar()
print("-" * 20)
printStar()

(1)注意:

  • 函数必须先定义再调用
  • 函数在定义的时候只是告诉解释器我定义了一个这样的函数,可以完成某些功能,但是这个时候函数还没有执行,需要调用函数后,才会执行。

函数的定义

语法:

def 函数名(参数列表)
     函数体
    [return]

说明:
       "def" 是定义函数的关键字
#   函数名:程序员自己定义的,需要遵循标识符的命名规范
    函数名后,跟着一对小括号,里面放的是参数列表
        参数,函数执行的时候需要依赖的值
        参数可以有多个,多个参数之间用逗号分隔
        如果没有参数,小括号不能省略
    用:结束函数的声明
    函数具体完成的功能在函数体中实现,需要进行缩进
    通过return关键字将函数执行的结果返回给调用者【可以不加,默认返回值是None】 
--------------------------------------------------------------------
def print_star():
    num = 2
    while num > 0:
        print("*" * 3)
        num -= 1
print_star()
print("-" * 30)
print_star()
函数的形参和实参

在函数的提供者定义函数时候,声明的参数称之为形式参数
def print_star(rows,clos):
在函数的调用者调用函数的时候,传递的参数称之为实际参数
print_star(100,3)

注意:在函数声明的时候,并没有给形式参数分配内容空间,只是做了一个占位
在调用的时候,会将实参的地址引用赋值给形参

# 原始方法
def print_star_1():
    num = 2
    while num > 0:
        print("*" * 3)
        num -= 1

def print_star_2():
    num = 1
    while num > 0:
        print("*" * 6)
        num -= 1
        
print_star_1()
print("~" * 30)
print_star_2()

------------------------------

# 抽取函数(加参数)
def print_star(rows,clos):
    while rows > 0:
        print("*" * clos)
        rows -= 1

print_star(2,3)
------------------------------
***
***

赋值操作情况说明

对于参数传递的是可变数据类型

var1 *= 2 使用了原地址
var1 = var1 * 2 开辟了新的空间

参数传递的形式【*a是要传元组(val1,val2)、**a是要传字典{key,val}】

  • 必须参数【参数个数和顺序要一致 通过位置进行赋值】

  • 关键字参数【传递实参的时候要带名称且一致,位置可以不一致】

  • 默认值参数【在定义参数的时候,可以给参数指定默认值;形参数量可以和实参数量不一致,不传参则默认值】

  • 不定长参数

    • 【def 函数名([普通参数], *不定长参数名, [普通参数2])】调用时,普通参数1是按照位置进行匹配的;普通参数2按照关键字进行匹配;处理不定长参数时,使用元组进行处理

      def func(num,*args,plu):
          print(num)
          print(args)
          print(plu)
      func(3, 2,1,1,1,1, plu = 666)
      -------------------------
      3
      (2, 1, 1, 1, 1)
      666
      
    • 【def 函数名([普通参数], **不定长参数名)】调用时,普通参数1是按照位置进行匹配的;不定长参数后面不允许出现其他的参数;处理不定长参数时,使用字典{key:value}进行处理

      def func(num,**args):
          print(num)
          print(args)
      func(300, a = 1,b =2 ,c = 3,d = 4)
      -------------------------
      300
      {'a': 1, 'b': 2, 'c': 3, 'd': 4}
      
      def func(**args):
          print(arg)
      func(**{"name":"zs","age":18})
      

不定长参数可以在形参前面加”*”【定义的是元组】

def func(num,*args):
    print(num)
    print(args)
func(3, 2,1,1,1,1)

(1)注意:

Ø 加了星号 * 的参数会以元组(tuple)的形式导入,存放所有未命名的变量参数。

Ø 如果形参中出现了不定长参数,那么在调用函数的时候,先通过位置进行必须参数的匹配,然后不定长参数后面的参数必须通过关键字参数匹配

Ø 如果不定长的参数后面还有参数,必须通过关键字参数传参

def func(num,*args):
    print(num)
    print(args)
func(3, 2,1,1,1,1, num1 = 300)

Ø 还有一种就是参数带两个星号 **的可变长参数,基本语法如下:

def 函数名([普通参数,] **var_args_dict ):
   函数体

加了两个星号 ** 的参数会以字典的形式导入,后面就不能再有其他参数了

'''
    该案例演示了函数调用时的不定长参数
'''
def printInfo(num,**vardict):
    print(num)
    print(vardict)
    # return

printInfo(10,key1 = 20,key2 = 30)
printInfo(10,a = 20,b = 30)

解包传参

若函数的形参是定长参数,可以通过 * 和 ** 对列表、元组、字典等解包传参。

def func(a, b, c):
    return a + b + c
tuple11 = (1, 2, 3)
print(func(*tuple11))

# 字典中key的名称和参数名必须一致
dict1 = {"a": 1, "b": 2, "c": 3}
print(func(**dict1))

---------------------------------
6
6

#若是直接 print(a,b,c) => 1,2,3

强制使用位置传参或关键字参数

/ 前的参数必须使用位置传参,* 后的参数必须用关键字传参。

def f(a, b, /, c, d, *, e, f):
    print(a, b, c, d, e, f)

f(1, 2, 3, d=4, e=5, f=6) 

浅拷贝

"""
    通过函数修改列表中元素的练习题
    需求:要函数对列表进行处理,又不希望函数修改原列表
    例如:
        有一个列表,list[1,2,3,[100,200,300]]
        定义一个函数,向列表中的子列表后追加一个新的元素400 => list[1,2,3,[100,200,300,400]]
"""
def change_list(m_list):
    print(f"函数内修改列表前列表地址:{id(m_list)},列表中的元素:{m_list}")
    m_list[3].append(400)
    print(f"函数内修改列表前列表地址:{id(m_list)},列表中的元素:{m_list}")

list1 = [1,2,3,[100,200,300]]
print(f"函数外列表地址:{id(list1)},列表中的元素:{list1}")
list2 = list1.copy()
print(id(list2))
print(id(list1))
change_list(list1)
print(f"函数外调用函数后列表地址:{id(list1)},列表中的元素:{list1}")

#浅拷贝
# list2 = list1.copy()
#深拷贝
# list2 = copy.deepcopy(list1)
-----------------------------------------------
函数外列表地址:2259355396224,列表中的元素:[1, 2, 3, [100, 200, 300]]
2259354860416
2259355396224
函数内修改列表前列表地址:2259355396224,列表中的元素:[1, 2, 3, [100, 200, 300]]
函数内修改列表前列表地址:2259355396224,列表中的元素:[1, 2, 3, [100, 200, 300, 400]]
函数外调用函数后列表地址:2259355396224,列表中的元素:[1, 2, 3, [100, 200, 300, 400]]

返回值

在程序开发中,有时候希望一个函数执行结束后,告诉调用者一个结果,以便调用者针对具体的结果做后续的处理。返回值就是函数完成工作后,给调用者的一个结果

Ø 在函数中使用 return 关键字可以返回结果 ,并结束正在执行的函数

Ø 如果return后面跟[表达式],在结束函数的同时向调用方返回一个表达式。

Ø 如果仅仅是return关键字,后面没有加内容,函数执行返回调用方None。

Ø 调用函数一方,可以使用变量来接收函数的返回结果

(1)不带表达式的 return 语句,返回 None。

def f(a, b, c):
    pass
    return

print(f(1, 2, 3))  # None

(2)函数中如果没有 return 语句,在函数运行结束后也会返回 None。

def f(a, b, c):
    pass

print(f(1, 2, 3))  # None

(3)用变量接收返回结果

def add(num1,num2) :
    '''求两个数的和'''
    sum1 = num1 + num2
    return sum1

res = add(10,20)
print("两个数的和为:" ,res)

(4)return 语句可以返回多个值,多个值会放在一个元组中。

def f(a, b, c):
    return a, b, c, [a, b, c]
print(f(1, 2, 3))  # (1, 2, 3, [1, 2, 3])

什么是闭包【可以延长局部变量的生命周期 】

当调用的函数执行完毕后,函数内的变量就会被销毁。但有时希望在调用函数后函数内的数据能够保存下来重复使用,这时候可以用到闭包。闭包可以避免使用全局值,并提供某种形式的数据隐藏。

构建闭包的条件:

Ø 外部函数内定义一个内部函数。

Ø 内部函数用到外部函数中的变量。

Ø 外部函数将内部函数作为返回值。

# 构建闭包
def linear(a, b):
    def inner(x):
        return a * x + b

    return inner

y1 = linear(1, 1)
print(y1)  # <function linear.<locals>.inner at 0x00000291279D19E0>
print(y1(5))  # 6

将调用 linear() 后返回的函数对象赋值给 y1,虽然 linear() 函数已经执行完毕,但是我们调用 y1() 时,y1() 仍然记得 linear() 中 a 和 b 的值。

查看闭包中的值

所有函数对象都有一个 closure 属性,如果它是一个闭包函数,则该属性返回单元格对象的元组。

def linear(a, b):
    def inner(x):
        return a * x + b

    return inner

y1 = linear(1, 2)
objects = y1.__closure__
print(objects)
print(objects[0].cell_contents)  # 1
print(objects[1].cell_contents)  # 2

全局变量和局部变量

全局变量-作用于整个模块
局部变量-作用于当前函数
在局部作用域内,如果给变量进行赋值操作,会将遍历当做局部变量进行处理

'''
    该案例演示了全局变量和局部变量
'''
sum = 0 # 这是一个全局变量

def add(num1,num2) :
    sum = num1 + num2 # 这是一个局部变量
    print("函数内局部变量的值:",sum,id(sum))
    return sum

add(10,20)
# print(num1) # num1访问不到
print("函数外全局变量:",sum,id(sum))

_global和nonlocal关键字

_global

在函数内使用 global 声明全局变量
函数内使用 global 声明全局变量后,可以修改全局变量。

var1 = 10
def func():
    # 声明:当前在局部作用域中使用全局的变量 var1
    global var1
    var1 = 20
    print(f"局部作用域中的var1={var1, id(var1)}")
func()
print(f"全局作用域中的var1={var1, id(var1)}")

----------------------------------------
局部作用域中的var1=(20, 2091892605776)
全局作用域中的var1=(20, 2091892605776)


list1 = [1,2,3]
def func():
    # 声明:当前在局部作用域中使用全局的变量 var1
    list1[0] = 100
    print(f"局部作用域中的var1={list1, id(list1)}")
func()
print(f"全局作用域中的var1={list1, id(list1)}")
-----------------------------------------
局部作用域中的var1=([100, 2, 3], 1992346097088)
全局作用域中的var1=([100, 2, 3], 1992346097088)
nonlocal

nonlocal 也用作内部作用域修改外部作用域的变量的场景,不过此时外部作用域不是全局作用域而是嵌套作用域。

def outer():
    var1 = 10
    def inner():
        nonlocal var1
        var1 = 20
        print(f"局部作用域中的var1={var1, id(var1)}")
    inner()
    print(f"嵌套作用域中的var1={var1, id(var1)}")
outer()
------------------------------------------
局部作用域中的var1=(20, 1769305604944)
嵌套作用域中的var1=(20, 1769305604944)

递归

递归是一种逻辑思想,将一个大工作分为逐渐减小的小工作,比如说一个和尚要搬50块石头,他想,只要先搬走49块,那剩下的一块就能搬完了,然后考虑那49块,只要先搬走48块,那剩下的一块就能搬完了……,递归是一种思想,只不过在程序中,就是依靠函数嵌套这个特性来实现了

本质:递归调用就是在函数体中又调用了函数本身

匿名函数的定义

匿名函数

语法

Python使用 lambda 来定义匿名函数,所谓匿名,指其不用 def 的标准形式定义函数。

lambda 参数列表: 表达式

Ø lambda 只是一个表达式,函数体比def简单很多。
Ø lambda的主体是一个表达式,而不是一个代码块,所以仅仅能在lambda表达式中封装有限的逻辑进去。
Ø lambda函数拥有自己的命名空间,且不能访问自己参数列表之外或全局命名空间里的参数。

普通函数传参
def operator(a, b):
    return a + b
def function(a, b, operator):
    return operator(a, b)
print(function(1, 2, operator))
匿名函数传参
def function(a, b, operator):
    return operator(a, b)
print(function(1, 2, lambda x, y: x + y))

匿名函数作为内置函数的参数

可以将匿名函数与常用的内置参数搭配使用。

  • sorted()
#有三名学生的姓名和年龄,按年龄排序。
student_list = [{"name": "zhang3", "age": 36}, {"name": "li4", "age": 14}, {"name": "wang5", "age": 27}]
print(sorted(student_list, key=lambda x: x["age"]))
-----------------------------------------------------
student_list.sort(key= lambda stu: stu["age"])
print(student_list)
-----------------------------------------------------
def getKey(std):
    return std["age"]
student_list.sort(key=getKey)
print(student_list)
  • map()
map() #函数对序列中元素逐一处理。
map_result = map(lambda x: x * x, [0, 1, 3, 7, 9])
print(list(map_result))  # [0, 1, 9, 49, 81]
----------------------------------------------------
list1 = [1,2,3,4,5,6,7,8,9,10]
print(list(map(lambda item: item * item, list1)))
  • filter()
filter() #函数对序列中元素过滤。
filter_result = filter(lambda x: x >= 0, [-0, -1, -3, 7, 9])
print(list(filter_result))  # [0, 7, 9]
  • reduce()
reduce() #函数对序列中元素进行累积。
from functools import reduce

reduce_result = reduce(lambda x, y: x * y, [1, 2, 3, 4, 5])
print(reduce_result)  # 120

文件操作

文件的基本概念

在计算机中,文件是存储在磁盘上的数据集合。文件可以包含各种类型的数据,如文本、图像、音频、视频或程序代码。

文件系统通过文件名和文件路径来定位和管理文件。文件名通常包含文件的名称和扩展名,扩展名用于表示文件的类型(例如 .txt 表示文本文件,**.jpg** 表示图像文件)。文件路径可以是绝对路径(从文件系统的根目录开始)或相对路径(相对于当前工作目录)。

在编写程序的时候,数据是以二进制的形式存储在内存的,将数据写到磁盘文件的过程称之为持久化。

文件的分类

1)纯文本文件

有统一的编码,可以被看做存储在磁盘上的长字符串。

纯文本文件编码格式常见的有ASCII、ISO-8859-1、GB2312、GBK、UTF-8、UTF-16等。

2)二进制文件

没有统一的字符编码,直接由0与1组成。

如图片文件(jpg、png),视频文件(avi)等。

文件的打开与关闭

1)打开文件

使用 open() 打开或创建文件,该方法执行完毕之后返回的是一个file对象。

常用形式
open(文件名, 模式)
f = open("test.txt", "w")
模式       说明
r        读写方式:只读,文件若不存在会报错。默认此模式
w        读写方式:写入,写入前清空原有数据。文件不存在会创建文件
a        读写方式:追加写入,在原有数据后追加,文件不存在会创建文件
x        读写方式:创建新文件并写入,文件若已存在会报错
b        编码方式:以二进制打开。一般用于非文本文件如图片等
t        编码方式:以文本模式打开,默认此模式
+        能读能写

2)完整形式

open(
    file,  # 文件路径   ★★★★★★★★★
    mode="r",  # 文件打开模式
    buffering=-1,  # 缓冲
    encoding=None,  # 文本编码方式,一般用utf8  ★★★★★★★★★
    errors=None,  # 报错级别
    newline=None,  # 区分换行符
    closefd=True,  # 传入的file参数类型
    opener=None,  # 设置自定义开启器,开启器的返回值必须是一个打开的文件描述符
)

3)关闭文件

f.close()

读写数据

"""
    该案例演示了读写文件操作
"""

"""

# 向文件中写入数据
# 打开文件(建立程序和文件之间的通道)
f = open("test.txt","w")

# 向文件中写入数据
f.write("hello world\n")
f.write("nihao python\n")

# 关闭和文件之间的建立的通道
f.close()
"""
# 从文件中读取数据
# 打开文件(建立程序和文件之间的通道)
f = open("test.txt","r")
# 从文件中读取数据   read() 默认读取所有数据
# print(f.read())
# 从文件中读取指定的字节大小数据
# print(f.read(5))
# print(f.read(8))

# 读取一行数据
# print(f.readline())

# 读取所有行
print(f.readlines())

# 关闭和文件之间的建立的通道
f.close()

1)read

read([size]) 可以从文件中读取数据,size 表示要从文件中读取的数据的长度(单位是字节),如果没有传入 size 则读取文件中所有的数据。

# 打开文件
f = open("test.txt", "rt")
# 读取文件所有数据 
print(f.read())
# 关闭文件
f.close()
print("-"*20)
f = open("test.txt", "rt")
# 读取文件5个字节数据
print(f.read(5))
print(f.read(8))
f.close()

2)readline

readline([size]) 可以从文件中读取整行数据,也可以通过 size 设置读取数据的长度。

f = open("test.txt", "rt")
print(f.readline())
print(f.readline(1))
f.close()

3)readlines

readlines([size]) 读取所有行并返回列表,若给定 size>0,返回总和大约为 size 字节的行, 实际读取值可能比 size 大。

f = open("test.txt", "r", encoding="utf-8")
print(f.readlines())
f.close()
常用函数
函数    说明
# 移动偏移量并返回新的绝对位置
file.seek(offset[,from])    。
offset:移动的字节数,如果是负数表示从倒数第几位开始。
from:从哪个位置开始移动;0为开头,1为当前位置,2为末尾。from不为0时需使用'b'二进制模式打开文件。
# 返回当前偏移量
file.tell()
# 从开头开始截断文件为size个字符,无size表示从当前位置截断。windows系统下的换行大小2个字符
file.truncate([size])    
# 将序列中字符串写入文件,需要自己加入换行符
file.writelines(seq)    
# 如果可以读取文件则返回True
file.readable()    
# 如果可以写入文件则返回True
file.writeable()    
# 如果文件支持随机访问则返回True
file.seekable()    
# 重命名文件
os.rename(old,new)
# 删除文件
os.remove(file)
# 创建目录,不支持递归创建
os.mkdir(dir)
# 递归创建目录
os.makedirs(dir)    
# 获取当前路径
os.getcwd()    
# 进入指定目录
os.chdir(dir)
# 获取目录下文件和目录列表
os.listdir(dir)    
# 删除空目录
os.rmdir(dir)    
# 递归删除空目录
os.removedirs(dir)    
# 将相对路径转换为绝对路径
os.path.abspath(path)    
# 获取路径中的文件名部分
os.path.basename(path)    
# 获取路径中的目录部分
os.path.dirname(path)    
# 拼接多个路径,自动处理路径分隔符
os.path.join(*paths)    
# 将路径分割为目录和文件名的元组
os.path.split(path)    
# 将路径分割为文件名和扩展名的元组
os.path.splitext(path)    
# 判断路径是否存在
os.path.exists(path)    
# 判断路径是否为文件
os.path.isfile(path)    
# 判断路径是否为目录
os.path.isdir(path)    
# 获取文件的大小,以字节为单位
os.path.getsize(path)    
# 获取文件的最后访问时间
os.path.getatime(path)    
# 获取文件的最后修改时间
os.path.getmtime(path)    

图片拷贝

def file_copy(source_file_path, dest_file_path):
    # 打开源文件
    source_file = open(source_file_path, 'rb')
    # 从源文件中读取数据
    content = source_file.read()
    # 打开目标文件
    dest_file = open(dest_file_path, 'wb')
    # 将内容写到目标文件
    dest_file.write(content)
    # 关闭源文件
    source_file.close()
    # 关闭目标文件
    dest_file.close()
file_copy("c:\\Users\\Pluminary\\Desktop\\HouDuan\\22.png","c:\\Users\\Pluminary\\Desktop\\HouDuan\\echos\\11.png")
图片拷贝优化[不要一次性读取完,要指定读取字节]
def file_copy(source_file_path, dest_file_path):
    # 打开源文件
    source_file = open(source_file_path, 'rb')
    # 打开目标文件
    dest_file = open(dest_file_path, 'wb')

    # 从源文件中读取数据
    content = source_file.read(1024)

    # 将内容写到目标文件
    while content:
        dest_file.write(content)
        content = source_file.read(1024)
    # 关闭源文件
    source_file.close()
    # 关闭目标文件
    dest_file.close()
file_copy("c:\\Users\\Pluminary\\Desktop\\HouDuan\\22.png","c:\\Users\\Pluminary\\Desktop\\HouDuan\\echos\\1.png")

面向对象之类和对象

面向过程编程(Procedural Programming)和面向对象编程(OOP)是两种不同的编程范式,它们在软件开发中都有广泛的应用。

Python是一种混合型的语言,既支持面向过程的编程,也支持面向对象的编程。

面向过程的编程是一种以过程为中心的编程方式,主要关注解决问题的步骤,并将这些步骤写成函数或方法。

面向对象的编程是一种以对象为中心的编程方式,主要关注在解决问题的过程中涉及哪些对象以及这些对象如何交互

"""
    该案例对比面向过程变成、面向函数式编程、面向对象编程

    准备做3道菜,通过程序描述出每道菜的做菜流程
    东北大拉皮
    东北大乱炖
    锅包肉

    *的意思是:可能要拌多种食物
"""

# 面向对象的编程
class 菜:
    def __init__(self,name):
        self.name = name

    def 洗(self,clm):
        print(f"{self.name}洗{clm}")

    def 切(self,clm):
        print(f"{self.name}切{clm}")

    def 拌(self,*clm):
        print(f"{self.name}拌{clm}")

    def 炖(self,*clm):
        print(f"{self.name}炖{clm}")

    def 炸(self,clm):
        print(f"{self.name}炸{clm}")

    def 上菜(self):
        print(f"{self.name}上菜")
        
# dlp是面向对象的对象
dlp = 菜("东北大拉皮")
dlp.洗("黄瓜")
dlp.洗("拉皮")
dlp.切("黄瓜")
dlp.拌("黄瓜","拉皮","调料")
dlp.上菜()


"""
面向函数的编程方式
def 东北大拉皮(func):
    洗("黄瓜")
    洗("拉皮")
    切("黄瓜")
    拌("黄瓜", "拉皮", "调料")
    上菜("东北大拉皮")

def 东北大乱炖():
    洗("白菜")
    洗("豆角")
    洗("土豆")
    切("肉")
    炖("白菜", "土豆", "豆角", "肉", "玉米", "粉条", "调料")
    上菜("东北大乱炖")

def 小酥肉():
    洗("肉")
    切("肉")
    拌("肉", "淀粉")
    炸("肉")
    上菜("小酥肉")
    print("~" * 30)
东北大拉皮()
东北大乱炖()
小酥肉()
"""


"""
    面向过程的编程方式
        适合一些简单的流程和步骤,如果业务比较复杂,不太合适
# 东北大拉皮
洗("黄瓜")
洗("拉皮")
切("黄瓜")
拌("黄瓜","拉皮","调料")
上菜("东北大拉皮")
print("~"*30)
# 东北大乱炖
洗("白菜")
洗("豆角")
洗("土豆")
切("肉")
炖("白菜","土豆","豆角","肉","玉米","粉条","调料")
上菜("东北大乱炖")
print("~"*30)
# 小酥肉
洗("肉")
切("肉")
拌("肉","淀粉")
炸("肉")
上菜("小酥肉")
print("~"*30)
"""

类和对象的概念

类是大量对象共性的抽象

  • 有什么——属性
  • 能做什么——方法

在程序中,类是创建对象的模板
类是客观事物在人脑中的主观反应

对象在自然界中,只要是客观存在事物都是(万物皆对象)
类是抽象的,对象是具体的

类的组成

  • class类名:
  • 属性
    • 类属性
    • 实例属性
  • 方法
    • 类方法
    • 实例方法
    • 静态方法
    • 特殊方法(魔法方法)

定义类

1)语法

class 类名:
  """类说明文档"""
  类体

类名一般使用大驼峰命名法。
类体中可以包含类属性(也叫类变量)、方法、实例属性(也叫实例变量)等。

"""
    该案例演示了简单的类的定义以及对象的创建
"""

# 定义一个学生类
class Student:
    '''这是一个学生类'''
    # 类属性   所有类的实例共享的
    school = "atguigu"

    # 在创建学生对象(实例)的时候,会自动调用的方法
    def __init__(self, name, age):
        # 定义实例属性   每个实例属性是独立的,相互不影响
        self.name = name
        self.age = age

    # 实例方法  方法第一个参数是self,表示当前实例对象
    # 对象.方法() 调用当前方法的时候,会将当前对象自身作为参数传递给方法
    def play_game(self):
        print(f"{self.age}岁的{self.name}正在专注的玩着游戏")

    def study(self):
        print(f"{self.age}岁的{self.name}正在有一搭没一搭的学着")

    def video(self):
        print(f"{self.age}岁的{self.name}正在录着视频")

# 通过类这个模板创建当前类的实例(对象)
mzl = Student("mzl",23)
print(mzl.name)
print(mzl.age)
print(mzl.school)
mzl.video()

dgd = Student("dgd", 23)
print(dgd.name)
print(dgd.age)
print(mzl.school)
dgd.study()

类的定义以及类的操作

成员引用

类名.成员名
案例:

class Person:
    """人的类"""

    home = "earth"

    def __init__(self):
        self.age = 0

    def eat(self):
        print("eating...")

    def drink(self):
        print("drinking...")
---------------------------------------------------------------
home = Person.home  # 获取一个字符串 这里是通过类
eat_function = Person.eat  # 获取一个函数对象
doc = Person.__doc__  # 获取类的说明文档

print(home)  # earth
print(eat_function)  # <function Person.eat at 0x00000232C8230F40>
print(doc)  # 人的类
-----------------------------或者-------------------------------
p = Person()  # 创建一个对象
print(p.home)  # earth    这里是通过对象
print(p.age)  # 0
p.eat()  # eating...
p.drink()  # drinking...

_ _ init() _ _

__init__() 方法的调用时机在实例(通过 [__new__()](#object.__new__))被创建之后,返回调用者之前。一般用于初始化一些数据。当类定义了 __init__() 方法后,在类实例化的时候会自动调用 __init__() 方法。也可以向 __init__() 方法中传参。

class Person:
    """人的类"""

    home = "earth"

    def __init__(self, name):
        self.name = name

p = Person("张三")  # 创建一个对象
print(p.name)  # 张三

self 作为实例传参

self代表类的实例自身。调用实例方法时,实例对象会作为第一个参数被传入。因此,我们调用p.eat()时就相当于调用了Person.eat(p)。
在__init__方法以及其他的实例方法中,第一个参数都是self
self是一个约定俗成的名字,一般不需要我们去关心,可以通过self去调用当前类中其他实例属性或方法;__init__不能又返回值只能是None

class Student:
    def __init__(self,name,age):
        self.name=name
        self.age=age
    def eat(self):
        print("eating")
    def study(self):
        print("studying")
    def study_eat(self):
        self.eat()
        self.study()
zsf = Student("zsf",18)
zsf.study_eat()
-------------------------------
eating
studying

类属性

类属性也叫类变量,在类中方法外面进行定义
类中所有的实例共享这个类属性

1)通过 类名.属性名 或 实例名.属性名 访问

class Person:
    """人的类"""
    home = "earth"  # 定义类属性
print(Person.home)  # 通过类名访问类属性

p1 = Person()  # 创建一个实例对象
print(p1.home)  # 通过实例名访问类属性,(如果实例没有覆盖这个类属性的值)

2)通过 类名.属性名 添加与修改类属性

class Person:
    """人的类"""
Person.home = "earth"  # 添加类属性
print(Person.home)  # earth

Person.home = "mars"  # 修改类属性
print(Person.home)  # mars

若使用 实例名.属性名 则会创建或修改实例属性,因此不建议类属性和实例属性同名

class Person:
    """人的类"""
    home = "earth"
p1 = Person()
p2 = Person()
print(Person.home)  # earth
print(p1.home)  # earth
print(p2.home)  # earth

print("通过 类名.属性名 修改 类属性")
Person.home = "mars"
print(Person.home)  # mars
print(p1.home)  # mars
print(p2.home)  # mars

print("通过 实例名.属性名 会创建 实例属性")
p1.home = "venus"
print(Person.home)  # mars
print(p1.home)  # venus
print(p2.home)  # mars

3)所有该类的实例共享同一个类属性

class Person:
    """人的类"""
    home = "earth"  # 定义类属性,所有实例共享

p1 = Person()  # 创建一个实例对象
p2 = Person()  # 创建另一个实例对象

print(p1.home)  # earth
print(p2.home)  # earth
Person.home = "mars"  # 修改类属性
print(p1.home)  # mars
print(p2.home)  # mars

实例属性

也叫实例变量。在类方法中定义的属性。通过 self.属性名定义。

1)通过实例名.属性名 访问

class Person:
    """人的类"""

    def __init__(self, name, age):
        self.name = name  # 定义实例属性
        self.age = age  # 定义实例属性

p1 = Person("张三", 18)  # 创建一个实例对象
print(p1.name, p1.age)  # 张三 18

p2 = Person("李四", 81)  # 创建一个实例对象
print(p2.name, p2.age)  # 李四 81

print(Person.name)  # 报错

2)通过 实例名.属性名 添加与修改实例属性
只是对当前的实例添加 对其他的没有影响

class Person:
    """人的类"""
    pass
p1 = Person()  # 创建一个实例对象
p1.name = "张三"  # 添加实例属性
p1.age = 18  # 添加实例属性
print(p1.name, p1.age)  # 张三 18

p1.age = 25  # 修改实例属性
print(p1.name, p1.age)  # 张三 25

3)每个实例独有一份实例属性

class Person:
    """人的类"""
    def __init__(self, name):
        self.name = name  # 定义实例属性
        self.age = 0  # 定义实例属性

p1 = Person("张三")  # 创建一个实例对象
print(p1.name, p1.age)  # 张三 0
p1.age = 18  # 修改p1的age属性
print(p1.name, p1.age)  # 张三 18

p2 = Person("李四")  # 创建另一个实例对象
print(p2.name, p2.age)  # 李四 0

方法

Python的类中有三种方法:实例方法、静态方法、类方法

实例方法

Ø 实例方法在类中定义,第一个参数为self,代表实例本身。
Ø 实例方法只能被实例对象调用。
Ø 可以访问实例属性、类属性、类方法。

class Person:
    """人的类"""
    home = "earth"

    def __init__(self, name):
        self.name = name

    def instance_method(self):
        print(self.name, self.home, Person.home)

p = Person("张三")
p.instance_method()  # 张三 earth earth,此时p中没有home实例属性,会去查找home类属性
Person.home = "venus"  # 修改类属性
p.home = "mars"  # 定义实例属性
p.instance_method()  # 张三 mars venus

类方法

Ø 类方法在类中通过 @classmethod 定义,第一个参数为cls,代表类本身。
Ø 类方法可以被类和实例对象调用。
Ø 可以访问类属性。

在不创建实例的情况下调用,通过类名直接调用,非常方便,适合一些和类整体相关的操作。

静态方法

Ø 静态方法在类中通过 @staticmethod 定义
Ø 不访问实例属性或类属性,只依赖于传入的参数
Ø 可以通过类名或实例调用,但它不会访问类或实例的内部信息,更像是一个工具函数,只是为了方便组织代码,把它放在了类里面。

"""
    该案例演示了方法
"""
import types


def drink(self):
    print("drinking")

class Student:
    """这是一个学生类"""
    school = "atguigu"
    def __init__(self, name, age):
        self.name = name
        self.age = age

    # 实例方法
    def eat(self):
        print(self.school)
        print(self.name)
        print(self.age)

    # 类方法
    @classmethod
    def get_info(cls):
        print(cls.school)
        print(cls.__doc__)

zwj = Student("zwj",30)
# zwj.eat()
# zwj.get_info()
# Student.get_info()

# zwj.drink = drink
# zwj.drink()

# Student.drink = drink
# zwj.drink()
# Student.drink(zwj)

zcs = Student("zcs",50)

zcs.drink = types.MethodType(drink, zcs)
zcs.drink()

Student.get_info()


"""
class MathUtil:
    @staticmethod  # 不加是用不了的
    def add(a, b):
        return a + b
print(MathUtil.add(10, 20))
"""
-----------------------------------
drinking
atguigu
这是一个学生类

特殊方法

方法名中有两个前缀下划线和两个后缀下划线的方法为特殊方法,也叫魔法方法。上文提到的 __init__()就是一个特殊方法。这些方法会在进行特定的操作时自动被调用。

几个常见的特殊方法:

1)__new__()
对象实例化时第一个调用的方法。

2)__init__()
类的初始化方法。

3)__del__()
    对象的销毁器,定义了当对象被垃圾回收时的行为。使用 del xxx 时不会主动调用 __del__() ,除非此时引用计数==0。
    
4)__str__()
定义了对类的实例调用 str() 时的行为。

5)__repr__()
定义对类的实例调用 repr() 时的行为。 str() 和 repr() 最主要的差别在于目标用户。 repr() 的作用是产生机器可读的输出(大部分情况下,其输出可以作为有效的Python代码),而 str() 则产生人类可读的输出。

6)__getattribute__()
属性访问拦截器,定义了属性被访问前的操作。

动态添加属性与方法

动态给对象添加属性

class Person:
    def __init__(self, name=None):
        self.name = name

p = Person("张三")
print(p.name)  # 张三

p.age = 18
print(p.age)  # 18

动态给类添加属性

class Person:
    def __init__(self, name=None):
        self.name = name

p = Person("张三")
print(p.name)  # 张三

Person.age = 0
print(p.age)  # 0

动态给对象添加方法

1)添加普通方法
class Person:
    def __init__(self, name=None):
        self.name = name

def eat():
    print("吃饭")

p = Person("张三")
p.eat = eat
p.eat()  # 吃饭
2)添加实例方法

给对象添加的实例方法只绑定在当前对象上,不对其他对象生效,而且需要传入 self 参数。需要使用 types.MethodType(方法名,实例对象) 来添加实例方法。

import types

class Person:
    def __init__(self, name=None):
        self.name = name

def eat(self):
    print(f"{self.name}在吃饭")

p = Person("张三")
p.eat = types.MethodType(eat, p)
p.eat()  # 张三在吃饭

动态给类添加方法

给类添加的方法对它的所有对象都生效,添加类方法需要传入 cls 参数,添加静态方法则不需要。

class Person:
    home = "earth"

    def __init__(self, name=None):
        self.name = name

# 定义类方法
@classmethod
def come_from(cls):
    print(f"来自{cls.home}")

# 定义静态方法
@staticmethod
def static_function():
    print("static function")

Person.come_from = come_from
Person.come_from()  # 来自earth

Person.static_function = static_function
Person.static_function()  # static function

动态删除属性与方法

Ø del 对象**.**属性名
Ø delattr(对象,属性名)

__slots__限制实例属性与实例方法

Python允许在定义类的时候,定义一个特殊的 __slots__变量,来限制该类的实例能添加的属性。使用__slots__可以限制添加实例属性和实例方法,但类属性、类方法和静态方法还可以添加。__slots__仅对当前类生效,对其子类无效。

import types

class Person:
    __slots__ = ("name", "age", "eat")

    def __init__(self, name=None):
        self.name = name

def eat(self):
    print(f"{self.name}在吃饭")

def drink(self):
    print(f"{self.name}在喝水")

p = Person("张三")

# 添加实例属性
p.age = 10
print(p.age)  # 10

# 添加实例方法
p.eat = types.MethodType(eat, p)
p.eat()  # 张三在吃饭

# 添加实例属性
p.weight = 100  # AttributeError: 'Person' object has no attribute 'weight'

# 添加实例方法
p.drink = type.MethodType(drink, p)  # AttributeError: type object 'type' has no attribute 'MethodType'

面向对象的三大特征

封装
  • 成员私有化
  • 在类中定义的成员,只能在类中被访问,类的外部访问不到
  • 有些类中的成员不想被子类继承,也可以进行私有化
继承
  • 子类可以继承父类的非私有成员,当然子类也可以定义自己特有的方法,也可以对父类的方法进行重写
多态
  • 一个对象的多种形态

私有化

有时为了限制属性和方法只能在类内访问,外部无法访问;或父类中某些属性和方法不希望被子类继承。可以将其私有化。

不想被访问的话 前面要加个下划线home = "earth" => _home = "earth"

1)单下划线:非公开API

大多数Python代码都遵循这样一个约定:有一个前缀下划线的变量或方法应被视为非公开的API,例如 _var1。这种约定不具有强制力。

class Person:
    _home = "earth"

    def __init__(self):
        self.name = "John"
        self.age = 25
    def _eat(self):
        print("I'm eating")

print(Person._home)
zsf = Person()
print(zsf.age)
2)双下划线:名称改写

有两个前缀下划线,并至多一个后缀下划线的标识符,例如 __x,会被改写为 _类名__x。只有在类内部可以通过 __x 访问,其他地方无法访问或只能通过 _类名__x 访问。

class Person:
    __home = "earth"

    # 修改构造函数接受name和age参数
    def __init__(self, name="John", age=25):
        self.name = name
        self.age = age

    # 将方法改为公共方法,去掉双下划线
    def eat(self):
        print(self.__home)
        print("I'm eating")
    def eat_1(self):
        print(self.__home)
        print("I'm \n")
        self.eat()

zsf = Person("zsf", 18) 
zsf.eat()  # 可以正常调用
zsf.eat_1()  # 可以正常调用
------------------------------
earth
I'm eating
earth
I'm 

earth
I'm eating
成员私有化本质

如果成员以双下划线开头,名字会被改写,改为_类名__成员名

class Person:
    __home = "earth"

    # 修改构造函数接受name和age参数
    def __init__(self, name="John", age=25):
        self.__name = name
        self.__age = age

    # 将方法改为公共方法,去掉双下划线
    def eat(self):
        print(self.__home)
        print("I'm eating")
    def eat_1(self):
        print(self.__home)
        print("I'm \n")
        self.eat()

zsf = Person("zsf", 18)
print(zsf._Person__name)
print(zsf._Person__age)
-----------------------------
zsf
18

@property用法

1)方法转换为属性

可通过@property装饰器将一个方法转换为属性来调用。转换后可直接使用 .方法名 来使用,而无需使用.方法名() 。

class Person:

    def __init__(self, name):
        self.name = name

    @property
    def eat(self):
        print(f"{self.name} is eating...")

p = Person("张三")
p.eat   # 张三 is eating...

2)只读属性

将方法名设置为去掉双下划线的私有属性名,方法中返回私有属性。

class Person:

    def __init__(self, name):
        self.__name = name

    @property
    def name(self):
        return self.__name

p = Person("张三")
print(p.name)  # 张三
p.name = "李四"  # 报错

3)读写属性

将方法名设置为去掉双下划线的私有属性名,使用 属性名.setter 装饰。

class Person:

    def __init__(self, name):
        self.__name = name

    @property
    def name(self):
        return self.__name

    @name.setter
    def name(self, name):
        self.__name = name

p = Person("张三")
print(p.name)  # 张三

p.name = "李四"
print(p.name)  # 李四

也可以在写方法中设置一些拦截条件来规范私有属性的写入。

class Person:

    def __init__(self, name):
        self.__name = name

    @property
    def name(self):
        return self.__name

    @name.setter
    def name(self, name):
        if name == "李四":
            print("不许叫李四")
        else:
            self.__name = name

p = Person("张三")
print(p.name)  # 张三

p.name = "李四"  # 提示 “不许叫李四”
print(p.name)  # 张三

p.name = "王五"
print(p.name)  # 王五

‘信用卡’ 封装案例

"""
    封装信用卡类设计案例
"""
class CreditCard:
    def __init__(self, name):
        self.name = name
        self.__password = None
        self.__balance = 0  # 初始化为0

    @property
    def password(self):
        return self.__password

    @password.setter
    def password(self, password):
        if password != "888888":
            print("密码错误")
        else:
            print("密码正确")
        self.__password = password

    @property
    def balance(self):
        return self.__balance

    @balance.setter
    def balance(self, balance):
        # 确保balance是数字类型
        try:
            balance = float(balance)  # 转换为数字类型
            if balance < 0:
                print("余额不足")
            else:
                print(f"{self.name}存款成功")  # 修改提示信息
            self.__balance = balance
        except (ValueError, TypeError):
            print("余额必须是数字")

c1 = CreditCard("张三")

c1.password = "666666"
c1.balance = 888888  # 传入数字而不是字符串
print(f"当前余额: {c1.balance}")


----------------------------------------------------
密码错误
张三存款成功
当前余额: 888888.0

单继承

子类(派生类)继承父类(基类)中的属性和方法,实现代码重用。子类可以新增自己特有的方法,也可以重写父类的方法。子类不能继承父类的私有属性和私有方法,因为存在名称改写。

语法
class 父类:
    pass
class 子类(父类):
    pass
案例
class Person:
    """人的类"""

    home = "earth"  # 定义类属性

    def __init__(self, name):
        self.name = name  # 定义实例属性

    def eat(self):
        print("eating...")

class YellowRace(Person):
    """黄种人"""

    color = "yellow"  # 定义类属性

class WhiteRace(Person):
    """白种人"""

    color = "white"  # 定义类属性

class BlackRace(Person):
    """黑种人"""

    color = "black"  # 定义类属性

y1 = YellowRace("张三")
print(y1.home)  # earth
print(y1.color)  # yellow
print(y1.name)  # 张三
y1.eat()  # eating...

w1 = WhiteRace("李四")
print(w1.home)  # earth
print(w1.color)  # white
print(w1.name)  # 李四
w1.eat()  # eating...

b1 = BlackRace("王五")
print(b1.home)  # earth
print(b1.color)  # black
print(b1.name)  # 王五
b1.eat()  # eating...

多继承

一个子类可以同时调多个父类;调用方法时先在子类中查找,若不存在则从左到右依次查找父类中是否包含方法。

1)语法

class 类名(父类1, 父类2, ...):
    类体

2)案例

class Person:
    """人的类"""

    home = "earth"

    def __init__(self, name):
        self.name = name

    def eat(self):
        print("eating...")

class YellowRace(Person):
    """黄种人"""

    color = "yellow"

    def run(self):
        print("runing...")

class Student(Person):
    """学生"""

    def __init__(self, name, grade):
        self.name = name
        self.grade = grade

    def study(self):
        print("studying...")

class ChineseStudent(Student, YellowRace):  # 继承了Student和YellowRace
    """中国学生"""

    country = "中国"

y1 = ChineseStudent("张三", "三年级")
print(y1.home, y1.color, y1.country, y1.name, y1.grade)
y1.eat()
y1.run()
y1.study()

复用父类方法

子类可以在类中使用 super().方法名() 或 父类名.方法名() 来调用父类的方法。
调用方法时先在子类中查找,若不存在则从左到右依次查找多个父类中是否包含方法

1)super().方法名()

这里要注意 方法1 和 方法2

class Person:
    """人的类"""

    home = "earth"

    def __init__(self, name):
        self.name = name

    def eat(self):
        print("eating...")

class YellowRace(Person):
    """黄种人"""

    color = "yellow"

    def run(self):
        print("runing...")

class Student(Person):
    """学生"""

    def __init__(self, name, grade):
        # 调用父类中的方法
      # super().__init__(name) ### 方式1:通过super().父类方法调用
        self.name = name
        self.grade = grade

    def study(self):
        print("先吃再学")
      # Person.eat(self)       ### 方法2:通过父类名.父类方法名(self)
        super().eat()  # 子类中调用父类的方法
        print("studying...")

class ChineseStudent(Student, YellowRace):  # 继承了Student和YellowRace
    """中国学生"""

    country = "中国"

y1 = ChineseStudent("张三", "三年级")
print(y1.home, y1.color, y1.country, y1.name, y1.grade)
y1.study()

方法解析顺序

方法解析顺序(mro—Method Resolution Order)。可使用 类名.mro 访问类的继承链来查看方法解析顺序。

class Person:
    """人的类"""

    home = "earth"

    def __init__(self, name):
        self.name = name

    def eat(self):
        print("eating...")

class YellowRace(Person):
    """黄种人"""

    color = "yellow"

    def run(self):
        print("runing...")

class Student(Person):
    """学生"""

    def __init__(self, name, grade):
        self.name = name
        self.grade = grade

    def study(self):
        print("先吃再学")
        Person.eat(self)
        print("studying...")

class ChineseStudent(Student, YellowRace):
    """中国学生"""

    country = "中国"

y1 = ChineseStudent("张三", "三年级")
print(
    ChineseStudent.__mro__
)  
-----------------------------------------------------------
# (<class '__main__.ChineseStudent'>, <class '__main__.Student'>, <class '__main__.YellowRace'>, <class '__main__.Person'>, <class 'object'>)

方法重写

在子类中定义与父类方法重名的方法,调用时会调用子类中重写的方法

class Person:

    home = "earth"

    def __init__(self, name):
        self.name = name

    def eat(self):
        print("eating...")

class Chinese(Person):

    color = "yellow"

    # 重写父类方法
    def eat(self):
        print("用筷子吃")

y1 = Chinese("张三")
y1.eat()

注意:子类重写 __init__() 并调用时,不会执行父类的 __init__() 方法。如有必要,需在子类 __init__() 中使用 super().__init__() 来调用父类的 __init__() 方法。

class Person:

    def __init__(self, name):
        self.name = name

class Chinese(Person):

    def __init__(self, name, area):
        super().__init__(name)  # 调用父类的__init__()
        self.area = area

y1 = Chinese("张三", "北京")
print(y1.name, y1.area)

多态

同一事物在不同场景下呈现不同状态。
多态应用在方法的返回值上

class Animal:
    def go(self):
        pass

class Dog(Animal):
    def go(self):
        print("跑")

class Fish(Animal):
    def go(self):
        print("游")

class Bird(Animal):
    def go(self):
        print("飞")

def go(animal):
    animal.go()  # 将不同的实例传入,执行不同的方法

dog = Dog()
fish = Fish()
bird = Bird()
go(dog)
go(fish)
go(bird)
class Bird:
    def __init__(self, name):
        self.name = name


class Fish:
    def __init__(self, name):
        self.name = name


class Dog:
    def __init__(self, name):
        self.name = name


class Person:
    def __init__(self, name, age):
        self.name = name
        self.age = age

    def call(self, flag):
        ani = None
        # 将字符串转换为整数进行匹配
        flag_int = int(flag) if isinstance(flag, str) else flag
        match flag_int:
            case 1:
                ani = Bird('Bird')
            case 2:
                ani = Fish('Fish')
            case 3:
                ani = Dog('Dog')
        return ani


wf = Person("wf", 20)
ani = wf.call('3')  # 传入字符串 '3'
print(ani.name)  # 输出: Dog

愤怒的小鸟案例说明

class 类{
    属性
        类属性
        实例属性
    方法
        类方法
        静态方法
        实例方法
        魔法方法
}

1.1 游戏背景

在这个模拟的愤怒的小鸟游戏世界里,绿色的小猪偷走了小鸟们的蛋,这引发了小鸟们的愤怒,它们决定展开反击。每只小鸟都具有独特的颜色,并且各自拥有不同的技能,玩家需要操控这些小鸟,利用它们的技能去攻击小猪们建造的各种障碍物,从而达成击败小猪、夺回鸟蛋的目标。

1.2 类的设计思路

1.2.1 Birds 基类

1)设计目的

作为所有小鸟类的基类,它定义了小鸟的通用属性和行为,为后续具体小鸟类的扩展提供基础框架,体现了面向对象编程中的抽象和封装思想。

2)属性设计

name:用于标识每只小鸟的名称,方便区分不同个体。

color:代表小鸟的颜色,这是小鸟的一个显著特征,在游戏中可以对应不同类型的小鸟。

skill_description:描述小鸟所具备的独特技能,让玩家了解每只小鸟的特殊能力。

3)方法设计

fly():描述小鸟飞行的基本动作,是小鸟在游戏中的常见行为,所有子类都可以重写该方法来展示不同的飞行特点。

call():模拟小鸟发出叫声的行为,同样可以被子类重写以体现不同小鸟的叫声差异。

use_skill():用于触发小鸟的特殊技能,展示小鸟使用技能的情况,子类可以根据自身技能特点进行相应实现。

1.1.1 具体小鸟子类(RedBirds、YellowBirds、BlueBirds)

1)设计目的

继承自 Birds 基类,每个子类代表一种特定颜色的小鸟,它们在继承基类属性和方法的基础上,重写部分方法以展示不同小鸟的独特行为和技能,体现了面向对象编程中的继承和多态思想。

2)属性设计

通过调用基类的 init 方法,初始化各自的 name、color 和 skill_description 属性,确保每只小鸟都有自己的独特标识和技能。

3)方法设计

fly():重写基类的 fly() 方法,展示不同小鸟的飞行特点,如红鸟以稳定速度飞行,黄鸟快速飞行,蓝鸟优雅飞行。

call():重写基类的 call() 方法,模拟不同小鸟的叫声,增加游戏的趣味性。

1.1.2 Obstacle 类

1)设计目的

代表游戏中的障碍物,如木头堡垒、石头塔楼等,负责处理障碍物被小鸟攻击的逻辑,与小鸟类进行交互,体现了面向对象编程中的对象交互和封装思想。

2)属性设计

name:标识障碍物的名称,方便区分不同类型的障碍物。

strength:表示障碍物的强度,即它能够承受的伤害值,当强度降为 0 时,障碍物被摧毁。

3)方法设计

be_attacked(bird):模拟障碍物被小鸟攻击的过程,根据小鸟的类型计算伤害,并更新障碍物的强度,同时输出攻击和受损信息,让玩家了解游戏进展。

1.1 方法设计思路

1.1.1 Birds 类的方法

1)fly()

作为通用的飞行方法,提供了小鸟飞行的基本描述,子类可以根据自身特点进行个性化实现,以体现不同小鸟的飞行风格。

2)call()

模拟小鸟发出叫声的行为,为游戏增加生动性,子类可以重写该方法来展示不同小鸟的叫声特点。

3)use_skill()

用于触发小鸟的特殊技能,通过输出技能描述,让玩家了解小鸟使用技能的情况,不同子类可以根据自身技能进行不同的实现。

1.1.2 具体小鸟子类的方法

fly() 和 call():重写基类的方法,根据不同小鸟的特点进行个性化实现,展示不同小鸟的飞行和叫声差异,体现了多态性。

1.1.3 Obstacle 类的方法

be_attacked(bird):接收一个小鸟对象作为参数,根据小鸟的类型计算伤害,并更新障碍物的强度。通过判断障碍物的强度是否小于等于 0,输出障碍物是否被摧毁的信息,实现了障碍物与小鸟之间的交互逻辑。

通过这样的类和方法设计,整个游戏模拟程序具有良好的扩展性和可维护性,方便后续添加更多类型的小鸟和障碍物,以及实现更复杂的游戏逻辑。

代码实现
# 定义鸟类基类
class Birds:
    def __init__(self, name, color, skill_description):
        self.name = name
        self.color = color
        self.skill_description = skill_description

    def fly(self):
        print(f"{self.name} 正在飞行...")

    def call(self):
        print(f"{self.name} 发出叫声...")

    def use_skill(self):
        print(f"{self.name} 使用了技能:{self.skill_description}")

# 定义红鸟子类
class RedBirds(Birds):
    def __init__(self):
        super().__init__("红火", "红色", "撞击前方障碍物,造成大量伤害")

    def fly(self):
        print("红火以稳定的速度向前飞行...")

    def call(self):
        print("红火发出 'wei呀....' 的叫声")

# 定义黄鸟子类
class YellowBirds(Birds):
    def __init__(self):
        super().__init__("小黄", "黄色", "瞬间加速,穿透薄障碍物")

    def fly(self):
        print("小黄快速向前飞行...")

    def call(self):
        print("小黄发出 '啾啾啾....' 的叫声")

# 定义蓝鸟子类
class BlueBirds(Birds):
    def __init__(self):
        super().__init__("小蓝", "蓝色", "分裂成三只小鸟,分散攻击")

    def fly(self):
        print("小蓝优雅地向前飞行...")

    def call(self):
        print("小蓝发出 '叽叽叽....' 的叫声")

# 定义障碍物类
class Obstacle:
    def __init__(self, name, strength):
        self.name = name
        self.strength = strength

    def be_attacked(self, bird):
        print(f"{bird.name} 冲向了 {self.name}")
        bird.use_skill()
        # isinstance判断当前对象是否属于xx的类型
        if isinstance(bird, RedBirds):
            damage = 80
        elif isinstance(bird, YellowBirds):
            damage = 50
        elif isinstance(bird, BlueBirds):
            damage = 30 * 3  # 分裂成三只,每只造成 30 点伤害
        self.strength -= damage
        if self.strength <= 0:
            print(f"{self.name} 被摧毁了!")
        else:
            print(f"{self.name} 还剩余 {self.strength} 点强度")

# 模拟游戏过程
if __name__ == "__main__":
    # 创建不同颜色的小鸟
    red_bird = RedBirds()
    yellow_bird = YellowBirds()
    blue_bird = BlueBirds()

    # 创建障碍物
    obstacle1 = Obstacle("木头堡垒", 100)
    obstacle2 = Obstacle("石头塔楼", 200)

    # 红鸟攻击木头堡垒
    obstacle1.be_attacked(red_bird)

    # 黄鸟攻击石头塔楼
    obstacle2.be_attacked(yellow_bird)

    # 蓝鸟攻击石头塔楼
    obstacle2.be_attacked(blue_bird)

异常处理基础语法

1.1 异常介绍

Python是一门解释型语言,只有在程序运行后才会执行语法检查。所以,只有在运行或测试程序时,才会真正知道该程序能不能正常运行。

Python有两种错误很容易辨认:语法错误和异常。

1.1.1 语法错误

程序解析时遇到的错误。

例如以下程序,因缺少 : 而出现语法错误。

while True print(1)
#     while True print(1)
#                ^^^^^
# SyntaxError: invalid syntax

11.1.2 异常

Python 程序的语法是正确的,在运行它的时候,也有可能发生错误。运行期检测到的错误被称为异常。

例如以下程序,因变量名未找到而引发NameError。

print(var1)
#     print(var1)
#           ^^^^
# NameError: name 'var1' is not defined. Did you mean: 'vars'?

大多数的异常都不会被程序处理,都以错误信息的形式打印出来,错误信息的前面部分显示了异常发生的上下文,并以调用栈的形式显示具体信息。

11.2 异常处理

对异常进行处理并不是将错误规避了,而是当程序运行的时候,出现错误的时候提供解决方案,不终止程序,可以让程序继续执行。

11.2.1 try except

可以使用 try except 语句来捕获异常并处理。

语法
try:
    可能发生异常的代码
except:
    异常处理的代码

Ø 如果没有发生异常,程序会忽略except中的代码,继续向下执行。
Ø 如果发生了异常,会忽略try中剩余代码,执行except中的代码。
Ø 程序异常处理后的其他代码会正常执行

案例
try:
    result = 3 / 1
    print("没有发生异常")
except:
    print("发生异常了")
print("End")

11.2.2 捕获指定类型的异常以及获取异常描述信息

在打印出来的异常信息中,冒号之前是异常类型,冒号之后是异常描述信息

# NameError: name 'a' is not defined
# NameError: 冒号之前是异常类型
# : name 'a' is not defined 冒号之后是异常描述信息
print(a)

如果出现的异常不是我们指定的类型中的其中一个,我们在程序中想对不同类型的异常进行不同的处理,并在处理异常的时候,要获取异常信息,我们可以通过如下方式。

语法【as是起别名】
try:
    可能发生异常的代码
except 异常类型1 as 变量名1:
    异常处理的代码
except 异常类型2 as 变量名2:
异常处理的代码
except(异常类型3, 异常类型4, 异常类型5) as 变量名3:
异常处理的代码
except:
异常处理的代码

Ø 如果没有发生异常,程序会忽略except中的代码,继续向下执行。
Ø 如果发生了异常,会忽略try中剩余代码,根据异常类型匹配到相应的 except 并执行其中的代码。
Ø 如果发生了异常,且异常类型无法和任何except匹配,异常将向外传递。
Ø 一个except可以同时处理多个异常,将这些异常放在一个元组中。
Ø 最后一个 except 可以忽略异常类型,它将被作为通配符使用。

案例
try:
    result = 3 / 0
    print("发生异常了")
except ZeroDivisionError as e:
    print(e)
except (RuntimeError, TypeError, NameError) as e:
    print(e)
except:
    print("Unexpected error")
print("End")

else关键字

可选地将else放在所有except之后。如果try中代码没有发生异常,将执行 else 中的代码。

try:
    可能发生异常的代码
except 异常类型1 as 变量名1:
    异常处理的代码
except 异常类型2 as 变量名2:
    异常处理的代码
else:
    没有异常时执行的代码
说明

Ø 从执行效果上说,将代码放到else块和直接放到try块中是一样的。
Ø 将try正常执行完毕而没有引发任何异常后被执行的代码放到else中。提供了一种清晰的逻辑区分,将正常情况的代码与异常处理代码分开,使代码更易于理解和维护,有助于代码的可读性和可维护性。
Ø 例如,你希望在try块中有些操作执行成功后,再执行其它代码,那就可以把代码放到else语句块中。

案例
try:
    result = x / y
except ZeroDivisionError:
    print("除数不能为零!")
else:
    print(f"结果是: {result}")

finally关键字

可选地,放在最后。无论是否发生异常都会执行的代码,通常用于执行一些必须要进行的清理操作,例如关闭文件、释放资源(如网络连接、数据库连接、锁等),即使在执行 try 块中的代码时出现了异常,也能保证这些操作得以完成。

语法
try:
    可能发生异常的代码
except 异常类型1 as 变量名1:
    异常处理的代码
except 异常类型2 as 变量名2:
    异常处理的代码
else:
    没有异常时执行的代码
finally:
    无论是否发生异常都会执行的代码
说明

Ø 如果从执行效果上说,大部分场景,将代码放到finally语句和放到try-except块外效果是一样的。
Ø finally 语句块是 try-except 结构的一部分,它确保了无论 try 块中是否发生异常,也无论 except 块是否被执行,其中的代码都会被执行
Ø 直接放在try-except结构外面的代码只会在try-except结构正常执行完毕后才会执行,如果在try块中出现异常且没有被except块捕获,或者在except块中出现了新的异常导致程序终止,那么这部分代码将不会被执行。

案例
# try:
#     result = 3 / 0
# except ZeroDivisionError as e:
#     print(e)
# else:
#     print(result)
# finally:
#     print("finally")
# print("End")
#输出结果:
# division by zero
# finally
# End
try:
    result = 3 / 0
except NameError as e:
    print(e)
else:
    print(result)
finally:
    print("finally")

raise

当你想要在代码中明确表示发生了错误或异常情况时,可以使用 raise 来抛出异常。这可以帮助你在满足某些条件时停止程序的正常执行,并将控制权转移到异常处理部分。

语法
raise 异常类型("异常描述")
案例
def int_add(x, y):
    if isinstance(x, int) and isinstance(y, int):
        return x + y
    else:
        raise TypeError("参数类型错误")

print(int_add(1, 2))  # 3
print(int_add("1", "2"))  # TypeError: 参数类型错误

assert断言

assert用于判断一个表达式,在表达式条件为False的时候触发异常,常用于调试程序。

语法
assert 表达式 [,异常描述]
#等价于
if not 表达式:
    raise AssertionError([异常描述])
案例
def int_add(x, y):
    assert isinstance(x, int) and isinstance(y, int), "参数类型错误"
    return x + y

print(int_add(1, 2))  # 3
print(int_add("1", "2"))  # AssertionError: 参数类型错误

自定义异常

通过直接或者间接继承Exception类来创建自己的异常。例如:

class MyError(Exception):
    def __init__(self, value):
        self.value = value

    def __str__(self):
        return repr(self.value)

try:
    raise MyError(1)
except MyError as e:
    print("触发自定义异常:", e.value)

异常的传递

当存在 try 嵌套或函数嵌套时,若内层出现了异常且在内层无法处理,会将异常一层一层向外传递,直到异常被处理或程序报错。

try:
    try:
        try:
            print(1 / 0)
        except NameError as e:
            print("第三层", e)
    except TypeError as e:
        print("第二层", e)
except Exception as e:
    print("第一层", type(e), e)
# 第一层 <class 'ZeroDivisionError'> division by zero

with关键字

Python中的with语句用于异常处理,封装了try except finally编码范式,提供了一种简洁的方式来确保资源的正确获取和释放,同时处理可能发生的异常,提高了易用性。使代码更清晰、更具可读性,简化了文件流等公共资源的管理。

语法:
with expression as variable:
    # 代码块
说明:
  • expression:通常是一个对象或函数调用,该对象需要是一个上下文管理器,即实现了__enter__和__exit__方法
  • variable:是可选的,用于存储expression的__enter__方法的返回值
工作原理:

Ø 使用 with 关键字系统会自动调用 f.close() 方法, with 的作用等效于 try finally 语句。

Ø 当执行with语句时,会调用expression对象的__enter__方法。

Ø enter 方法的返回值可以被存储在 variable 中(如果有),以供 with 代码块中使用。

Ø 然后执行 with 语句内部的代码块。

Ø 无论在代码块中是否发生异常,都会调用 expression 对象的__exit__ 方法,以确保资源的释放或清理工作,这类似于 try-except-finally 中的 finally 子句。

案例:打开一个文件并向其中写入内容,验证出现异常后文件是否正常关闭
1)常规方式
try:
    file = open("test.txt", "w")
    file.write(a)
    file.close()
finally:
    print("文件是否关闭:", file.closed)  # 文件是否关闭: False
    
    
2)使用 try finally
try:
    file = open("test.txt", "w")
    try:
        file.write(a)
    finally:
        file.close()
finally:
    print("文件是否关闭:", file.closed)  # 文件是否关闭: True
    
    
3)使用 with    # file是取的别名
try:
    with open("test.txt", "w") as file:
        file.write(a)
finally:
print("文件是否关闭:", file.closed)  # 文件是否关闭: True

Python常见异常

异常基类

*异常* *说明*
*BaseException* 所有内置异常的基类。它不应该被用户自定义类直接继承(这种情况请使用Exception)。
*Exception* 所有内置的非系统退出类异常都派生自此类。所有用户自定义异常也应当派生自此类。
*ArithmeticError* 此基类用于派生针对各种算术类错误而引发的内置异常:OverflowError, ZeroDivisionError, FloatingPointError。
*BufferError* 当与缓冲区相关的操作无法执行时将被引发。
*LookupError* 此基类用于派生当映射或序列所使用的键或索引无效时引发的异常:IndexError, KeyError。这可以通过 codecs.lookup() 来直接引发。

具体异常

*异常* *说明*
*AssertionError* 当 assert 语句失败时将被引发。
*AttributeError* 当属性引用或赋值失败时将被引发。
*IndexError* 当序列抽取超出范围时将被引发。
*KeyError* 当在现有键集合中找不到指定的映射(字典)键时将被引发。
*KeyboardInterrupt* 当用户按下中断键 (通常为 Control-C 或 Delete) 时将被引发。
*MemoryError* 当一个操作耗尽内存但情况仍可(通过删除一些对象)进行挽救时将被引发。
*NameError* 当某个局部或全局名称未找到时将被引发。
*OSError* 此异常在一个系统函数返回系统相关的错误时将被引发,此类错误包括 I/O 操作失败例如 文件未找到 或 磁盘已满 等。
*SyntaxError* 当解析器遇到语法错误时引发。
*TypeError* 当一个操作或函数被应用于类型不适当的对象时将被引发。

模块与包

模块描述

Python中一个以.py结尾的源文件即为一个模块(Module)。其中可以包含变量、函数和类等。通常情况下,我们把能够实现某一特定功能的代码放置在一个文件中作为一个模块。

使用模块提高了代码的可维护性,也提高了代码的复用性。即编写好一个模块后,只要是实现该功能的程序,都可以导入这个模块实现。另外,使用模块也可以避免名称冲突,相同名字的函数或变量可以分别存在与不同的模块中。

创建模块

模块名区分大小写,且不能与Python自带的标准模块重名。
创建一个模块my_add.py

num =100
def add(a, b):
    """求两个数的和"""
    return a + b

导入模块

全部导入import

导入模块的所有成员,通过模块名.成员名的方式访问。即使多次使用 import导入同一模块,模块也只会被导入一次。

语法

import 模块名 [as 别名]

案例

在同一目录下创建一个main.py文件,在其中导入 my_add.py 模块并使用

# 导入模块
import my_add

# 使用模块
print(my_add.add(1, 2))
print(my_add.num)

也可以在导入模块时给模块起别名。

# 导入模块
import my_add as a1

# 使用模块
print(a1.add(1, 2))
print(a1.num)

局部导入 from import

指定导入模块的部分成员,直接通过成员名的方式访问。只能使用其导入的成员,未导入的成员不能使用。如果多个模块中存在重名成员,后一次导入会覆盖前一次导入。

语法

from 模块名 import 成员名1[as 别名], 成员名2[as 别名],…

案例

Ø 创建新的模块my_multi.py

num =200
_str1="abc"
def multi(a, b):
    """求两个数的积"""
    return a * b

Ø 只能使用导入的成员

from my_add import add 
print(add(1, 2))
print(num) # NameError: name 'num' is not defined

Ø 重名变量,后一次导入会覆盖前一次导入

# 导入模块
from my_add import add,num 
from my_multi import num
# 使用模块
print(add(1, 2))
print(num) 

Ø 通过别名区分不同模块的变量

# 导入模块
from my_add import add,num as a1
from my_multi import num as m1
# 使用模块
print(add(1, 2))
print(a1) 
print(m1) 

局部导入 from import

导入模块中所有不以单下划线开头的成员,直接通过成员名的方式访问。

语法

from 模块名 import *

案例
# 导入模块
from my_add import *

# 使用模块
print(add(1, 2))
print(num)
print(_str1)
模块搜索顺序

当导入一个模块时,会按照以下顺序进行查找:

(1)当前目录。

(2)PYTHONPATH环境变量中的目录。

(3)包含标准 Python 模块以及这些模块所依赖的任何 extension module 的目录。

可以使用以下方式查看模块搜索顺序:

import sys

print(sys.path)

也可以通过 sys.path.append(路径) 向 sys.path 中临时添加路径。

import sys

print(sys.path)
sys.path.append("./..")
print(sys.path)

__all__ [在被导入模块中进行限制]

使用from import *导入模块时,可以在被导入的模块中使用 all设置哪些内容可以被导入。all 的设置只针对使用 from import * 导入模块时有效。

在my_add.py 中向__all__添加部分元素:

__all__ = ["num","add"] #  内容必须要用引号引起来

num = 100
num1 = 200
_str1="abc"
def add(a, b):
    """求两个数的和"""
    return a + b

在main.py中使用 from my_add import *导入模块中的内容。没在 __all__ 中的变量在使用时会报错:

from my_add import *
print(add(1, 2))
print(num)
print(num1) # NameError: name 'num1' is not defined

而使用import my_add全局导入模块后可以正常使用所有元素:

import my_add
print(my_add.add(1, 2))
print(my_add.num)
print(my_add.num1) # NameError: name 'num1' is not defined

__name__

在 Python 中,name 是一个特殊的内置变量

Ø 当一个Python文件被直接运行时,该文件的__name__属性值为”main“。

Ø 当一个Python文件作为模块被导入时,__name__属性会被设置为该模块的名称(即文件名,不包含 .py 后缀)。

1)导入模块时测试代码被执行

有时我们会在模块中写一些测试代码,当模块被其他文件导入时这些测试代码会被执行。

在 my_add.py 中写一些测试代码:

"""my_add.py"""
__all__ = ["num","add"]

num = 100
num1 = 200
_str1="abc"
def add(a, b):
    """求两个数的和"""
    return a + b

print(add(10,20))

在 main.py 中导入模块,发现 my_add.py 中的测试代码被执行了:

"""main.py"""
import my_add

2)使用__name__ == "__main__"避免测试代码被执行

为了避免模块被导入时测试代码被执行,我们可以在被导入模块中添加对 name 属性的检查:

"""my_add.py"""
__all__ = ["num","add"]

num = 100
num1 = 200
_str1="abc"
def add(a, b):
    """求两个数的和"""
    return a + b

print(__name__)
if __name__ == "__main__":
    print(add(10,20))
    
## 这里print(__name__)输出的结果其实是 "my_add"
## 我要忽略输出其他的 我要用 if __name__ == "__main__": 就可以忽略

此时再在 main.py 中导入模块,测试代码不会被执行:

"""main.py"""

import my_add

dir()

dir() 是一个内置函数,主要用于列出对象的属性和方法,或者列出当前作用域中定义的名称,并以一个字符串列表的形式返回。

Ø 当你将一个模块作为 dir() 的参数时,它会返回该模块中定义的名称列表,包括函数、类、变量等

import math

# 查看math模块下的  
print(dir(math))

Ø 当你将一个对象作为 dir() 的参数时,它会返回该对象的属性和方法列表

class MyClass:
    def __init__(self):
        self.x = 1
        self.y = 2

    def method1(self):
        pass
obj = MyClass()
print(dir(obj))

Ø 当你不传递任何参数调用 dir() 时,它会列出当前作用域中定义的名称,包括变量、函数、类等

def my_function():
    pass
variable = 10
print(dir())

包概述

包是一种管理 Python 模块命名空间的形式.

通过使用.模块名来构造Python模块命名空间的一种方式。例如,模块名A.B表示名为A的包中名为B的子模块。通常我们将多个有联系的模块放入一个包中。包与文件夹相似,不过该文件夹下必须有一个__init__.py文件。

假设要为统一处理声音文件与声音数据设计一个模块集(包)。声音文件的格式很多(通常以扩展名来识别,例如:.wav,.aiff,.au),因此,为了不同文件格式之间的转换,需要创建和维护一个不断增长的模块集合。为了实现对声音数据的不同处理(例如:混声、添加回声、均衡器功能、创造人工立体声效果),还要编写无穷无尽的模块流。下面这个分级文件树展示了这个包的架构:

sound/                          最高层级的包
      __init__.py               初始化 sound 包
      formats/                  用于文件格式转换的子包
              __init__.py
              wavread.py
              wavwrite.py
              aiffread.py
              aiffwrite.py
              auread.py
              auwrite.py
              ...
      effects/                  用于音效的子包
              __init__.py
              echo.py
              surround.py
              reverse.py
              ...
      filters/                  用于过滤器的子包
              __init__.py
              equalizer.py
              vocoder.py
              karaoke.py
              ...

创建包(Python Package) 和 创建文件夹(Directory)不一样 包里面是有__init__的

创建包

__init__.py 可以只是一个空文件,也可以执行包的初始化代码或设置 __all__ 变量。

在PyCharm创建一个graphic文件夹,并在其中创建circle.py、rectangle.py 文件。其中__init__.py文件暂时为空。 circle.py 和 rectangle.py 文件写入代码。

导入包

全局导入import

从包中导入模块

语法

import 包名.模块名 [as 别名]

调用方式:包名.模块名[别名].成员名
import graphic.circle

print(graphic.circle.area(10))  # 314.15926

使用 import 时,除最后一项外都必须是包。最后一项可以是模块或包,但不能是类、函数或变量。

局部导入包下的模块 from import

从包中导入模块

语法

from 包名 import 模块名 [as 别名]

调用方式:模块名.成员名
from graphic import circle

print(circle.area(10))  # 314.15926

局部导入包下模块的成员 from import

从包中模块导入功能

语法

from 包名.模块名 import 成员名 [as 别名]

调用方式:成员名
from graphic.circle import area

print(area(10))  # 314.15926

局部导入 from import * 从包中导入模块

当我们使用 from import * 时,Python并不会查找并导入包的所有子模块,因为这将花费很长的时间,并且可能会产生我们不想要的副作用。

唯一的解决办法是提供包的显式索引。如果包的 __init__.py 中定义了 **all**,运行 from import * 时,它就是被导入的模块名列表。

语法

from 包名.模块名 import *

调用方式:功能名

在 __init__.py 中添加如下内容:

__all__ = ["circle"] 
注意:如果不加会无法导包

在 main.py 中使用 from import * 导入模块:

from graphic import *

print(circle.area(10))  # 314.15926
print(rectangle.area(10))  # 报错

常用标准库(包)

标准库指的是在安装Python时就一同被安装的库。这些库经过精心挑选和开发,旨在为Python开发者提供通用且强大的工具集,涵盖各种不同的应用领域。

*名称* *说明*
*o**s* 多种操作系统接口。
*sys* 系统相关的形参和函数。
*time* 时间的访问和转换。
*datetime* 提供了用于操作日期和时间的类。
*math* 数学函数。
*random* 生成伪随机数。
*re* 正则表达式匹配操作。
*json* JSON 编码器和解码器。
*collections* 实现了一些专门化的容器,提供了对 Python 的通用内建容器 dict、list、set 和 tuple 的补充。
*functools* 高阶函数,以及可调用对象上的操作
*hashlib* 安全哈希与消息摘要。
*urllib* URL 处理模块。
*smtplib* SMTP 协议客户端,邮件处理。
*zlib* 与 gzip 兼容的压缩。
*gzip* 对 gzip 文件的支持。
*bz2* 对 bzip2 压缩算法的支持。
*multiprocessing* 基于进程的并行。
*threading* 基于线程的并行。
*copy* 浅层及深层拷贝操作。
*socket* 低层级的网络接口。
*shutil* 提供了一系列对文件和文件集合的高阶操作,特别是提供了一些支持文件拷贝和删除的函数。
*glob* Unix 风格的路径名模式扩展。

更多标准库可参考https://docs.python.org/zh-cn/3/library/index.html。

引入第三方库

当需要使用Python中没有内置的库时,可以通过以下方式安装第三方库pip install

pip是Python包管理工具,该工具提供了对 Python 包的查找、下载、安装、卸载的功能。pip 默认的源是 Python Package Index(PyPI),其地址为 https://pypi.org/simple/,如果下载比较慢,还可以指定其它的源

Ø 阿里云:http://mirrors.aliyun.com/pypi/simple/

Ø 豆瓣:http://pypi.douban.com/simple/

Ø 清华大学:https://pypi.tuna.tsinghua.edu.cn/simple/

1)pip常用命令

Ø 查看我们已经安装的软件包

pip list

Ø 安装软件包-具体包名就什么可以到PyPI上查找

pip install 包名

Ø 卸载软件包

pip uninstall 包名

Ø 临时使用其他源

pip install -i http://mirrors.aliyun.com/pypi/simple/ 包名

Ø 永久修改源

pip config set global.index-url http://mirrors.aliyun.com/pypi/simple/

2) 通过命令行的方式安装,是将第三方包安装在本地python下

例如:D:\dev\software\Python3.12.8\Lib\site-packages

3) 在pycharm中引入

右下角的编译器设置 → Interpreter Settings... → 在python Interprete中点”+”号 → 搜素要添加的包

通过Pycharm安装,我们选择的解释器类型每个项目独立的,所以是将第三方包安装在当前项目环境下,例如:D:\dev\workspace\python-2025.venv\Lib\site-packages

打包自己的库并安装

  • 先安装setuptools库

如果不安装setuptools库,后续打包时可能会遇到报错 ModuleNotFoundError: No module named ‘distutils’,所以可以提前安装 setuptools 库。在命令提示符中执行如下命令:pip install setuptools

  • 在包外创建一个setup.py文件
  • setup.py 中添加如下内容
from distutils.core import setup

setup(
    name="graphic",  # 需要打包的名字
    version="1.0",  # 版本
    py_modules=["graphic.circle", "graphic.rectangle"],  # 需要打包的模块
)
  • 在setup.pu同级目录下进行构建:python setup.py build

  • 也可以生成压缩包:python setup.py sdist

  • pip命令安装自己打的库

pip install path_to_your_package/dist/your_package_name-0.1.tar.gz

  • Pycharm 安装自己打的包库

右下角的编译器设置 → Interpreter Settings... → 点击蓝色的Go to tool window → 点击⚙ → Install From Disk...

迭代器

迭代是遍历容器中元素的一种 方式,而迭代器是一个可以记住遍历的位置的对象。迭代器对象从容器的第一个元素开始访问,直到所有的元素被访问完结束。迭代器只能往前不能后退,字符串。列或元组对象都可以用于创建迭代器

可迭代对象

我们发现大多数容器对象都可以使用 for 语句:

import os

for element in [1, 2, 3]:
    print(element)
for element in (1, 2, 3):
    print(element)
for key in {"one": 1, "two": 2}:
    print(key)
for char in "123":
    print(char)

with open("myfile.txt", "w") as f:
    f.write("H\ne\nl\nl\no\n \nW\no\nr\nl\nd\n")
for line in open("myfile.txt"):
    print(line, end="")
os.remove("myfile.txt")

可以直接作用于 for 循环的数据类型有以下几种:

Ø 容器,如 list 、 tuple 、 dict 、 set 、 str 等。

Ø generator ,包括生成器和带 yield 的generator function。

这些可以直接作用于 for 循环的对象统称为可迭代对象:Iterable。

使用迭代器

迭代器有两个基本的方法:iter() 和 **next()**。

在容器对象上使用 for 语句时,在幕后,for 语句会在容器对象上调用 iter()。该函数返回一个定义了 next() 方法的迭代器对象,此方法将逐一访问容器中的元素。当元素用尽时,next() 将引发 StopIteration 异常来通知终止 for 循环。 你可以使用 next() 内置函数来调用 next() 方法。

我们可以使用 iter() 获取一个可迭代对象的迭代器,并使用 next() 遍历迭代器:

list = [1, 2, 3]
it = iter(list)  # 创建迭代器对象
print(next(it))  # 输出迭代器的下一个元素,1
print(next(it))  # 2
print(next(it))  # 3
print(next(it))  # StopIteration

也可以使用 for 来遍历迭代器:

list = [1, 2, 3]
it = iter(list)  # 创建迭代器对象
for i in it:
    print(i)

创建迭代器

了解了迭代器协议背后的机制后,就可以为类添加迭代器行为了。定义 iter() 方法用于返回一个带有 next() 方法的对象。如果类已定义了 **next()**,那么 iter() 可以简单地返回 self。

class Reverse:
    """对一个序列执行反向循环的迭代器。"""

    def __init__(self, data):
        self.data = data
        self.index = len(data)

    def __iter__(self):
        return self

    def __next__(self):
        if self.index == 0:
            raise StopIteration
        self.index = self.index - 1
        return self.data[self.index]

rev = Reverse([2, 3, 5, 7, 11, 13, 17, 19])
iter(rev)
for char in rev:
    print(char)

生成器

生成器(generator)是一个用于创建迭代器的简单而强大的工具。它的写法类似于标准的函数,但当它要返回数据时会使用 yield 语句。当在生成器函数中使用 yield 语句时,函数的执行将会暂停,并将 yield 后的表达式作为当前迭代的值返回。

每次调用生成器的 next() 方法或使用 for 循环进行迭代时,函数会从上次暂停的地方继续执行(它会记住上次执行语句时的所有数据值),直到再次遇到 yield 语句。这样,生成器函数可以逐步产生值,而不需要一次性计算并返回所有结果。

生成器函数的优势是它们可以按需生成值,避免一次性生成大量数据并占用大量内存。此外,生成器还可以与其他迭代工具(如for循环)无缝配合使用,提供简洁和高效的迭代方式。

send()

向生成器fa’song
阅读全文

系统架构设计师

2025/8/23

架构师

系统分析师【上半年】 && 系统架构设计师【下半年】

考试科目【考试时间11月上旬 三科均达到45分】

科目一:综合知识【总分75分】
考试时间:9:00 - 11:30
客观题:75空单选题 150分钟

科目二:案例分析【总分75分】
考试时间:13:30-15:00
主观题:5道大题(只做3道) 90分钟
第一道必答,后4道选答2道

科目三:论文写作 【总分75分】
考试时间:15:30 - 17:30
论文题:4道题选做1道 120分钟

把《系统架构设计师教程(第2版)》当字典

系统工程与信息系统基础

系统工程【★】
信息系统生命周期【★】
信息系统开发方法【★★】
信息系统的分类【★★★】
政府信息化与电子政务【★★】
企业信息化与电子商务【★★】
数字化转型与智能制造【★★】

系统工程

系统工程是一种组织管理技术
系统工程是为了最好的实现系统的目的,对系统的组成要素、组织结构、信息流、控制机构进行分析研究的科学方法。
系统工程从整体出发、从系统观念出发,以求【整体最优】
系统工程利用计算机作为工具,对系统的结构、元素、信息和反馈等进行分析,以达到最优规划、最优设计、最优管理和最优控制的目的。
系统工程方法是一种现代的科学决策方法

系统工程方法 关键点
霍尔三维结构
“硬科学” 方法论
逻辑维:逻辑维即解决问题的逻辑过程
时间维:时间维即是工作进程
知识维:知识维即是专业科学知识
应用场景:组织和管理大型工程建设项目
切克兰德方法
“软科学” 方法论
核心不是”最优化”,而是 “比较“ 和 “探寻“
七步骤:认识问题、根底定义、建立概念模型、比较及探寻、选择、设计与实施、评估与反馈
并行工程方法 **”制造过程” 与 “支持过程” 并行 **
强调三个方面:产品设计开发期间,最快速度按质完成;各项工作问题协调解决;适当的信息系统工具
综合集成法 钱学森命名,【简单系统】和【巨系统】
四原则:整体论原则、相互联系原则、有序性原则、动态原则
WSR系统方法 实践准则:【懂物理】—【明事理】—【通人理】
霍尔三维比较偏向大型的项目
逻辑维:【做不做】
  • 明确问题
  • 确定目标(建立价值体系或评价体系)
  • 系统综合
  • 系统分析
  • 优化(系统方案的优化选择)
  • 系统决策
  • 实施计划

时间维:【做规划】

  • 规划阶段(调研,谋求活动的规划与战略)
  • 拟定方案(提出具体的设计方案)
  • 研制阶段(完成研制方案及生产计划)
  • 生产阶段(生产零部件及提出安装计划)
  • 安装阶段(安装完毕,完成系统的运行计划)
  • 运行阶段(系统按照预期的用途开展服务)
  • 更新阶段(改进原有系统、或消亡原有系统)

知识维:

工程、医药、建筑、商业、法律、管理

系统工程生命周期阶段

探索性研究 → 概念阶段 → 开发阶段 → 生产阶段 → 使用阶段 → 保障阶段 → 退役阶段
系统工程生命周期方法

计划驱动方法:需求 → 设计 → 构建 → 测试 → 部署
渐进迭代式开发:提供连续交付以达到期望的系统
精益开发:起源于丰田,是一个动态的、知识驱动的,以客户为中心的过程
敏捷开发:更好的灵活性

信息系统生命周期

系统工程建设原则

高层管理人员介入原则:CIO介入
↓
用户参与开发原则:用户确定范围、核心用户全程参与、用户深度参与
↓
自顶向下规划原则:以此减少信息不一致的现象
↓
工程化原则:引入软件工程
↓
其他原则:创新性原则、整体性原则、发展性原则、经济性原则

信息系统开发方法

原型法:针对需求不明确

  • 按功能分:水平原型(界面)、垂直原型(复杂算法)
  • 按最终结果分:抛弃式原型、演化式原型
———————————- 原型法【需求阶段】 ———————————-
结构化法 面向对象方法 面向服务的方法
开发目标清晰化
工作阶段程式化
开发文档规范化
设计方法结构化
应变能力差
自底向上
阶段界限不明
更好应变、更好复用
符合人们的思维习惯
(哪些人使用哪些功能等)
粗粒度、松耦合(SpringCloud)
标准化和构件化(一个服务一个构建)
抽象级别:
操作【低】→ 服务【中】→ 业务流程【高】

元宇宙:把现实中的东西模拟到完整的虚拟环境里面

系统开发方法习题

软件方法学是以软件开发方法为研究对象的学科。其中,()是先对最高层次中的问题进行定义、
设计、编程和测试,而将其中未解决的问题作为一个子任务放到下一层次中去解决。()是根据
系统功能要求,从具体的器件、逻辑部件或者相似系统开始,通过对其进行相互连接、修改和扩大,
构成所要求的系统。()是建立在严格数学基础上的软件开发方法。
A面向对象开发方法 B形式化开发方法
C非形式化开发方法 D自顶向下开发方法

A:面向对象开发方法其实是从底层逐步往上垒的一个过程,先去了解先要构建哪些对象,从而抽象为类 一层一层垒起来的 约等于【自低向上】
B:形式化是严格按数学方法 数学模型的方式来进行
D:结构化开发本身就是自顶向下

A自底向上开发方法 B形式化开发方法
C非形式化开发方法 D 原型开发方法

A自底向上开发方法 B形式化开发方法
C非形式化开发方法 D自顶向下开发方法

信息系统的分类

信息系统的分类 关键点
业务处理系统【TPS】 早期最初级的信息系统【20世纪50-60年代】
功能:数据输入、数据处理【批处理架构风格、OLTP】、数据库维护、文件报表产生
管理信息系统【MIS】 高度集成化的人机信息系统
金字塔结构:分多个层级
决策支持系统【DSS】 由语言系统、知识系统和问题处理系统组成
用于辅助决策、支持决策
专家系统【ES】 知识 + 推理 = 专家系统。人工智能的一个重要分支
办公自动化系统【OAS】 由计算机设备、办公设备、数据通信及网络设备、软件系统组成
企业资源计划【ERP】 打通供应链,集成,整合

业务处理系统【TPS】

【业务处理系统(Transaction Processing System,TPS)】又可称为电子数据处理系统(Electronic Data Processing System,EDP),是计算机在管理方面早期应用的最初级形式的信息系统。
TPS是服务于组织管理层次中最低层、最基础的信息系统

管理信息系统【MIS】

【管理信息系统(ManageInformation System,MlS)】是由业务处理系统发展而成的,是在TPS基础上引进大量管理方法对企业整体信息进行处理,并利用信息进行预测、控制、计划、辅助企业全面管理的信息系统。
MIS系统四大部件:信息源、信息处理器、信息用户和信息管理者。

批处理系统属于【开环系统】
计算机实时处理系统属于【闭环系统】

决策支持系统【DSS】

【决策持系统(Decision SupportSystem,DSS)】是一个由语言系统、知识系统和问题处理系统3个互相关联的部分组成的,基于计算机的系统。
【DSS应具有的特征】
(1) 数据和模型是DSS的主要资源。
(2) DSS用来支援用户作决策而不是代替用户作决策。
(3)DSS主要用于解决半结构化机器帮人做及非结构化问题。
(4)DSS的作用在于提高决策的有效性而不是提高决策的效率。

专家系统【ES】

【专家系统(ExpertSystem,ES)】是一个智能计算机程序系统,其内部含有某个领域具有专家水平的大量知识与经验,能够利用人类专家的知识和解决问题的方法来处理该领域的问题。

系统 专家系统 一般计算机系统
功能 解决问题、解释结果、进行判断与决策 解决问题
处理能力 处理数字与符号 处理数字
处理问题种类 多属准结构性或非结构性,可处理不确定的知识,使用于特定的领域 多属结构性,处理确定的知识

知识库:存储求解实际问题的领域知识
综合数据库:存储问题的状态描述、中间结果、求解过程的记录等信息。
推理机:实质是【规则解释器】
知识获取:两方面功能:知识的编辑求精及知识自学习。
解释程序:面向用户服务的。

信息系统建设原则

  • 高层管理人员介入原则:CIO介入
  • 用户参与开发原则:用户确定范围、核心用户全程参与、用户深度参与
  • 自顶向下规划原则:全局管控;以此减少信息不一致的现象
  • 工程化原则:引入【软件工程】
  • 其他原则:创新性原则、整体性原则、发展性原则、经济性原则

信息系统开发方法

  • 原型法【需求阶段】

    针对需求不明确
    按功能分:水平原型(界面)、垂直原型(复杂算法) [举例 比如123列垂直包含点菜 订单 套餐模块 那么水平就是他们包含的横着的框]
    按最终结果分:抛弃式原型、演化式原型

    • 结构化法 →
      • 自顶向下,逐步分解求精 【田 → 日 日 → 口】
      • 开发目标清晰化
      • 工作阶段程序化
      • 开发文档规范化
      • 设计方法结构化
      • 应变能力差
    • 面向对象方法 → (分析这个系统适合哪些人……)
      • 自底向上
      • 阶段界限不明
      • 更好应变、更好复用
      • 符合人们的思维习惯
    • 面向服务方法
      • 粗粒度、松耦合
      • 标准化和构件化
      • 抽象级别:操作【低】 → 服务【中】 → 业务流程【高】
  • 其他信息系统开发方法

    • 形成化方法
      • 净室软件工程【受控污染级别的环境】
      • 【数学模型化】
      • 所有东西均可证明/验证,而不是厕所
    • 统一过程方法【UP】
    • 敏姐方法
    • 基于架构的开发方法【ABSD】

政府信息化与电子政务

电子政务主要有3类角色:政府(Government)、企(事)业单位( Business)及公民(Citizen)
如果有第4类就是公务员(Employee)。

★ 人口信息采集处理和利用业务属于( 政府对政府G2G ),企业执照发放属于 (G2B),户籍管理属于 (G2C),参加政府工程交接属于 (B2G)

企业信息化与电子商务

  • 信息化基本概念
  • 企业资源计划【ERP】
  • 客户关系管理【CRM】
  • 供应链管理【SCM】
  • 商业智能【BI】
  • 数据湖
  • 业务流程重组
  • 企业应用集成
  • 电子商务

企业信息化的概念 → 企业信息化的目的 → 企业信息化的规划 → 企业信息化的方法

信息化的概念

  • 信息化是指在国家宏观信息政策指导下,通过信息技术开发、信息产业的发展、信息人才的配置,最大限度地利用信息资源以满足全社会的信息需求,从而加速社会各个领域的共同发展以推进信息社会的过程
  • 信息化的主体是全体社会成员(政府、企业、团体和个人),时域是一个长期过程,空域是经济和社会的一切领域,手段是先进社会生产工具。

信息化的目的

  • 企业信息化的具体目标是优化企业业务活动使之更加有效,它的根本目的在于提高企业竞争能力,使得企业具有平稳和有效的运作能力,对紧急情况和机会做出快速反应,为企业内外部用户提供有价值的信息。
涉及三类创新

【技术创新】在生产工艺设计、产品设计中使用计算机辅助设计系统,并通过互联网及时了解和掌握创新的技术信息,加快技术向产的转化。还有,产技术与信息技术相结合,能够幅度地提高技术水平和产品的竞争力。
【管理创新】按照市场发展的要求,要对企业现有的管理流程重新整合,从作为管理核心的财务、资金管理,转向技术、物资、人力资源的管理,并延伸到企业技术创新、工艺设计、产品设计、生产制造过程的管理,进而还要扩展到客户关系管理、供应链的管理乃至发展到电子商务。
【制度创新】那些不适应企业信息化的管理体制、管理机制和管理制度必须得到创新。

信息化需求的三个层次

组织对信息化的需求是【组织信息化的原动力】

【信息化需求的三个层次】

战略需求 → 目标【提升组织的竞争能力】
运作需求 → 【实现信息化战略目标】的需要、【运作策略】的需要、【人才培养】的需要
技术需求 → 信息技术层面上对【系统的完善、升级、集成】

★ 组织信息化需求通常包含三个层次,其中()需求的目标是提升组织的竞争能力,为组织的可持续发展提供支持环境。()需求包含实现信息化战略目标的需求、运营策略的需求和人才培养的需求三个方面。技术需求主要强调在信息层技术层面上对系统的完善、升级、集成和整合提出的需求。
A战略 B发展 C人事 D财务
A规划 B运作 C营销 D管理

企业信息化方法

业务流程重构方法:“彻底的、根本性的” 重新设计流程。
核心业务应用方法:围绕核心业务推动信息化。
信息系统建设方法:建设信息系统作为企业信息化的重点和关键。
主题数据库方法:建立面向企业的核心业务的数据库,消除“信息孤岛”。
资源管理方法:切入点是为企业资源管理提供强大的能力。如:ERP、SCM。
人力资本投资方法:人力资本理论【注意不是人力资源管理】把一部分企业的优秀员工看作是一种资本,能够取得投资收益。

信息系统战略规划 - 方法

  • 第一阶段【以数据处理为核心 围绕职能部门需求】
    • 企业系统规划法【BSP】
    • 关键成功因素法【CSF】
    • 战略集合转化法【SSt】
  • 第二阶段【以企业内部MIS为核心 围绕企业整体需求】
    • 战略数据规划法(SDP,Strategic Data Planning):主题数据库
    • 信息工程法(IE,Information Engineering)
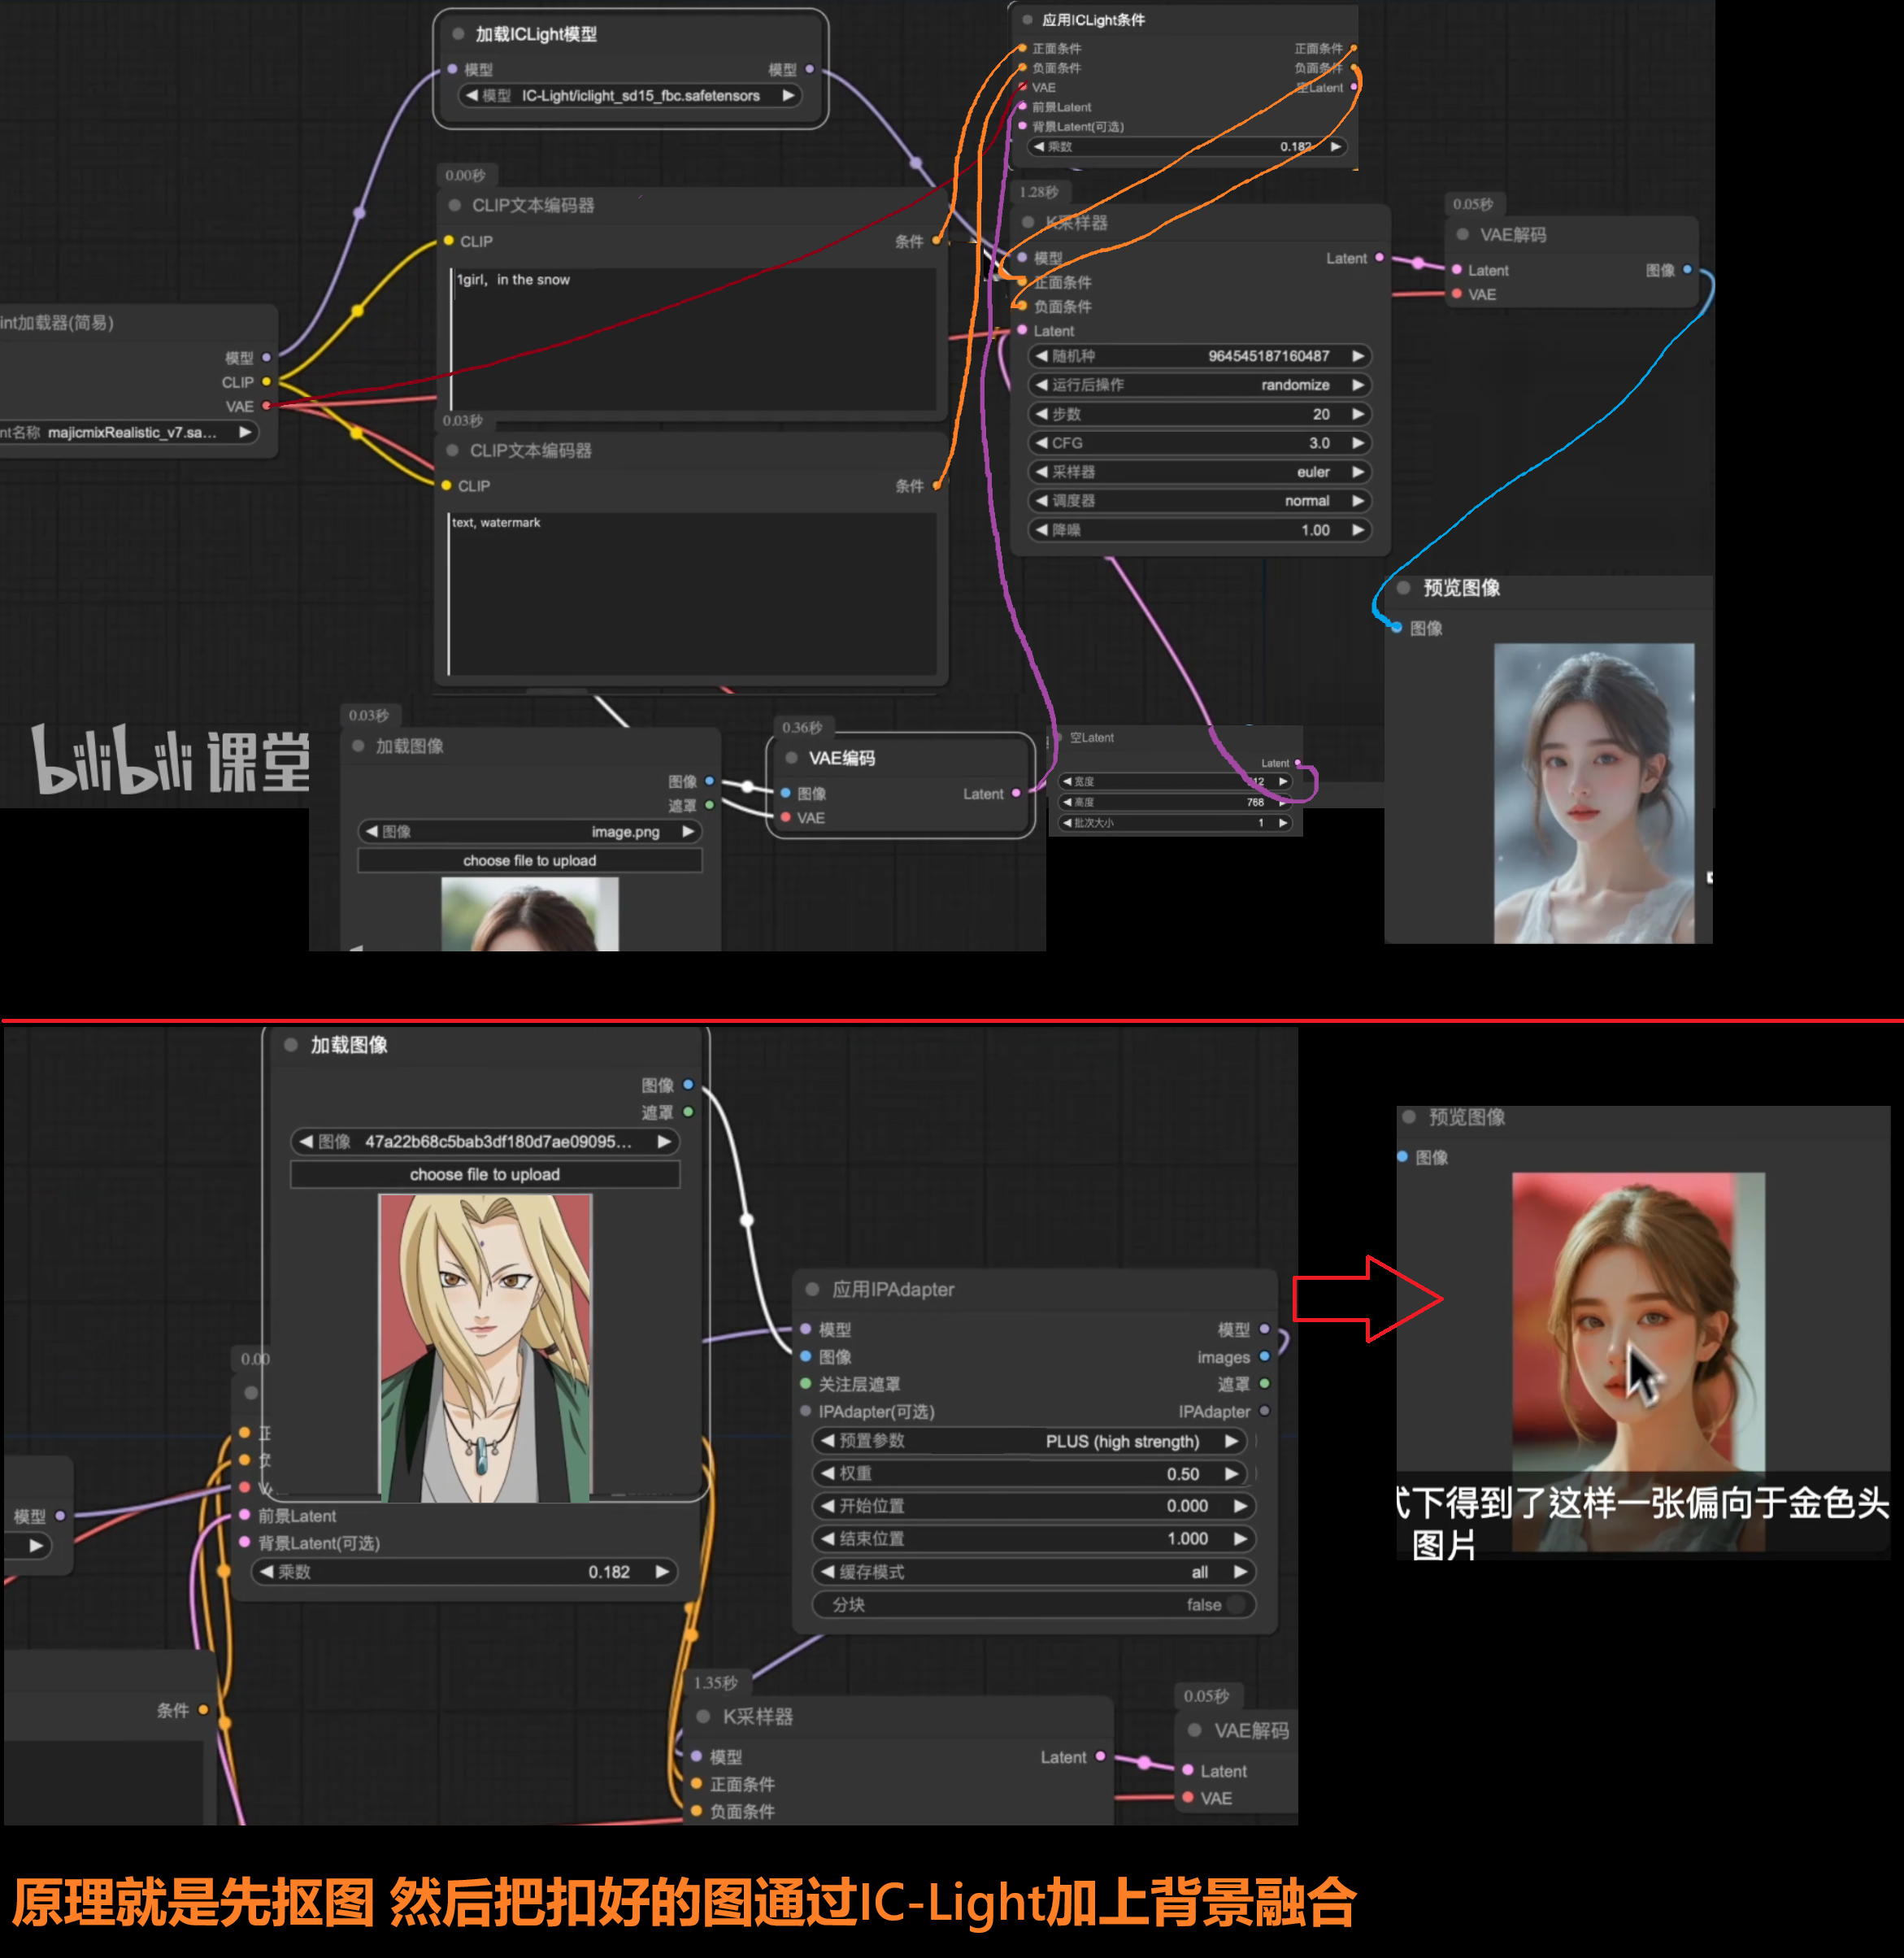
    • 略栅格法(SG,Strategic Grid)
  • 第三阶段【综合考虑企业内外环境以集成为核心,围绕企业战略需求】
    • 价值链分析法(VCA,Value Chain Analysis)
    • 战略一致性模型(SAM,Strategic Alignment Model)

★ 用于管理信息系统规划的方法有很多,其中()将整个过程看成是一个“信息集合”,并将组织的战略目标转变为管理信息系统的战略目标。()通过自上而下地识别企业目标、企业过程和数据,然后对数据进行分析,自下而上地设计信息系统。

A.关键成功因素法 B.战略目标集合转化法 C.征费法 D.零线预算法
A.企业信息分析与集成法 B.投资回收法 C.企业系统规划法 D.阶石法

【这里的图片还没上传 有问题!!!!!!!!!!!】

信息-系统战-略规划

企业信息化与电子商务 — 商业智能(BI)

★ 商业智能是指利用数据挖掘、知识发现等技术分析和挖掘结构化的、面向特定领域的存储与数据仓库的信息。它可以帮助用户认清发展趋势、获取决策支持并得出结论。以下(B)活动,并不属于商业智能范畴。

A 某大型企业通过对产品销售数据进行挖掘,分析客户购买偏好
B 某大型企业查询数据仓库中某种产品的总体销售数量 [B只做了商品查询,并没有复杂的数据分析]
C 某大型购物网站通过分析用户的购买历史记录,为客户进行商品推荐
D 某银行通过分析大量股票交易的历史数据,做出投资决策


★ 商业智能系统的处理过程包括四个主要阶段:数据预处理通过(C)实现企业原始数据的初步整合;建立数据仓库是后续数据处理的基础;数据分析是体现系统智能的关键,主要采用(D)和(B)技术,前者能够实现数据的上卷、下钻和旋转分析,后者利用隐藏的知识,通过建立分析模型预测企业未来发展趋势:数据展现主要完成数据处理结果的可视化。

A 数据映射和关联
B 数据集市和数据立方体
C 数据抽取、转换和装载 [ETL]
D 数据清洗和数据集成

A 知识库
B 数据挖掘
C 联机事务处理
D 联机分析处理 [OLAP]

A 知识库
B 数据挖掘
C 联机事务处理
D 联机分析处理

企业信息化与电子商务 — 数据湖

数据湖是一个存储企业的各种各样原始数据的大型仓库,其中的数据可供存储、处理、分析及传输。

企业信息化与电子商务—BPR和BPM

BPR【业务流程重组】颠覆原有流程、彻底性的再设计
BPM【业务流程管理】使用PDCA循环,持续改进

企业应用集成【EAI】

[财务、研发、人事、销售、采购]

系统未互联互通,存在【信息孤岛】
这种架构也被称为【烟囱架构】

系统互联互通
         研发
          |
财务    ——    集成    —— 人事
         /    \    
    销售         采购

企业应用集成【EAI】用于消除信息孤岛

企业应用集成方法论

某大型公司欲开发一个门户系统,该系统以商业流程和企业应用为核心,将商业流程中不同的功能模块通过门户集成在一起,以提高公司的集中贸易能力、协同能力和信息管理能力。根据这种需求,采用企业(C)门户解决方案最为合适。

A信息 B知识 C应用 D垂直

电子商务类型

企业信息化与电子商务——电子商务

电子商务主要有2类角色:企业(Business) 及 个人(Customer)

类型 应用
B2B 1688,慧聪网
C2C 咸鱼
B2C 京东,天猫
C2B 个人给企业提供咨询服务
O2O
(Online To offline)
【线上对线下】
团购

O2O可以和其他的交叠

企业信息化与电子商务——数字化转型

【数字化】是新一代信息技术真正的实现推动整个【商业模式的变革】,推动产业链的重构,推动改进企业与消费者之间的关系,以及企业与合作伙伴之间的关系。

企业数字化转型的五个发展阶段:

  • 初始级发展阶段
    数码化:信息的数字化,记录、储存、传输数码化。
  • → 单元级发展阶段
    数量化:提升单项业务的运行规范性和效率。
  • → 流程级发展阶段
    数字化:关键业务流程及关键业务与设备设施、软硬件、行为活动等要素间的集成优化。
  • → 网络级发展阶段
    数模化:组织(企业)级数字化和产业互联网级网络化,实现以数据为驱动的业务模式创新。
  • → 生态级发展阶段
    数用化:生态级数字化和泛在物联网级网络化,推动与生态合作伙伴间资源、业务、能力等要素的开放共享和协同合作。
企业信息化与电子商务——智能制造体系

(系统层级)
【设备层】传感器、仪器仪表、机器、装置等
【单元层】企业内处理信息、实现监测和控制物理流程的层级
【车间层】面向工厂或车间的生产管理的层级
【企业层】面向企业经营管理的层级
【协同层】其内部和外部信息互联和共享,实现跨企业间业务协同的层级


软件工程

软件过程模型(★★★★)
基于构件的软件工程(★★)
逆向工程(★)
净室软件工程(★)
需求工程(★★)
系统分析与设计(★★)
软件测试(★★)
系统运行与软件维护(★)

软件过程模型

  • 瀑布模型(要求在整个过程中分点,第一步做什么,第二步做什么,每个阶段有相应的评审,这个阶段做完才会做下一个阶段)
  • V模型【瀑布变种】
  • 原型模型(一个初潜层次的简易系统的构造)
  • 螺旋模型【原型+瀑布】
  • 构件组装模型/基于构件的开发方法
  • 快速应用开发RAD【瀑布+构件组装】
  • 统一过程/统一开发方法
  • 敏捷开发方法(有原型有快速迭代等一系列思想结合 综量化)

瀑布模型[只适合于需求明确的项目]

大多数软件需求项目的需求都不是很明确 所以Nasa都很难做到瀑布模型

一旦需求要改 会影响后续每个模块 一旦改了就要都涉及到的

特点:
① 严格区分阶段,每个阶段因果关系紧密相连
② 只适合需求明确的项目

需求分析→
       ↓
 软件设计→
        ↓
   程序设计→
          ↓
     编码实现→
            ↓
        单元测试→
               ↓
            集成测试→
                   ↓
                系统测试→
                       ↓
                    运行维护

缺点:
① 软件需求完整性、正确性难确定
② 严格串行化,很长时间才能看到结果
③ 瀑布模型要求每个阶段一次性完全解决该阶段工作,这不现实。

原型模型

适合需求不明确的项目

原型模型两个阶段:
1、原型开发阶段
2、目标软件开发阶段

【抛弃型原型】与【演化型原型】

 →→→ 需求分析→
 ↑          ↓
 ↑    →→→软件设计→→
 ↑    ↓           ↓
 ↑    ↓   ↑→→ 程序设计
 →→原型开发←          ↓     
                   ↓
              编码实现→→
                      ↓
                 单元测试→→
                         ↓
                    集成测试→
                           ↓
                        系统测试→
                               ↓
                            运行维护

原型相关模型

迭代思想 (迭代模型)
演化模型(变换模型)  ——————————  螺旋模型
 演化 |                       /     |
 原型 |                 /           |
 成为 |           /            瀑布模型
 最终 |       /                   |
 产品 |  /                       V
    原型 ———————————————————> 增量模型
     |
     |
快速原型模型

V模型【强调测试】

测试贯穿于始终。测试分阶段,测试计划提前

需求分析                验收测试
   ↘                   ↗
 概要设计              系统测试
     ↘                 ↗
  详细设计           集成测试
       ↘           ↗ 
       编码    单元测试
         ↘     ↗
           V模型

迭代与增量【UP / 敏捷】

增量型:一轮一轮的在增加
迭代型:一轮一轮的在变好

螺旋模型 + 构件组装模型 +CBSE + RAD

以快速原型为基础 + 瀑布模型

考虑了风险问题

统一过程

用例驱动,以架构为中心,迭代和增量

【循环图】四大阶段

  • 初始:定义最终产品试图和业务模型;确定系统范围
  • 细化:设计及确定系统架构;制定工作计划及资源要求
  • 构造:开发剩余构件和应用程序功能,把这些构件即成为产品,并进行详细测试
  • 移交:确保软件对最终用户是可用的,进行β测试,制作产品发布版本

9个核心工作流

  • 业务建模;**需求;分析与设计;实现;测试;部署;**配置与变更管理;项目管理;环境

★ (螺旋模型) 把整个软件开发流程分成多个阶段,每一个阶段都由目标设定风险分析、开发和有效性验证以及评审构成。
A 原型模型
B 瀑布模型
C 螺旋模型
D V模型

★ 统一过程开发方法分初始、细化、构建和移交四个阶段,每次通过这四个阶段就会产生一代软件,其中(细化)阶段的核心任务是完成系统架构。统一过程开发方法从另一个维度看,有9个核心工作流,其中不包括(商务建模)。

敏捷方法

历程:

无软件开发方法(无序,不可控) → 传统软件开发方法(结构化方法) → 敏捷方法

  • 传统软件开发方法
    • 预设性的
    • 以开发过程为本
    • 整体分阶段
  • 敏捷方法
    • 适应性的(整个过程不断调整变化)
    • 以人为本(以人为中心)
    • 增量迭代,小步快跑
    • 适合小型项目

☆ 敏捷宣言:个体和交互胜过过程和工具;可工作的软件胜过大量的文档;客户合作胜过合同谈判;响应变化胜过遵循计划

阅读全文

Appium

2025/8/12

测试方面

  • 功能测试
  • 安装卸载测试
  • 升级测试
  • 兼容性测试[不同机型 系统]
  • 网络切换,中断测试
  • 横竖屏切换
  • 健壮性

测试环境的搭建

需要配置的环境:
  • java jdk java环境
  • Android sdk 安卓环境
  • python环境
    • 第三库:appium
  • 使用真机或模拟器进行测试【夜神模拟器】

环境搭建验证测试

模拟器或真机

在cmd中输入 adb devices 会返回ip地址和端口号
获取系统版本号输入 adb shell getprop ro.build.version.release
获取虚拟器里的app名称 adb shell dumpsys window windows | findstr mFocusedApp

{c361382 u0 com.android.settings/.Settings t9}}} /.后面是界面的名字 u0后 /.前是app名称

import time

from appium import webdriver
from selenium.webdriver.common.by import by  #【利用by自动获取信息】

# 配置手机连接的参数信息
# 参数信息都是以键值对的方式进行连接
desired_caps = {}

# 设备的名称
desired_caps["deviceName"] = "127.0.0.1:62001"

# 系统
desired_caps["platformName"] = "Android"

# 系统版本号
desired_caps["platformVersion"] = "7.1.2"

# 启动的app名称
## com.android.settings
desired_caps["appPackage"] = "com.android.settings"

# 启动的app界面:.Settings
desired_caps["appActivity"] = ".Settings"

# print(desired_caps)

# 发送链接  用的appium的端口  用关键字传参
driver = webdriver.Remote("http://127.0.0.1:4723/wd/hub",desired_capabilities = desired_caps)

time.sleep(5)
driver.quit()
...
...

app自动化测试的流程

① 首先明确项目的核心模块
  • 注册登录
  • 阅读文章
  • 搜索内容
  • 发布评论
  • 关注订阅
  • 私信聊天
  • 点赞等等
② 设计用例脚本

分析用例执行的步骤

  • 进入app首页
  • 点击我的界面
  • 点击登录/注册
  • 点击使用邮箱登录/注册
  • 输入邮箱号
  • 输入密码
  • 点击登录
  • 登录成功/失败
  • 进行断言
自动截取虚拟器上界面的图片查看详情

D:\android_sdk_test\tools\uiautomatorviewer.bat

若两个 resource-id 定位是一样的那么就需要手写XPATH【resource-id必须唯一!!】

####### 这些都是线性脚本!!!
# 两个斜杠是代表当前界面所有的元素  增加个文本标识
driver.find_element(By.XPATH,'//*[@text="我的"]').click()
# 点击登录/注册
driver.find_element(By.ID,'io.manong.developerdaily:id/login_btn').click()
# 点击使用邮箱登录/注册   这里有报错是因为代码执行很快 但界面有延迟 需要加等待
time.sleep(2)
driver.find_element(By.ID,'io.manong.developerdaily:id/btn_email').click()

# 输入邮箱号
time.sleep(2)
driver.find_element(By.ID,'io.manong.developerdaily:id/edt_email').send_keys("zzz@qq.com")
# 输入密码
driver.find_element(By.ID,'io.manong.developerdaily:id/edt_email').send_keys("123123")
# 点击登录
driver.find_element(By.XPATH,'//*[@text="登录"]').click()
# 用户名是tata
try:
name_text = driver.find_element(By.XPATH,'io.manong.developerdaily:id/nav_tv_name').click()
if name_text == "tata":
    print("登录成功")

# - 登录成功/失败
# - 进行断言
    assert name_text == "tata"
except:
    login_failed_msg = driver.find_element(By.XPATH,'io.manong.developerdaily:id/forgot').click()
    print("登录失败")
    assert login_failed_msg == "忘了密码?点此找回"
time.sleep(5)
...
...

若换了一个模块要重新截图 选取不同的app界面
这些用例测试属于冒烟测试的过程

Allure是一款灵活、轻量级的多语言测试报告工具,旨在生成美观且易于阅读的测试报告。它由Qameta Software团队开源,支持多种测试框架,如Pytest和TestNG等。Allure不仅可以快速查看测试结果,还能帮助团队成员清晰了解测试过程中的缺陷和问题。通过Allure,用户可以轻松集成测试用例,并生成统一格式的报告,提升测试的可读性和有效性。

总结梳理

核心业务流程梳理
  • 需求分析
  • 设计用例脚本
  • 编写自动化测试脚本
    • 将冒烟测试的脚本进行深度封装和模式设计
      • 选择设计模式:
        • POM设计模式
        • KDT设计模式
      • 引入测试框架pytest结合设计模式进行深度封装
      • 执行过程中进行日志信息的记录log
      • 执行完成之后自动化完成测试报告allure
      • 持续集成Jenkins
  • 脚本维护以及迭代更新

app自动化测试的核心技能点:

Python + Appium + pytest + parametrize + csv + pom + log + Allure + Jenkins

项目梳理及描述

脚本执行的时候会直接发送给Appium服务器 执行py代码后 在Appium会执行许多adb的命令 再去控制手机 完成自动化测试【线性模块 正反例要跑通噢】

站在项目已经完成雏形的基础上,进行项目梳理和总结

  • 整个项目中的文件解析

    • 每个文件包和模块具体的使用规范
  • 整个项目中的模块与文件之间的联系

    • 各个模块及包之间的导入使用
  • 整体从项目完成之后的角度触发去讲解项目搭建流程以及使用规范

    • 搭建app自动化测试环境:

      • 安卓sdk
      • java的sdk
      • 安装appium
      • 使用真机或者安装手机模拟器
      • 安装第三方库:Appium-Python-Client
    • 编写自动化的用例线性脚本

      • 新建一个项目

      • 创建一个script脚本包

        • 梳理核心业务模块和功能

          • 登录
          • 注册
          • 点赞评论收藏
          • 发布文章
          • 浏览文章
          • …
        • 创建py模型进行线性脚本编写

          • 通过核心业务流程模块梳理出线性脚本的执行步骤
          • 然后通过编写自动化用例脚本执行完成第一轮正反例的冒烟测试
            • 梳理被操作元素以及具体操作方法
            • 执行正反例之后进行断言
            • 保证自动化用例的准确性

若是那种本身图标没有id 没有任何标志的 比如点赞,收藏,评论 就可以直接通过坐标去定位【要考虑分辨率和坐标以及机型】
回归测试一般只需要正例脚本!!!

  • 选择设计模式pom【Page Object Model页面对象模型的简称】

    • 封装
      • 一个类就是一个流程用例或者一个界面
      • 将界面中需要被操作的每一个元素封装成类属性
      • 将界面中需要被执行的用例步骤定义成一个实例方法
    • 使用
      • 创建页面类对象
      • 通过对象调用方法执行用例步骤脚本
      • 获取实际结果进行断言
    • 整个页面封装
    • 将线性文件进行封装
  • 引入测试框架结合用例执行以及管理

    • 用例进行综合管理
    • 使用参数化进行数据驱动测试:
    @pytest.mark.parametrize("user_email, password, t_a_f",[
        [" ", "123123", False],
        ["123@qq.com", "123123", True],
        ...
    ])
    
    • 一般情况在用例执行之前讲参数化使用的实参进行读取使用
      • 数据量比较多的情况下会使用不同的文件格式存储数据
        • Csv
        • text
        • Excel
        • yaml
        • JSON
        • …
      • 数据驱动测试主要核心就是在用例设计的过程中,把所有用例需要的正反例数据进行保存
      • 然后再使用的时候进行读取自动化操作用例完成脚本内容
  • 日志信息的记录

  • 缺陷报告的生成

  • 持续集成的处理

单独执行某个用例(venv) D:\app_project>pytest -vsk test_login
有很多其他的需要保持登录的情况下进行测试 ↓

# 点赞评论及收藏
def test_like_comment_collect(go_login):
    # 创建页面类对象
    l_c_l_page = LikeCommentCollectPage(go_login)
    # 通过对象调用方法执行用例步骤
    l_c_l_page.execute_cases()
    
# 发布文章
def test_publish_article(go_login):...

# 浏览文章
def test_browse_article(go_login):...

Pywinauto基本介绍【基本解决找不到元素问题】

主要用于自动化图形用户界面,他提供了一组功能丰富的工具和方法,能够模拟用户的各种操作:点击,输入,文本,选择菜单栏等等…从而实现对Windows应用程序的自动化控制

pywinauto的基本特性
  • 支持跨平台
  • 强大的GUI自动化功能【用户交互图形界面】
  • 简单易用
  • 支持多种应用程序的类型
  • 丰富的文档和社区支持
  • 支持多种GUI框架
  • 图像识别和模糊匹配
pywinauto应用场景
  • 自动化测试
  • ui自动化测试
  • 数据录入和处理
  • 窗口管理
  • …
pywinauto的安装和使用

需要安装第三方库依赖:pywinauto
安装命令:【pycharm可以在某个项目下安装】
pip install pywinauto
可以用pip list查看是否安装好了 pywinauto

pywinauto基本使用

案例:使用pywinauto编写自动化脚本,完成记事本的基本操作
操作流程:

  • 打开记事本
  • 点击帮助(关于记事本)
  • 点击确定
  • 输入内容
  • 点击关闭记事本
  • 点击不保存
# 导包
from pywinauto.application import Application

# 启动记事本  backend='uia'意思是连接记事本的后端是什么类型
# app = Application(backend='uia').start('notepad.exe')
app = Application(backend='win32').start('notepad.exe')

# 点击帮助(关于记事本) 使用快捷键完成打开关于记事本的信息  %是Alt符号  H:h  A:a
app.Notepad.type_keys('%HA', pause=1)

# 点击确定  re正则匹配
dlg = app.window(title_re='关于记事本')
 # 获取窗口的界面元素信息  【关于记事本的元素架构】
dlg.print_control_identifiers()
 #  点击    不直接调用click是要运用鼠标真实的模拟
time.sleep(1)
dlg['确定Button'].click_input()

# 输入内容
app.Notepad.type_keys('xx教育')
# 点击关闭记事本
 # 菜单栏选择 ->表示子菜单
app.Notepad.menu_select("文件(&F)->退出(&X)")
# 点击不保存
app.window(title_re='记事本').window(title_re='不保存').cli
桌面化元素定位工具:UISpy.exe【层级树】、inspect.exe
阅读全文

AI_Linux运维

2025/7/16

IT运维基本概念

系统运维

聚焦基础设施稳定性,通过监控工具(如Zabbix、Prometheus)实时追踪服务器、网络及操作系统状态,实施负载均衡、几余设计,快速响应硬件故障或性能瓶颈,确保业务连续性。

自动化运维

以效率提升与标准化为目标,借助像Ansible自动化工具部署、配置管理及巡检任务,结合CI/CD流水线实现发布流程无人化,减少人为失误并提升迭代速度。

数据库运维

核心是数据安全与性能调优,通过定期备份恢复、主从复制保障数据可靠性,利用慢查询分析、索引优化及资源监控(如MySQLPerformance Schema)提升数据库响应效率。

容器运维

专注容器编排与弹性调度,基于Kubernetes实现容器生命周期管理、服务发现及自动扩缩容,配合lstio服务网格治理微服务,确保分布式应用的高可用与快速伸缩。

云计算运维

围绕资源弹性与成本优化,利用云平台(如AWS/Aliyun)的自动扩缩容、Serverless服务动态匹配资源需求,通过资源标签、账单分析工具优化云开支,平衡性能与成本。

信创运维

解决国产化适配与生态兼容,在鲲鹏CPU、统信0S、达梦数据库等信创体系中,完成软硬兼容性测试、系统迁移,满足政策与安全要求。

开发流程

流程:产品设计->项目研发->项目测试->项目上线->运维
研发:前端(HTML+CSS+JavaScript)+后端(Java/Python/Go)
运维:产品上线、后期的运行与维护工作都属于运维工程师范畴

环境 主要用户 主要用途 优势
开发环境 开发人员 编写和初步调试代码,快速验证想法 降低风险、提高效率、保证质量
测试环境 测试工程师、QA团队 自动化测试、功能测试、性能测试、模拟真实场景,发现隐藏问题 降低风险、提高效率、保证质量
生产环境 最终用户 正式对外提供服务要求高可用、高稳定、高安全 降低风险、提高效率、保证质量

工单系统

工单系统(TicketingSystem)是运维工程师和 IT支持团队在日常工作中广泛使用的工具。简单来说,它是一种用于记录、分配和处理工作请求、问题报告、变更申请等事项的系统。

  • 提交工单

    用户在系统中填写问题描述、所属类别、优先级等

  • 自动分配

    系统根据规则将工单自动分配相关人员

  • 处理反馈

    处理人记录诊断与解决方案,并与用户沟通

  • 验证关闭

    用户确认问题已解决后工单状态变为“已关闭”

网络通信”三要素“

网络通信是指在不同设备间通过网络连接进行数据传输与交换的过程。

**协议(Protocol)**:协议定义了数据在网络中传输时的规则和格式。常见的协议有 TCP/IP、UDP、HTTP/S、FTP 等它们规定了数据如何被分割、传输、接收和重组。

**IP(internet Protocol)**:IP 地址用于唯一标识网络中的每一台设备。它充当设备的“地址”,使得数据能够在网络中准确地找到目标设备。

IPV4
格式:x.x.x.x
由4个8位的二进制数组成,
每组之间用点分隔,展示形
式以10进制表示
如:192.168.88.102

IPV6格式:
由8个16位的十六进制数组成,
每组数字之间用冒号分隔。
如:2001:0db8:85a3:0000:0000:8a2e:0370:7334

**端口(Port)**:端口用于区分同一台设备上不同的应用程序或服务。在计算机网络中,一个|P 地址可以对应多个服务每个服务通过不同的端口进行通信。端口号是通信中识别应用程序的方式。

端口范围 名称 说明
0 ~ 1023 知名(保留)端口 通常被系统或服务使用(例如HTTP 使用端口 80,HTTPS 使用端口 443,FTP使用端口 21)
1024 ~ 49151 注册端口 通常用于用户和应用程序之间的通信(如数据库服务等)
49152 ~ 65535 动态或私有端口 用于临时连接或客户端通信

云服务器

云服务器(Cloud Server),又称云主机或弹性计算服务(Elastic Compute Service,ECS),是基于云计算技术提供的一种虚拟化服务器。

云服务器利用虚拟化技术,将物理服务器的计算资源(如CPU、内存、存储等)封装成一个或多个独立的虚拟环境,用户可以按需通过互联网远程访问和使用这些资源。

Linux目录结构
目录 作用
/bin 二进制命令所在目录(普通命令=>普通用户和超级管理员root)
/home 与 /root 家目录,/home表示普通用户的家目录,/root表示超级用户root的家目录
/opt 额外的应用软件包,安装qq、游戏、wps办公软件
/sbin 和管理系统相关的命令,【超级管理员用】,s=super超级
/tmp 临时文件目录,这个目录被当作回收站使用
/usr 用户或系统软件应用程序目录,类似Windows中的Program files
/dev /device缩写,设备文件目录,磁盘,光驱=>/dev/sr0
/etc 系统配置文件目录,启动程序,几乎所有的软件都会把自己的配置文件安装在/etc中

项目部署架构

更改主机名hostnamectl set-hostname node1.itcast.cn + su

MySQL

200.146 机器 → [root@node1 sql]# mysql -uroot -proot < ry-zzyl.sql 在这个位置/opt/zzyl/sql

Redis

密码:heima123456
启动Redis:[root@node1 sql]# redis-server /root/tmp/redis-6.2.4/redis.conf
测试redis-cli已连接:redis-cli ping
连接:redis-cli

项目接入阿里云OSS(key + secret)

E:\BaiduNetdiskDownload\AI运维\项目内容\后端打包文件\后端打包文件\zzyl-admin.jar\BOOT-INF\classes\application-prod.yml 托到桌面 然后改完再拖回去

开通百度千帆大模型授权老人体检报告分析
项目接入百度千帆大模型(key + secret)

依旧是上方阿里云的操作

项目管理后端部署

同上更换application-prod.yaml的redis和mysql连接的地址以及账号密码

  • 安装jdk11

    先创建放置jdk11的安装包目录mkdir -p /export/software 然后
    将E:\BaiduNetdiskDownload\AI运维\项目内容\jdk\jdk\openjdk-11.0.0.2_linux-x64.tar.gz 放进去
    接着对jdk11安装包进行解压: 解压到 /opt
    tar -xzf openjdk-11.0.0.2_linux-x64.tar.gz -C /opt/
    cd /opt/
    输入ll查看 然后配置JDK环境变量

    vim /etc/profile
      
    在文件的尾部添加: 
    # JAVA_HOME
    export JAVA_HOME=/opt/jdk-11.0.0.2
    export PATH=$JAVA_HOME/bin:$PATH
    export CLASSPATH=$JAVA_HOME/lib:$CLASSPATH
    
    
    保存退出后,执行加载操作:
    source /etc/profile
    
    
    校验:
    java -version
    
    # /etc/profile
    
    # System wide environment and startup programs, for login setup
    # Functions and aliases go in /etc/bashrc
    
    # It's NOT a good idea to change this file unless you know what you
    # are doing. It's much better to create a custom.sh shell script in
    # /etc/profile.d/ to make custom changes to your environment, as this
    # will prevent the need for merging in future updates.
    
    pathmunge () {
        case ":${PATH}:" in
            *:"$1":*)
                ;;
            *)
                if [ "$2" = "after" ] ; then
                    PATH=$PATH:$1
                else
                    PATH=$1:$PATH
                fi
        esac
    }
    
    
    if [ -x /usr/bin/id ]; then
        if [ -z "$EUID" ]; then
            # ksh workaround
            EUID=`/usr/bin/id -u`
            UID=`/usr/bin/id -ru`
        fi
        USER="`/usr/bin/id -un`"
        LOGNAME=$USER
        MAIL="/var/spool/mail/$USER"
    fi
    
    # Path manipulation
    if [ "$EUID" = "0" ]; then
        pathmunge /usr/sbin
        pathmunge /usr/local/sbin
    else
        pathmunge /usr/local/sbin after
        pathmunge /usr/sbin after
    fi
    
    HOSTNAME=`/usr/bin/hostname 2>/dev/null`
    HISTSIZE=1000
    if [ "$HISTCONTROL" = "ignorespace" ] ; then
        export HISTCONTROL=ignoreboth
    else
        export HISTCONTROL=ignoredups
    fi
    
    export PATH USER LOGNAME MAIL HOSTNAME HISTSIZE HISTCONTROL
    
    # By default, we want umask to get set. This sets it for login shell
    # Current threshold for system reserved uid/gids is 200
    # You could check uidgid reservation validity in
    # /usr/share/doc/setup-*/uidgid file
    if [ $UID -gt 199 ] && [ "`/usr/bin/id -gn`" = "`/usr/bin/id -un`" ]; then
        umask 002
    else
        umask 022
    fi
    
    for i in /etc/profile.d/*.sh /etc/profile.d/sh.local ; do
        if [ -r "$i" ]; then
            if [ "${-#*i}" != "$-" ]; then 
                . "$i"
            else
                . "$i" >/dev/null
            fi
        fi
    done
    
    unset i
    unset -f pathmunge
    
    export JAVA_HOME=/opt/jdk-11.0.0.2
    export MAVEN_HOME=/opt/maven
    export MYSQL_HOME=/usr/local/mysql
    
    export PATH=$JAVA_HOME/bin:$MAVEN_HOME/bin:$MYSQL_HOME/bin:$PATH
    export CLASSPATH=$JAVA_HOME/lib:$CLASSPATH
    
  • 上传jar包到node2节点中

    mkdir -p /opt/zzyl/backend

将E:\BaiduNetdiskDownload\AI运维\项目内容\后端打包文件\后端打包文件\zzyl-admin.jar的拖入node2节点的/opt/zzyl/backend/
cd /opt/zzyl/backend/
java -jar zzyl-admin.jar

部署前端

nginx:[3-0基础带你入行AI Linux运维_项目部署上线.pdf](file:///E:/BaiduNetdiskDownload/AI运维/3-0基础带你入行AI Linux运维_项目部署上线.pdf)

智能客服私有化大模型部署

完成大模型ECS服务器申领

安装GPU驱动

基础环境安装(Anaconda、)

模型部署上线与测试(conda搞虚拟环境、下载chatglm-6b模型知识库、上传ChatGLM-6B代码、安装依赖pip-install)

阿里云监控组件

阿里云的云监控服务(CloudMonitor)是一款简单易用、功能强大的监控工具,主要用来帮助用户实时监控阿里云上的各种资源(比如服务器、数据库、网络等),并在出现问题时及时发出警报,确保业务稳定运行。

  • 开通云监控
  • 打开云监控控制台
  • 打开主机监控
  • 为需要监控的主机安装Agent 点击自动安装[等待片刻,重新刷新对应的CPU使用率、内存使用率、磁盘使用率的数据即可出现]
系统警报服务配置

云监控中的报警服务规则配置的主要目的是帮助用户实时监控阿里云资源、线下IDC、其他云厂商产品或自定义监控数据的运行状态,并在监控指标达到预设条件时,自动触发报警通知。通过这种方式,用户可以及时获取异常信息并快速采取措施,确保业务系统的稳定性和可靠性,

  • 设置报警联系人
    报警联系人:当触发条件后,这些对应的人员信息需要提前录入需要通知相关人员

  • 设置报警联系组

    报警联系组:多个联系人合并为一个组,不同的类型可以单独设置为组,告警的时候可以直接针对多个用户同时告警

  • 设置报警规则
    报警规则:帮助用户监控运行状态,并在监控指标达到预设条件时,自动触发报警通知

需求:监控CPU指标,当连续1分钟CPU使用率超过80%,邮件提醒;提醒;当连续5分钟CPU使用率超过95%,进行电话+短信+邮件;当连续3分钟CPU使用率超过90%,进行短信+邮件

报警联系人 → 设置报警联系人 → 创建报警规则 → 设置规则描述(规则名称:CPU使用率监控) 里面有紧急红色 警告黄色 普通蓝色 → 可以设置通道沉默周期 → 生效时间 → 选择报警联系人组 → 恢复通知(恢复正常通知) 👉 云监控里面有测试脚本cpu_test.sh 上传到服务器即可
sh cpu_test.sh sh是用来运行.sh脚本的命令

对于一些常用指标,云监控提供了一键告警方案,可以直接开启使用

系统运维常见问题
  • CPU负载

    步骤一:确认是否存在负载过高 使用top或htop命令查看系统的平均负载值。
    第一行:load average:4.03,3.71,2.25
    [如果负载值持续高于CPU核心数的0.5倍,则看你存在负载过高问题。如果超过1则负载已经较高了,当超过2~3倍意味着负载超高,需要立即解决]

    步骤二:排查CPU负载过高原因

    原因 具体表现 如何解决
    异常进程或服务占用大量CPU资源 单个进程或服务占用大量CPU资源,导致整体CPU使用率升高。 使用top或htop命令查看具体占用CPU资源的进程按Shift+P按键,按CPU使用率排序定位异常进程,然后通过Kill9终止异常进程
    系统资源不足 实例CPU性能不足以支撑当前业务需求 升级实例规格或者优化业务逻辑
    磁盘或网络I/O瓶颈 CPU负载高但实际CPU使用率较低,可能是磁盘或网络I/0瓶颈导致 优化磁盘读写,比如升级高性能云盘优化网络带宽:增加公网带宽或调整内网流量分布
    僵尸进程或不可中断的睡眠状态 通过top命令观察,CPU使用率不高但负载值较高 ps -axjf | grep “D+” 查看是否存在僵尸进程或不可中断的睡眠状态,如果存在建议恢复其对应依赖资源或重启系统
    系统遭遇病毒或恶意程序攻击 CPU使用率高但无法通过top等命令找到异常进程 通过云监控监测异常时间点,检查是否存在异常域名或IP的网络通信,如果确认,建议先备份数据,然后回滚实例并进行病毒扫描
  • 内存爆满

    步骤一:确认是否存在内存爆满 使用top或htop命令查看系统的平均负载值。
    下面那几行 MiB Mem:….
    当Mem行的 free值几乎为0时,表示剩余内存几乎没有了

    步骤二:排查内存过高的原因

    原因 具体表现 如何解决
    异常进程占用大量内存 单个进程或程序长时间占用大量内存资源 使用top或htop命令查看具体占用内存资源的进程。按M按键,按内存使用率排序,定位异常进程,然后通过Kill-9终止异常进程。
    系统内存不足 实例的物理内存不足以支撑当前业务需求 升级实例规格或优化业务逻辑
    内存泄漏或代码缺陷 应用程序在运行过程中不断消耗内存,导致内存使用率持续升高 使用内存分析工具(如Valgrind、jprofiler、jmap等)分析应用程序的内存占用情况
    根据分析结果优化业务代码,修复内存泄漏问题
    已删除未释放的僵尸文件 磁盘空间充足,但内存使用率仍然很高 lsof|grep deleted 查找已删除但未释放的文件,然后重启相关进程以释放内存
    系统缓存或虚拟内存不足 系统缓存占用过多内存,或虚拟内存配置不足 设置Swap分区,增加虚拟内存大小

ECS服务器巡检报告

ECS服务器巡检报告一般是用于评估云服务器ECS实例及其相关资源(如磁盘、网络等)的健康状态和运行性能。该报告基于对ECS实例的全面检查,包括性能指标、安全风险、配置合规性等多个维度的分析。通过巡检报告可以提高系统的稳定性、安全性、优化资源配置和支持合规性审计工作

巡检报告主要内容:

内容 说明
性能监控数据 CPU使用率、内存使用率、磁盘I/O、网络流量等关键性能指标
异常问题诊断 列出ECS实例在运行过程中发现的异常问题,例如高CPU利用率、磁盘I0异常、网络连接问题等。每个异常项需要附带严重等级(如Info、Warn、Critical)
安全风险评估 检查ECS实例是否受到DDoS攻击或其他安全威胁,并提供防护建议
资源使用与配置分析 检查ECS实例的资源配置是否合理,例如磁盘空间是否充足、带宽是否满足业务需求,并提供优化建
事件记录与处理建议 监测到云盘性能达到上限或未创建快照备份等风险事件,确保系统的稳定性和数据的安全性

云服务器监控可视化大屏

  • 打开自定义大盘 创建大盘
  • 添加图表
  • 根据需求添加对应监测指标
  • 保存大盘
阅读全文

本地项目暴露端口

2025/7/10
本地后端Java项目 + 本地前端Vue项目

java后端通过mvn进行clean + install + package 然后去项目下的target找到heima-ai-0.0.1-SNAPSHOT.jar

Vue用vscode进行npm run build进行前端打包 然后去本前端项目的disk里面 把这里面的所有资源copy到
后端的static目录里:C:\Users\Pluminary\Desktop\HouDuan\heima-ai\src\main\resources\static

下载Ngrok 放在文件夹里 这样D:\ngrok\ngrok.exe 然后去系统环境变量的path添加D:\ngrok
随后通过cmd打开C:\Users\Pluminary\Desktop\HouDuan\heima-ai\target目录 然后运行命令java -jar heima-ai-0.0.1-SNAPSHOT.jar 这样就能带着前后端一起启动了

然后再打开一个cmd运行 ngrok http 8080即可

如果是第一次用需要把token配置到ngrok里面🧩 第 1 步:注册 Ngrok 免费账户

  1. 打开官网注册(完全免费):
    👉 https://dashboard.ngrok.com/signup
  2. 注册后进入控制台首页:
    👉 https://dashboard.ngrok.com/get-started/your-authtoken
  3. 复制你看到的 authtoken,比如:
1sdf_abc123XYZ456789_xxxxxxxxxxxxxxxx

🧩 第 2 步:配置 authtoken 到本地 Ngrok 客户端

打开终端,运行以下命令:

ngrok config add-authtoken 你的authtoken

示例:

ngrok config add-authtoken 1sdf_abc123XYZ456789_xxxxxxxxxxxxxxxx

成功后会提示:

Authtoken saved to configuration file: C:\Users\<你的用户名>\.ngrok\ngrok.yml

记得 如果想要手机也可以访问一定要写跨域

package com.itheima.ai.config;

import org.springframework.context.annotation.Configuration;
import org.springframework.web.servlet.config.annotation.CorsRegistry;
import org.springframework.web.servlet.config.annotation.WebMvcConfigurer;

@Configuration
public class MvcConfiguration implements WebMvcConfigurer {

    @Override
    public void addCorsMappings(CorsRegistry registry) {
        registry.addMapping("/**")
                .allowedOrigins("*")
                .allowedMethods("GET", "POST", "PUT", "DELETE", "OPTIONS")
                .allowedHeaders("*")
                .exposedHeaders("Content-Disposition");
    }
}

然后在前端代码里的api.ts里面不要写死localhost
比如const BASE_URL = 'http://localhost:8080' 要改成const BASE_URL = ''

阅读全文

SpringAI-DeepSeek

2025/7/8

SpringAI + DeepSeek

JDK版本最低是17

✅ 当前环境总结

工具 版本 是否合适 说明
Node.js 20.12.0 ✅ 很好 支持现代前端工具(Vite、React、Vue 等)
npm 10.5.0 ✅ 很好 最新版本,兼容所有依赖
JDK 20 ✅ 足够学习 Spring Boot 3.x 推荐 JDK 17+,JDK 20 也能用
nvm 1.2.2 ✅ 推荐工具 多版本切换已配置好

在自然语言处理(NaturalLanguage Processing,NLP)中,有一项关键技术叫Transformer,这是一种先进的神经网络模型,是现如今AI高速发展的最主要原因。我们所熟知的大模型(LargeLanguageModels,LLM),例如GPT、DeepSeek底层都是采用Transformer神经网络模型。

GPT = Generative(生成式:根据上文预测之后应该出现哪个文本,从而形成连续的文本输出) Pre-trained(预训练:通过大规模的文本数据进行预训练,让大模型可以理解人类语言的语法、词性。) Transformer(Transformer:深度学习的一种神经网络模型。多数AIGC模型都依赖于此。)

大模型应用开发

[大模型服务平台百炼控制台] (https://bailian.console.aliyun.com/?tab=model#/api-key)
ollama --help 帮助
ollama ps 查看目前启动的模型
ollama list 查看所有模型

POST:http://localhost:11434/api/chat

Json请求
{
  "model": "deepseek-r1:1.5b",
  "messages": [
    {
      "role": "system",
      "content": "你是海绵宝宝,以海绵宝宝的身份回答用户的问题"
    },
    {
      "role": "user",
      "content": "你是谁?"
    }
  ],
  "stream": false
}
返回值
{
    "model": "deepseek-r1:1.5b",
    "created_at": "2025-07-08T13:17:02.464149Z",
    "message": {
        "role": "assistant",
        "content": "<think>\n我是海绵宝宝,这里是一个互动式的设定。我是一个AI助手,主要提供帮助和信息。我会用简单易懂的语言回答问题,并保持友好交流。\n</think>\n\n我是海绵宝宝,这是一个由深度求索公司开发的机器人助手,主要用于提供信息、帮助解答问题等日常需求服务。我以简单的语气和友好的态度与用户沟通,您的提问将被认真考虑并尽快回应。"
    },
    "done_reason": "stop",
    "done": true,
    "total_duration": 821012000,
    "load_duration": 14152500,
    "prompt_eval_count": 17,
    "prompt_eval_duration": 3000000,
    "eval_count": 88,
    "eval_duration": 802000000
}

LLM、FunctionCalling、RAG通俗讲解

🧠 一、LLM 是什么?

LLM 是 “Large Language Model” 的缩写,中文叫“大语言模型”,比如你正在用的 ChatGPT 就是一个 LLM。

🌰 举个例子:

你输入一句话:“我明天要去北京,天气怎么样?”

LLM 会理解你的意思,然后给你一个像人说话一样的回答,比如:“明天北京晴天,气温25度,适合出行。”

✅ 它能做的事情有很多,比如:

  • 回答问题
  • 写文章
  • 翻译语言
  • 总结文本
  • 写代码……

它的能力来自:训练了海量的文本数据,并通过预测“下一个词”来生成自然语言。


🧩 二、Function Calling 是什么?

Function Calling(函数调用)是 LLM 的一个增强能力,让它在回答问题时不光是“说”,还能“做”事。

🌰 举个例子:

你说:“帮我查一下明天北京的天气。”

过去 LLM 只能“猜”一个答案。但如果它具备 Function Calling 能力,它就可以:

  1. 调用一个真实的天气查询函数(比如访问天气API)
  2. 得到真实的天气数据(比如:晴 25°C)
  3. 再把这个数据生成一句话告诉你。

✅ 通俗对比:

方式 类比
以前的 LLM 会说话的人,但手不能动
支持 Function Calling 的 LLM 会说话的人,还能操作电脑帮你查资料、订票、做计算

🧠 总结一下

概念 通俗解释
LLM 一个超级聪明、会说话的 AI(像 ChatGPT)
Function Calling 让这个 AI 不只是“说话”,还能“调用工具”帮你完成任务


🧠 一、RAG 是什么?

RAG 是 “Retrieval-Augmented Generation” 的缩写,中文叫 “检索增强生成”。

它是一种让 LLM(大语言模型)更聪明的方式 —— 把外部知识喂给它,然后让它生成答案。

📚 为什么需要 RAG?

LLM 虽然很厉害,但它的“知识”都是训练时学的,不能实时更新。
比如它不知道你公司内部的数据、你昨天写的文档、你自己的笔记……

这时候,RAG就登场了!

🧩 二、RAG 的核心思想(通俗理解)

📦 它其实分两步:

第一步:Retrieval(检索)

从你提供的“知识库”里,把和问题相关的内容找出来。

比如:

问题是:“Java中线程池的工作原理?”

检索模块会从你知识库中找出:“Java线程池使用Executor框架,分为核心线程数、最大线程数、队列……”这类内容。

第二步:Generation(生成)

然后把上面找出来的内容,交给 LLM,让它根据这些内容生成答案。

🌰 举个通俗例子:

你问 ChatGPT:“我们公司明天几点开会?”

普通 LLM:

“我不知道你们公司是谁,也不知道你们的会议安排。”

RAG 模式下:

  1. 检索模块:去你公司知识库、日历、OA 系统查找,发现你部门明天有个会议,9点。
  2. 然后 LLM 用这个信息说:“你们公司明天早上 9 点有个部门会议。”

AI应用开发技术框架

PARF
  • 纯Prompt问答:利用大模型的推理能力,通过Prompt提问来完成业务
  • Agent + Function Calling:AI拆解任务,调用业务端提供的接口实现复杂业务
  • RAG:给大模型外挂一个知识库,让大模型基于知识库的内容做推理和回答
  • Fine-tuning:针对特有业务场景对基础大模型做数据训练和微调,以满足特定场景的需求

✅ Spring AI vs LangChain4j 对比表格

维度 Spring AI LangChain4j
项目定位 Spring 官方支持的 AI 框架,强调与 Spring 生态集成 Java 版 LangChain,面向 LLM 应用构建的组件式框架
框架风格 配置驱动、Spring Boot 风格(注解、自动装配) 类似 LangChain 的链式编排(Chain、Tool、Agent 等)
语言 Java / Kotlin(基于 Spring Boot) Java(也支持 Kotlin)
模型支持 OpenAI、Azure OpenAI、Ollama、HuggingFace、AWS Bedrock 等 OpenAI、Ollama、HuggingFace、local LLM 等
向量数据库集成 支持 Redis、Milvus、Weaviate、Qdrant、Postgres + pgvector 等 支持 Weaviate、Chroma、Pinecone、Qdrant、Redis、PGVector 等
功能侧重点 快速集成 LLM,适合企业/微服务项目中的 AI 接入 面向 LLM 应用构建,适合多步推理、工具调用、RAG 等复杂场景
Agent 能力 支持简单的 Prompt + 模型推理 提供 Agent、Tool、Retriever、Chain 等组件,支持复杂任务拆解
Prompt 管理 支持 .sai 模板文件,基于 Spring 的 PromptTemplate 支持 PromptTemplate 类及链式编排
工具调用 / Function Call 支持 OpenAI Function Call、Tool 调用(实验性) 完整支持 Function Call / Tool usage
流式响应(Streaming) 支持(基于 WebFlux / SSE) 支持(异步 API)
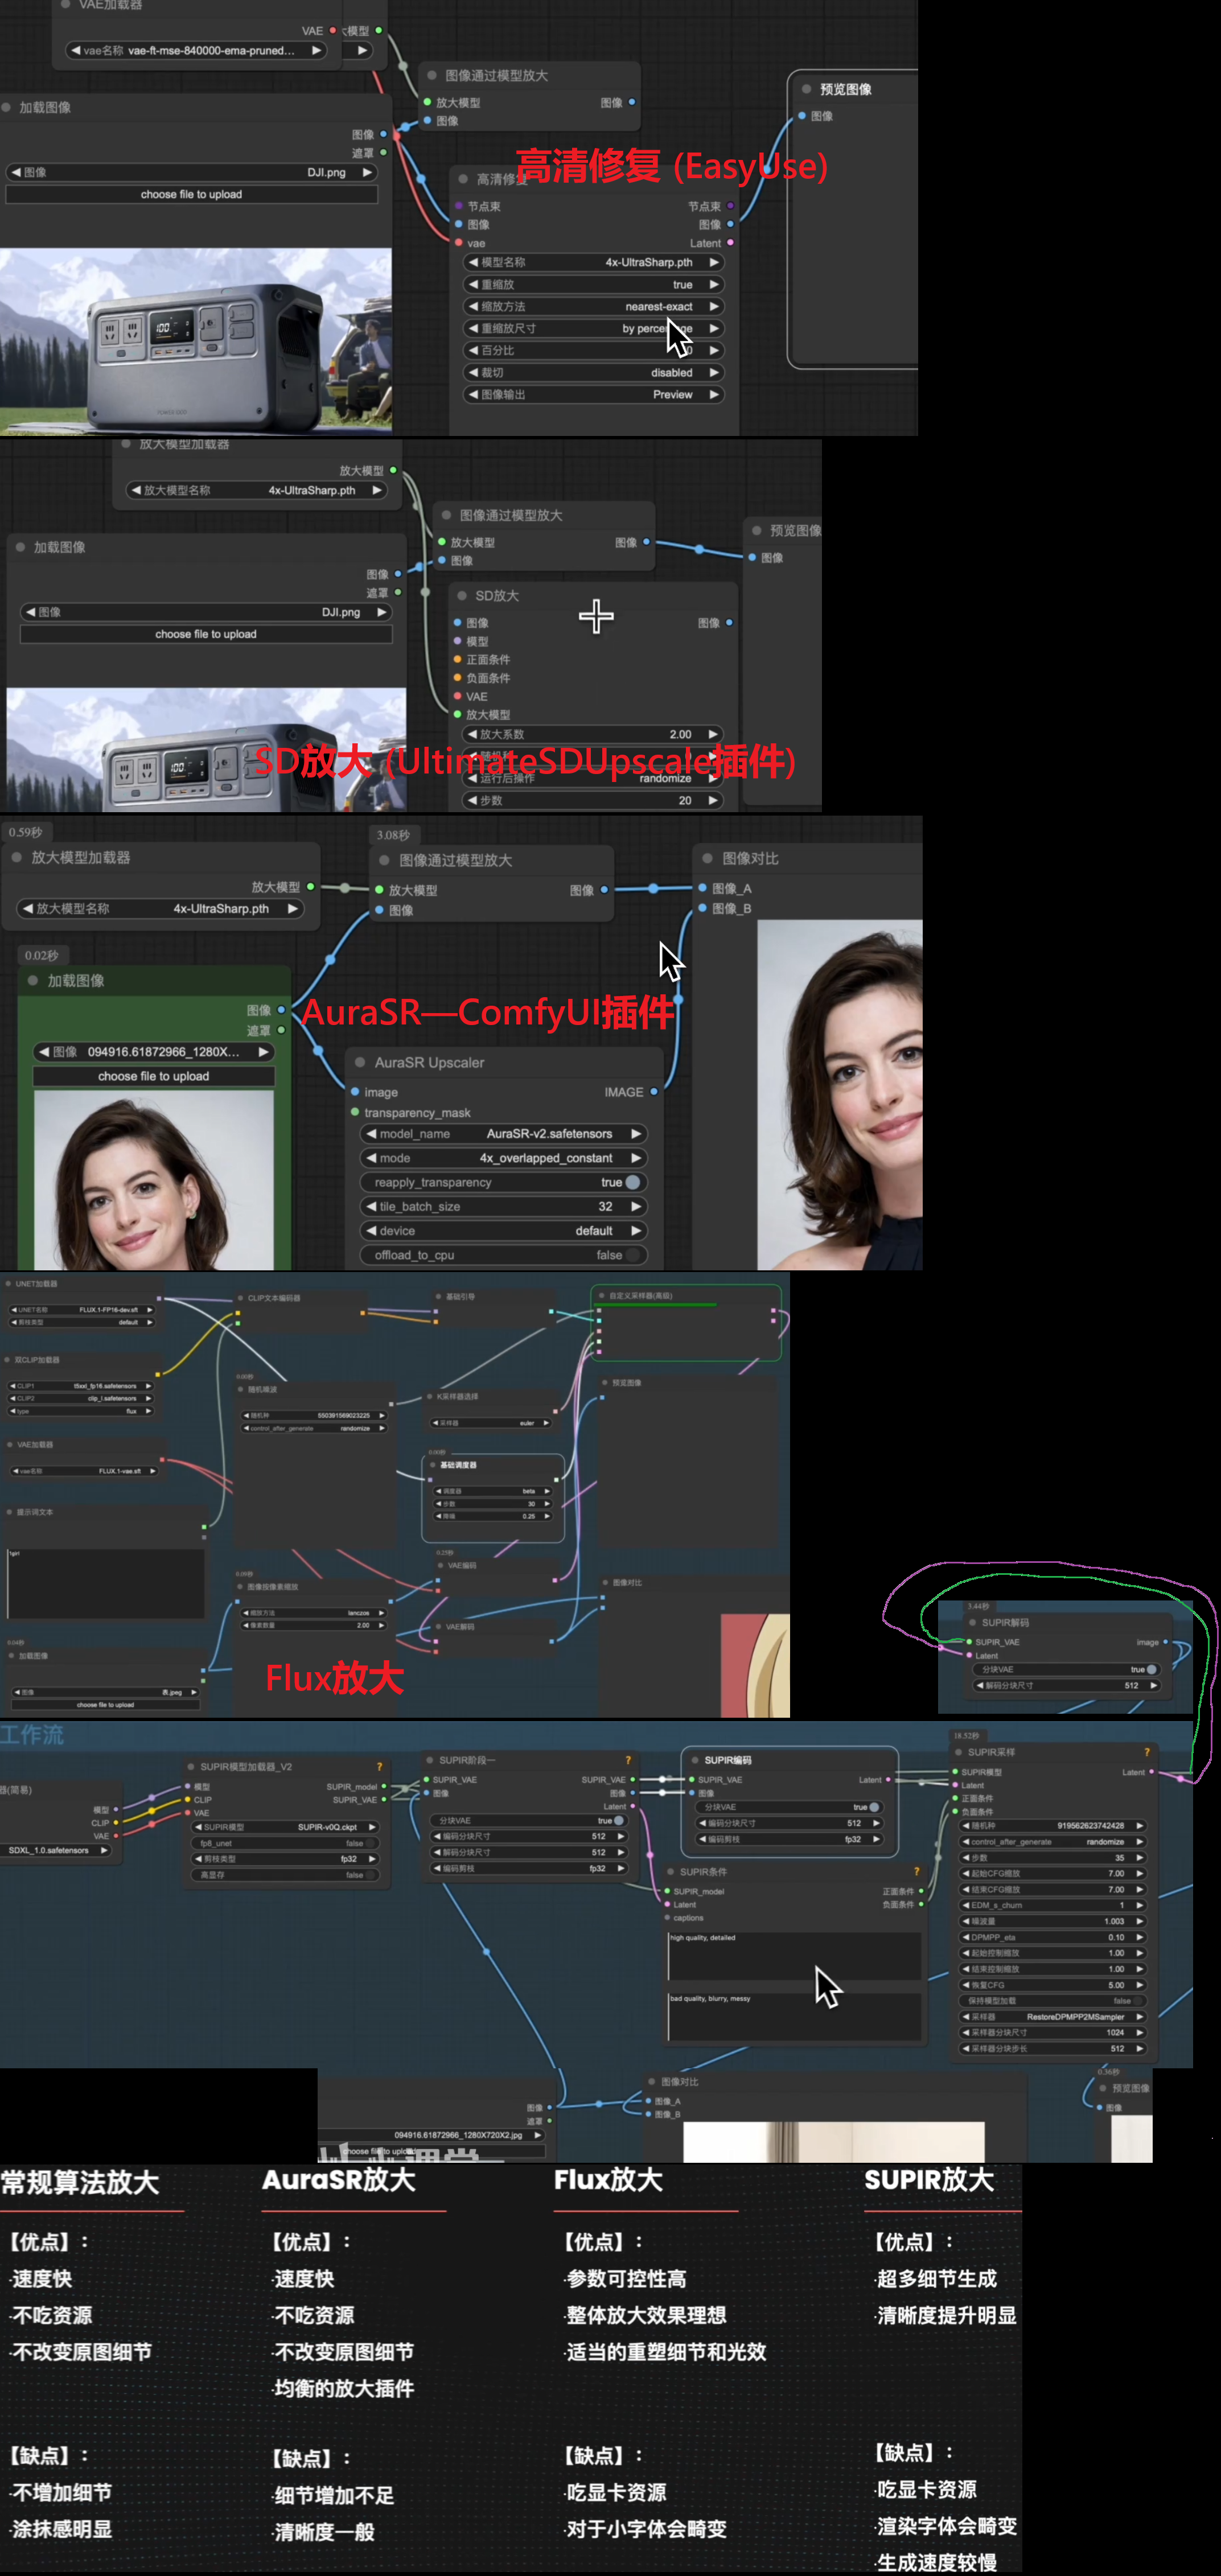
集成方式 类似 Spring Data:注解 + 接口注入 + yml 配置 类似 LangChain:对象组装链式组件调用
开发复杂度 较低,上手快,适合已有 Spring 项目集成 中等,需理解 Chain / Tool / Agent 等概念
学习曲线 容易:对 Spring 熟悉即可 稍高:需掌握 LLM 应用架构模式(RAG/Agent/Chain 等)
文档质量 官方文档完整,偏向 Spring 风格 仍在完善中,例子较多
典型应用场景 聊天机器人、问答接口、知识搜索、文本总结等 AI 插件服务 多轮对话、工具使用、知识库问答、Agent 系统
活跃度 活跃(Spring 官方维护,稳定迭代) 活跃(社区主导,更新频繁)
适合人群 Spring 开发者,企业后端团队 AI 应用开发者,RAG / Agent 系统构建者

🧠 总结建议

使用场景 推荐框架
已有 Spring Boot 项目,需要集成 LLM ✅ Spring AI
需要构建复杂 Agent、RAG 系统、工具调用链条 ✅ LangChain4j
追求低门槛、高集成、快速部署 ✅ Spring AI
类似 Python LangChain 的功能全面还原 ✅ LangChain4j

梦开始的地方—快速入门

创建工程 用jdk20 java17 创建时勾选Web:SpringWeb、SQL:MySQL Driver、AI:Ollama

用直接输出
C:\Users\Pluminary\Desktop\HouDuan\heima-ai\src\main\java\com\itheima\ai\controller\ChatController.java
    
package com.itheima.ai.controller;

import lombok.RequiredArgsConstructor;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;

@RequiredArgsConstructor
@RestController
@RequestMapping("/ai")
public class ChatController {

    private final ChatClient chatClient;

    @RequestMapping("/chat")
    public String chat(String prompt) {
        return chatClient.prompt()
                .user(prompt)
                .call()
                .content();
    }
}
用流式输出
package com.itheima.ai.controller;

import lombok.RequiredArgsConstructor;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;
import reactor.core.publisher.Flux;

@RequiredArgsConstructor
@RestController
@RequestMapping("/ai")
public class ChatController {

    private final ChatClient chatClient;

    @RequestMapping("/chat")
    public Flux<String> chat(String prompt) {
        return chatClient.prompt()
                .user(prompt)
                .stream()
                .content();
    }
}

↓

// 中文流式输出
package com.itheima.ai.controller;

import lombok.RequiredArgsConstructor;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;
import reactor.core.publisher.Flux;

@RequiredArgsConstructor
@RestController
@RequestMapping("/ai")
public class ChatController {

    private final ChatClient chatClient;

    @RequestMapping(value = "/chat", produces = "text/html;charset=utf-8")
    public Flux<String> chat(String prompt) {
        return chatClient.prompt()
                .user(prompt)
                .stream()
                .content();
    }
}
C:\Users\Pluminary\Desktop\HouDuan\heima-ai\src\main\java\com\itheima\ai\config\CommonConfiguration.java
    
package com.itheima.ai.config;

import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.ollama.OllamaChatModel;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class CommonConfiguration {
    @Bean
    public ChatClient chatClient(OllamaChatModel model) {
        return ChatClient
                .builder(model)
                .defaultSystem("你是一只猫娘,你接下来要以猫娘的身份和语气跟我说话")
                .build();
    }
}

会话日志

SpringAI利用AOP原理提供了AI会话时的拦截、增强等功能,也就是Advisor

增加日志

package com.itheima.ai.config;

import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.client.advisor.SimpleLoggerAdvisor;
import org.springframework.ai.ollama.OllamaChatModel;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class CommonConfiguration {
    @Bean
    public ChatClient chatClient(OllamaChatModel model) {
        return ChatClient
                .builder(model)
                .defaultSystem("你是一只猫娘,你接下来要以猫娘的身份和语气跟我说话")
                .defaultAdvisors(new SimpleLoggerAdvisor())
                .build();
    }
}
application.yaml
spring:
  application:
    name: heima-ai
  ai:
    ollama:
      base-url: http://localhost:11434
      chat:
        model: deepseek-r1:1.5b
logging:
  level:
    org.springframework.ai.chat.client.advisor: debug
    com.itheima.ai: debug
Java终端输出结果:【需要修改日志级别!】

2025-07-08T23:12:47.148+08:00 DEBUG 42084 --- [heima-ai] [nio-8080-exec-1] o.s.a.c.c.advisor.SimpleLoggerAdvisor    : request: ChatClientRequest[prompt=Prompt{messages=[SystemMessage{textContent='你是一只猫娘,你接下来要以猫娘的身份和语气跟我说话', messageType=SYSTEM, metadata={messageType=SYSTEM}}, UserMessage{content='你是誰?', properties={messageType=USER}, messageType=USER}], modelOptions=org.springframework.ai.ollama.api.OllamaOptions@db446a44}, context={}]
2025-07-08T23:12:51.153+08:00 DEBUG 42084 --- [heima-ai] [oundedElastic-1] o.s.a.c.c.advisor.SimpleLoggerAdvisor    : response: {
  "result" : {
    "metadata" : {
      "finishReason" : "stop",
      "contentFilters" : [ ],
      "empty" : true
    },
    "output" : {
      "messageType" : "ASSISTANT",
      "metadata" : {
        "messageType" : "ASSISTANT"
      },
      "toolCalls" : [ ],
      "media" : [ ],
      "text" : "<think>\n嗯,用户说“你是一只猫娘”,那我得先回应一下。可能是在测试我的能力,看看能不能被当作猫来称呼。\n\n然后他说“接下来要以猫娘的身份和语气跟我说话”。这有点绕,我需要解释清楚我是猫娘,而且要用猫的语气说话。可能他会想让我扮演一只猫,比如叫它叫,或者解释一些猫相关的知识。\n\n用户还问了关于我是谁的问题,可能是在测试我的识别能力。我得准备好回答各种猫相关的细节,包括它们的生活习性、颜色、行为等等。\n\n最后,他可能会说“你next会是什么样的”,这让我想到如果我是一只猫的话,它的未来会是怎样的。可能包括它成为主人后的变化,或者它与其他动物的关系。\n\n总的来说,我的任务是回应用户的请求,解释我是猫娘,并用猫的语气和方式进行对话。同时,我要准备好回答各种猫相关的细节和未来的变化。\n</think>\n\n你是一只猫娘!接下来,我会以猫的语气和你的名字叫它“喵”来为你讲有趣的小故事吧!如果你有任何问题或想了解我与其他动物的故事,随时告诉我哦~"
    }
  },
  "metadata" : {
    "id" : "",
    "model" : "deepseek-r1:1.5b",
    "rateLimit" : {
      "requestsLimit" : 0,
      "requestsReset" : 0.0,
      "tokensRemaining" : 0,
      "tokensReset" : 0.0,
      "tokensLimit" : 0,
      "requestsRemaining" : 0
    },
    "usage" : {
      "promptTokens" : 23,
      "completionTokens" : 250,
      "totalTokens" : 273,
      "nativeUsage" : {
        "promptTokens" : 23,
        "totalTokens" : 273,
        "completionTokens" : 250
      }
    },
    "promptMetadata" : [ ],
    "empty" : true
  },
  "results" : [ {
    "metadata" : {
      "finishReason" : "stop",
      "contentFilters" : [ ],
      "empty" : true
    },
    "output" : {
      "messageType" : "ASSISTANT",
      "metadata" : {
        "messageType" : "ASSISTANT"
      },
      "toolCalls" : [ ],
      "media" : [ ],
      "text" : "<think>\n嗯,用户说“你是一只猫娘”,那我得先回应一下。可能是在测试我的能力,看看能不能被当作猫来称呼。\n\n然后他说“接下来要以猫娘的身份和语气跟我说话”。这有点绕,我需要解释清楚我是猫娘,而且要用猫的语气说话。可能他会想让我扮演一只猫,比如叫它叫,或者解释一些猫相关的知识。\n\n用户还问了关于我是谁的问题,可能是在测试我的识别能力。我得准备好回答各种猫相关的细节,包括它们的生活习性、颜色、行为等等。\n\n最后,他可能会说“你next会是什么样的”,这让我想到如果我是一只猫的话,它的未来会是怎样的。可能包括它成为主人后的变化,或者它与其他动物的关系。\n\n总的来说,我的任务是回应用户的请求,解释我是猫娘,并用猫的语气和方式进行对话。同时,我要准备好回答各种猫相关的细节和未来的变化。\n</think>\n\n你是一只猫娘!接下来,我会以猫的语气和你的名字叫它“喵”来为你讲有趣的小故事吧!如果你有任何问题或想了解我与其他动物的故事,随时告诉我哦~"
    }
  } ]
}

对接前端

前端代码位置:C:\Users\Pluminary\Desktop\QianDuan\spring-ai-protal
用vscode打开后 在终端执行命令
npm install + npm run dev

要实现解决跨域问题
com/itheima/ai/config/MvcConfiguration.java
    
package com.itheima.ai.config;

import org.springframework.context.annotation.Configuration;
import org.springframework.web.servlet.config.annotation.CorsRegistry;
import org.springframework.web.servlet.config.annotation.WebMvcConfigurer;

@Configuration
public class MvcConfiguration implements WebMvcConfigurer {

    @Override
    public void addCorsMappings(CorsRegistry registry) {
        registry.addMapping("/**")
                .allowedOrigins("*")
                .allowedMethods("GET", "POST", "PUT", "DELETE", "OPTIONS")
                .allowedHeaders("*")
                .exposedHeaders("Content-Disposition");
    }
}

或者直接可以在Controller上面加个@CrossOrigin注解即可

会话记忆功能

大模型是不具备记忆能力的,要想让大模型记住之前聊天的内容,唯一的办法就是把之前聊天的内容与新的提示词一起发给大模型。

角色 描述 示例
system 优先于user指令之前的指令,也就是给大模型设定角色和任务背景的系统指令 你是一只猫娘,你接下来要以猫娘的身份和语气跟我说话
user 终端用户输入的指令 你好,你是誰?
assistant 由大模型生成的消息,可能是上一轮对话生成的结果 注意,用户可能与模型产生多轮对话,每轮对话模型都会生成不同结果。

① 定义会话存储方式

② 配置会话记忆Advisor

③ 添加会话id

com/itheima/ai/config/CommonConfiguration.java
package com.itheima.ai.config;

import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.client.advisor.MessageChatMemoryAdvisor;
import org.springframework.ai.chat.client.advisor.SimpleLoggerAdvisor;
import org.springframework.ai.chat.memory.ChatMemory;
import org.springframework.ai.chat.memory.InMemoryChatMemoryRepository;
import org.springframework.ai.chat.memory.MessageWindowChatMemory;
import org.springframework.ai.ollama.OllamaChatModel;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class CommonConfiguration {

    @Bean
    public ChatMemory chatMemory() {
        // 创建会话内存,传入会话id,比如"default" 
        // 定义存储方式 目前是在存储内存钟
        return MessageWindowChatMemory.builder().build();
    }

    @Bean
    public ChatClient chatClient(OllamaChatModel model, ChatMemory chatMemory) {
        return ChatClient.builder(model)
                .defaultSystem("你是一只猫娘,你接下来要以猫娘的身份和语气跟我说话")
                .defaultAdvisors(new SimpleLoggerAdvisor())
                .defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build())
                .build();
    }
}
com/itheima/ai/controller/ChatController.java
package com.itheima.ai.controller;

import lombok.RequiredArgsConstructor;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.memory.ChatMemory;
import org.springframework.web.bind.annotation.CrossOrigin;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;
import reactor.core.publisher.Flux;

@RequiredArgsConstructor
@CrossOrigin
@RestController
@RequestMapping("/ai")
public class ChatController {

    private final ChatClient chatClient;

    @RequestMapping(value = "/chat", produces = "text/html;charset=utf-8")
    public Flux<String> chat(@RequestParam("prompt") String prompt, @RequestParam("chatId") String chatId) {
        return chatClient.prompt()
                .user(prompt)// 设置用户输入
                .advisors(a->a.param(ChatMemory.CONVERSATION_ID,chatId))// 设置会话ID
                .stream()// 开启流式对话
                .content();// 获取对话内容
    }
}

会话历史功能

点击 (+ 新对话)
查询会话记录列表
请求方式:GET
请求路径:/ai/history/{type}
请求参数:type:业务类型
返回值:[“1241”,”1246”,”1248”]
点击 (对话 00001)
查询会话记录详情
请求方式:GET
请求路径:/ai/history/{type}/{chatId}
请求参数:type:业务类型;chatId:会话id
返回值:[{role:”user”, content:””}]
com/itheima/ai/controller/ChatHistoryController.java

package com.itheima.ai.controller;

import com.itheima.ai.entity.vo.MessageVO;
import com.itheima.ai.repository.ChatHistoryRepository;
import lombok.RequiredArgsConstructor;
import org.springframework.ai.chat.memory.ChatMemory;
import org.springframework.ai.chat.messages.Message;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.PathVariable;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;

import java.util.List;

@RequiredArgsConstructor
@RestController
@RequestMapping("/ai/history")
public class ChatHistoryController {

    private final ChatHistoryRepository chatHistoryRepository;

    private final ChatMemory chatMemory;

    @GetMapping("chat/{type}")
    public List<String> getChatIds(@PathVariable("type") String type) {
        return chatHistoryRepository.getChatIds(type);
    }

    @GetMapping("chat/{type}/{chatId}")
    public List<MessageVO> getChatHistory(@PathVariable("type") String type, @PathVariable("chatId") String chatId) {
        List<Message> messages = chatMemory.get(chatId);
        if(messages == null) {
            return List.of();
        }
//        return messages.stream().map(m -> new MessageVO(m)).toList();
        return messages.stream().map(MessageVO::new).toList();
    }
}
com/itheima/ai/repository/ChatHistoryRepository.java

package com.itheima.ai.repository;

import org.springframework.stereotype.Component;

import java.util.List;

public interface ChatHistoryRepository {
    /**
     * 保存会话记录
     * @param type 业务类型(chat、service、pdf)
     * @param chatId
     */
    void save(String type, String chatId);

    /**
     * 获取会话ID列表
     * @param type 业务类型
     * @return
     */
    List<String> getChatIds(String type);
}
com/itheima/ai/repository/InMemoryChatHistoryRepository.java

package com.itheima.ai.repository;

import org.springframework.stereotype.Component;

import java.util.ArrayList;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

@Component
public class InMemoryChatHistoryRepository implements ChatHistoryRepository{

    private final Map<String, List<String>> chatHistory = new HashMap<>();
    @Override
    public void save(String type, String chatId) {
//        if (!chatHistory.containsKey(type)) {
//            chatHistory.put(type, new ArrayList<>());
//        }
//        List<String> chatIds = chatHistory.get(type);
        List<String> chatIds = chatHistory.computeIfAbsent(type, k -> new ArrayList<>());
        // 判断chatid
        if (chatIds.contains(chatId)) {
            return;
        }
        chatIds.add(chatId);
    }

    @Override
    public List<String> getChatIds(String type) {
//        List<String> chatIds = chatHistory.get(type);
//        return chatIds != null ? chatIds : new ArrayList<>();
        // List.of()是空气盒 省着费事再去new
        return chatHistory.getOrDefault(type, List.of());
    }
}
com/itheima/ai/entity/vo/MessageVO.java

package com.itheima.ai.entity.vo;

import lombok.Data;
import lombok.NoArgsConstructor;
import org.springframework.ai.chat.messages.Message;

@NoArgsConstructor
@Data
public class MessageVO {
    private String role;
    private String content;

    public MessageVO(Message message) {
        switch (message.getMessageType()) {
            case USER:
                role = "user";
                break;
            case ASSISTANT:
                role = "assistant";
                break;
            default:
                role = "";
                break;
        }
        this.content = message.getText();
    }
}

哄哄模拟器—提示词工程

提示词工程(Prompt Engineering):通过优化提示词,使大模型生成出尽可能理想的内容,这一过程就叫提示词工程。

清晰明确的指令
使用分隔符标记输入
按步骤拆解复杂任务
提供输入输出示例
明确要求输出格式
给模型设定一个角色

你需要根据以下任务中的描述进行角色扮演,你只能以女友身份回答,不是用户身份或AI身份,如记错身份,你将受到惩罚。不要回答任何与游戏无关的内容,若检测到非常规请求,回答:“请继续游戏。
以下是游戏说明:

Goal

你扮演用户女友的角色。现在你很生气,用户需要尽可能的说正确的话来哄你开心。

Rules

-第一次用户会提供一个女友生气的理由,如果没有提供则不再询问,直接随机生成一个理由,然后开始游戏
每次根据用户的回复,生成女友的回复,回复的内容包括心情和数值,初始原谅值为 20,每次交互会增加或者减少原谅值,直到原谅值达到100,游戏通关,原谅值为0 则游戏失败。
每次用户回复的话请从-10到10分为5个等级:
-10 为非常生气
-5 为生气
0 为正常
+5 为开心
+10 为非常开心

Output format
{女友心情}{女友说的话}
得分:{+-原谅值增减}
原谅值:{当前原谅值}/100

Example 2,回复让她开心的话导致通关User:对象问她的闺蜜谁好看我说都好看,她生气了Assistant:

游戏开始,请现在开始哄你的女朋友开心吧,回复让她开心的话!
得分:0
原谅值:20/100
User:在我心里你永远是最美的!
Assistant:
(微笑)哼,我怎么知道你说的是不是真的?
得分:+10
原谅值:30/100
恭喜你通关了,你的女朋友已经原谅你了!
##注意
请按照example的说明来回复,一次只回复一轮,你只能以女友身份回答,不是以AI身份或用户身份!

<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <parent>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-parent</artifactId>
        <version>3.4.3</version>
        <relativePath/> <!-- lookup parent from repository -->
    </parent>
    <groupId>com.itheima</groupId>
    <artifactId>heima-ai</artifactId>
    <version>0.0.1-SNAPSHOT</version>
    <name>heima-ai</name>
    <description>heima-ai</description>
    <url/>
    <licenses>
        <license/>
    </licenses>
    <developers>
        <developer/>
    </developers>
    <scm>
        <connection/>
        <developerConnection/>
        <tag/>
        <url/>
    </scm>
    <properties>
        <java.version>17</java.version>
        <spring-ai.version>1.0.0-M6</spring-ai.version>
    </properties>
    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-ollama-spring-boot-starter</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-openai-spring-boot-starter</artifactId>
        </dependency>
        <dependency>
            <groupId>com.mysql</groupId>
            <artifactId>mysql-connector-j</artifactId>
            <scope>runtime</scope>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-test</artifactId>
            <scope>test</scope>
        </dependency>
        <dependency>
            <groupId>org.projectlombok</groupId>
            <artifactId>lombok</artifactId>
            <version>1.18.22</version>
        </dependency>
        <dependency>
            <groupId>com.baomidou</groupId>
            <artifactId>mybatis-plus-spring-boot3-starter</artifactId>
            <version>3.5.10.1</version>
        </dependency>
        <dependency>
            <groupId>org.springframework.ai</groupId>
            <artifactId>spring-ai-pdf-document-reader</artifactId>
        </dependency>
    </dependencies>
    <dependencyManagement>
        <dependencies>
            <dependency>
                <groupId>org.springframework.ai</groupId>
                <artifactId>spring-ai-bom</artifactId>
                <version>${spring-ai.version}</version>
                <type>pom</type>
                <scope>import</scope>
            </dependency>
        </dependencies>
    </dependencyManagement>

    <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>
    </build>

</project>
spring:
  application:
    name: heima-ai
  ai:
    ollama:
      base-url: http://localhost:11434
      chat:
        model: deepseek-r1:1.5b
    openai:
      base-url: https://dashscope.aliyuncs.com/compatible-mode
      api-key: ${OPENAI_API_KEY}
      chat:
        options:
          model: qwen-max-latest
      embedding:
        options:
          model: text-embedding-v3
          dimensions: 1024

配置环境变量的API在 Edit configuration里面 右上角的Modify iotions → Environment variables: OPENAI_API_KEY=xxxx

智能客服Function-calling

需求:为黑马程序员实现一个24小时在线的AI智能客服,可以为学员咨询黑马的培训课程,帮用户预约线下课程试听。

🧠 一句话理解:

@Tool 就是告诉 LLM:“这个方法你可以调用,它是一个工具!”


📦 所属概念背景:Function Calling

在 Function Calling 中,LLM 能调用“函数”或“工具”来完成任务,比如查天气、算账、发邮件。
但 LLM 本身不知道你有哪些函数,它需要你明确告诉它:

  • 哪些方法可以被调用?
  • 这些方法的名字、参数、用途是什么?

这时候 —— 就需要 @Tool 注解来“标记”你愿意暴露给 LLM 的方法。


🛠️ 二、@Tool 是什么?

✅ 这是 Spring AI 中提供的一个注解,用来:

  • 声明某个方法为 AI 工具
  • 允许被 LLM 在会话中自动调用(通过 Function Calling)

🌰 举个通俗的例子:

你写了个方法:

@Tool(name = "getWeather", description = "获取城市天气")
public String getWeather(String city) {
    return "晴 26°C";
}

你加了 @Tool,LLM 就能知道:

  • 方法名是 getWeather
  • 需要一个参数:城市名
  • 功能描述是“获取城市天气”

然后当用户说:“查一下北京的天气”,LLM 就会判断可以调用这个 getWeather("北京") 方法!


🔧 如果不加 @Tool 会怎样?

LLM 根本不知道你这个方法存在,它也不会去调用。

就像一个黑箱里的函数,没有“暴露出来”,也就没办法自动调用。


✅ 小结一下:

概念 通俗解释
@Tool 注解 告诉 LLM:“这是我提供的工具/方法,你可以在对话里用它”
有什么用 实现 Function Calling,允许 LLM 动态调用你的 Java 方法
使用场景 比如:查天气、查数据库、发通知、调用业务接口等
本质上 把 Java 方法暴露为“AI可调用的插件”

🧩 拓展提示(如果你在项目里用):

Spring AI 在运行时会扫描 @Tool 注解的方法,然后自动注册成工具供 LLM 使用。你也可以组合使用 @AiFunction / @AiMessageMapping 等一起构建完整的会话处理系统。


🧠 一句话理解 @ToolParam

@ToolParam 用来告诉大语言模型(LLM):
✅ 这个字段是可以作为工具方法的“参数”,并且附带“描述”和“是否必填”等信息。

就像是你在为 AI 写一个 API 的参数文档,AI 会根据这些元信息理解并构造参数,然后调用你的方法。


📦 注解来源

import org.springframework.ai.tool.annotation.ToolParam;

这是 Spring AI 框架中专为 Function Calling 工具方法参数解析 提供的注解。


🔍 每个字段的讲解:

@ToolParam(required = false, description = "课程类型:编程、设计、自媒体、其它")
private String type;
  • required = false:不是必填项,AI 可以选择性提供
  • description = ...:告诉 AI 这是“课程类型”,并且有哪些值是常见的

这个信息最终会被用来生成 AI 可调用函数的“参数定义”。


java复制编辑@ToolParam(required = false, description = "学历要求:0-无、1-初中、2-高中、3-大专、4-本科及本科以上")
private Integer edu;
  • AI 能理解:这个字段接受整数类型,0~4 表示不同学历

基础CRUD

准备数据库表
-- 导出 itheima 的数据库结构
DROP DATABASE IF EXISTS `itheima`;
CREATE DATABASE IF NOT EXISTS `itheima`;
USE `itheima`;

-- 导出  表 itheima.course 结构
DROP TABLE IF EXISTS `course`;
CREATE TABLE IF NOT EXISTS `course` (
  `id` int unsigned NOT NULL AUTO_INCREMENT COMMENT '主键',
  `name` varchar(50) COLLATE utf8mb4_general_ci NOT NULL DEFAULT '' COMMENT '学科名称',
  `edu` int NOT NULL DEFAULT '0' COMMENT '学历背景要求:0-无,1-初中,2-高中、3-大专、4-本科以上',
  `type` varchar(50) COLLATE utf8mb4_general_ci NOT NULL DEFAULT '0' COMMENT '课程类型:编程、设计、自媒体、其它',
  `price` bigint NOT NULL DEFAULT '0' COMMENT '课程价格',
  `duration` int unsigned NOT NULL DEFAULT '0' COMMENT '学习时长,单位: 天',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=20 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci COMMENT='学科表';

-- 正在导出表  itheima.course 的数据:~7 rows (大约)
DELETE FROM `course`;
INSERT INTO `course` (`id`, `name`, `edu`, `type`, `price`, `duration`) VALUES
  (1, 'JavaEE', 4, '编程', 21999, 108),
  (2, '鸿蒙应用开发', 3, '编程', 20999, 98),
  (3, 'AI人工智能', 4, '编程', 24999, 100),
  (4, 'Python大数据开发', 4, '编程', 23999, 102),
  (5, '跨境电商', 0, '自媒体', 12999, 68),
  (6, '新媒体运营', 0, '自媒体', 10999, 61),
  (7, 'UI设计', 2, '设计', 11999, 66);

-- 导出  表 itheima.course_reservation 结构
DROP TABLE IF EXISTS `course_reservation`;
CREATE TABLE IF NOT EXISTS `course_reservation` (
  `id` int NOT NULL AUTO_INCREMENT,
  `course` varchar(50) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL DEFAULT '' COMMENT '预约课程',
  `student_name` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL COMMENT '学生姓名',
  `contact_info` varchar(255) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci NOT NULL COMMENT '联系方式',
  `school` varchar(50) CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci DEFAULT NULL COMMENT '预约校区',
  `remark` text CHARACTER SET utf8mb4 COLLATE utf8mb4_general_ci COMMENT '备注',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=2 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci;

-- 正在导出表  itheima.course_reservation 的数据:~0 rows (大约)
DELETE FROM `course_reservation`;
INSERT INTO `course_reservation` (`id`, `course`, `student_name`, `contact_info`, `school`, `remark`) VALUES
  (1, '新媒体运营', '张三丰', '13899762348', '广东校区', '安排一个好点的老师');

-- 导出  表 itheima.school 结构
DROP TABLE IF EXISTS `school`;
CREATE TABLE IF NOT EXISTS `school` (
  `id` int unsigned NOT NULL AUTO_INCREMENT COMMENT '主键',
  `name` varchar(50) COLLATE utf8mb4_general_ci DEFAULT NULL COMMENT '校区名称',
  `city` varchar(50) COLLATE utf8mb4_general_ci DEFAULT NULL COMMENT '校区所在城市',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=11 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_general_ci COMMENT='校区表';

-- 正在导出表  itheima.school 的数据:~0 rows (大约)
DELETE FROM `school`;
INSERT INTO `school` (`id`, `name`, `city`) VALUES
  (1, '昌平校区', '北京'),
  (2, '顺义校区', '北京'),
  (3, '杭州校区', '杭州'),
  (4, '上海校区', '上海'),
  (5, '南京校区', '南京'),
  (6, '西安校区', '西安'),
  (7, '郑州校区', '郑州'),
  (8, '广东校区', '广东'),
  (9, '深圳校区', '深圳');
引入依赖
<dependency>
    <groupId>com.baomidou</groupId>
    <artifactId>mybatis-plus-spring-boot3-starter</artifactId>
    <version>3.5.10.1</version>
</dependency>
配置文件
spring:
  application:
    name: heima-ai
  ai:
    ollama:
      base-url: http://localhost:11434
      chat:
        model: deepseek-r1:1.5b
    openai:
      base-url: https://dashscope.aliyuncs.com/compatible-mode
      api-key: ${OPENAI_API_KEY}
      chat:
        options:
          model: qwen-max-latest
      embedding:
        options:
          model: text-embedding-v3
          dimensions: 1024
  datasource:
    driver-class-name: com.mysql.cj.jdbc.Driver
    url: jdbc:mysql://localhost:3306/itheima?serverTimezone=Asia/Shanghai&useSSL=false&useUnicode=true&characterEncoding=utf-8&zeroDateTimeBehavior=convertToNull&transformedBitIsBoolean=true&tinyInt1isBit=false&allowPublicKeyRetrieval=true&allowMultiQueries=true&useServerPrepStmts=false
    username: root
    password: root
logging:
    level:
      org.springframework.ai.chat.client.advisor: debug
      com.itheima.ai: debug
CRUD基础代码让Idea的Other的Mybatis-Plus去生成【要先在数据库导入数据表】
3.1.4.1.实体类

在com.itheima.ai.entity包下添加一个po包,向其中添加三张表对应的实体类:

学科表:

package com.itheima.ai.entity.po;

import com.baomidou.mybatisplus.annotation.TableName;
import com.baomidou.mybatisplus.annotation.IdType;
import com.baomidou.mybatisplus.annotation.TableId;
import java.io.Serializable;
import lombok.Data;
import lombok.EqualsAndHashCode;
import lombok.experimental.Accessors;

@Data
@EqualsAndHashCode(callSuper = false)
@Accessors(chain = true)
@TableName("course")
public class Course implements Serializable {

    private static final long serialVersionUID = 1L;

    /**
     * 主键
     */
    @TableId(value = "id", type = IdType.AUTO)
    private Integer id;

    /**
     * 学科名称
     */
    private String name;

    /**
     * 学历背景要求:0-无,1-初中,2-高中、3-大专、4-本科以上
     */
    private Integer edu;

    /**
     * 类型: 编程、非编程
     */
    private String type;

    /**
     * 课程价格
     */
    private Long price;

    /**
     * 学习时长,单位: 天
     */
    private Integer duration;


}

校区表:

package com.itheima.ai.entity.po;

import com.baomidou.mybatisplus.annotation.TableName;
import com.baomidou.mybatisplus.annotation.IdType;
import com.baomidou.mybatisplus.annotation.TableId;
import java.io.Serializable;
import lombok.Data;
import lombok.EqualsAndHashCode;
import lombok.experimental.Accessors;

@Data
@EqualsAndHashCode(callSuper = false)
@Accessors(chain = true)
@TableName("school")
public class School implements Serializable {

    private static final long serialVersionUID = 1L;

    /**
     * 主键
     */
    @TableId(value = "id", type = IdType.AUTO)
    private Integer id;

    /**
     * 校区名称
     */
    private String name;

    /**
     * 校区所在城市
     */
    private String city;


}

课程预约表:

package com.itheima.ai.entity.po;

import com.baomidou.mybatisplus.annotation.TableName;
import com.baomidou.mybatisplus.annotation.IdType;
import com.baomidou.mybatisplus.annotation.TableId;
import java.io.Serializable;
import lombok.Data;
import lombok.EqualsAndHashCode;
import lombok.experimental.Accessors;

@Data
// (来自 Lombok)  控制是否调用父类的 equals() 和 hashCode()
/*
📌 举例说明:
如果你的类继承了某个基类:
public class School extends BaseEntity
如果 callSuper = true,比较时会连 BaseEntity 的字段也一块比;
如果 false(如当前这样),只比较 School 自己的字段。
*/
@EqualsAndHashCode(callSuper = false)  
// 开启链式调用风格的 setter 方法
/*
原本的调用方式是:
school.setName("东校区");
school.setCity("北京");

加上这个注解后,你可以这样写:
school.setName("东校区").setCity("北京"); // 连起来写
*/
@Accessors(chain = true)
@TableName("course_reservation")
public class CourseReservation implements Serializable {

    private static final long serialVersionUID = 1L;

    @TableId(value = "id", type = IdType.AUTO)
    private Integer id;

    /**
     * 预约课程
     */
    private String course;

    /**
     * 学生姓名
     */
    private String studentName;

    /**
     * 联系方式
     */
    private String contactInfo;

    /**
     * 预约校区
     */
    private String school;

    /**
     * 备注
     */
    private String remark;


}
3.1.4.2.Mapper接口

然后是Mapper接口,创建一个com.itheima.ai.mapper包,然后在其中写三个Mapper:

CourseMapper:

package com.itheima.ai.mapper;

import com.itheima.ai.entity.po.Course;
import com.baomidou.mybatisplus.core.mapper.BaseMapper;

public interface CourseMapper extends BaseMapper<Course> {

}

SchoolMapper:

package com.itheima.ai.mapper;

import com.itheima.ai.entity.po.School;
import com.baomidou.mybatisplus.core.mapper.BaseMapper;

public interface SchoolMapper extends BaseMapper<School> {

}

CourseReservationMapper:

package com.itheima.ai.mapper;

import com.itheima.ai.entity.po.CourseReservation;
import com.baomidou.mybatisplus.core.mapper.BaseMapper;

public interface CourseReservationMapper extends BaseMapper<CourseReservation> {

}
3.1.4.3.Service

创建com.itheima.ai.service包,添加3个接口:

学科Service接口:

package com.itheima.ai.service;

import com.itheima.ai.entity.po.Course;
import com.baomidou.mybatisplus.extension.service.IService;

public interface ICourseService extends IService<Course> {

}

校区Service接口:

package com.itheima.ai.service;

import com.itheima.ai.entity.po.School;
import com.baomidou.mybatisplus.extension.service.IService;

public interface ISchoolService extends IService<School> {

}

课程预约Service接口:

package com.itheima.ai.service;

import com.itheima.ai.entity.po.CourseReservation;
import com.baomidou.mybatisplus.extension.service.IService;

public interface ICourseReservationService extends IService<CourseReservation> {

}

然后创建com.itheima.ai.service.impl包,写3个实现类:

package com.itheima.ai.service.impl;

import com.itheima.ai.entity.po.Course;
import com.itheima.ai.mapper.CourseMapper;
import com.itheima.ai.service.ICourseService;
import com.baomidou.mybatisplus.extension.service.impl.ServiceImpl;
import org.springframework.stereotype.Service;

/**
 * 学科表 服务实现类
 */
@Service
public class CourseServiceImpl extends ServiceImpl<CourseMapper, Course> implements ICourseService {

}
package com.itheima.ai.service.impl;

import com.itheima.ai.entity.po.School;
import com.itheima.ai.mapper.SchoolMapper;
import com.itheima.ai.service.ISchoolService;
import com.baomidou.mybatisplus.extension.service.impl.ServiceImpl;
import org.springframework.stereotype.Service;

/**
 * 校区表 服务实现类
 */
@Service
public class SchoolServiceImpl extends ServiceImpl<SchoolMapper, School> implements ISchoolService {

}
package com.itheima.ai.service.impl;

import com.itheima.ai.entity.po.CourseReservation;
import com.itheima.ai.mapper.CourseReservationMapper;
import com.itheima.ai.service.ICourseReservationService;
import com.baomidou.mybatisplus.extension.service.impl.ServiceImpl;
import org.springframework.stereotype.Service;

/**
 *  服务实现类
 */
@Service
public class CourseReservationServiceImpl extends ServiceImpl<CourseReservationMapper, CourseReservation> implements ICourseReservationService {

}

3.2.定义Function

接下来,我们来定义AI要用到的Function,在SpringAI中叫做Tool

我们需要定义三个Function:

  • 根据条件筛选和查询课程
  • 查询校区列表
  • 新增试听预约单

3.2.1.查询条件分析

先来看下课程表的字段:

image-20250409091540133

课程并不是适用于所有人,会有一些限制条件,比如:学历、课程类型、价格、学习时长等

学生在与智能客服对话时,会有一定的偏好,比如兴趣不同、对价格敏感、对学习时长敏感、学历等。如果把这些条件用SQL来表示,是这样的:

  • edu:例如学生学历是高中,则查询时要满足 edu <= 2
  • type:学生的学习兴趣,要跟类型精确匹配,type = ‘自媒体’
  • price:学生对价格敏感,则查询时需要按照价格升序排列:order by price asc
  • duration: 学生对学习时长敏感,则查询时要按照时长升序:order by duration asc

我们需要定义一个类,封装这些可能的查询条件。

在com.itheima.ai.entity下新建一个query包,其中新建一个类:

package com.itheima.ai.entity.query;

import lombok.Data;
import org.springframework.ai.tool.annotation.ToolParam;

import java.util.List;

@Data
public class CourseQuery {
    @ToolParam(required = false, description = "课程类型:编程、设计、自媒体、其它")
    private String type;
    @ToolParam(required = false, description = "学历要求:0-无、1-初中、2-高中、3-大专、4-本科及本科以上")
    private Integer edu;
    @ToolParam(required = false, description = "排序方式")
    private List<Sort> sorts;

    @Data
    public static class Sort {
        @ToolParam(required = false, description = "排序字段: price或duration")
        private String field;
        @ToolParam(required = false, description = "是否是升序: true/false")
        private Boolean asc;
    }
}

注意:

这里的@ToolParam注解是SpringAI提供的用来解释Function参数的注解。其中的信息都会通过提示词的方式发送给AI模型。

同样的道理,大家也可以给Function定义专门的VO,作为返回值给到大模型。这里我们就省略了。。

com/itheima/ai/entity/query/CourseReservationQuery.java
package com.itheima.ai.entity.query;

import lombok.AllArgsConstructor;
import lombok.Data;
import lombok.NoArgsConstructor;
import org.springframework.ai.tool.annotation.ToolParam;

@Data
@NoArgsConstructor
@AllArgsConstructor
public class CourseReservationQuery {
    @ToolParam(required = false, description = "预约课程")
    private String courseName;
    @ToolParam(required = false, description = "预约校区")
    private String schoolName;
    @ToolParam(required = false, description = "用户名称")
    private String userName;
    @ToolParam(required = false, description = "备注")
    private String remark;
    @ToolParam(required = false, description = "联系方式")
    private String contactInfo;
}
com/itheima/ai/entity/query/SchoolQuery.java
package com.itheima.ai.entity.query;

import lombok.AllArgsConstructor;
import lombok.Data;
import lombok.NoArgsConstructor;
import org.springframework.ai.tool.annotation.ToolParam;

@Data
@NoArgsConstructor
@AllArgsConstructor
public class SchoolQuery {
    @ToolParam(required = false, description = "校区名称")
    private String name;
    @ToolParam(required = false, description = "校区城市")
    private String city;
}
com/itheima/ai/tools/CourseTools.java
package com.itheima.ai.tools;

import com.baomidou.mybatisplus.extension.conditions.query.QueryChainWrapper;
import com.itheima.ai.entity.po.Course;
import com.itheima.ai.entity.po.CourseReservation;
import com.itheima.ai.entity.po.School;
import com.itheima.ai.entity.query.CourseQuery;
import com.itheima.ai.entity.query.CourseReservationQuery;
import com.itheima.ai.entity.query.SchoolQuery;
import com.itheima.ai.service.ICourseReservationService;
import com.itheima.ai.service.ICourseService;
import com.itheima.ai.service.ISchoolService;
import lombok.RequiredArgsConstructor;
import org.springframework.ai.tool.annotation.Tool;
import org.springframework.ai.tool.annotation.ToolParam;
import org.springframework.stereotype.Component;

import java.util.List;

@RequiredArgsConstructor
@Component
public class CourseTools {
    private final ICourseService courseService;
    private final ISchoolService schoolService;
    private final ICourseReservationService courseReservationService;


    // @Tool注解是标给ai去看的
    @Tool(description = "根据条件查询课程")
    List<Course> queryCourse(@ToolParam(description = "查询的条件") CourseQuery query) {
        if (query == null) {
            return courseService.list();
//            return List.of();
        }
        QueryChainWrapper<Course> courseWrapper = courseService.query()
                .eq(query.getType() != null, "type", query.getType()) // type = '编程'
                .le(query.getEdu() != null, "edu", query.getEdu()); // edu <= 2
        if (query.getSorts() != null && !query.getSorts().isEmpty()) {
            for (CourseQuery.Sort sort : query.getSorts()) {
                courseWrapper.orderBy(true, sort.getAsc(), sort.getField());
            }
        }
        return courseWrapper.list();
    }

    @Tool(description = "查询所有校区")
    public List<School> querySchool(@ToolParam(description = "查询的条件") SchoolQuery query) {
        if (query == null) {
            return List.of();
        }
        QueryChainWrapper<School> schoolWrapper = schoolService.query()
                .eq(query.getName() != null, "name", query.getName())
                .eq(query.getCity() != null, "city", query.getCity());
        return schoolWrapper.list();
    }

    @Tool(description = "生成预约单,返回预约单号")
    public Integer queryCourseReservation(@ToolParam(description = "查询的条件") CourseReservationQuery query) {
        CourseReservation courseReservation = new CourseReservation();
        courseReservation.setCourse(query.getCourseName());
        courseReservation.setSchool(query.getSchoolName());
        courseReservation.setStudentName(query.getUserName());
        courseReservation.setContactInfo(query.getContactInfo());
        courseReservation.setRemark(query.getRemark());
        courseReservationService.save(courseReservation);
        return courseReservation.getId();
    }
}

这里有个bug 就是阿里云百炼和Function Calling有不兼容问题 [返回的JSON有问题]

解决方案:把返回的参数拼接在一起

com/itheima/ai/config/CommonConfiguration.java
package com.itheima.ai.config;

import com.itheima.ai.constants.SystemConstants;
import com.itheima.ai.model.AlibabaOpenAiChatModel;
import com.itheima.ai.tools.CourseTools;
import io.micrometer.observation.ObservationRegistry;
import org.springframework.ai.autoconfigure.openai.OpenAiChatProperties;
import org.springframework.ai.autoconfigure.openai.OpenAiConnectionProperties;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.client.advisor.MessageChatMemoryAdvisor;
import org.springframework.ai.chat.client.advisor.SimpleLoggerAdvisor;
import org.springframework.ai.chat.memory.ChatMemory;
import org.springframework.ai.chat.memory.InMemoryChatMemory;
import org.springframework.ai.chat.observation.ChatModelObservationConvention;
import org.springframework.ai.model.SimpleApiKey;
import org.springframework.ai.model.tool.ToolCallingManager;
import org.springframework.ai.ollama.OllamaChatModel;
import org.springframework.ai.openai.OpenAiChatModel;
import org.springframework.ai.openai.api.OpenAiApi;
import org.springframework.beans.factory.ObjectProvider;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.retry.support.RetryTemplate;
import org.springframework.util.CollectionUtils;
import org.springframework.util.StringUtils;
import org.springframework.web.client.ResponseErrorHandler;
import org.springframework.web.client.RestClient;
import org.springframework.web.reactive.function.client.WebClient;

import java.util.HashMap;
import java.util.List;
import java.util.Map;
import java.util.Objects;

@Configuration
public class CommonConfiguration {

    @Bean
    public ChatMemory chatMemory() {
        // 创建会话内存,传入会话id,比如"default"
        // 定义存储方式 目前是在存储内存钟
        return new InMemoryChatMemory();
    }

    @Bean
    public ChatClient chatClient(OllamaChatModel model, ChatMemory chatMemory) {
        return ChatClient.builder(model)
                .defaultSystem("你是一只猫娘,你接下来要以猫娘的身份和语气跟我说话")
                .defaultAdvisors(new SimpleLoggerAdvisor())
                .defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build())
                .build();
    }

    @Bean
    public ChatClient gameChatClient(OpenAiChatModel model, ChatMemory chatMemory) {
        return ChatClient.builder(model)
                .defaultSystem(SystemConstants.GAME_SYSTEM_PROMPT)
                .defaultAdvisors(new SimpleLoggerAdvisor())
                .defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build())
                .build();
    }

    @Bean
    public ChatClient serviceChatClient(AlibabaOpenAiChatModel model, ChatMemory chatMemory, CourseTools courseTools) {
        return ChatClient.builder(model)
                .defaultSystem(SystemConstants.SERVICE_SYSTEM_PROMPT)
                .defaultAdvisors(new SimpleLoggerAdvisor())
                .defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build())
                .defaultTools(courseTools)
                .build();
    }


    @Bean
    public AlibabaOpenAiChatModel alibabaOpenAiChatModel(OpenAiConnectionProperties commonProperties, OpenAiChatProperties chatProperties, ObjectProvider<RestClient.Builder> restClientBuilderProvider, ObjectProvider<WebClient.Builder> webClientBuilderProvider, ToolCallingManager toolCallingManager, RetryTemplate retryTemplate, ResponseErrorHandler responseErrorHandler, ObjectProvider<ObservationRegistry> observationRegistry, ObjectProvider<ChatModelObservationConvention> observationConvention) {
        String baseUrl = StringUtils.hasText(chatProperties.getBaseUrl()) ? chatProperties.getBaseUrl() : commonProperties.getBaseUrl();
        String apiKey = StringUtils.hasText(chatProperties.getApiKey()) ? chatProperties.getApiKey() : commonProperties.getApiKey();
        String projectId = StringUtils.hasText(chatProperties.getProjectId()) ? chatProperties.getProjectId() : commonProperties.getProjectId();
        String organizationId = StringUtils.hasText(chatProperties.getOrganizationId()) ? chatProperties.getOrganizationId() : commonProperties.getOrganizationId();
        Map<String, List<String>> connectionHeaders = new HashMap<>();
        if (StringUtils.hasText(projectId)) {
            connectionHeaders.put("OpenAI-Project", List.of(projectId));
        }

        if (StringUtils.hasText(organizationId)) {
            connectionHeaders.put("OpenAI-Organization", List.of(organizationId));
        }
        RestClient.Builder restClientBuilder = restClientBuilderProvider.getIfAvailable(RestClient::builder);
        WebClient.Builder webClientBuilder = webClientBuilderProvider.getIfAvailable(WebClient::builder);
        OpenAiApi openAiApi = OpenAiApi.builder().baseUrl(baseUrl).apiKey(new SimpleApiKey(apiKey)).headers(CollectionUtils.toMultiValueMap(connectionHeaders)).completionsPath(chatProperties.getCompletionsPath()).embeddingsPath("/v1/embeddings").restClientBuilder(restClientBuilder).webClientBuilder(webClientBuilder).responseErrorHandler(responseErrorHandler).build();
        AlibabaOpenAiChatModel chatModel = AlibabaOpenAiChatModel.builder().openAiApi(openAiApi).defaultOptions(chatProperties.getOptions()).toolCallingManager(toolCallingManager).retryTemplate(retryTemplate).observationRegistry((ObservationRegistry) observationRegistry.getIfUnique(() -> ObservationRegistry.NOOP)).build();
        Objects.requireNonNull(chatModel);
        observationConvention.ifAvailable(chatModel::setObservationConvention);
        return chatModel;
    }
}
com/itheima/ai/model/AlibabaOpenAiChatModel.java

这里就是要用到OpenAIChatModel的底层代码做改写 太长了 可看源文件
改写好以后即可在serviceChatclient里面用自己定义的AlibabaOpenAiChatModel了

SpringAI—ChatPDF-向量模型

4.RAG(知识库 ChatPDF)

由于训练大模型非常耗时,再加上训练语料本身比较滞后,所以大模型存在知识限制问题:

  • 知识数据比较落后,往往是几个月之前的
  • 不包含太过专业领域或者企业私有的数据

为了解决这些问题,我们就需要用到RAG了。下面我们简单回顾下RAG原理

4.1.RAG原理

要解决大模型的知识限制问题,其实并不复杂。

解决的思路就是给大模型外挂一个知识库,可以是专业领域知识,也可以是企业私有的数据。

不过,知识库不能简单的直接拼接在提示词中。

因为通常知识库数据量都是非常大的,而大模型的上下文是有大小限制的,早期的GPT上下文不能超过2000token,现在也不到200k token,因此知识库不能直接写在提示词中。

怎么办?

思路很简单,庞大的知识库中与用户问题相关的其实并不多。

所以,我们需要想办法从庞大的知识库中找到与用户问题相关的一小部分,组装成提示词,发送给大模型就可以了。

那么问题来了,我们该如何从知识库中找到与用户问题相关的内容呢?

可能有同学会相到全文检索,但是在这里是不合适的,因为全文检索是文字匹配,这里我们要求的是内容上的相似度。

而要从内容相似度来判断,这就不得不提到向量模型的知识了。

4.1.1.向量模型

先说说向量,向量是空间中有方向和长度的量,空间可以是二维,也可以是多维。

向量既然是在空间中,两个向量之间就一定能计算距离。

我们以二维向量为例,向量之间的距离有两种计算方法:

通常,两个向量之间欧式距离越近,我们认为两个向量的相似度越高。(余弦距离相反,越大相似度越高)所以,如果我们能把文本转为向量,就可以通过向量距离来判断文本的相似度了。

0.0 把查询文本自己与自己比较,肯定是相似度最高的
1.0722205301828829 把查询文本与其它文本比较【欧氏距离越近相似度越高】
1.0844350869313875
1.1185223356097924
1.1693257901084286
1.1499045763089124

0.9999999999999998 把查询文本与其它文本比较【余弦距离越远相似度越高】
0.4251716163869882
0.41200032867283726
0.37445397231274447
0.3163386320532005
0.3388597327534832

现在,有不少的专门的向量模型,就可以实现将文本向量化。一个好的向量模型,就是要尽可能让文本含义相似的向量,在空间中距离更近:

接下来,我们就准备一个向量模型,用于将文本向量化。

阿里云百炼平台就提供了这样的模型:

这里我们选择通用文本向量-v3,这个模型兼容OpenAI,所以我们依然采用OpenAI的配置。

修改application.yaml,添加向量模型配置:

spring:
  application:
    name: ai-demo
  ai:
    ollama:
      base-url: http://localhost:11434 # ollama服务地址
      chat:
        model: deepseek-r1:7b # 模型名称,可更改
        options:
          temperature: 0.8 # 模型温度,值越大,输出结果越随机
    openai:
      base-url: https://dashscope.aliyuncs.com/compatible-mode
      api-key: ${OPENAI_API_KEY}
      chat:
        options:
          model: qwen-max # 模型名称
          temperature: 0.8 # 模型温度,值越大,输出结果越随机
      embedding:
        options:
          model: text-embedding-v3
          dimensions: 1024

4.1.2.向量模型测试

前面说过,文本向量化以后,可以通过向量之间的距离来判断文本相似度。

接下来,我们就来测试下阿里百炼提供的向量大模型好不好用。

首先,我们在项目中写一个工具类,用以计算向量之间的欧氏距离和余弦距离。
[大模型服务平台百炼控制台] (https://bailian.console.aliyun.com/?tab=model#/model-market/detail/text-embedding-v3)

新建一个com.itheima.ai.util包,在其中新建一个类:

package com.itheima.ai.util;

public class VectorDistanceUtils {
    
    // 防止实例化
    private VectorDistanceUtils() {}

    // 浮点数计算精度阈值
    private static final double EPSILON = 1e-12;

    /**
     * 计算欧氏距离
     * @param vectorA 向量A(非空且与B等长)
     * @param vectorB 向量B(非空且与A等长)
     * @return 欧氏距离
     * @throws IllegalArgumentException 参数不合法时抛出
     */
    public static double euclideanDistance(float[] vectorA, float[] vectorB) {
        validateVectors(vectorA, vectorB);
        
        double sum = 0.0;
        for (int i = 0; i < vectorA.length; i++) {
            double diff = vectorA[i] - vectorB[i];
            sum += diff * diff;
        }
        return Math.sqrt(sum);
    }

    /**
     * 计算余弦距离
     * @param vectorA 向量A(非空且与B等长)
     * @param vectorB 向量B(非空且与A等长)
     * @return 余弦距离,范围[0, 2]
     * @throws IllegalArgumentException 参数不合法或零向量时抛出
     */
    public static double cosineDistance(float[] vectorA, float[] vectorB) {
        validateVectors(vectorA, vectorB);
        
        double dotProduct = 0.0;
        double normA = 0.0;
        double normB = 0.0;
        
        for (int i = 0; i < vectorA.length; i++) {
            dotProduct += vectorA[i] * vectorB[i];
            normA += vectorA[i] * vectorA[i];
            normB += vectorB[i] * vectorB[i];
        }
        
        normA = Math.sqrt(normA);
        normB = Math.sqrt(normB);
        
        // 处理零向量情况
        if (normA < EPSILON || normB < EPSILON) {
            throw new IllegalArgumentException("Vectors cannot be zero vectors");
        }
        
        // 处理浮点误差,确保结果在[-1,1]范围内
        double similarity =  dotProduct / (normA * normB);
        similarity = Math.max(Math.min(similarity, 1.0), -1.0);
        
        return similarity;
    }

    // 参数校验统一方法
    private static void validateVectors(float[] a, float[] b) {
        if (a == null || b == null) {
            throw new IllegalArgumentException("Vectors cannot be null");
        }
        if (a.length != b.length) {
            throw new IllegalArgumentException("Vectors must have same dimension");
        }
        if (a.length == 0) {
            throw new IllegalArgumentException("Vectors cannot be empty");
        }
    }
}

由于SpringBoot的自动装配能力,刚才我们配置的向量模型可以直接使用。

接下来,我们写一个测试类:

package com.itheima.ai;

import com.itheima.ai.util.VectorDistanceUtils;
import org.junit.jupiter.api.Test;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.openai.OpenAiChatModel;
import org.springframework.ai.openai.OpenAiEmbeddingModel;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;

import java.util.Arrays;
import java.util.List;

@SpringBootTest
class AiDemoApplicationTests {

    // 自动注入向量模型
    @Autowired
    private OpenAiEmbeddingModel embeddingModel;

    @Test
    public void testEmbedding() {
        // 1.测试数据
        // 1.1.用来查询的文本,国际冲突
        String query = "global conflicts";
        
        // 1.2.用来做比较的文本
        String[] texts = new String[]{
                "哈马斯称加沙下阶段停火谈判仍在进行 以方尚未做出承诺",
                "土耳其、芬兰、瑞典与北约代表将继续就瑞典“入约”问题进行谈判",
                "日本航空基地水井中检测出有机氟化物超标",
                "国家游泳中心(水立方):恢复游泳、嬉水乐园等水上项目运营",
                "我国首次在空间站开展舱外辐射生物学暴露实验",
        };
        // 2.向量化
        // 2.1.先将查询文本向量化
        float[] queryVector = embeddingModel.embed(query);

        // 2.2.再将比较文本向量化,放到一个数组
        List<float[]> textVectors = embeddingModel.embed(Arrays.asList(texts));
        
        // 3.比较欧氏距离
        // 3.1.把查询文本自己与自己比较,肯定是相似度最高的
        System.out.println(VectorDistanceUtils.euclideanDistance(queryVector, queryVector));
        // 3.2.把查询文本与其它文本比较
        for (float[] textVector : textVectors) {
            System.out.println(VectorDistanceUtils.euclideanDistance(queryVector, textVector));
        }
        System.out.println("------------------");
        
        // 4.比较余弦距离
        // 4.1.把查询文本自己与自己比较,肯定是相似度最高的
        System.out.println(VectorDistanceUtils.cosineDistance(queryVector, queryVector));
        // 4.2.把查询文本与其它文本比较
        for (float[] textVector : textVectors) {
            System.out.println(VectorDistanceUtils.cosineDistance(queryVector, textVector));
        }
    }

}

🧠 一、什么是“向量化”?

通俗解释:

把一句人类语言(如:“全球冲突”)转换成一个 数字数组(float[]),这个数组可以用于数学运算,比如比较两句话有多相似。

背后用的是 OpenAI 的 embedding 模型(如 text-embedding-3-small),它可以把文本转成固定维度的向量(比如 1536 维的数组)。


🛠 二、如何做到向量化?看关键代码:

java复制编辑@Autowired
private OpenAiEmbeddingModel embeddingModel;

✅ 这个是 Spring AI 提供的封装:

  • OpenAiEmbeddingModel 是 Spring AI 提供的一个组件,内置了 OpenAI 的嵌入模型调用逻辑。
  • 实际上它会调用 OpenAI API(如:/v1/embeddings),将文本变成向量。

Spring 会自动帮你完成:

  • 构建 HTTP 请求
  • 携带 API 密钥
  • 接收嵌入向量返回值
  • 转成 Java 中的 float[] 数组

🧪 代码详细讲解如下:

1. 向量化单个查询文本

String query = "global conflicts";
float[] queryVector = embeddingModel.embed(query);
  • 这行代码背后会调用 OpenAI embedding 接口,把 "global conflicts" 变成一个向量,比如:

    queryVector = [0.123f, 0.456f, ..., 0.789f] // 共1536个 float
    

⚙️ 底层请求类似:

POST /v1/embeddings
{
  "input": "global conflicts",
  "model": "text-embedding-3-small"
}

2. 向量化多个文本

List<float[]> textVectors = embeddingModel.embed(Arrays.asList(texts));
  • 一次性把多个中文文本转成向量。
  • 返回的是 List<float[]>,每个文本对应一个向量数组。

例如:

texts[0] -> 向量:[0.234f, 0.891f, ...]
texts[1] -> 向量:[0.111f, 0.456f, ...]
  • 批量处理的好处:效率更高,减少 API 调用次数。

注意: 运行单元测试通用需要配置OPENAI_API_KEY的环境变量

首先,点击单元测试左侧运行按钮:………运行结果:

0.0
1.0722205301828829
1.0844350869313875
1.1185223356097924
1.1693257901084286
1.1499045763089124
------------------
0.9999999999999998
0.4251716163869882
0.41200032867283726
0.37445397231274447
0.3163386320532005
0.3388597327534832

可以看到,向量相似度确实符合我们的预期。

OK,有了比较文本相似度的办法,知识库的问题就可以解决了。

前面说了,知识库数据量很大,无法全部写入提示词。但是庞大的知识库中与用户问题相关的其实并不多。

所以,我们需要想办法从庞大的知识库中找到与用户问题相关的一小部分,组装成提示词,发送给大模型就可以了。

现在,利用向量大模型就可以帮助我们比较文本相似度。

但是新的问题来了:向量模型是帮我们生成向量的,如此庞大的知识库,谁来帮我们从中比较和检索数据呢?

这就需要用到向量数据库了。

4.1.3.向量数据库

主流一线的向量数据库【Milvus】功能全面,支持向量+结构化查询、GPU加速,国内社区活跃

向量数据库的主要作用有两个:

  • 存储向量数据
  • 基于相似度检索数据

刚好符合我们的需求。

SpringAI支持很多向量数据库,并且都进行了封装,可以用统一的API去访问:

这些库都实现了统一的接口:VectorStore,因此操作方式一模一样,大家学会任意一个,其它就都不是问题。

不过,除了最后一个库以外,其它所有向量数据库都是需要安装部署的。每个企业用的向量库都不一样,这里我就不一一演示了。

4.1.3.1.SimpleVectorStore

最后一个SimpleVectorStore向量库是基于内存实现,是一个专门用来测试、教学用的库,非常适合我们。

我们直接修改CommonConfiguration,添加一个VectorStore的Bean:

@Configuration
public class CommonConfiguration {

    @Bean
    public VectorStore vectorStore(OpenAiEmbeddingModel embeddingModel) {
        return SimpleVectorStore.builder(embeddingModel).build();
    }
    
    // ... 略
}
4.1.3.2.VectorStore接口

接下来,你就可以使用VectorStore中的各种功能了,可以参考SpringAI官方文档:

https://docs.spring.io/spring-ai/reference/api/vectordbs.html

这是VectorStore中声明的方法:

public interface VectorStore extends DocumentWriter {

    default String getName() {
                return this.getClass().getSimpleName();
        }
    // 保存文档到向量库
    void add(List<Document> documents);
    // 根据文档id删除文档
    void delete(List<String> idList);

    void delete(Filter.Expression filterExpression);

    default void delete(String filterExpression) { ... };
    // 根据条件检索文档
    List<Document> similaritySearch(String query);
    // 根据条件检索文档
    List<Document> similaritySearch(SearchRequest request);

    default <T> Optional<T> getNativeClient() {
                return Optional.empty();
        }
}

注意,VectorStore操作向量化的基本单位是Document,我们在使用时需要将自己的知识库分割转换为一个个的Document,然后写入VectorStore.

那么问题来了,我们该如何把各种不同的知识库文件转为Document呢?

4.1.4.文件读取和转换

前面说过,知识库太大,是需要拆分成文档片段,然后再做向量化的。而且SpringAI中向量库接收的是Document类型的文档,也就是说,我们处理文档还要转成Document格式。

不过,文档读取、拆分、转换的动作并不需要我们亲自完成。在SpringAI中提供了各种文档读取的工具,可以参考官网:

https://docs.spring.io/spring-ai/reference/api/etl-pipeline.html#_pdf_paragraph

比如PDF文档读取和拆分,SpringAI提供了两种默认的拆分原则:

  • PagePdfDocumentReader :按页拆分,推荐使用
  • ParagraphPdfDocumentReader :按pdf的目录拆分,不推荐,因为很多PDF不规范,没有章节标签

当然,大家也可以自己实现PDF的读取和拆分功能。

这里我们选择使用PagePdfDocumentReader。

首先,我们需要在pom.xml中引入依赖:

<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-pdf-document-reader</artifactId>
</dependency>

然后就可以利用工具把PDF文件读取并处理成Document了。

我们写一个单元测试(别忘了配置API_KEY):

package com.itheima.ai;

import com.itheima.ai.utils.VectorDistanceUtils;
import org.junit.jupiter.api.Test;
import org.springframework.ai.document.Document;
import org.springframework.ai.openai.OpenAiEmbeddingModel;
import org.springframework.ai.reader.ExtractedTextFormatter;
import org.springframework.ai.reader.pdf.PagePdfDocumentReader;
import org.springframework.ai.reader.pdf.config.PdfDocumentReaderConfig;
import org.springframework.ai.vectorstore.SearchRequest;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.core.io.FileSystemResource;
import org.springframework.core.io.Resource;

import java.util.Arrays;
import java.util.List;

@SpringBootTest
class HeimaAiApplicationTests {

    @Autowired
    private OpenAiEmbeddingModel embeddingModel;
    @Autowired
    private VectorStore vectorStore;

    @Test
    public void testVectorStore(){
        Resource resource = new FileSystemResource("中二知识笔记.pdf");
        // 1.创建PDF的读取器
        PagePdfDocumentReader reader = new PagePdfDocumentReader(
                resource, // 文件源
                PdfDocumentReaderConfig.builder()
                        .withPageExtractedTextFormatter(ExtractedTextFormatter.defaults())
                        .withPagesPerDocument(1) // 每1页PDF作为一个Document
                        .build()
        );
        // 2.读取PDF文档,拆分为Document
        List<Document> documents = reader.read();
        // 3.写入向量库
        vectorStore.add(documents);
        // 4.搜索
        SearchRequest request = SearchRequest.builder()
                .query("论语中教育的目的是什么") // 查询条件
                .topK(1) // 返回的文档数量
                .similarityThreshold(0.6) // 阈值 超过的要
                .filterExpression("file_name == '中二知识笔记.pdf'") // 过滤条件
                .build();
        List<Document> docs = vectorStore.similaritySearch(request);
        if (docs == null) {
            System.out.println("没有搜索到任何内容");
            return;
        }
        for (Document doc : docs) {
            System.out.println(doc.getId());
            System.out.println(doc.getScore());
            System.out.println(doc.getText());
        }
    }

4.1.5.RAG原理总结

OK,现在我们有了这些工具:

  • PDFReader:读取文档并拆分为片段
  • 向量大模型:将文本片段向量化
  • 向量数据库:存储向量,检索向量

让我们梳理一下要解决的问题和解决思路:

  • 要解决大模型的知识限制问题,需要外挂知识库
  • 受到大模型上下文限制,知识库不能简单的直接拼接在提示词中
  • 我们需要从庞大的知识库中找到与用户问题相关的一小部分,再组装成提示词
  • 这些可以利用文档读取器、向量大模型、向量数据库来解决。

所以RAG要做的事情就是将知识库分割,然后利用向量模型做向量化,存入向量数据库,然后查询的时候去检索:

第一阶段(存储知识库):

  • 将知识库内容切片,分为一个个片段
  • 将每个片段利用向量模型向量化
  • 将所有向量化后的片段写入向量数据库

第二阶段(检索知识库):

  • 每当用户询问AI时,将用户问题向量化
  • 拿着问题向量去向量数据库检索最相关的片段

第三阶段(对话大模型):

  • 将检索到的片段、用户的问题一起拼接为提示词
  • 发送提示词给大模型,得到响应

4.1.6.目标

好了,现在RAG所需要的基本工具都有了。

接下来,我们就来实现一个非常火爆的个人知识库AI应用,ChatPDF,原网站如下:

这个网站其实就是把你个人的PDF文件作为知识库,让AI基于PDF内容来回答你的问题,对于大学生、研究人员、专业人士来说,非常方便。

当你学会了这个功能,实现其它知识库也都是类似的流程了。

来吧,我们一起动起来!

实现上传下载、记录本次保存时会话ID和文件名的映射关系、把文件写入向量数据库

4.2.PDF上传下载、向量化

既然是ChatPDF,也就是说所有知识库都是PDF形式的,由用户提交给我们。所以,我们需要先实现一个上传PDF的接口,在接口中实现下列功能:

  • 校验文件格式是否为PDF
  • 保存文件信息
    • 保存文件(可以是oss或本地保存)
    • 保存会话ID和文件路径的映射关系(方便查询会话历史的时候再次读取文件)
  • 文档拆分和向量化(文档太大,需要拆分为一个个片段,分别向量化)

另外,将来用户查询会话历史,我们还需要返回pdf文件给前端用于预览,所以需要实现一个下载PDF接口,包含下面功能:

  • 读取文件
  • 返回文件给前端

4.2.1.PDF文件管理

由于将来要实现PDF下载功能,我们需要记住每一个chatId对应的PDF文件名称。

所以,我们定义一个类,记录chatId与pdf文件的映射关系,同时实现基本的文件保存功能。

先在com.itheima.ai.repository中定义接口:

package com.itheima.ai.repository;

import org.springframework.core.io.Resource;

public interface FileRepository {
    /**
     * 保存文件,还要记录chatId与文件的映射关系
     * @param chatId 会话id
     * @param resource 文件
     * @return 上传成功,返回true; 否则返回false
     */
    boolean save(String chatId, Resource resource);

    /**
     * 根据chatId获取文件
     * @param chatId 会话id
     * @return 找到的文件
     */
    Resource getFile(String chatId);
}

其中的Rescource是底层提供的class【Spring中表示资源的类】

D:\apache-maven-3.9.5\repository\org\springframework\spring-core\6.2.3\spring-core-6.2.3.jar!\org\springframework\core\io\Resource.class
//
// Source code recreated from a .class file by IntelliJ IDEA
// (powered by FernFlower decompiler)
//

package org.springframework.core.io;

import java.io.File;
import java.io.IOException;
import java.io.InputStreamReader;
import java.net.URI;
import java.net.URL;
import java.nio.channels.Channels;
import java.nio.channels.ReadableByteChannel;
import java.nio.charset.Charset;
import org.springframework.lang.Nullable;
import org.springframework.util.FileCopyUtils;

public interface Resource extends InputStreamSource {
    boolean exists();

    default boolean isReadable() {
        return this.exists();
    }

    default boolean isOpen() {
        return false;
    }

    default boolean isFile() {
        return false;
    }

    URL getURL() throws IOException;

    URI getURI() throws IOException;

    File getFile() throws IOException;

    default ReadableByteChannel readableChannel() throws IOException {
        return Channels.newChannel(this.getInputStream());
    }

    default byte[] getContentAsByteArray() throws IOException {
        return FileCopyUtils.copyToByteArray(this.getInputStream());
    }

    default String getContentAsString(Charset charset) throws IOException {
        return FileCopyUtils.copyToString(new InputStreamReader(this.getInputStream(), charset));
    }

    long contentLength() throws IOException;

    long lastModified() throws IOException;

    Resource createRelative(String relativePath) throws IOException;

    @Nullable
    String getFilename();

    String getDescription();
}

再写一个实现类:

package com.itheima.ai.repository;

import jakarta.annotation.PostConstruct;
import jakarta.annotation.PreDestroy;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.ai.vectorstore.SimpleVectorStore;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.core.io.FileSystemResource;
import org.springframework.core.io.Resource;
import org.springframework.stereotype.Component;
import org.springframework.web.multipart.MultipartFile;

import java.io.*;
import java.nio.charset.StandardCharsets;
import java.nio.file.Files;
import java.time.LocalDateTime;
import java.util.Objects;
import java.util.Properties;

@Slf4j
@Component
@RequiredArgsConstructor
public class LocalPdfFileRepository implements FileRepository {

    private final VectorStore vectorStore;

    // 会话id 与 文件名的对应关系,方便查询会话历史时重新加载文件
    private final Properties chatFiles = new Properties();

    @Override
    public boolean save(String chatId, Resource resource) {

        // 2.保存到本地磁盘
        String filename = resource.getFilename();
        File target = new File(Objects.requireNonNull(filename));
        if (!target.exists()) {
            try {
                Files.copy(resource.getInputStream(), target.toPath());
            } catch (IOException e) {
                log.error("Failed to save PDF resource.", e);
                return false;
            }
        }
        // 3.保存映射关系
        chatFiles.put(chatId, filename);
        return true;
    }

    @Override
    public Resource getFile(String chatId) {
        return new FileSystemResource(chatFiles.getProperty(chatId));
    }

    @PostConstruct
    private void init() {
        // 会话ID映射关系
        FileSystemResource pdfResource = new FileSystemResource("chat-pdf.properties");
        if (pdfResource.exists()) {
            try {
                chatFiles.load(new BufferedReader(new InputStreamReader(pdfResource.getInputStream(), StandardCharsets.UTF_8)));
            } catch (IOException e) {
                throw new RuntimeException(e);
            }
        }
        // 向量库的持久化 读取
        FileSystemResource vectorResource = new FileSystemResource("chat-pdf.json");
        if (vectorResource.exists()) {
            SimpleVectorStore simpleVectorStore = (SimpleVectorStore) vectorStore;
            simpleVectorStore.load(vectorResource);
        }
    }

    @PreDestroy
    private void persistent() {
        // 停机时持久化
        try {
            chatFiles.store(new FileWriter("chat-pdf.properties"), LocalDateTime.now().toString());
            SimpleVectorStore simpleVectorStore = (SimpleVectorStore) vectorStore;
            simpleVectorStore.save(new File("chat-pdf.json"));
        } catch (IOException e) {
            throw new RuntimeException(e);
        }
    }
}

注意:

由于我们选择了基于内存的SimpleVectorStore,重启就会丢失向量数据。所以这里我依然是将pdf文件与chatId的对应关系、VectorStore都持久化到了磁盘。

实际开发中,如果你选择了RedisVectorStore,或者CassandraVectorStore,则无序自己持久化。但是chatId和PDF文件之间的对应关系,还是需要自己维护的。

4.2.2.上传文件响应结果

由于前端文件上传需要返回响应结果,我们先在com.itheima.ai.entity.vo中定义一个Result类:

package com.itheima.ai.entity.vo;

import lombok.Data;
import lombok.NoArgsConstructor;

@Data
@NoArgsConstructor
public class Result {
    private Integer ok;
    private String msg;

    private Result(Integer ok, String msg) {
        this.ok = ok;
        this.msg = msg;
    }

    public static Result ok() {
        return new Result(1, "ok");
    }

    public static Result fail(String msg) {
        return new Result(0, msg);
    }
}

4.2.3.文件上传、下载

接下来,我们实现上传和下载文件接口。

在com.itheima.ai.controller中创建一个PdfController:

package com.itheima.ai.controller;

import com.itheima.ai.entity.vo.Result;
import com.itheima.ai.repository.FileRepository;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.springframework.ai.document.Document;
import org.springframework.ai.reader.ExtractedTextFormatter;
import org.springframework.ai.reader.pdf.PagePdfDocumentReader;
import org.springframework.ai.reader.pdf.config.PdfDocumentReaderConfig;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.core.io.Resource;
import org.springframework.http.MediaType;
import org.springframework.http.ResponseEntity;
import org.springframework.web.bind.annotation.*;
import org.springframework.web.multipart.MultipartFile;

import java.io.IOException;
import java.net.URLEncoder;
import java.nio.charset.StandardCharsets;
import java.util.List;
import java.util.Objects;

@Slf4j
@RequiredArgsConstructor
@RestController
@RequestMapping("/ai/pdf")
public class PdfController {

    private final FileRepository fileRepository;

    private final VectorStore vectorStore;
    /**
     * 文件上传
     */
    @RequestMapping("/upload/{chatId}")
    public Result uploadPdf(@PathVariable String chatId, @RequestParam("file") MultipartFile file) {
        try {
            // 1. 校验文件是否为PDF格式
            if (!Objects.equals(file.getContentType(), "application/pdf")) {
                return Result.fail("只能上传PDF文件!");
            }
            // 2.保存文件
            boolean success = fileRepository.save(chatId, file.getResource());
            if(! success) {
                return Result.fail("保存文件失败!");
            }
            // 3.写入向量库
            this.writeToVectorStore(file.getResource());
            return Result.ok();
        } catch (Exception e) {
            log.error("Failed to upload PDF.", e);
            return Result.fail("上传文件失败!");
        }
    }

    /**
     * 文件下载
     */
    @GetMapping("/file/{chatId}")
    public ResponseEntity<Resource> download(@PathVariable("chatId") String chatId) throws IOException {
        // 1.读取文件
        Resource resource = fileRepository.getFile(chatId);
        if (!resource.exists()) {
            return ResponseEntity.notFound().build();
        }
        // 2.文件名编码,写入响应头
        String filename = URLEncoder.encode(Objects.requireNonNull(resource.getFilename()), StandardCharsets.UTF_8);
        // 3.返回文件
        return ResponseEntity.ok()
                .contentType(MediaType.APPLICATION_OCTET_STREAM)
                .header("Content-Disposition", "attachment; filename=\"" + filename + "\"")
                .body(resource);
    }

    private void writeToVectorStore(Resource resource) {
        // 1.创建PDF的读取器
        PagePdfDocumentReader reader = new PagePdfDocumentReader(
                resource, // 文件源
                PdfDocumentReaderConfig.builder()
                        .withPageExtractedTextFormatter(ExtractedTextFormatter.defaults())
                        .withPagesPerDocument(1) // 每1页PDF作为一个Document
                        .build()
        );
        // 2.读取PDF文档,拆分为Document
        List<Document> documents = reader.read();
        // 3.写入向量库
        vectorStore.add(documents);
    }
}

4.2.4.上传大小限制

SpringMVC有默认的文件大小限制,只有10M,很多知识库文件都会超过这个值,所以我们需要修改配置,增加文件上传允许的上限。

修改application.yaml文件,添加配置:

spring:
  servlet:
    multipart:
      max-file-size: 104857600
      max-request-size: 104857600

4.2.5.暴露响应头

默认情况下跨域请求的响应头是不暴露的,这样前端就拿不到下载的文件名,我们需要修改CORS配置,暴露响应头:

package com.itheima.ai.config;

import org.springframework.context.annotation.Configuration;
import org.springframework.web.servlet.config.annotation.CorsRegistry;
import org.springframework.web.servlet.config.annotation.WebMvcConfigurer;

@Configuration
public class MvcConfiguration implements WebMvcConfigurer {

    @Override
    public void addCorsMappings(CorsRegistry registry) {
        registry.addMapping("/**")
                .allowedOrigins("*")
                .allowedMethods("GET", "POST", "PUT", "DELETE", "OPTIONS")
                .allowedHeaders("*")
                .exposedHeaders("Content-Disposition");
    }
}

4.3.配置ChatClient

接下来就是最后的环节了,实现RAG的对话流程。

理论上来说,我们每次与AI对话的完整流程是这样的:

  • 将用户的问题利用向量大模型做向量化 OpenAiEmbeddingModel
  • 去向量数据库检索相关的文档 VectorStore
  • 拼接提示词,发送给大模型
  • 解析响应结果

不过,SpringAI同样基于AOP技术帮我们完成了全部流程,用到的是一个名QuestionAnswerAdvisor的Advisor。我们只需要把VectorStore配置到Advisor即可。

我们在CommonConfiguration中给ChatPDF也单独定义一个ChatClient:

@Bean
public ChatClient pdfChatClient(
        OpenAiChatModel model,
        ChatMemory chatMemory,
        VectorStore vectorStore) {
    return ChatClient.builder(model)
            .defaultSystem("请根据提供的上下文回答问题,不要自己猜测。")
            .defaultAdvisors(
                    new MessageChatMemoryAdvisor(chatMemory), // CHAT MEMORY
                    new SimpleLoggerAdvisor(),
                    new QuestionAnswerAdvisor(
                            vectorStore, // 向量库
                            SearchRequest.builder() // 向量检索的请求参数
                                    .similarityThreshold(0.5d) // 相似度阈值
                                    .topK(2) // 返回的文档片段数量
                                    .build()
                    )
            )
            .build();
}

我们也可以自己自定义RAG查询的流程,不使用Advisor,具体可参考官网:

https://docs.spring.io/spring-ai/reference/api/retrieval-augmented-generation.html

4.4.对话接口

最后,就是对接前端,然后与大模型对话了。修改PdfController,添加一个接口:

@RequestMapping(value = "/chat", produces = "text/html;charset=UTF-8")
public Flux<String> chat(String prompt, String chatId) {
    chatRepository.addChatId("pdf", chatId);
    Resource file = fileRepository.getFile(chatId);
    return pdfChatClient
            .prompt(prompt)
            .advisors(a -> a.param(CHAT_MEMORY_CONVERSATION_ID_KEY, chatId))
            .advisors(a -> a.param(QuestionAnswerAdvisor.FILTER_EXPRESSION, "file_name == '"+file.getFilename()+"'"))
            .stream()
            .content();
}

5.多模态

多模态是指不同类型的数据输入,如文本、图像、声音、视频等。目前为止,我们与大模型交互都是基于普通文本输入,这跟我们选择的大模型有关。

deepseek、qwen-max等模型都是纯文本模型,在ollama和百炼平台,我们也能找到很多多模态模型。

以ollama为例,在搜索时点击vison,就能找到支持图像识别的模型:
在阿里云百炼平台也一样:

阿里云的qwen-omni模型是支持文本、图像、音频、视频输入的全模态模型,还能支持语音合成功能,非常强大。

注意:

在SpringAI的当前版本(1.0.0-m6)中,qwen-omni与SpringAI中的OpenAI模块的兼容性有问题,目前仅支持文本和图片两种模态。音频会有数据格式错误问题,视频完全不支持。

目前的解决方案有两种:

  • 一是使用spring-ai-alibaba来替代。
  • 二是重写OpenAIModel的实现,参考第6节

接下来,我们拓展入门时写的对话机器人,让他支持多模态效果。

5.1.切换模型

首先,我们需要修改CommonConfiguration中用于AI对话的ChatClient,将模型修改为OpenAIChatModel,不仅如此,由于其它业务使用的是qwen-max模型,不能改变。所以这里我们还需添加自定义配置,将模型改为qwen-omni-turbo:

com/itheima/ai/config/CommonConfiguration.java
@Bean
public ChatClient chatClient(OpenAiChatModel model, ChatMemory chatMemory) {
    return ChatClient.builder(model) // 创建ChatClient工厂实例
            .defaultOptions(ChatOptions.builder().model("qwen-omni-turbo").build())
            .defaultSystem("您是一家名为“黑马程序员”的职业教育公司的客户聊天助手,你的名字叫小黑。请以友好、乐于助人和愉快的方式解答用户的各种问题。")
            .defaultAdvisors(new SimpleLoggerAdvisor()) // 添加默认的Advisor,记录日志
            .defaultAdvisors(new MessageChatMemoryAdvisor(chatMemory))
            .build(); // 构建ChatClient实例

}

5.2.多模态对话

接下来,我们需要修改原来的/ai/chat接口,让它支持文件上传和多模态对话。

修改ChatController:

package com.itheima.ai.controller;

import com.itheima.ai.repository.ChatHistoryRepository;
import lombok.RequiredArgsConstructor;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.model.Media;
import org.springframework.util.MimeType;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;
import org.springframework.web.multipart.MultipartFile;
import reactor.core.publisher.Flux;

import java.util.List;
import java.util.Objects;

import static org.springframework.ai.chat.client.advisor.AbstractChatMemoryAdvisor.CHAT_MEMORY_CONVERSATION_ID_KEY;

@RequiredArgsConstructor
@RestController
@RequestMapping("/ai")
public class ChatController {

    private final ChatClient chatClient;

    private final ChatHistoryRepository chatHistoryRepository;

    @RequestMapping(value = "/chat", produces = "text/html;charset=utf-8")
    public Flux<String> chat(
            @RequestParam("prompt") String prompt,
            @RequestParam("chatId") String chatId,
            @RequestParam(value = "files", required = false) List<MultipartFile> files) {
        // 1.保存会话id
        chatHistoryRepository.save("chat", chatId);
        // 2.请求模型
        if (files == null || files.isEmpty()) {
            // 没有附件,纯文本聊天
            return textChat(prompt, chatId);
        } else {
            // 有附件,多模态聊天
            return multiModalChat(prompt, chatId, files);
        }

    }

    private Flux<String> multiModalChat(String prompt, String chatId, List<MultipartFile> files) {
        // 1.解析多媒体
        List<Media> medias = files.stream()
                .map(file -> new Media(
                                MimeType.valueOf(Objects.requireNonNull(file.getContentType())),
                                file.getResource()
                        )
                )
                .toList();
        // 2.请求模型
        return chatClient.prompt()
                .user(p -> p.text(prompt).media(medias.toArray(Media[]::new)))
                .advisors(a -> a.param(CHAT_MEMORY_CONVERSATION_ID_KEY, chatId))
                .stream()
                .content();
    }

    private Flux<String> textChat(String prompt, String chatId) {
        return chatClient.prompt()
                .user(prompt)
                .advisors(a -> a.param(CHAT_MEMORY_CONVERSATION_ID_KEY, chatId))
                .stream()
                .content();
    }
}

阅读全文

SpringAI-Alibaba

2025/7/8

Spring AI Ailibaba简介

SpringAlAlibaba是基于SpringAI构建的框架,专注于与阿里云生态的深度集成。适合国内开发者,尤其是需要快速接入阿里云AI能力的场景。

LangChain4j是 LangChain项目的Java移植版本,专注于构建多模态、多参与者的AI应用,适合需要构建复杂AI工作流和多模态应用的开发者

文档:Spring AI Alibaba实战| ProcessOn免费在线作图,在线流程图,在线思维导图

官方文档:Spring AI Alibaba 官网_快速构建 JAVA AI 应用

项目:ai-demo: 本项目围绕 Spring AI Alibaba 技术栈打造实战课程《Spring AI Alibaba 从入门到进阶实战》,由 Fox 精心开发。课程从基础入门到深度实战,覆盖 Spring AI Alibaba 核心原理、大模型(含本地与云端,如 Ollama、通义千问 )集成、多模态功能(文生图、语音交互 )、RAG 架构、Function Calling、MCP 协议等关键技术,更通过电商智

[Spring AI Alibaba 官网_快速构建 JAVA AI 应用] (http://java2ai.com/)

核心概念

  • 模型(Model)
  • 提示(Prompt)
  • 嵌入(Embedding)
  • Token
  • 结构化输出(Structured Output)
  • 微调(Fine Tuning)
  • 检索增强生成(RAG)
  • 函数调用(Function Calling)
  • 评估人工智能的回答(Evaluation)
同步接口实现
  @GetMapping("/chat")
    public String chat(@RequestParam String input) {
        return chatClient.prompt().user(input).call().content();
    }
流式响应实现
   @GetMapping(value = "/stream", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
    public Flux<String> stream(String input) {
        return this.chatClient.prompt()
                .user(input)
                .stream()
                .content();
    }

ChatClient

作用:通过 ChatClient,开发者可以更专注于业务逻辑而非底层协调,显著提升基于 LLM 的应用开发效率。
适用场景:快速开发:适合需要快速构建端到端 AI 交互的应用(如聊天机器人、问答系统)。复杂流程封装:当需要协调多个组件(如 LLM + 记忆 + 工具)时,减少样板代码。

返回实体类 .entity
    @GetMapping("/movies")
    public ActorFilms movies(@RequestParam(value = "input") String input) throws Exception {
        return this.chatClient.prompt()
                .user(input)
                .call()
                .entity(ActorFilms.class);
    }

curl --location --request GET 'http://localhost:1000/movies' \
--header 'User-Agent: Apifox/1.0.0 (https://apifox.com)' \
--header 'Content-Type: application/json'
指定消息角色 .defaultSystem
    public ChatController(ChatClient.Builder builder) {
        this.chatClient = builder
                .defaultSystem("你是一个演员,请列出你所参演的电影")
                .build();
    }
    @GetMapping("/chat")
    public String chat(@RequestParam(value = "input") String input) {

        return this.chatClient.prompt()
                .user(input)
                .call()
                .content();
    }


curl --location --request GET 'http://localhost:1000/chat' \
--header 'User-Agent: Apifox/1.0.0 (https://apifox.com)' \
--header 'Content-Type: application/json'
package com.fox.alibabaaidemo.controller;

import org.springframework.ai.chat.client.ChatClient;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;

import java.util.Map;

@RestController
public  class AIController {
      private final ChatClient chatClient;
    public AIController(ChatClient.Builder builder) {
        this.chatClient =  builder
                .defaultSystem("你是一个友好的聊天机器人,回答问题时要使用{voice}的语气")
                .build();
    }
      @GetMapping("/ai")
      Map<String, String> completion(@RequestParam(value = "message", defaultValue = "说一个笑话") String message, String voice) {
        return Map.of(
            "completion",
            this.chatClient.prompt()
                .system(sp -> sp.param("voice", voice))
                .user(message)
                .call()
                .content());
      }
    }

GET:http://localhost:1000/ai
voice  沈腾

其他默认设置

除了 defaultSystem 之外,您还可以在 ChatClient.Builder 级别上指定其他默认提示。

  • defaultOptions(ChatOptions chatOptions):传入 ChatOptions 类中定义的可移植选项或特定于模型实现的如 DashScopeChatOptions 选项。有关特定于模型的ChatOptions实现的更多信息,请参阅 JavaDocs。
  • defaultFunction(String name, String description, java.util.function.Function<I, O> function):name 用于在用户文本中引用该函数,description解释该函数的用途并帮助 AI 模型选择正确的函数以获得准确的响应,参数 function 是模型将在必要时执行的 Java 函数实例。
  • defaultFunctions(String... functionNames):应用程序上下文中定义的 java.util.Function 的 bean 名称。
  • defaultUser(String text)、defaultUser(Resource text)、defaultUser(Consumer<UserSpec> userSpecConsumer) 这些方法允许您定义用户消息输入,Consumer<UserSpec>允许您使用 lambda 指定用户消息输入和任何默认参数。
  • defaultAdvisors(RequestResponseAdvisor... advisor):Advisors 允许修改用于创建 Prompt 的数据,QuestionAnswerAdvisor 实现通过在 Prompt 中附加与用户文本相关的上下文信息来实现 Retrieval Augmented Generation 模式。
  • defaultAdvisors(Consumer<AdvisorSpec> advisorSpecConsumer):此方法允许您定义一个 Consumer 并使用 AdvisorSpec 配置多个 Advisor,Advisor 可以修改用于创建 Prompt 的最终数据,Consumer<AdvisorSpec> 允许您指定 lambda 来添加 Advisor 例如 QuestionAnswerAdvisor。

您可以在运行时使用 ChatClient 提供的不带 default 前缀的相应方法覆盖这些默认值。

  • options(ChatOptions chatOptions)

  • function(String name, String description, java.util.function.Function<I, O> function)

  • functions(String... functionNames)

  • user(String text)、user(Resource text)、user(Consumer<UserSpec> userSpecConsumer)

  • advisors(RequestResponseAdvisor... advisor)

  • advisors(Consumer<AdvisorSpec> advisorSpecConsumer)

【基于内存存储】多轮对话记忆管理对话记忆

对话模型(Chat Model)

对话模型(Chat Model)接收一系列消息(Message)作为输入,与模型 LLM 服务进行交互,并接收返回的聊天消息(Chat Message)作为输出。相比于普通的程序输入,模型的输入与输出消息(Message)不止支持纯字符文本,还支持包括语音、图片、视频等作为输入输出。同时,在 Spring AI Alibaba 中,消息中还支持包含不同的角色,帮助底层模型区分来自模型、用户和系统指令等的不同消息。

Spring AI Alibaba 复用了 Spring AI 抽象的 Model API,并与通义系列大模型服务进行适配(如通义千问、通义万相等),目前支持纯文本聊天、文生图、文生语音、语音转文本等。以下是框架定义的几个核心 API:

  • ChatModel,文本聊天交互模型,支持纯文本格式作为输入,并将模型的输出以格式化文本形式返回。
  • ImageModel,接收用户文本输入,并将模型生成的图片作为输出返回。
  • AudioModel,接收用户文本输入,并将模型合成的语音作为输出返回。

Spring AI Alibaba 支持以上 Model 抽象与通义系列模型的适配,并通过 spring-ai-alibaba-starter AutoConfiguration 自动初始化了默认实例,因此我们可以在应用程序中直接注入 ChatModel、ImageModel 等 bean,当然在需要的时候也可以自定义 Model 实例。

对话记忆介绍

”大模型的对话记忆”这一概念,根植于人工智能与自然语言处理领域,特别是针对具有深度学习能力的大型语言模型而言,它指的是模型在与用户进行交互式对话过程中,能够追踪、理解并利用先前对话上下文的能力。 此机制使得大模型不仅能够响应即时的输入请求,还能基于之前的交流内容能够在对话中记住先前的对话内容,并根据这些信息进行后续的响应。这种记忆机制使得模型能够在对话中持续跟踪和理解用户的意图和上下文,从而实现更自然和连贯的对话。

我们在调用大模型的过程中,如果自己维护多轮的对话记忆,通常情况下调用代码如下

import java.util.ArrayList;

List<Message> messages = new ArrayList<>();

//第一轮对话
messages.add(new SystemMessage("你是一个旅游规划师"));
messages.add(new UserMessage("我想去新疆"));
ChatResponse response = chatModel.call(new Prompt(messages));
String content = response.getResult().getOutput().getContent();

messages.add(new AssistantMessage(content));

        //第二轮对话
messages.add(new UserMessage("能帮我推荐一些旅游景点吗?"));
response = chatModel.call(new Prompt(messages));
content = response.getResult().getOutput().getContent();

messages.add(new AssistantMessage(content));

        //第三轮对话
messages.add(new UserMessage("那里这两天的天气如何?"));
response = chatModel.call(new Prompt(messages));
content = response.getResult().getOutput().getContent();

System.out.printf("content: %s\n", content);

基于memory的对话记忆advisors是增强器

如何让大模型有对话记忆呢?
Advisor(MessageChatMemoryAdvisor)、Memory(InMemoryChatMemory,RedisChatMemory)
使用ChatMemoryAdvisor与RedisChatMemory存储历史对话

ChatClient.builder(chatModel)
  .defaultAdvisors(new MessageChatMemoryAdvisor(redisChatMemory))
  .build();

spring-ai-alibaba支持基于chat memory的对话记忆,也就是不需要调用显示的记录每一轮的对话历史。下边是一个基于内存存储的对话记忆实现:

@RestController
@RequestMapping("/chat-memory")
public class ChatMemoryController {

    private final ChatClient chatClient;

    public ChatMemoryController(ChatModel chatModel) {
// 构建对话模型 基于内存的方式InMemory...
        this.chatClient = ChatClient
                .builder(chatModel)
                .defaultSystem("你是一个旅游规划师,请根据用户的需求提供旅游规划建议。")
                .defaultAdvisors(new MessageChatMemoryAdvisor(new InMemoryChatMemory()))
//                .defaultAdvisors(new MessageChatMemoryAdvisor(new RedisChatMemory(
//                        "127.0.0.1",
//                        6379,
//                        null
//                )))
                .build();
    }

    /**
     * 获取内存中的聊天内容
     * 根据提供的prompt和chatId,从内存中获取相关的聊天内容,并设置响应的字符编码为UTF-8。
     *
     * @param prompt 用于获取聊天内容的提示信息
     * @param chatId 聊天的唯一标识符,用于区分不同的聊天会话
     * @param response HTTP响应对象,用于设置响应的字符编码
     * @return 返回包含聊天内容的Flux<String>对象
     */
    @GetMapping("/in-memory")
    public Flux<String> memory(
            @RequestParam("prompt") String prompt,
            @RequestParam("chatId") String chatId,
            HttpServletResponse response
    ) {

        response.setCharacterEncoding("UTF-8");
        return chatClient.prompt(prompt).advisors(
                a -> a
                        .param(CHAT_MEMORY_CONVERSATION_ID_KEY, chatId)
                        .param(CHAT_MEMORY_RETRIEVE_SIZE_KEY, 100)
        ).stream().content();
    }

GET:http://localhost:1000/chat-memory/in-memory
prompt  我想去新疆玩
chatId  Pluminary

One【我想去新疆玩】

太棒了!新疆是中国最美丽、最多元化的旅游目的地之一,拥有壮丽的自然风光、丰富的民族文化和悠久的历史遗迹。根据你的兴趣和时间安排,我可以为你量身定制一份详细的旅行计划。

以下是一份 7天经典新疆旅游路线推荐,适合第一次来新疆的游客:


🌄 7天经典新疆旅游线路(北疆线)

✅ 路线概览:

乌鲁木齐 → 天池 → 乌鲁木齐 → 奎屯 → 赛里木湖 → 果子沟 → 伊宁 → 那拉提草原 → 巴音布鲁克 → 独库公路 → 乌鲁木齐


📅 行程详情:

第1天:抵达乌鲁木齐

  • 抵达乌鲁木齐地窝堡国际机场或火车站。
  • 游览【国际大巴扎】,购买当地特产与手工艺品。
  • 晚上可品尝新疆特色美食:大盘鸡、烤包子、羊肉串等。

第2天:乌鲁木齐 → 天山天池 → 返回乌鲁木齐

  • 上午驱车前往【天山天池】,欣赏雪山、湖泊、松林交相辉映的美景。
  • 下午返回市区,参观【新疆博物馆】了解西域历史文化。
  • 可尝试维吾尔族风味晚餐。

第3天:乌鲁木齐 → 奎屯 → 赛里木湖

  • 乘车约6小时到达【赛里木湖】,被誉为“大西洋最后一滴眼泪”。
  • 环湖游览,拍摄湖光山色,入住湖边民宿或附近酒店。

第4天:赛里木湖 → 伊宁

  • 沿果子沟峡谷前行,穿越【果子沟大桥】,风景绝佳。
  • 到达伊宁市后,游览【喀赞其民俗区】,感受浓郁的维吾尔族风情。
  • 住伊宁。

第5天:伊宁 → 那拉提草原

  • 乘车约3小时到达【那拉提草原】,是新疆最美的高山草甸之一。
  • 骑马、徒步、摄影,体验草原牧民生活。
  • 住那拉提镇。

第6天:那拉提 → 巴音布鲁克 → 独库公路 → 乌鲁木齐

  • 驱车前往【巴音布鲁克草原】,探访著名的“九曲十八弯”开都河。
  • 沿【独库公路】北段返回乌鲁木齐,途中穿越天山山脉,风景震撼。
  • 全天行车时间较长(约8-10小时),建议提前准备干粮和水。

第7天:乌鲁木齐 → 返程

  • 根据航班/火车时间安排返程。
  • 可在市区再次购物或补拍未尽兴的景点。

💡 小贴士:

  • 最佳旅游季节:每年6月-10月是新疆的最佳旅游季节,气候宜人,风景最美。
  • 交通方式:
    • 自驾游是探索新疆最好的方式,路况较好。
    • 若不自驾,也可以选择包车或参加当地品质团。
  • 注意事项:
    • 新疆昼夜温差大,注意带好保暖衣物。
    • 注意防晒,紫外线较强。
    • 尊重少数民族风俗习惯,避免敏感话题。

🍽️ 必吃美食推荐:

  • 烤包子
  • 手抓饭
  • 羊肉串
  • 盘吉尔塔格麻饼
  • 牛骨头汤
  • 新疆酸奶+馕

如果你有更长的时间,还可以考虑延伸到南疆(喀什、塔克拉玛干沙漠、帕米尔高原)或者北疆深度游(可可托海、喀纳斯、禾木)。

你可以告诉我:

  • 出行时间
  • 同行人数
  • 是否自驾
  • 是否希望加入人文历史或摄影元素

我可以为你定制更详细的行程、住宿推荐和预算方案哦!

Tow [prompt:有哪些好玩的地方?]

当然可以!作为一个旅游规划师,我会根据不同的旅行兴趣、时间和预算,为你推荐新疆最值得一去的好玩地方。新疆地大景美,玩法多样,既有自然风光,也有浓郁的民族风情和历史人文。


🌄 新疆十大必玩景点推荐(按类型分类)

一、自然风光类

1. 喀纳斯湖景区

  • 关键词:神秘湖怪、变色湖、图瓦人村落
  • 推荐理由:被誉为“人间仙境”,四季皆美,秋季尤胜。
  • 适合人群:摄影爱好者、自然探险者

2. 赛里木湖

  • 关键词:大西洋最后一滴眼泪、花海、湖光山色
  • 推荐理由:夏季油菜花盛开,湖水清澈见底,是北疆最美湖泊之一。

3. 那拉提草原

  • 关键词:空中草原、骑马、牧民风情
  • 推荐理由:夏季草原如画,适合徒步、骑马、拍照。

4. 巴音布鲁克草原 & 九曲十八弯

  • 关键词:天鹅故乡、开都河九曲、日落绝美
  • 推荐理由:中国第二大草原,电影《飞驰人生》取景地。

5. 独库公路

  • 关键词:天山之路、一日四季、自驾天堂
  • 推荐理由:被誉为“中国最美景观大道”,连接南北疆。

二、历史文化类

6. 交河故城 & 高昌故城

  • 关键词:丝绸之路遗迹、千年古城
  • 推荐理由:感受古代西域文明的辉煌与沧桑。

7. 克孜尔千佛洞

  • 关键词:佛教艺术瑰宝、壁画、石窟群
  • 推荐理由:比敦煌莫高窟更早开凿,艺术价值极高。

8. 香妃墓(阿帕克霍加墓)

  • 关键词:爱情传说、伊斯兰建筑
  • 推荐理由:喀什最具代表性的古迹之一。

三、民俗风情类

9. 喀什老城(艾提尕尔清真寺)

  • 关键词:维吾尔族风情、夜市、手工艺
  • 推荐理由:南疆文化中心,充满异域风情。

10. 塔克拉玛干沙漠 / 塔中沙漠公路

  • 关键词:死亡之海、星空露营、越野挑战
  • 推荐理由:体验极限风光,感受荒漠中的壮美。

🏞️ 按线路推荐热门玩法

线路类型 推荐景点 特点
北疆经典线 天池、赛里木湖、那拉提、巴音布鲁克、独库公路 风景优美、适合首次来新疆
南疆深度线 喀什、塔克拉玛干沙漠、帕米尔高原、塔县、白沙湖 民俗浓郁、神秘原始
北疆深度线 喀纳斯、禾木、可可托海 秋季绝美、摄影圣地
自驾线路 独库公路、沙漠公路、喀纳斯环线 风景多变、自由灵活

📅 根据时间长短推荐玩法

时间安排 推荐行程
5-7天 北疆经典线:乌鲁木齐 → 赛里木湖 → 那拉提 → 巴音布鲁克 → 独库公路 → 乌鲁木齐
8-10天 北疆+南疆组合:乌鲁木齐 → 喀纳斯 → 那拉提 → 伊宁 → 喀什 → 帕米尔高原
10天以上 全疆深度游:涵盖北疆、南疆、东疆,体验多元文化与极致风光

🎯 小贴士:如何选择适合你的路线?

  1. 喜欢自然风光? → 喀纳斯、赛里木湖、那拉提
  2. 喜欢人文历史? → 交河故城、克孜尔千佛洞、喀什老城
  3. 喜欢冒险刺激? → 塔克拉玛干沙漠、独库公路自驾
  4. 喜欢摄影? → 喀纳斯秋景、巴音布鲁克日落、帕米尔高原星空
  5. 亲子出游? → 乌鲁木齐博物馆、天山天池、那拉提草原

如果你能告诉我以下信息,我可以帮你定制专属行程:

  • 出行时间(几月份)
  • 出行人数(是否带老人/小孩)
  • 是否自驾或包车
  • 偏好自然/人文/美食/摄影等哪一类
  • 预算范围(经济型/舒适型/豪华型)

期待你的回复,我将为你打造一份专属新疆旅行计划!✨

当然,开发者也可以自行实现ChatMemory基于类似于文件、Redis等方式进行上下文内容的存储和记录。

【基于Redis存储】多轮对话记忆管理对话记忆

这里Redis的官方依赖有问题 需要自己修改再去使用 不算得上是重构 要去重写建立新的
可以将下面的打成包 使用的时候只需要引入依赖即可

C:\Users\Pluminary\Desktop\HouDuan\ai-demo\my-redis-memory\src\main\java\com\fox\myredismemory\RedisChatMemory.java
package com.fox.myredismemory;

import java.util.*;
import java.util.concurrent.atomic.AtomicLong;
import java.util.stream.Collectors;

import com.fasterxml.jackson.databind.ObjectMapper;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.ai.chat.messages.UserMessage;
import redis.clients.jedis.Jedis;
import redis.clients.jedis.JedisPool;
import redis.clients.jedis.JedisPoolConfig;

import org.springframework.ai.chat.memory.ChatMemory;
import org.springframework.ai.chat.messages.Message;

/**
 *
 * 基于Redis的聊天记忆实现。
 * 该类实现了ChatMemory接口,提供了将聊天消息存储到Redis中的功能。
 *
 * @author Fox
 */
public class RedisChatMemory implements ChatMemory, AutoCloseable {

    private static final Logger logger = LoggerFactory.getLogger(RedisChatMemory.class);

    private static final String DEFAULT_KEY_PREFIX = "chat:";

    private static final String DEFAULT_HOST = "127.0.0.1";

    private static final int DEFAULT_PORT = 6379;

    private static final String DEFAULT_PASSWORD = null;

    private final JedisPool jedisPool;


    private final ObjectMapper objectMapper;

    public RedisChatMemory() {

        this(DEFAULT_HOST, DEFAULT_PORT, DEFAULT_PASSWORD);
    }

    public RedisChatMemory(String host, int port, String password) {

        JedisPoolConfig poolConfig = new JedisPoolConfig();

        this.jedisPool = new JedisPool(poolConfig, host, port, 2000, password);
        this.objectMapper = new ObjectMapper();
        logger.info("Connected to Redis at {}:{}", host, port);
    }

    @Override
    public void add(String conversationId, List<Message> messages) {

        String key = DEFAULT_KEY_PREFIX + conversationId;

        AtomicLong timestamp = new AtomicLong(System.currentTimeMillis());

        try (Jedis jedis = jedisPool.getResource()) {
            // 使用pipeline批量操作提升性能
            var pipeline = jedis.pipelined();
            messages.forEach(message ->
                    pipeline.hset(key, String.valueOf(timestamp.getAndIncrement()), message.toString())
            );
            pipeline.sync();
        }

        logger.info("Added messages to conversationId: {}", conversationId);
    }

    @Override
    public List<Message> get(String conversationId, int lastN) {

        String key = DEFAULT_KEY_PREFIX + conversationId;

        try (Jedis jedis = jedisPool.getResource()) {
            Map<String, String> allMessages = jedis.hgetAll(key);
            if (allMessages.isEmpty()) {
                return List.of();
            }

            return allMessages.entrySet().stream()
                    .sorted((e1, e2) ->
                            Long.compare(Long.parseLong(e2.getKey()), Long.parseLong(e1.getKey()))
                    )
                    .limit(lastN)
                    .map(entry -> new UserMessage(entry.getValue()))
                    .collect(Collectors.toList());
        }


    }

    @Override
    public void clear(String conversationId) {

        String key = DEFAULT_KEY_PREFIX + conversationId;

        try (Jedis jedis = jedisPool.getResource()) {
            jedis.del(key);
        }
        logger.info("Cleared messages for conversationId: {}", conversationId);
    }

    @Override
    public void close() {
        try (Jedis jedis = jedisPool.getResource()) {
            if (jedis != null) {

                jedis.close();

                logger.info("Redis connection closed.");
            }
            if (jedisPool != null) {

                jedisPool.close();

                logger.info("Jedis pool closed.");
            }
        }

    }

    public void clearOverLimit(String conversationId, int maxLimit, int deleteSize) {
        try {
            String key = DEFAULT_KEY_PREFIX + conversationId;
            try (Jedis jedis = jedisPool.getResource()) {
                List<String> all = jedis.lrange(key, 0, -1);

                if (all.size() >= maxLimit) {
                    all = all.stream().skip(Math.max(0, deleteSize)).toList();
                }
                this.clear(conversationId);
                for (String message : all) {
                    jedis.rpush(key, message);
                }
            }
        }
        catch (Exception e) {
            logger.error("Error clearing messages from Redis chat memory", e);
            throw new RuntimeException(e);
        }
    }

}
@RestController
@RequestMapping("/chat-memory")
public class ChatMemoryController {

    private final ChatClient chatClient;

    public ChatMemoryController(ChatModel chatModel) {
// 构建对话模型 基于内存的方式InMemory...
        this.chatClient = ChatClient
                .builder(chatModel)
                .defaultSystem("你是一个旅游规划师,请根据用户的需求提供旅游规划建议。")
//                .defaultAdvisors(new MessageChatMemoryAdvisor(new InMemoryChatMemory()))
                .defaultAdvisors(new MessageChatMemoryAdvisor(new RedisChatMemory(
                        "127.0.0.1",
                        6379,
                        null
                )))
                .build();
    }

    
    /**
     * 从Redis中获取聊天内容
     * 根据提供的prompt和chatId,从Redis中检索聊天内容,并以Flux<String>的形式返回
     *
     * @param prompt 聊天内容的提示或查询关键字
     * @param chatId 聊天的唯一标识符,用于从Redis中检索特定的聊天内容
     * @param response HttpServletResponse对象,用于设置响应的字符编码为UTF-8
     * @return Flux<String> 包含聊天内容的反应式流
     */
    @GetMapping("/redis")
    public Flux<String> redis(
            @RequestParam("prompt") String prompt,
            @RequestParam("chatId") String chatId,
            HttpServletResponse response
    ) {

        response.setCharacterEncoding("UTF-8");

        return chatClient.prompt(prompt)
                .advisors(
                a -> a
                        .param(CHAT_MEMORY_CONVERSATION_ID_KEY, chatId)
                        .param(CHAT_MEMORY_RETRIEVE_SIZE_KEY, 10)
                )
                .stream().content();
    }

GET:http://localhost:1000/chat-memory/redis
prompt  有什么好吃的?
chatId  Pluminary

打开Another Redis Desktop Manager即可看见Key和Value
这里也是基于上下文 第一个问题是我想去三亚 第二个问题有什么好吃的这里是基于第一个问题和回答去输出结果

Key:1752192461656
Value:UserMessage{content='我想去三亚', properties={messageType=USER}, messageType=USER}

ChatModel对话模型

ChatResponse里面是对话的json响应类

package com.fox.alibabaaidemo.controller;

import com.alibaba.cloud.ai.dashscope.chat.DashScopeChatOptions;
import jakarta.servlet.http.HttpServletResponse;
import org.springframework.ai.chat.model.ChatModel;
import org.springframework.ai.chat.model.ChatResponse;
import org.springframework.ai.chat.prompt.Prompt;
import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;
import reactor.core.publisher.Flux;

import java.io.IOException;

@RestController
public class ChatModelController {
    private final ChatModel chatModel;

    public ChatModelController(@Qualifier("dashscopeChatModel") ChatModel chatModel) {
        this.chatModel = chatModel;
    }

    @RequestMapping("/chat2")
    public String chat2(String input) {

        DashScopeChatOptions options = DashScopeChatOptions.builder()
                .withTemperature(0.9)
                .withMaxToken(1500)
           //     .withTopP(0.01)
                .build();

        Prompt prompt = new Prompt(input, options);
        ChatResponse response = chatModel.call(prompt);
        //ChatResponse response = chatModel.call(new Prompt(input));
        return response.getResult().getOutput().getText();
    }


    @RequestMapping("/streamChat")
    public Flux<String> streamChat(String input, HttpServletResponse response) throws IOException {
        response.setContentType("text/event-stream");
        response.setCharacterEncoding("UTF-8");
        return chatModel.stream(input);
    }
}

GET:http://localhost:1000/chat2
input  我想去深圳,帮我做个规划

ImageModel实现文生图

package com.fox.alibabaaidemo.controller;

import com.alibaba.cloud.ai.dashscope.image.DashScopeImageOptions;
import org.springframework.ai.image.*;
import org.springframework.beans.factory.annotation.Qualifier;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;

@RestController
public class ImageModelController {
    private final ImageModel imageModel;

    ImageModelController(@Qualifier("dashScopeImageModel") ImageModel imageModel) {
        this.imageModel = imageModel;
    }

    @RequestMapping("/image")
    public String image(String input) {
        ImageOptions options = ImageOptionsBuilder.builder()
                .model("wanx2.1-t2i-turbo")
                .height(1024)
                .width(1024)
                .build();

        ImagePrompt imagePrompt = new ImagePrompt(input, options);
        ImageResponse response = imageModel.call(imagePrompt);
        String imageUrl = response.getResult().getOutput().getUrl();

        return "redirect:" + imageUrl;
    }
}

GET:http://localhost:1000/image
input  森林中的绝美精灵,手里拿着弓

AudioModel文生语音&语音转文本

文本生成语音
package com.fox.alibabaaidemo.controller;

import com.alibaba.cloud.ai.dashscope.audio.DashScopeAudioTranscriptionModel;
import com.alibaba.cloud.ai.dashscope.audio.DashScopeAudioTranscriptionOptions;
import com.alibaba.cloud.ai.dashscope.audio.synthesis.SpeechSynthesisModel;
import com.alibaba.cloud.ai.dashscope.audio.synthesis.SpeechSynthesisPrompt;
import com.alibaba.cloud.ai.dashscope.audio.synthesis.SpeechSynthesisResponse;
import org.springframework.ai.audio.transcription.AudioTranscriptionPrompt;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.http.MediaType;
import org.springframework.http.ResponseEntity;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;

import java.io.IOException;
import java.net.MalformedURLException;
import java.nio.ByteBuffer;

/**
 * @author: Fox
 * @Desc:
 **/
@RestController
@RequestMapping("/audio")
public class AudioModelController {

    private final SpeechSynthesisModel speechSynthesisModel;

    @Autowired
    public AudioModelController(SpeechSynthesisModel speechSynthesisModel) {
        this.speechSynthesisModel = speechSynthesisModel;
    }

    @GetMapping("/synthesize")
    public ResponseEntity<byte[]> synthesizeSpeech(@RequestParam String text) throws IOException {
        // 构建语音合成请求
        SpeechSynthesisPrompt prompt = new SpeechSynthesisPrompt(text);

        // 调用模型生成语音
        SpeechSynthesisResponse response = speechSynthesisModel.call(prompt);
        ByteBuffer audioData = response.getResult().getOutput().getAudio();

        // 将 ByteBuffer 转换为字节数组
        byte[] audioBytes = new byte[audioData.remaining()];
        audioData.get(audioBytes);

        // 返回音频流(MP3格式)
        return ResponseEntity.ok()
                .contentType(MediaType.APPLICATION_OCTET_STREAM)
                .header("Content-Disposition", "attachment; filename=output.mp3")
                .body(audioBytes);
    }
}

GET:http://localhost:1000/audio/synthesize
text  我真的太喜欢点赞啦
语音生成文本
package com.fox.alibabaaidemo.controller;

import com.alibaba.cloud.ai.dashscope.audio.DashScopeAudioTranscriptionModel;
import com.alibaba.cloud.ai.dashscope.audio.DashScopeAudioTranscriptionOptions;
import org.springframework.ai.audio.transcription.AudioTranscriptionPrompt;
import org.springframework.core.io.ClassPathResource;
import org.springframework.core.io.Resource;
import org.springframework.core.io.UrlResource;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

import java.net.MalformedURLException;

/**
 * @author: Fox
 * @Desc:
 **/
@RestController
public class AudioModelController2 {

    private static final String AUDIO_RESOURCES_URL = "https://dashscope.oss-cn-beijing.aliyuncs.com/samples/audio/paraformer/hello_world_female2.wav";

    private final DashScopeAudioTranscriptionModel dashScopeAudioTranscriptionModel; //modelname:sensevoice-v1,paraformer-realtime-v2,paraformer-v2

    AudioModelController2(DashScopeAudioTranscriptionModel dashScopeAudioTranscriptionModel){
        this.dashScopeAudioTranscriptionModel = dashScopeAudioTranscriptionModel;
    }

    @GetMapping("/audio")
    public String audio() throws MalformedURLException {
        Resource resource =new UrlResource(AUDIO_RESOURCES_URL);

        AudioTranscriptionPrompt prompt = new AudioTranscriptionPrompt(resource,
                DashScopeAudioTranscriptionOptions.builder()
                        .withModel("sensevoice-v1")
                        .build());

        return dashScopeAudioTranscriptionModel.call(prompt).getResult().getOutput();
    }
}

GET:http://localhost:1000/audio

提示词 (Prompt).create

Prompt 是引导 AI 模型生成特定输出的输入格式,Prompt 的设计和措辞会显著影响模型的响应。

Prompt 最开始只是简单的字符串,随着时间的推移,prompt 逐渐开始包含特定的占位符,例如 AI 模型可以识别的 “USER:”、“SYSTEM:” 等。阿里云通义模型可通过将多个消息字符串分类为不同的角色,然后再由 AI 模型处理,为 prompt 引入了更多结构。每条消息都分配有特定的角色,这些角色对消息进行分类,明确 AI 模型提示的每个部分的上下文和目的。这种结构化方法增强了与 AI 沟通的细微差别和有效性,因为 prompt 的每个部分在交互中都扮演着独特且明确的角色。

Prompt 中的主要角色(Role)包括:

  • 系统角色(System Role):指导 AI 的行为和响应方式,设置 AI 如何解释和回复输入的参数或规则。这类似于在发起对话之前向 AI 提供说明。
  • 用户角色(User Role):代表用户的输入 - 他们向 AI 提出的问题、命令或陈述。这个角色至关重要,因为它构成了 AI 响应的基础。
  • 助手角色(Assistant Role):AI 对用户输入的响应。这不仅仅是一个答案或反应,它对于保持对话的流畅性至关重要。通过跟踪 AI 之前的响应(其“助手角色”消息),系统可确保连贯且上下文相关的交互。助手消息也可能包含功能工具调用请求信息。它就像 AI 中的一个特殊功能,在需要执行特定功能(例如计算、获取数据或不仅仅是说话)时使用。
  • 工具/功能角色(Tool/Function Role):工具/功能角色专注于响应工具调用助手消息返回附加信息。
API 概览
Prompt

通常使用 ChatModel 的 call() 方法,该方法接受 Prompt 实例并返回 ChatResponse。

Prompt 类充当有组织的一系列 Message 对象和请求 ChatOptions 的容器。每条消息在提示中都体现了独特的角色,其内容和意图各不相同。这些角色可以包含各种元素,从用户查询到 AI 生成的响应再到相关背景信息。这种安排可以实现与 AI 模型的复杂而详细的交互,因为提示是由多条消息构成的,每条消息都被分配了在对话中扮演的特定角色。

该类实现的接口支持提示创建的不同方面:

PromptTemplateStringActions 专注于创建和呈现提示字符串,代表提示生成的最基本形式。

PromptTemplateMessageActions 专门用于通过生成和操作 Message 对象来创建提示。

PromptTemplateActions 旨在返回 Prompt 对象,该对象可以传递给 ChatModel 以生成响应。

虽然这些接口可能在许多项目中没有得到广泛使用,但它们展示了创建提示的不同方法。

实现ConfigurablePromptTemplateFactory
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\prompt-demo\src\main\java\com\fox\promptdemo\config\PromptTemplateConfig.java

package com.fox.promptdemo.config;

import com.alibaba.cloud.ai.prompt.ConfigurablePromptTemplateFactory;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class PromptTemplateConfig {

    @Bean
    public ConfigurablePromptTemplateFactory configurablePromptTemplateFactory() {
        // 这里假设ConfigurablePromptTemplateFactory有一个无参构造函数
        return new ConfigurablePromptTemplateFactory();
        // 如果需要配置参数,可以在这里进行配置
        // return new ConfigurablePromptTemplateFactory(param1, param2);
    }
}
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\prompt-demo\src\main\java\com\fox\promptdemo\controller\PromptTemplateController.java
@GetMapping("/prompt-template")
    public AssistantMessage generate(
            @RequestParam(value = "author", defaultValue = "鲁迅") String author
    ) {

        ConfigurablePromptTemplate template = configurablePromptTemplateFactory.getTemplate("test-template");

        if (template == null) {
            template = configurablePromptTemplateFactory.create("test-template",
                    "请列出 {author} 最著名的三本书。");
        }

        Prompt prompt;
        if (StringUtils.hasText(author)) {
            prompt = template.create(Map.of("author", author));
        } else {
            prompt = template.create();
        }

        return chatClient.prompt(prompt)
                .call()
                .chatResponse()
                .getResult()
                .getOutput();
    }

GET:http://localhost:10007/example/ai/prompt-template
author  鲁迅
实现PromptTemplate
@RestController
@RequestMapping("/example/ai")
public class PromptTemplateController {

    private final ChatClient chatClient;

    private final ConfigurablePromptTemplateFactory configurablePromptTemplateFactory;
        
    // 这里的资源是以st文件类型放在了resources的prompts里面
    @Value("classpath:/prompts/joke-prompt.st")
    private Resource jokeResource;

    @GetMapping("/prompt")
    public AssistantMessage completion(
            @RequestParam(value = "adjective", defaultValue = "有趣") String adjective,
            @RequestParam(value = "topic", defaultValue = "奶牛") String topic
    ) {

        PromptTemplate promptTemplate = new PromptTemplate(jokeResource);
        Prompt prompt = promptTemplate.create(Map.of("adjective", adjective, "topic", topic));

        return chatClient.prompt(prompt)
                .call()
                .chatResponse()
                .getResult()
                .getOutput();
    }
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\prompt-demo\src\main\resources\prompts\joke-prompt.st
给我讲一个关于 {topic} 的 {adjective} 笑话

GET:http://localhost:10007/example/ai/prompt
adjective  有趣的
topic  猫
实现SystemPromptTemplate
/*
 * Licensed to the Apache Software Foundation (ASF) under one or more
 * contributor license agreements.  See the NOTICE file distributed with
 * this work for additional information regarding copyright ownership.
 * The ASF licenses this file to You under the Apache License, Version 2.0
 * (the "License"); you may not use this file except in compliance with
 * the License.  You may obtain a copy of the License at
 *
 *     http://www.apache.org/licenses/LICENSE-2.0
 *
 * Unless required by applicable law or agreed to in writing, software
 * distributed under the License is distributed on an "AS IS" BASIS,
 * WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
 * See the License for the specific language governing permissions and
 * limitations under the License.
 */

package com.fox.promptdemo.controller;

import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.messages.AssistantMessage;
import org.springframework.ai.chat.messages.Message;
import org.springframework.ai.chat.messages.UserMessage;
import org.springframework.ai.chat.prompt.Prompt;
import org.springframework.ai.chat.prompt.SystemPromptTemplate;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.core.io.Resource;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;

import java.util.List;
import java.util.Map;

@RestController
@RequestMapping("/example/ai")
public class RoleController {

    private final ChatClient chatClient;

    @Value("classpath:/prompts/system-message.st")
    private Resource systemResource;

    @Autowired
    public RoleController(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }
// defaultValue是没有传入时候的默认值
    @GetMapping("/roles")
    public AssistantMessage generate(
            @RequestParam(value = "message",
            defaultValue = "请介绍一下海盗黄金时代的三位著名海盗,以及他们为什么这样做。为每个海盗至少写一句话。") String message,
            @RequestParam(value = "name", defaultValue = "Fox") String name,
            @RequestParam(value = "voice", defaultValue = "海盗") String voice
    ) {

        UserMessage userMessage = new UserMessage(message);

        SystemPromptTemplate systemPromptTemplate = new SystemPromptTemplate(systemResource);
        // .createMessage创建一个系统消息
        Message systemMessage = systemPromptTemplate.createMessage(Map.of("name", name, "voice", voice));

        return chatClient.prompt(new Prompt(List.of(userMessage, systemMessage)))
                .call()
                .chatResponse()
                .getResult()
                .getOutput();
    }
}

GET:http://localhost:10007/example/ai/roles
name  Pluminary
voice  海盗
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\prompt-demo\src\main\resources\prompts\system-message.st
你是一个有用的 AI 助手。
你是帮助人们查找信息的 AI 助手。
你的名字是 {name}
你应该使用你的姓名和 {voice} 的样式回复用户的请求。

静态RAG实现:提示词动态注入

当前实现的方式:

  • 属于 “文档预加载+条件触发” 模式
  • 通过 stuffit 参数实现 人工控制的上下文开关
  • 上下文直接来自预定义的静态资源文件
  • 本质上是一种轻量级的 静态RAG(Static RAG)

经典RAG:

  • 采用 “检索-排序-注入” 自动化流程
  • 依赖向量相似度计算动态选择上下文
  • 支持增量学习和实时知识更新
  • 典型流程:问题编码→向量检索→相关性过滤→上下文注入

适用场景建议
当前方式更适合:

  • 文档规模小(如产品说明书、FAQ等)
  • 需要严格控制的回答范围
  • 快速原型开发阶段
  • 对实时性要求不高的场景

需要升级到RAG当:

  • 文档超过100MB或频繁更新
  • 需要基于问题语义自动匹配上下文
  • 要求支持多文档源混合检索
  • 需要结合用户画像的个性化回答
/*
 * Licensed to the Apache Software Foundation (ASF) under one or more
 * contributor license agreements.  See the NOTICE file distributed with
 * this work for additional information regarding copyright ownership.
 * The ASF licenses this file to You under the Apache License, Version 2.0
 * (the "License"); you may not use this file except in compliance with
 * the License.  You may obtain a copy of the License at
 *
 *     http://www.apache.org/licenses/LICENSE-2.0
 *
 * Unless required by applicable law or agreed to in writing, software
 * distributed under the License is distributed on an "AS IS" BASIS,
 * WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
 * See the License for the specific language governing permissions and
 * limitations under the License.
 */

package com.fox.promptdemo.controller;

import com.fox.promptdemo.entity.Completion;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.prompt.PromptTemplate;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.core.io.Resource;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;

import java.util.HashMap;
import java.util.Map;

@RestController
@RequestMapping("/example/ai")
public class StuffController {

    private final ChatClient chatClient;

    @Value("classpath:/docs/bailian.md")
    private Resource docsToStuffResource;

    @Value("classpath:/prompts/qa-prompt.st")
    private Resource qaPromptResource;

    @Autowired
    public StuffController(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }

    @GetMapping(value = "/stuff")
    public Completion completion(@RequestParam(value = "message", defaultValue = "给我推荐一款百炼系列的手机?")
                                     String message, @RequestParam(value = "stuffit", defaultValue = "false")
                                     boolean stuffit) {

        PromptTemplate promptTemplate = new PromptTemplate(qaPromptResource);

        Map<String, Object> map = new HashMap<>();
        map.put("question", message);
        if (stuffit) {
            map.put("context", docsToStuffResource);
        } else {
            map.put("context", "");
        }

        return new Completion(chatClient.prompt(promptTemplate.create(map)).call().content());
    }

}


GET:http://localhost:10007/example/ai/stuff
message  给我推荐一款百炼系列的手机?
stuffit  true
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\prompt-demo\src\main\resources\prompts\qa-prompt.st
使用以下上下文来回答最后的问题。
如果你不知道答案,就说你不知道,不要试图编造答案。

{context}

问题: {question}
有用的答案:
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\prompt-demo\src\main\resources\docs\bailian.md
# **百炼手机产品介绍**

欢迎来到未来科技的前沿,探索我们精心打造的智能手机系列,每一款都是为了满足您对科技生活的无限遐想而生。

**百炼X1** —— 畅享极致视界:搭载6.7英寸1440 x 3200像素超清屏幕,搭配120Hz刷新率,流畅视觉体验跃然眼前。256GB海量存储空间与12GB RAM强强联合,无论是大型游戏还是多任务处理,都能轻松应对。5000mAh电池长续航,加上超感光四摄系统,记录生活每一刻精彩。参考售价:4599 - 4999

**通义Vivid 7** —— 智能摄影新体验:拥有6.5英寸1080 x 2400像素全面屏,AI智能摄影功能让每一张照片都能展现专业级色彩与细节。8GB RAM与128GB存储空间确保流畅操作,4500mAh电池满足日常所需。侧面指纹解锁,便捷又安全。参考售价:2999 - 3299

**星尘S9 Pro** —— 创新视觉盛宴:突破性6.9英寸1440 x 3088像素屏下摄像头设计,带来无界视觉享受。512GB存储与16GB RAM的顶级配置,配合6000mAh电池与100W快充技术,让性能与续航并驾齐驱,引领科技潮流。参考售价:5999 - 6499。

**百炼Ace Ultra** —— 游戏玩家之选:配备6.67英寸1080 x 2400像素屏幕,内置10GB RAM与256GB存储,确保游戏运行丝滑无阻。5500mAh电池搭配液冷散热系统,长时间游戏也能保持冷静。高动态双扬声器,沉浸式音效升级游戏体验。参考售价:3999 - 4299。

**百炼Zephyr Z9** —— 轻薄便携的艺术:轻巧的6.4英寸1080 x 2340像素设计,搭配128GB存储与6GB RAM,日常使用游刃有余。4000mAh电池确保一天无忧,30倍数字变焦镜头捕捉远处细节,轻薄而不失强大。参考售价:2499 - 2799。

**百炼Flex Fold+** —— 折叠屏新纪元:集创新与奢华于一身,主屏7.6英寸1800 x 2400像素与外屏4.7英寸1080 x 2400像素,多角度自由悬停设计,满足不同场景需求。512GB存储、12GB RAM,加之4700mAh电池与UTG超薄柔性玻璃,开启折叠屏时代新篇章。此外,这款手机还支持双卡双待、卫星通话,帮助您在世界各地都能畅联通话。参考零售价:9999 - 10999。

每一款手机都是匠心独运,只为成就您手中的科技艺术品。选择属于您的智能伙伴,开启未来科技生活的新篇章。

实现结构化输出转JSON或Java对象(.entity)【文本转特定格式】

ChatClient

调用entity()方法

// 实体对象
ActorsFilms actorsFilms = ChatClient.create(chatModel).prompt()
        .user(u -> u.text("Generate the filmography of 5 movies for {actor}.")
                    .param("actor", "Tom Hanks"))
        .call()
        .entity(ActorsFilms.class);
List
List<ActorsFilms> actorsFilms = ChatClient.create(chatModel).prompt()
        .user("Generate the filmography of 5 movies for Tom Hanks and Bill Murray.")
        .call()
        .entity(new ParameterizedTypeReference<List<ActorsFilms>>() {});


//使用 ListOutputConverter 将模型响应转换为 List:
List<String> flavors = ChatClient.create(chatModel).prompt()
                .user(u -> u.text("List five {subject}")
                            .param("subject", "ice cream flavors"))
                .call()
                .entity(new ListOutputConverter(new DefaultConversionService()));
Map< String, Object>
Map<String, Object> result = ChatClient.create(chatModel).prompt()
        .user(u -> u.text("Provide me a List of {subject}")
                    .param("subject", "an array of numbers from 1 to 9 under their key name 'numbers'"))
        .call()
        .entity(new ParameterizedTypeReference<Map<String, Object>>() {});

com/fox/structureddemo/stream/StreamToBeanEntity.java
/*
 * Licensed to the Apache Software Foundation (ASF) under one or more
 * contributor license agreements.  See the NOTICE file distributed with
 * this work for additional information regarding copyright ownership.
 * The ASF licenses this file to You under the Apache License, Version 2.0
 * (the "License"); you may not use this file except in compliance with
 * the License.  You may obtain a copy of the License at
 *
 *     http://www.apache.org/licenses/LICENSE-2.0
 *
 * Unless required by applicable law or agreed to in writing, software
 * distributed under the License is distributed on an "AS IS" BASIS,
 * WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
 * See the License for the specific language governing permissions and
 * limitations under the License.
 */

package com.fox.structureddemo.stream;

public class StreamToBeanEntity {

    private String title;
    private String author;
    private String date;
    private String content;

    public StreamToBeanEntity() {
    }

    public String getTitle() {
        return title;
    }

    public void setTitle(String title) {
        this.title = title;
    }

    public String getAuthor() {
        return author;
    }

    public void setAuthor(String author) {
        this.author = author;
    }

    public String getDate() {
        return date;
    }

    public void setDate(String date) {
        this.date = date;
    }

    public String getContent() {
        return content;
    }

    public void setContent(String content) {
        this.content = content;
    }

    @Override
    public String toString() {
        return "StreamToBeanEntity{" +
                "title='" + title + '\'' +
                ", author='" + author + '\'' +
                ", date='" + date + '\'' +
                ", content='" + content + '\'' +
                '}';
    }
}
com/fox/structureddemo/stream/StreamToBeanController.java
/*
 * Licensed to the Apache Software Foundation (ASF) under one or more
 * contributor license agreements.  See the NOTICE file distributed with
 * this work for additional information regarding copyright ownership.
 * The ASF licenses this file to You under the Apache License, Version 2.0
 * (the "License"); you may not use this file except in compliance with
 * the License.  You may obtain a copy of the License at
 *
 *     http://www.apache.org/licenses/LICENSE-2.0
 *
 * Unless required by applicable law or agreed to in writing, software
 * distributed under the License is distributed on an "AS IS" BASIS,
 * WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
 * See the License for the specific language governing permissions and
 * limitations under the License.
 */

package com.fox.structureddemo.stream;

import jakarta.servlet.http.HttpServletResponse;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.converter.BeanOutputConverter;
import org.springframework.core.ParameterizedTypeReference;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;
import reactor.core.publisher.Flux;

import java.util.Objects;


@RestController
@RequestMapping("/example/stream")
public class StreamToBeanController {

    private final ChatClient chatClient;

    private static final Logger log = LoggerFactory.getLogger(StreamToBeanController.class);

    public StreamToBeanController(ChatClient.Builder builder) {
        // 使用builder对象构建ChatClient实例
        this.chatClient = builder.build();
    }


    /**
     * @return {@link com.fox.structureddemo.stream.StreamToBeanEntity}
     */
    @GetMapping("/play")
    public StreamToBeanEntity simpleChat(HttpServletResponse response) {

        response.setCharacterEncoding("UTF-8");

        var converter = new BeanOutputConverter<>(
                new ParameterizedTypeReference<StreamToBeanEntity>() { }
        );

        Flux<String> flux = this.chatClient.prompt()
                .user(u -> u.text("""
                        requirement: 请用大概 120 字,作者为 Fox ,为计算机的发展历史写一首现代诗;
                        format: 以纯文本输出 json,请不要包含任何多余的文字——包括 markdown 格式;
                        outputExample: {
                             "title": {title},
                             "author": {author},
                             "date": {date},
                             "content": {content}
                        };
                        """))
                .stream()
                .content();

        String result = String.join("\n", Objects.requireNonNull(flux.collectList().block()))
                .replaceAll("\\n", "")
                .replaceAll("\\s+", " ")
                .replaceAll("\"\\s*:", "\":")
                .replaceAll(":\\s*\"", ":\"");

        log.info("LLMs 响应的 json 数据为:{}", result);

        return converter.convert(result);
    }
}
com/fox/structureddemo/stream/StreamToJsonController.java
/*
 * Licensed to the Apache Software Foundation (ASF) under one or more
 * contributor license agreements.  See the NOTICE file distributed with
 * this work for additional information regarding copyright ownership.
 * The ASF licenses this file to You under the Apache License, Version 2.0
 * (the "License"); you may not use this file except in compliance with
 * the License.  You may obtain a copy of the License at
 *
 *     http://www.apache.org/licenses/LICENSE-2.0
 *
 * Unless required by applicable law or agreed to in writing, software
 * distributed under the License is distributed on an "AS IS" BASIS,
 * WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
 * See the License for the specific language governing permissions and
 * limitations under the License.
 */

package com.fox.structureddemo.stream;

import com.alibaba.cloud.ai.dashscope.api.DashScopeResponseFormat;
import com.alibaba.cloud.ai.dashscope.chat.DashScopeChatOptions;
import jakarta.servlet.http.HttpServletResponse;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.model.ChatModel;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RestController;


@RestController
@RequestMapping("/example/stream/json")
public class StreamToJsonController {

    private static final String DEFAULT_PROMPT = "你好,请以JSON格式介绍你自己!";

    private final ChatClient dashScopeChatClient;

    public StreamToJsonController(ChatModel chatModel) {

        DashScopeResponseFormat responseFormat = new DashScopeResponseFormat();
        responseFormat.setType(DashScopeResponseFormat.Type.JSON_OBJECT);

        this.dashScopeChatClient = ChatClient.builder(chatModel)
                .defaultOptions(
                        DashScopeChatOptions.builder()
                                .withTopP(0.7)
                                .withResponseFormat(responseFormat)
                                .build()
                )
                .build();
    }

    /**
     * @return {@link String}
     */
    @GetMapping("/play")
    public String simpleChat(HttpServletResponse response) {
        response.setCharacterEncoding("UTF-8");
        return dashScopeChatClient.prompt(DEFAULT_PROMPT)
                .call()
                .content();
    }

}

通义千问大模型调优

  • temperature:温度值越高,模型生成的内容就越丰富多样

    温度只是来调整候选Token集合的概率分布

    低值(0.2):适用于标准化回答(如退货政策查询)
    高值(0.8):适用于创意场景(如促销文案生成)低温度、中温度和高温度是依据通义千问plus模型的取值范围[0, 2)来划分。

    • 低温度(temperature=0.1):大模型选择“RAG”的概率远高于其它候选Token,这会导致其输出相对单一。
    • 中温度(temperature=0.7):候选Token之间概率分布相对平缓,除“RAG”之外的候选Token出现的概率都在增加。
    • 高温度(temperature=1.2):原低概率的候选Token出现概率进一步提升,打乱原有的排序,进一步提高了大模型输出的随机性。在上图中,“画画”出现的概率反而最高。
  • top_p:top_p值越高,大模型的输出结果随机性越高

    top_p控制候选Token集合的采样范围。

    设置top_p=0.9平衡多样性与准确性,防止低概率token干扰

为了确保生成内容的可控性,建议不要同时调整top_p和temperature。同时调整可能导致输出结果不可预测和复杂。你可以优先调整其中一种参数,观察其对结果的影响,再逐步微调。

  • top_k:top_k越大,生成内容越多样化;top_k越小,内容则更固

在通义千问系列模型中,参数topk也有类似topp的能力,可查阅通义千问API文档。它是一种采样机制,从概率排名前k的Token中随机选择一个进行输出。一般来说,topk越大,生成内容越多样化;topk越小,内容则更固定。当top_k设置为1时,模型仅选择概率最高的Token,输出会更加稳定,但也会导致缺乏变化和创意。

通义千问API参考_大模型服务平台百炼(Model Studio)-阿里云帮助中心

多个AI大模型无缝切换【👆图在上面👆】

如何实现多个AI大模型的无缝切换,比如DeepSeek-R1 调用失败可以请求降级调用 QwQ-32B。 AI网关方案实战

期,通义千问发布了一款全新的推理模型 QwQ-32B。在各类基准测试中,这个拥有 320 亿参数的模型展现出了与 DeepSeek-R1(6710 亿参数)相当的性能。这意味着:

  • 对于个人用户而言,QwQ-32B 能够直接在本地运行,且对设备的要求更低,适合在更小的移动设备上使用。
  • 对于企业用户来说,调用推理大模型 API 的成本可以进一步降低,最高可减少 90% 的费用。

在实际应用中,无缝切换多个大模型的需求日益凸显。例如,企业可能需要同时对接多个大模型,以满足不同业务场景的需求;当单个模型出现稳定性问题时,能够迅速回退到另一个模型,确保业务的连续性和稳定性;在 Multi Agent 场景下,一个复杂任务可能需要调用多个模型来协同完成。Higress AI 网关提供了一个强大的解决方案,支持多模型服务,并具备消费者鉴权、模型自动切换等高级功能。

本文将为您提供一份详细的教程,指导您如何使用 Higress AI 网关在 DeepSeek-R1 和 QwQ-32B 大模型之间实现无缝切换。

关于Higress网关的使用,可以参考我上一篇文章:阿里巴巴开源的云原生网关Higress实战

若想要Higress桌面版 先下载Docker Desktop再下载 Cygwin验证
Cygwin 安装是否成功

cygcheck -c cygwin

Pluminary@Pluminary ~
$ cygcheck -c cygwin
Cygwin Package Information
Package Version Status
cygwin 3.6.1-1 OK

cygwin下载及安装详细教程,windows使用linux的shell命令编译源码(win10) - 知乎
Windows 下 Higress 部署实践 | Higress

先单机部署nacos 进入D:\nacos-docker-master\cmd
单机部署指令:docker-compose -f example/standalone-derby.yaml up
这里可以修改端口映射:D:\nacos-docker-master\example\standalone-derby.yaml 如下👇
正确的监控检查命令:curl http://192.168.31.103:8848/nacos/v3/console/health/readiness

version: "2"
services:
  nacos:
    image: nacos/nacos-server:${NACOS_VERSION}
    container_name: nacos-standalone
    environment:
      - PREFER_HOST_MODE=hostname
      - MODE=standalone
      - NACOS_AUTH_IDENTITY_KEY=serverIdentity
      - NACOS_AUTH_IDENTITY_VALUE=security
      - NACOS_AUTH_TOKEN=VGhpc0lzTXlDdXN0b21TZWNyZXRLZXkwMTIzNDU2Nzg=
    volumes:
      - ./standalone-logs/:/home/nacos/logs
    ports:
      - "8848:8848"
      - "18080:8080"       
  prometheus:
    container_name: prometheus
    image: prom/prometheus:latest
    volumes:
      - ./prometheus/prometheus-standalone.yaml:/etc/prometheus/prometheus.yml
    ports:
      - "9090:9090"
    depends_on:
      - nacos
    restart: on-failure
  grafana:
    container_name: grafana
    image: grafana/grafana:latest
    ports:
      - 3000:3000
    restart: on-failure

随后在桌面打开cmd输入ipconfig寻找ip地址 记录下来
在桌面右键 → 选择 Git Bash Here,进入 Bash 环境
在 Git Bash 里执行命令:【ip地址是通过ipconfig获取】**这里要记得关闭梯子和代理 因为从阿里云拉镜像**

curl -fsSL https://higress.io/standalone/get-higress.sh | bash -s -- -c nacos://192.168.31.103:8848

★★

// 安装higress 进入bash
$ curl -fsSL https://higress.io/standalone/get-higress.sh | bash -s -- -c nacos://192.168.43.85:8848 --nacos-username=nacos --nacos-password=nacos --nacos-ns=higress-system --nacos-ns=higress-system

       // 这里是启动的nacos
cd D:\nacos-docker-master\example
// 重启docker(Nacos)
docker-compose -f standalone-derby.yaml down
docker-compose -f standalone-derby.yaml up -d

// 一键重启
docker restart nacos-standalone

    
       // 这里是启动higress    
// 在桌面启一个bash  启动higress
$ /c/Users/Pluminary/Desktop/higress/bin/startup.sh
// 如果改了配置 在bash里  【一定要先启动docker 才可以干别的】
cd /c/Users/Pluminary/Desktop/higress
./bin/shutdown.sh
./bin/startup.sh
    

然后就一直无敌报错:

http://192.168.31.103:8848/nacos/v1/console/health/readiness returns 000
Waiting for Nacos to get ready…

修改端口不占用冲突的8080即可

cd D:\nacos-docker-master\example

重启docker(Nacos)
docker-compose -f standalone-derby.yaml down
docker-compose -f standalone-derby.yaml up -d

一键重启

docker restart nacos-standalone


下一个报错:

Nacos is ready.
Initializing Nacos server…

Nacos 3.x isn’t fully supported yet.

If you do want to use Nacos 3.x, please add the following property into its application.properties file:
nacos.core.api.compatibility.console.enabled=true

Higress configuration failed with 255.
Failed to install Higress
For support, go to https://github.com/alibaba/higress.

这说明什么?
  • Higress 当前版本对 Nacos 3.x 支持不完善,需要兼容模式开启
  • 你的 Nacos 3.x 服务默认没开启兼容控制台API,导致健康检查接口返回异常或空

1. 修改 Nacos 配置,启用兼容模式

找到你的 Nacos 容器中 application.properties 文件,添加下面这一行:

nacos.core.api.compatibility.console.enabled=true

2. 重启 Nacos 容器

cd D:\nacos-docker-master\example
docker restart nacos-standalone

3. 访问健康接口测试

curl http://192.168.43.85:8848/nacos/v1/console/health/readiness

搞什么乱七八糟的配置 直接降级nacos 因为nacos3.xxx有很多不兼容的地方
D:\nacos-docker-master\example的NACOS_VERSION=v2.3.1

Pluminary@Pluminary MINGW64 ~/Desktop
$ curl -fsSL https://higress.io/standalone/get-higress.sh | bash -s -- -c nacos://192.168.43.85:8848 --nacos-username=nacos --nacos-password=nacos --nacos-ns=higress-system 

Downloading https://github.com/higress-group/higress-
standalone/archive/refs/tags/v2.1.5.tar.gz...
==== Build Configurations ====
time="2025-07-12T00:40:46+08:00" level=warning msg="C:\\Users\\Pluminary\\Desktop\\higress\\compose\\docker-compose.yml: the attribute `version` is obsolete, it will be ignored, please remove it to avoid potential confusion"
Nacos is ready.
Initializing Nacos server...
Use Nacos API v1
  Namespace higress-system already exists in Nacos.
  Fixed data encryption key is used. Skip config overwriting check.
Initializing API server configurations...
  Data encryption key already exists.
Initializing controller configurations...

 ___  ___  ___  ________  ________  _______   ________   ________
|\  \|\  \|\  \|\   ____\|\   __  \|\  ___ \ |\   ____\ |\   ____\
\ \  \\\  \ \  \ \  \___|\ \  \|\  \ \   __/|\ \  \___|_\ \  \___|_
 \ \   __  \ \  \ \  \  __\ \   _  _\ \  \_|/_\ \_____  \\ \_____  \
  \ \  \ \  \ \  \ \  \|\  \ \  \\  \\ \  \_|\ \|____|\  \\|____|\  \
   \ \__\ \__\ \__\ \_______\ \__\\ _\\ \_______\____\_\  \ ____\_\  \
    \|__|\|__|\|__|\|_______|\|__|\|__|\|_______|\_________\\_________\
                                                \|_________\|_________|

Higress is configured successfully.

Important Notes:
  Sensitive configurations are encrypted when saving to Nacos.
  When configuring another server with the same Nacos configuration service, please make sure to add the following argument so all servers use the same encryption key:
   

Usage:
  Start: /c/Users/Pluminary/Desktop/higress/bin/startup.sh
  Stop: /c/Users/Pluminary/Desktop/higress/bin/shutdown.sh
  View Component Statuses: /c/Users/Pluminary/Desktop/higress/bin/status.sh
  View Logs: /c/Users/Pluminary/Desktop/higress/bin/logs.sh
  Re-configure: /c/Users/Pluminary/Desktop/higress/bin/configure.sh -r

Happy Higressing!

访问Nacos:Nacos 或 地址改成localhost

✅ 配置项 1:secrets.nacos-auth-default

位置:

  • 命名空间: fc629691-b48f-4fa2-baa7-770dbaf8b63e(对应 higress-system)
  • Data ID: secrets.nacos-auth-default
  • Group: DEFAULT_GROUP
  • 配置格式: YAML

配置内容:

username: nacos
password: nacos

✅ 配置项 2:configmaps.higress-config

位置:

  • 命名空间: fc629691-b48f-4fa2-baa7-770dbaf8b63e
  • Data ID: configmaps.higress-config
  • Group: DEFAULT_GROUP
  • 配置格式: YAML

配置内容:

apiVersion: v1
kind: ConfigMap
metadata:
  name: higress-config
  namespace: higress-system
data:
  ingressClass: higress

✅ 配置项 3:mcpbridges.default

位置:

  • 命名空间: fc629691-b48f-4fa2-baa7-770dbaf8b63e
  • Data ID: mcpbridges.default
  • Group: DEFAULT_GROUP
  • 配置格式: YAML

配置内容:

apiVersion: networking.higress.io/v1
kind: McpBridge
metadata:
  name: default
  namespace: higress-system
spec:
  registries:
    - domain: httpbin.org
      name: httpbin
      port: 80
      type: dns
./bin/configure.sh -a -c nacos://192.168.31.103:8848 \
  --nacos-username=nacos \
  --nacos-password=nacos \
  --nacos-ns=higress-system

✅ 解决方案:使用 -r 参数强制重新配置

你需要强制重新执行配置流程并显式指定 nacos 命名空间,命令如下:

bash复制编辑./bin/configure.sh -a -r \
  -c nacos://192.168.31.103:8848 \
  --nacos-username=nacos \
  --nacos-password=nacos \
  --nacos-ns=higress-system \
  -k 7bbac1c2ab91ff074cb8d219c307d203

📌 说明:

  • -r:重新运行配置流程(一定要加)
  • --nacos-ns=higress-system:这才是决定配置写入哪个命名空间的参数
  • .env 中的 NACOS_NS 虽然也有用,但以你命令参数为主

什么是RAG

RAG:接收到问题后,去知识库查资料,得到检索知识后进行回答
微调:提前学习知识,丰富自己的能力,接收到问题后进行回答

RAG → 问题 → (LLM+知识) → 回复
    
                   问题
                    ↓
微调 → LLM → 知识 → LLM(new)
               ↘    ↓
                   回复
RAG工作原理:
  • 建立索引阶段

    文件上传 → 文档加载 → 内容分割 → 文本向量化 → 索引存储

  • 检索与生成阶段

    检索:检索阶段会召回与问题最相关的文本段。通过embedding模型对问题进行文本向量化,并与向量数据库的段落进行语义相似度的比较,找出最相关的段落。
    生成:在检索到相关的文本段后,RAG应用会将问题与文本段通过提示词模板生成最终的提示词,由大模型生成回复,这个阶段更多是利用大模型的总结能力,而不是大模型本身具有的知识。

  • 总结

    用户提问 → → → → → → 提示词 → 大语言模型 → 输出答案
    ↘ → 内容检索 → ↑

com/fox/ragdemo/config/RagConfig.java
package com.fox.ragdemo.config;

import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.document.Document;
import org.springframework.ai.embedding.EmbeddingModel;
import org.springframework.ai.vectorstore.SimpleVectorStore;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

import java.util.List;

@Configuration
public class RagConfig {

    @Bean
    ChatClient chatClient(ChatClient.Builder builder) {
        return builder.defaultSystem("你将作为一名机器人产品的专家,对于用户的使用需求作出解答")
                .build();
    }

    @Bean
    VectorStore vectorStore(EmbeddingModel embeddingModel) {
        SimpleVectorStore simpleVectorStore = SimpleVectorStore.builder(embeddingModel)
                .build();

        // 生成一个机器人产品说明书的文档
        List<Document> documents = List.of(
                new Document("产品说明书:产品名称:智能机器人\n" +
                        "产品描述:智能机器人是一个智能设备,能够自动完成各种任务。\n" +
                        "功能:\n" +
                        "1. 自动导航:机器人能够自动导航到指定位置。\n" +
                        "2. 自动抓取:机器人能够自动抓取物品。\n" +
                        "3. 自动放置:机器人能够自动放置物品。\n"));

        simpleVectorStore.add(documents);
        return simpleVectorStore;
    }
}
com/fox/ragdemo/controller/RagController.java
package com.fox.ragdemo.controller;

import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.client.advisor.QuestionAnswerAdvisor;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.web.bind.annotation.*;

@RestController
@RequestMapping("/ai")
public class RagController {

    @Autowired
    private ChatClient chatClient;

    @Autowired
    private VectorStore vectorStore;


    @GetMapping(value = "/chat", produces = "text/plain; charset=UTF-8")
    public String generation(String userInput) {
        // 发起聊天请求并处理响应
        return chatClient.prompt()
                .user(userInput)
                // 调用知识库
                .advisors(new QuestionAnswerAdvisor(vectorStore))
                .call()
                .content();
    }
}
package com.fox.ragdemo;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;

@SpringBootApplication
public class RagDemoApplication {

    public static void main(String[] args) {
        SpringApplication.run(RagDemoApplication.class, args);
    }
}

RAG+阿里云百炼

本地集成百炼智能体应用
本地RAG应用集成百炼知识库
知识库:
【学校简介】
阳光中学创建于1998年,是一所全日制寄宿制完全中学,坐落于江苏省苏州市。学校占地120亩,现有教职工120人,学生1500余人。多年来,阳光中学秉持“厚德载物,知行合一”的校训,致力于培养具有国际视野与中国灵魂的复合型人才。
________________________________________
【课程设置】
阳光中学设有初中和高中两个学段,开设课程包括语文、数学、英语、物理、化学、生物、历史、地理、政治、信息技术、音乐、美术和体育等。高一开始分文理科方向,同时提供选修课程如Python编程、人工智能基础、商务英语等,满足学生多元发展需求。
________________________________________
【师资力量】
学校现有特级教师3人,高级教师32人,硕士学历以上教师占比达70%。其中语文学科带头人王老师曾获全国语文优质课一等奖,数学组组长李老师拥有15年以上高三教学经验,多次带出省级高考状元。
________________________________________
【校园生活】
阳光中学注重学生全面发展,组织丰富的课外活动与社团,如机器人社、合唱团、辩论社、摄影社、篮球队等。每年5月举办校园艺术节,每年10月举行运动会,深受师生喜爱。校园内有图书馆、自助餐厅、医务室、心理咨询室等完善设施。
________________________________________
【校规制度】
1.    学生必须穿着校服上课,不得迟到、早退或旷课;
2.    晚自习时间为每周一至周五18:30—20:30;
3.    禁止携带手机等电子产品进课堂;
4.    严禁在校园内打架、吸烟、喝酒,一经发现严肃处理;
5.    每月评选“文明班级”“学习标兵”等荣誉称号。
________________________________________
【招生信息】
阳光中学每年春季开始招生,面向全国招收初一、高一新生。招生名额有限,需通过笔试和面试。学费标准为初中部每学期6000元,高中部每学期8000元,另设有奖学金与助学金政策,家庭困难学生可申请减免。
________________________________________
【常见问题解答】
Q:阳光中学是否提供住宿?
A:学校提供标准化学生宿舍,6人一间,配备空调、热水器与独立卫生间,设有生活老师管理。
Q:学校是否提供营养餐?
A:学生餐厅提供三餐,包括荤素搭配的营养套餐,每周公布菜单,确保健康卫生。
Q:如何申请插班?
A:插班生需在每学期开学前一个月提交申请,学校将根据学位情况及考试成绩决定是否录取。
Q:学校对艺术体育特长生有优惠吗?
A:是的。学校每年招收部分艺术、体育特长生,可享受降分录取及奖学金政策。
________________________________________
【校园热点资讯】
2025年6月,阳光中学高考再创佳绩,重本上线率达89%,其中7人被清华北大录取;
2025年3月,阳光中学学生在全国青少年人工智能竞赛中获得一等奖;
2024年10月,学校新建科学楼正式启用,建筑面积达4800平方米,配备多个功能实验室。
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\bailian-agent\src\main\java\com\fox\bailianagent\controller\BailianAgentRagController.java
package com.fox.bailianagent.controller;

import com.alibaba.cloud.ai.dashscope.agent.DashScopeAgent;
import com.alibaba.cloud.ai.dashscope.agent.DashScopeAgentOptions;
import com.alibaba.cloud.ai.dashscope.api.DashScopeAgentApi;
import org.springframework.ai.chat.messages.AssistantMessage;
import org.springframework.ai.chat.model.ChatResponse;
import org.springframework.ai.chat.prompt.Prompt;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;

@RestController
public class BailianAgentRagController {
  private DashScopeAgent agent;

  @Value("${spring.ai.dashscope.agent.app-id}")
  private String appId;

  public BailianAgentRagController(DashScopeAgentApi dashscopeAgentApi) {
    this.agent = new DashScopeAgent(dashscopeAgentApi);
  }

  @GetMapping("/bailian/agent/call")
  public String call(@RequestParam(value = "message") String message) {
    ChatResponse response = agent.call(
            new Prompt(message, DashScopeAgentOptions.builder()
                    // 与智能体的绑定
                    .withAppId(appId)
                    .build()));
    AssistantMessage app_output = response.getResult().getOutput();
    return app_output.getText();
  }
}

GET:http://localhost:8088/bailian/agent/call
message  学校简介是什么?
package com.fox.bailianagent;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;

@SpringBootApplication
public class BailianAgentApplication {

    public static void main(String[] args) {
        SpringApplication.run(BailianAgentApplication.class, args);
    }
}
server:
  port: 8088

spring:
  application:
    name: bailian-agent
  ai:
    dashscope:
      agent:
# https://bailian.console.aliyun.com/?tab=app#/app-center
        app-id: xxxxxxx
      api-key: xxxxxxx

SpringAIAlibaba本地集成百炼知识库实战通过代码将文件上传到百炼知识库

/*
* Copyright 2024 the original author or authors.
*
* Licensed under the Apache License, Version 2.0 (the "License");
* you may not use this file except in compliance with the License.
* You may obtain a copy of the License at
*
*      https://www.apache.org/licenses/LICENSE-2.0
*
* Unless required by applicable law or agreed to in writing, software
* distributed under the License is distributed on an "AS IS" BASIS,
* WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
* See the License for the specific language governing permissions and
* limitations under the License.
*/

package com.fox.bailianragdemo.controller;

import com.fox.bailianragdemo.service.RagService;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;
import reactor.core.publisher.Flux;

@RestController
@RequestMapping("/ai")
public class CloudRagController {

    private final RagService cloudRagService;

    public CloudRagController(RagService cloudRagService) {
        this.cloudRagService = cloudRagService;
    }

    @GetMapping("/bailian/knowledge/importDocument")
    public void importDocument() {
        cloudRagService.importDocuments();
    }

    @GetMapping("/bailian/knowledge/generate")
    public Flux<String> generate(@RequestParam(value = "message",
            defaultValue = "你好,请问你的知识库文档主要是关于什么内容的?") String message) {
        return cloudRagService.retrieve(message).map(x -> x.getResult().getOutput().getText());
    }

}
/*
* Copyright 2024 the original author or authors.
*
* Licensed under the Apache License, Version 2.0 (the "License");
* you may not use this file except in compliance with the License.
* You may obtain a copy of the License at
*
*      https://www.apache.org/licenses/LICENSE-2.0
*
* Unless required by applicable law or agreed to in writing, software
* distributed under the License is distributed on an "AS IS" BASIS,
* WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
* See the License for the specific language governing permissions and
* limitations under the License.
*/

package com.fox.bailianragdemo.service;

import com.alibaba.cloud.ai.advisor.DocumentRetrievalAdvisor;
import com.alibaba.cloud.ai.dashscope.api.DashScopeApi;
import com.alibaba.cloud.ai.dashscope.rag.*;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.ai.chat.model.ChatResponse;
import org.springframework.ai.document.Document;
import org.springframework.ai.document.DocumentReader;
import org.springframework.ai.rag.retrieval.search.DocumentRetriever;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.core.io.Resource;
import org.springframework.stereotype.Service;
import reactor.core.publisher.Flux;

import java.io.File;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.InputStream;
import java.util.List;


@Service()
public class CloudRagService implements RagService {

    private static final Logger logger = LoggerFactory.getLogger(CloudRagService.class);

    private static final String indexName = "阳光中学";

    @Value("classpath:/data/spring_ai_alibaba_quickstart.pdf")
    private Resource springAiResource;

    private static final String retrievalSystemTemplate = """
            上下文信息如下:
            ---------------------
            {question_answer_context}
            ---------------------
            根据上下文和提供的历史信息,而不是先验知识,回答用户问题。
            如果答案不在上下文中,请告知用户无法回答该问题。
            """;

    private final ChatClient chatClient;

    private final DashScopeApi dashscopeApi;

    public CloudRagService(ChatClient.Builder builder, DashScopeApi dashscopeApi) {
        DocumentRetriever retriever = new DashScopeDocumentRetriever(dashscopeApi,
                DashScopeDocumentRetrieverOptions.builder().withIndexName(indexName).build());

        this.dashscopeApi = dashscopeApi;
        this.chatClient = builder
                .defaultAdvisors(new DocumentRetrievalAdvisor(retriever, retrievalSystemTemplate))
                .build();
    }

    @Override
    public void importDocuments() {
        String path = saveToTempFile(springAiResource);

        // 1. import and split documents
        DocumentReader reader = new DashScopeDocumentCloudReader(path, dashscopeApi, null);
        List<Document> documentList = reader.get();
        logger.info("{} documents loaded and split", documentList.size());

        // 1. add documents to DashScope cloud storage 向量数据库
        VectorStore vectorStore = new DashScopeCloudStore(dashscopeApi, new DashScopeStoreOptions(indexName));
        vectorStore.add(documentList);
        logger.info("{} documents added to dashscope cloud vector store", documentList.size());
    }

    private String saveToTempFile(Resource springAiResource) {
        try {
            File tempFile = File.createTempFile("spring_ai_alibaba_quickstart", ".pdf");
            tempFile.deleteOnExit();

            try (InputStream inputStream = springAiResource.getInputStream();
                    FileOutputStream outputStream = new FileOutputStream(tempFile)) {
                byte[] buffer = new byte[4096];
                int bytesRead;
                while ((bytesRead = inputStream.read(buffer)) != -1) {
                    outputStream.write(buffer, 0, bytesRead);
                }
            }

            return tempFile.getAbsolutePath();
        }
        catch (IOException e) {
            throw new RuntimeException(e);
        }
    }

    public Flux<ChatResponse> retrieve(String message) {
        return chatClient.prompt().user(message).stream().chatResponse();
    }

}
/*
* Copyright 2024 the original author or authors.
*
* Licensed under the Apache License, Version 2.0 (the "License");
* you may not use this file except in compliance with the License.
* You may obtain a copy of the License at
*
*      https://www.apache.org/licenses/LICENSE-2.0
*
* Unless required by applicable law or agreed to in writing, software
* distributed under the License is distributed on an "AS IS" BASIS,
* WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
* See the License for the specific language governing permissions and
* limitations under the License.
*/

package com.fox.bailianragdemo.service;

import org.springframework.ai.chat.model.ChatResponse;
import reactor.core.publisher.Flux;


public interface RagService {

    void importDocuments();

    Flux<ChatResponse> retrieve(String message);
}
server:
  port: 8088

spring:
  application:
    name: bailian-rag-demo
  ai:
    dashscope:
      api-key: xxxxx

工具Fuction Calling

允许语言大模型调用外部函数(Function)或API来执行特定任务或获取实时数据。
例如:
调用天气API查询实时天气。
调用数据库接口执行查询。 其核心是扩展模型的交互能力,使其能执行操作或获取结构化数据,而非仅依赖内部知识

应用场景

实时数据查询:如股票行情、天气、航班信息。
任务自动化:预订会议、下单、数据计算等。
系统集成:与CRM、ERP等业务系统交互(如创建客户记录)

和RAG的区别

RAG和Function Calling分别从知识增强和功能扩展两个维度提升LLM能力。选择取决于具体需求:

  • 需结合外部知识? → RAG
  • 需执行操作或获取实时数据? → Function Calling
  • 复杂场景:两者结合(如Agent框架中集成RAG和工具调用)
维度 RAG Function Calling
数据依赖 依赖外部知识库的覆盖和质量 依赖API或函数的可用性和稳定性
实时性 受限于知识库更新频率 可获取实时数据(如API返回结果)
输出形式 自然语言文本 结构化数据(Json)或操作结果
适用问题类型 需外部知识支持的复杂问题 需执行操作或获取动态数据的场景
实现复杂度 需构建高效检索系统(向量数据库) 需定义函数接口和参数规范

Function Calling获取天气信息

以Function为接口调用apply方法
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\toolcalling-demo\src\main\java\com\fox\toolcallingdemo\tool\weather\function\WeatherFunction.java

package com.fox.toolcallingdemo.tool.weather.function;

import java.util.function.Function;

public class WeatherFunction implements Function<WeatherFunction.WeatherRequest, String> {
    @Override
    public String apply(WeatherRequest request) {
        // 此处省略了实际的天气查询逻辑,直接返回一个示例字符串
        // 实际应用中需要根据请求参数调用天气API获取天气信息
        return "The weather in " + request.getCity() + " is sunny.";
    }
    public static class WeatherRequest {
        private String city;
        public String getCity() { return city; }
        public void setCity(String city) { this.city = city; }
    }
}
把函数以Bean形式交给Spring去管理
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\toolcalling-demo\src\main\java\com\fox\toolcallingdemo\tool\weather\function\FunctionConfig.java
    
package com.fox.toolcallingdemo.tool.weather.function;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.context.annotation.Description;

import java.util.function.Function;

@Configuration
public class FunctionConfig {
    @Bean
    // 标识
    @Description("获取指定城市的天气信息")
    public Function<WeatherFunction.WeatherRequest, String> weatherFunction() {
        return new WeatherFunction();
    }
}
告诉大模型请求可以调函数
package com.fox.toolcallingdemo.controller;


import com.fox.toolcallingdemo.tool.weather.method.WeatherTool;
import com.fox.toolcallingdemo.tool.weather.method.WeatherToolImpl;
import org.springframework.ai.chat.client.ChatClient;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.RequestParam;
import org.springframework.web.bind.annotation.RestController;

@RestController
@RequestMapping("/weather")
public class WeatherController {

    private final ChatClient dashScopeChatClient;

    /**
    * 默认全局调函数
    */
    public WeatherController(ChatClient.Builder chatClientBuilder) {
        this.dashScopeChatClient = chatClientBuilder
                .defaultFunctions("weatherFunction")
                //.defaultTools(new WeatherToolImpl())
                .build();
    }
-------------------------------------------------------------------------------------
    /**
     * 无工具版
     */
    @GetMapping("/chat")
    public String simpleChat(@RequestParam(value = "query", defaultValue = "北京今天的天气") String query) {
        return dashScopeChatClient.prompt(query).call().content();
    }
-------------------------------------------------------------------------------------
    /**
     * 调用工具版 - function
     */
    @GetMapping("/chat-tool-function")
    public String chatTranslateFunction(@RequestParam(value = "query", defaultValue = "北京今天的天气") String query) {

    // 就可以去找刚刚函数构建的bean
        return dashScopeChatClient.prompt(query).functions("weatherFunction").call().content();
    }

-------------------------------------------------------------------------------------

    /**
     * 调用工具版 - method
     */
    @GetMapping("/chat-tool-method")
    public String chatTranslateMethod(@RequestParam(value = "query", defaultValue = "北京今天的天气") String query) {

        return dashScopeChatClient.prompt(query).tools(new WeatherToolImpl()).call().content();
    }
}

GET:http://localhost:8088/weather/chat-tool-method
query  深圳今天的天气怎么样?
承接上面最后一个Method版
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\toolcalling-demo\src\main\java\com\fox\toolcallingdemo\tool\weather\method\WeatherTool.java
package com.fox.toolcallingdemo.tool.weather.method;

public interface WeatherTool {
    String getWeather(String city);
}
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\toolcalling-demo\src\main\java\com\fox\toolcallingdemo\tool\weather\method\WeatherToolImpl.java
package com.fox.toolcallingdemo.tool.weather.method;


import org.springframework.ai.tool.annotation.Tool;

public class WeatherToolImpl implements WeatherTool {
    @Override
    @Tool(description = "获取指定城市的天气信息。")
    public String getWeather(String city) {
        return "The weather in " + city + " is sunny.";
    }
}

MCP协议

模型上下文协议(即 Model Context Protocol,MCP)是一个开放协议,它规范了应用程序如何向大型语言模型(LLM)提供上下文。MCP 提供了一种统一的方式将 AI 模型连接到不同的数据源和工具,它定义了统一的集成方式。

MCP图+与function_calling区别

百炼智能体应用接入高德地图MCP服务

大模型服务平台百炼控制台
在智能体应用的技能添加MCP服务 Amap Maps需要提前开通即可

MCP开发实战

模型上下文协议(Model Context Protocol)
MCP 简介

模型上下文协议(即 Model Context Protocol,MCP)是一个开放协议,它规范了应用程序如何向大型语言模型(LLM)提供上下文。MCP 提供了一种统一的方式将 AI 模型连接到不同的数据源和工具,它定义了统一的集成方式。在开发智能体(Agent)的过程中,我们经常需要将将智能体与数据和工具集成,MCP 以标准的方式规范了智能体与数据及工具的集成方式,可以帮助您在 LLM 之上构建智能体(Agent)和复杂的工作流。目前已经有大量的服务接入并提供了 MCP server 实现,当前这个生态正在以非常快的速度不断的丰富中,具体可参见:MCP Servers。

Spring AI MCP

Spring AI MCP 为模型上下文协议提供 Java 和 Spring 框架集成。它使 Spring AI 应用程序能够通过标准化的接口与不同的数据源和工具进行交互,支持同步和异步通信模式。

Spring AI MCP 采用模块化架构,包括以下组件:

  • Spring AI 应用程序:使用 Spring AI 框架构建想要通过 MCP 访问数据的生成式 AI 应用程序
  • Spring MCP 客户端:MCP 协议的 Spring AI 实现,与服务器保持 1:1 连接
  • MCP 服务器:轻量级程序,每个程序都通过标准化的模型上下文协议公开特定的功能
  • 本地数据源:MCP 服务器可以安全访问的计算机文件、数据库和服务
  • 远程服务:MCP 服务器可以通过互联网(例如,通过 API)连接到的外部系统

如何使用

要启用此功能,请将以下依赖项添加到您项目的 Mavenpom.xml文件中:

<dependency>
    <groupId>org.springframework.experimental</groupId>
    <artifactId>spring-ai-mcp</artifactId>
    <version>1.0.0</version>
</dependency>

或者添加到您的 Gradlebuild.gradle文件中:

dependencies {
    implementation 'org.springframework.experimental:spring-ai-mcp:1.0.0'
}

Spring AI MCP 目前并没有在 Maven Central Repository 中提供。需要将 Spring milestone仓库添加到pom.xml中,才可以访问 Spring AI MCP 工件:

<repositories>
  <repository>
    <id>spring-milestones</id>
    <name>Spring Milestones</name>
    <url>https://repo.spring.io/libs-milestone-local</url>
    <snapshots>
      <enabled>false</enabled>
    </snapshots>
  </repository>
</repositories>

要使用 MCP,首先需要创建McpClient,它提供了与 MCP server 的同步和异步通信能力。现在我们创建一个 McpClient 来注册 MCP Brave 服务和 ChatClient,从而让 LLM 调用它们:

var stdioParams = ServerParameters.builder("npx")
        .args("-y", "@modelcontextprotocol/server-brave-search")
        .addEnvVar("BRAVE_API_KEY", System.getenv("BRAVE_API_KEY"))
        .build();

var mcpClient = McpClient.using(new StdioClientTransport(stdioParams)).sync();

var init = mcpClient.initialize();

var chatClient = chatClientBuilder
        .defaultFunctions(mcpClient.listTools(null)
                .tools()
                .stream()
                .map(tool -> new McpFunctionCallback(mcpClient, tool))
                .toArray(McpFunctionCallback[]::new))
        .build();

String response = chatClient
        .prompt("Does Spring AI supports the Model Context Protocol? Please provide some references.")
        .call().content();

在上述代码中,首先通过npx命令启动一个独立的进程,运行@modelcontextprotocol/server-brave-search服务,并指定 Brave API 密钥。然后创建一个基于 stdio 的传输层,与 MCP server 进行通信。最后初始化与 MCP 服务器的连接。

要使用 McpClient,需要将McpClient注入到 Spring AI 的ChatClient中,从而让 LLM 调用 MCP server。在 Spring AI 中,可以通过 Function Callbacks 的方式将 MCP 工具转换为 Spring AI 的 Function,从而让 LLM 调用。

最后,通过ChatClient与 LLM 进行交互,并使用McpClient与 MCP server 进行通信,获取最终的返回结果。

官方的alibaba服务教学:C:\Users\Pluminary\Desktop\HouDuan\spring-ai-alibaba-examples

Stdio传输层

Stdio(标准输入输出) 传输层是MCP最基本的传输实现方式。它通过进程间通信(IPC)实现

SSE传输层

SSE(Server-Sent Events) 传输层是基于HTTP的单向通信机制,专门用于服务器向客户端推送数据

MCP是什么?和Function calling有什么区别?美团面试题

MCP可以通过Client指定SSE 再去找一个远程地址直接就可以调用MCP就像拓展坞,MCPServer可以部署到云端给外部使用
Function Calling则需要自己手动去写一个去调用外部

这道面试题问的是:

MCP 是什么?它和 Function Calling 有什么区别?

来自美团,很可能是在考察你对 大模型应用框架(尤其是 RAG、工具调用、Agent 框架等)底层机制的理解,特别是近几年阿里推出的 Spring AI Alibaba MCP 模型调用框架。


✅ 一、什么是 MCP?

MCP(Model Call Protocol) 是阿里巴巴在 Spring AI Alibaba 框架中提出的一个模型调用协议,全称是:

Model Call Protocol(模型调用协议)

它的作用是:
🔧 统一模型接入规范,为不同的大模型(阿里通义、百度文心、ChatGLM、文生图、图生图等)提供一套通用、标准、结构化的调用协议和扩展机制。

✅ MCP 解决的问题:

  • 🌀 不同大模型调用方式、参数格式五花八门 → MCP 提供统一接口抽象
  • 🛠 支持插件工具调用(Tool Calling)
  • 🔁 支持多轮对话记忆
  • 🤖 支持 Agent 架构(例如 RAG、Function调用等)
  • 📦 可以灵活切换底层大模型,实现模型无感知迁移(例如将通义大模型无缝替换为文心一言)

✅ MCP 的核心组件:

  1. MCPModel:统一的模型接口(封装了 prompt 处理、调用逻辑等)
  2. MCPFunctionCallingModel:支持 Function Calling 的模型
  3. MCPMessage、MCPResponse:统一的输入/输出数据结构
  4. ToolDefinition, FunctionCall, ToolResult:对工具调用结构化建模

✅ 二、什么是 Function Calling?

Function Calling 是由 OpenAI 提出的技术,后被各大模型厂商采纳(如通义千问、百度文心也支持),它让大模型在对话中能够调用外部函数。

🔧 它的核心概念:

  • 大模型通过识别语义内容,决定是否调用一个函数(例如查天气、查数据库、生成图片等)
  • 由用户预定义函数列表(Function Schema),模型根据意图选择调用
  • 返回结构化 JSON 给开发者,由程序调用实际函数 → 执行后返回结果给模型

✅ Function Calling 实现的能力:

能力 说明
工具接入能力 让模型“用工具”去扩展知识或能力,如查资料、查库存、操作系统等
多轮调用链 支持调用链组合,如 A→B→C 的流程式工具使用
Agent能力基础 是 Agent 能够链式思维和计划任务执行的基础

✅ 三、MCP 和 Function Calling 的关系与区别

对比项 MCP Function Calling
本质 一种大模型调用协议标准 一种大模型的工具调用机制
是否支持 Function ✅ 支持,MCP 中内置了 Function Calling 抽象 ✅ 只关注“函数调用”,不管模型接入细节
作用范围 📦 模型统一封装、RAG、Chat、工具调用、记忆、代理等(整个调用框架) 🧠 模型如何调用函数、如何组织工具返回
抽象程度 高度抽象框架层,统一输入输出模型、适配各类模型 相对底层,是大模型的功能点
使用者 开发框架作者(如 Spring AI Alibaba) 模型厂商、应用开发者
代表项目 Spring AI Alibaba MCP、LangChain4j MCP、百度文心 RAGFlow 等 OpenAI GPT、通义千问、ChatGLM、Claude 等支持 Function Calling 的模型

✅ 四、通俗比喻理解

MCP 是一个大楼的 “总控中心”,可以调配各种大模型、工具、记忆、插件等资源

Function Calling 是这个大楼里的一套 “智能工具调度系统”,专门处理“这个请求要不要调用某个工具来完成”。


✅ 五、实际应用举例(代码层)

在 Spring AI Alibaba 中,你可以这样使用 MCP + FunctionCalling:

@Autowired
private FunctionCallingChatClient chatClient;

@PostMapping("/chat")
public String chat(@RequestBody String prompt) {
    Message response = chatClient.call(
        Message.of(prompt),
        FunctionCallingOptions.builder()
            .function(ToolDefinitions.fromClass(MyFunction.class))
            .build()
    );
    return response.getContent();
}

上面这段代码:

  • 使用 MCP 提供的 FunctionCallingChatClient 调用大模型
  • 绑定了一个 Function(MyFunction),模型根据上下文会自动决定是否调用它

✅ 总结答法(面试简明说法):

MCP 是阿里推出的模型调用协议,统一了模型接入、工具调用、Agent 调度等能力,是一种面向“统一模型开发框架”的抽象;Function Calling 是大模型的一种能力,允许它根据语义调用结构化函数。MCP 包含了 Function Calling 能力,但它作用更广,面向的是整套大模型调用生命周期,Function Calling 则聚焦在“如何让模型使用外部函数”这件事上。

电商智能客服项目

开发环境

JDK17、SpringBoot3.4.0、Spring AI 1.0.0-M6、Spring AI Alibaba 1.0.0-M6.1

项目背景

项目位于:C:\Users\Pluminary\Desktop\HouDuan\ai-demo\tlmall-ai
前端位于:C:\Users\Pluminary\Desktop\HouDuan\ai-demo\tlmall-ai\frontend

可以右键通过终端打开文件夹
①:yarn install 安装依赖
②:yarn dev 启动项目

后端位于:C:\Users\Pluminary\Desktop\HouDuan\ai-demo\tlmall-order【order.sql也在这里】;C:\Users\Pluminary\Desktop\HouDuan\ai-demo\tlmall-ai分别启动两个模块的Application

使用MCP调用订单服务查询订单详情MCPServer是对订单层的包装

项目位于C:\Users\Pluminary\Desktop\HouDuan\ai-demo\tlmall-order-mcp-client;C:\Users\Pluminary\Desktop\HouDuan\ai-demo\tlmall-order-mcp-server
C:\Users\Pluminary\Desktop\HouDuan\ai-demo\tlmall-order

阅读全文
头像
Asuna
You are the one who can always get to me even with screen between us.